


Python中math.log与numpy.log的区别与选择
深入解析Python中内置math.log与NumPy科学计算库numpy.log在设计目标、参数机制、异常控制与性能表现上的关键差异,提供清晰的工程选型与实战决策指南。
核心结论速览:在 Python 中,math.log 是内置标准库函数,专注于单个数字标量的高效运算,原生支持动态指定对数底数,遇到零或负数严格抛出 ValueError;而 numpy.log 是 NumPy 的向量化通用函数(ufunc),核心专长是批量数组与矩阵的大规模并行计算,仅计算以 e 为底的自然对数(无 base 参数),遇到非法数值返回 nan 或 -inf 并触发警告。选择原则清晰:单个数值或标准库无依赖场景用 math.log;批量数据分析或机器学习矩阵运算无条件选用 numpy.log。
假设你正在处理一份包含数十万行传感器数值的日志列表,需要对所有读数取自然对数进行尺度压缩。初学者往往直接顺手写下 math.log(data),结果立即触发 TypeError: must be real number, not list;随后若改用列表推导式 [math.log(x) for x in data],虽然程序能够跑通,耗时却比直接调用 np.log(data) 慢了数十倍。而在另一个微服务接口中,只是对前端传入的单个阈值做简单的对数换算,如果专门引入几百兆的 NumPy 库并调用 np.log,又会因为额外的数组包装与派发机制带来负向的性能损耗。理解两者的底层差异与选型逻辑,是写出健壮且高性能 Python 代码的基础。
一、执行机制与输入类型的根本差异
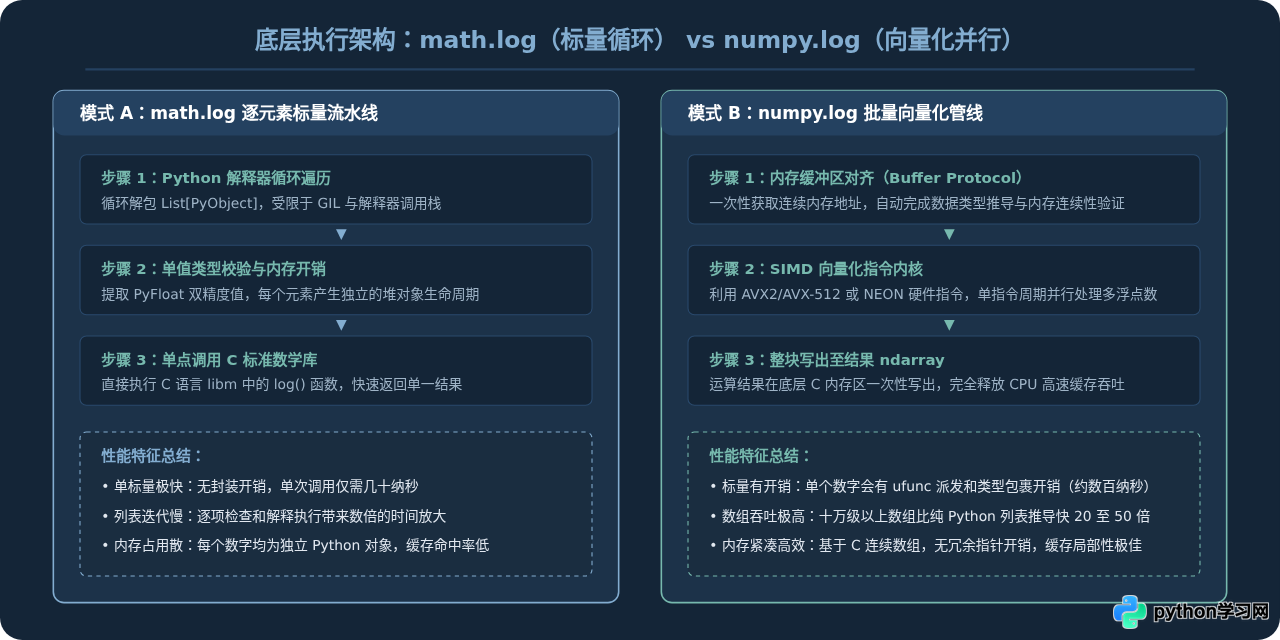
math.log 和 numpy.log 表面上都用来计算对数,但两者的底层架构与运行时设计目标截然不同:
- math.log(标量轻量级机制):作为 Python 官方
math模块的一部分,它本质上是对底层标准 C 数学库(libm)中log()函数的直接轻量封装。每次调用只接收单个实数(int或float),在 CPython 虚拟机内部进行简单的解包与调用后,立即返回一个纯粹的 Pythonfloat对象。 - numpy.log(底层向量化管线):作为 NumPy 核心的通用函数(universal function,简称 ufunc),它面向的是连续内存缓冲区。它既能接收标量,也能无缝接收 Python 列表、元组以及任意维度的
ndarray。在底层,NumPy 会绕过 Python 虚拟机的逐元素循环机制,直接通过底层连续内存寻址与现代 CPU 的 SIMD 矢量指令并行批处理。
以下代码直观展示了输入类型的支持差异:
import math
import numpy as np

# 1. 标量输入
val = 10.0
math_res = math.log(val)         # 正确:返回标准 float 类型,约 2.302585
np_res = np.log(val)             # 正确:返回 numpy.float64 类型,约 2.302585

# 2. 列表与数组输入
data_list = [1.0, 2.71828, 7.389]

# 尝试对列表直接使用 math.log 会触发异常
try:
    math.log(data_list)
except TypeError as e:
    print(f"math.log 抛出错误: {e}")
    # 报错示例:TypeError: must be real number, not list

# numpy.log 原生直接支持列表与 ndarray
batch_res = np.log(data_list)
print("numpy.log 批量处理成功:", batch_res)
# 运行输出示例:[0.         0.99999933 1.99999313]
二、底数指定机制与函数族生态
在需要计算非自然对数(例如以 2 为底、以 10 为底或任意底数)时,两者提供了完全不同的接口设计,这也是许多开发者极易踩坑的重灾区。
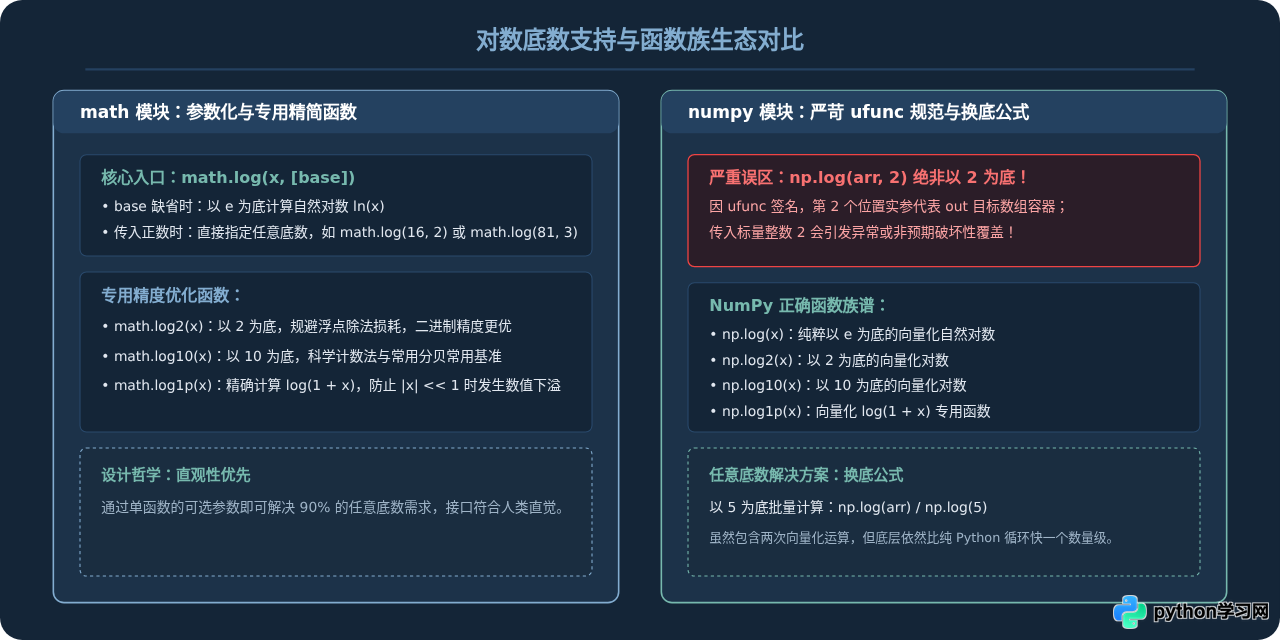
1. math.log 的双参数原生机制
math.log 的完整签名是 math.log(x, [base])。如果不传第二个参数,默认以数学常数 e 为底(自然对数)。如果传入第二个参数,则直接以该参数为底数进行对数计算:
# math 模块中的灵活底数设定
math.log(8, 2)    # 计算以 2 为底 8 的对数,返回 3.0
math.log(1000, 10) # 计算以 10 为底 1000 的对数,返回 2.9999999999999996
math.log(27, 3)   # 计算以 3 为底 27 的对数,返回 3.0

# 此外 math 也提供了专门经过硬件或常数优化的快捷函数
math.log2(8)     # 精度优于 math.log(8, 2),精准返回 3.0
math.log10(1000) # 精准返回 3.0
math.log1p(1e-15) # 计算 log(1 + x),防止浮点精度发生严重截断下溢
2. numpy.log 的致命传参陷阱
高危警示:numpy.log 没有 base 形参!如果写出 np.log(arr, 2),第二个参数 2 并不会被识别为底数,而是会被传给 ufunc 的输出参数 out。这会导致程序立即抛出 TypeError: return arrays must be of ArrayType,甚至在旧版本中可能导致不可预期的内存覆盖灾难。
NumPy 将特定底数的对数实现为独立的顶层函数。对于任意自定义底数,必须使用数学上的换底公式:log_b(x) = ln(x) / ln(b)。
三、边界值与异常处理逻辑:严格中断 vs 浮点容错流
当输入出现数学定义域之外的非法值(如零、负数、无效数据 NaN)时,两者的行为策略展示了传统软件工程安全(快速失败)与科学计算工程容错(保持管线流动)的哲学分歧。
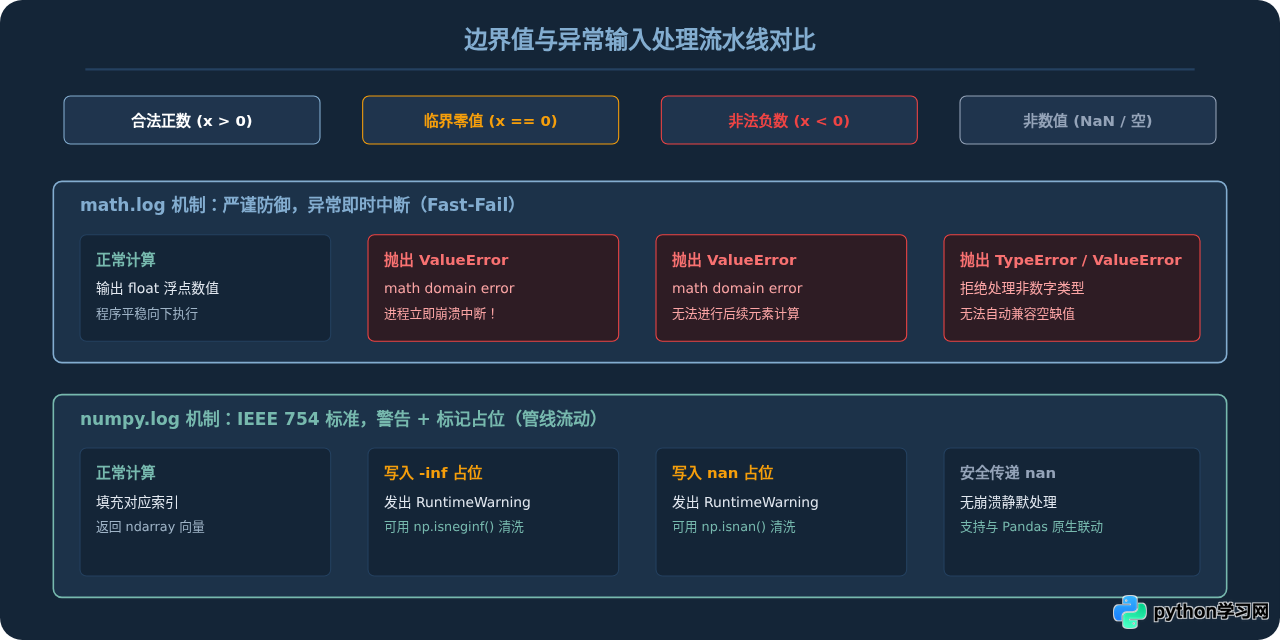
1. math.log 的防御式报错(Fail-Fast)
在数学上,实数对数函数的定义域为 x > 0。math.log 秉承严格的 Python 错误处理机制:
- 输入 0:抛出
ValueError: math domain error。 - 输入负数:同样抛出
ValueError: math domain error。 - 输入非标量类型:立即抛出
TypeError。
这种机制保证了任何异常都不会“悄无声息”地向后蔓延,适合单次业务逻辑判断或对数据合规性要求极其苛刻的场景。
2. numpy.log 的 IEEE 754 容错流机制
在海量数据矩阵(如深度学习特征提取、百万级气象数据批处理)中,只要其中有一个元素为 0 或负数,如果直接崩溃终止,会导致前续所有的计算资源白白浪费。因此,numpy.log 遵循 IEEE 754 浮点运算标准:
- 输入 0:抛出运行时警告
RuntimeWarning: divide by zero encountered in log,在对应索引位置写入负无穷大-inf。 - 输入负数:抛出运行时警告
RuntimeWarning: invalid value encountered in log,在对应索引位置写入非数值nan。 - 输入已有 NaN:静默传递,输出
nan。
这种差异直接决定了数据预处理工程的代码编写方式。如果在批处理中希望保持计算链条,且在完成后统一清洗,NumPy 提供了极其优雅的向量化清洗工具:
import numpy as np

raw_array = np.array([10.0, 0.0, -5.0, np.nan, 100.0])

# 进行对数运算:输出警告,但程序保持运行
log_result = np.log(raw_array)
# 此时 log_result 内容为:array([2.30258509, -inf, nan, nan, 4.60517019])

# 工程实践:利用 np.nan_to_num 或掩码进行后续向量化修复与清洗
cleaned = np.nan_to_num(log_result, nan=0.0, neginf=-999.0)
print("清洗后的数组:", cleaned)
# 输出示例:[   2.30258509 -999.            0.            0.            4.60517019]
四、基准性能测试与资源开销
很多开发者有一种盲目信任:“NumPy 是 C 写的,所以无论什么情况都肯定比原生 Python 快”。这种认知在对数计算中是存在片面性的。
| 测试场景 | math.log 表现 | numpy.log 表现 | 胜出者与原因剖析 |
|---|---|---|---|
| 单标量调用 (Single Float) 100 万次独立标量计算 |
约 0.05 秒 (每次约 50 ns) |
约 0.42 秒 (每次约 420 ns) |
math.log 胜出(快 8~10 倍) math.log 直接命中 C 底层,没有参数检测、广播推导与 ndarray 标量封装成本。 |
| 小规模列表 (1,000 元素) 列表推导 vs np.log |
约 0.07 毫秒 | 约 0.02 毫秒 | numpy.log 胜出(快约 3.5 倍) 向量化优势开始显现,弥补了初始调用的开销。 |
| 大规模数组 (1,000,000 元素) 连续内存百万浮点批处理 |
约 75 毫秒 [math.log(x) for x in list] |
约 1.8 毫秒 np.log(arr) |
numpy.log 完胜(快 40 倍以上) 连续内存 + CPU SIMD 矢量化并行指令,完全释放硬件算力吞吐。 |
| 内存空间占用 (1,000,000 浮点数) | 约 8 MB (PyList 指针) + 约 24 MB (独立 PyFloat) |
精准 8 MB (连续 64 位浮点内存块) |
numpy.log 完胜(内存节省 75%) 无任何对象头、引用计数器等冗余元数据开销。 |
五、工程选型决策路径与最佳实践
为了让不同应用场景下的选型不再模棱两可,我们可以依据数据结构形态、调用频次与容错需求,遵循以下决策树流程:
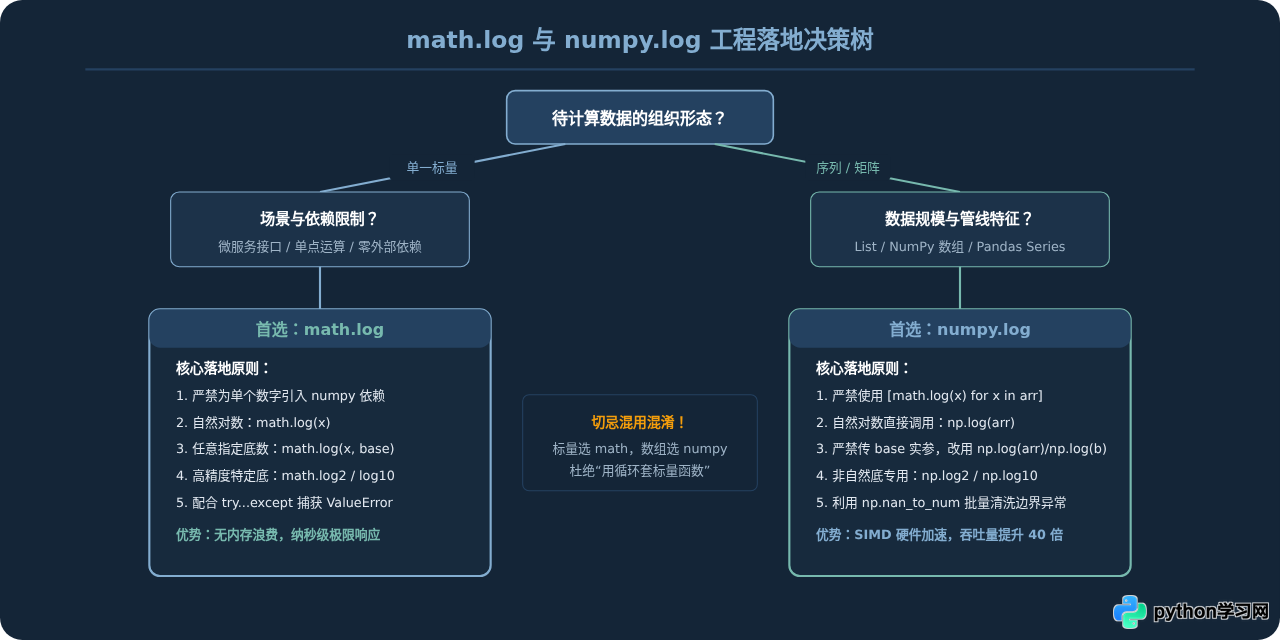
六、总结与避坑清单
为了确保在实际项目中写出无懈可击的数学运算代码,请牢记以下四大避坑守则:
- 不要为标量引入大炮:在纯轻量级工具脚本或 Web API 内部计算单一公式时,直接使用内置标准库
math.log,避免打包体积膨胀和数百纳秒的额外派发开销。 - 绝不对序列使用列表推导套 math.log:如果你面对的是列表、Pandas 列或 ndarray,务必将其一次性交付给
np.log()执行。用 Python 循环遍历单个标量函数是典型的数据处理反模式。 - 谨防 numpy.log 的第二个参数陷阱:牢记
np.log(x, base)是语法毒药,第二个参数是 ufunc 的out缓冲区。指定任意底数只认准换底公式np.log(x) / np.log(base)。 - 关注静默异常与数据清洗:
numpy.log面对非正数不会打断程序,务必在批量计算完成后通过np.isnan()、np.isneginf()或np.nan_to_num()完成数据过滤,防止nan像病毒一样污染后续所有下游模型。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















