


Python列表与字典操作指南:零基础掌握常用数据结构
面向零基础学习者的Python列表与字典操作指南。详细讲解列表与字典的底层逻辑、核心操作步骤、应用对比及高频避坑建议。
在编写 Python 程序时,单一的基础数据类型(如数字、字符串)通常只能表达孤立的信息。面对实际场景中的成组数据或复杂实体,我们需要依赖容器型数据结构来高效组织与访问。在 Python 提供的内置容器中,列表(List)与字典(Dictionary)是使用频率最高、适用场景最广泛的两种结构。掌握它们的底层逻辑、核心增删改查语法以及各自的边界,是零基础学习者从简单计算迈向实际编程开发的关键一步。
一、认识数据结构:序列排队与标签映射
初学者在面对容器时,最核心的困惑往往在于“什么时候用列表,什么时候用字典”。理解它们的根本差异,在于看清两者的内部组织逻辑。
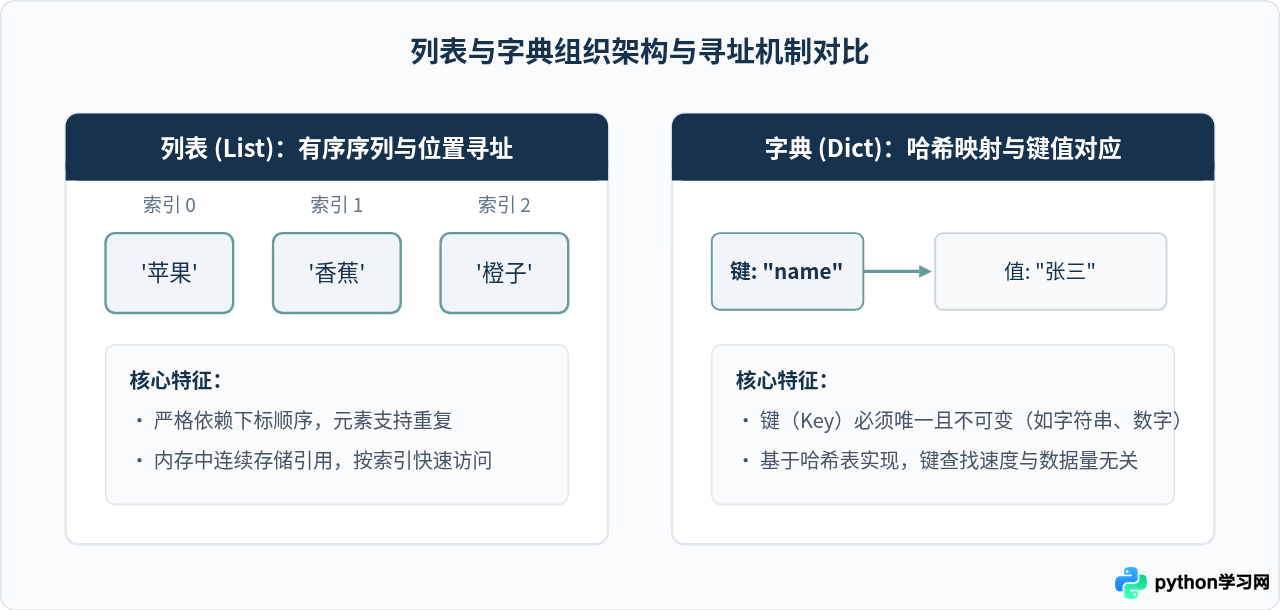
列表(List)是一个有序的集合,就像一条排列整齐的队列。列表中的每一项元素都有明确的前后顺序,并且系统自动给每一项分配了一个从 0 开始递增的整数编号,这个编号被称为“索引”(Index)。当你需要保存有先后次序、支持重复、强调排列位置的一组数据时(例如学生的成绩排单、按时间发生的待办事项),列表是第一选择。
字典(Dictionary)则是一个无序或按插入顺序维护的“键值对”(Key-Value Pair)集合。它就像现实生活中的一本新华字典或通讯录:查词不需要一页页数第几个词,而是直接根据拼音或人名索引到具体的电话号码。在字典中,我们使用自定义的“键”(Key)去精准定位对应的“值”(Value)。当你需要描述一个具有多个属性的具体对象,或者需要按特定标识快速检索数据时,字典具有不可替代的效率优势。
二、列表的核心操作与数据处理流程
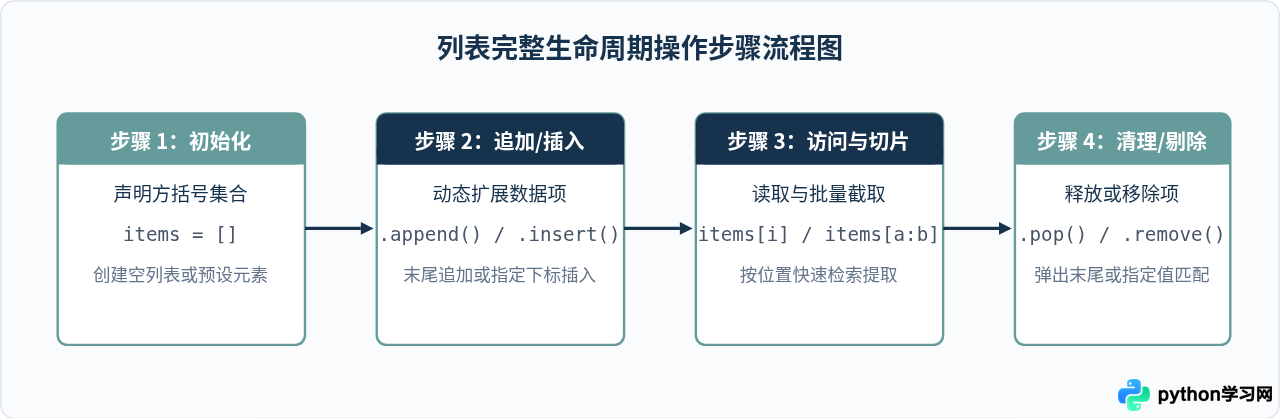
在 Python 中,列表用方括号 [] 标识,元素之间使用英文逗号 , 分隔。对列表的操作可以归纳为四类基本动作:创建、增补、查找/修改、删除。
1. 列表操作核心执行步骤
为了让读者直观掌握列表处理的典型执行链路,我们可以把对列表数据的处理抽象为标准的操作流水线:
2. 列表常用操作完整代码示例
以下示例展示了从创建列表开始,逐步执行追加、插入、修改、切片读取与删除的全流程代码。请在 Python 3 环境中直接运行验证:
# 1. 列表初始化
fruits = ["苹果", "香蕉", "橙子"]

# 2. 增加元素
fruits.append("葡萄")        # 在列表末尾追加:"葡萄"
fruits.insert(1, "草莓")     # 在索引 1 的位置插入:"草莓",后续元素后移

# 3. 读取与切片
first_item = fruits[0]      # 读取首个元素 -> "苹果"
sub_list = fruits[1:3]      # 左闭右开切片,获取索引 1、2 的元素 -> ["草莓", "香蕉"]

# 4. 修改元素
fruits[2] = "熟香蕉"         # 将索引 2 的元素直接赋值替换

# 5. 删除元素
popped_item = fruits.pop()  # 弹出末尾元素并返回该元素 -> "葡萄"
fruits.remove("草莓")       # 根据内容查找并移除首个匹配的 "草莓"

print("最终水果列表:", fruits)
print("被弹出的元素:", popped_item)
示例输出:
最终水果列表: ['苹果', '熟香蕉', '橙子']
被弹出的元素: 葡萄避坑提示:使用索引访问列表时,如果传入的下标大于等于列表长度(例如只有 3 个元素却访问 fruits[3]),Python 会抛出 IndexError: list index out of range。在不确定长度时,可使用 len(fruits) 提前确认安全范围。
三、字典的核心操作与安全查询机制
字典使用大括号 {} 声明,每个条目采用 键: 值 的形式。字典最显著的特性是快速定位:无论字典中有十个元素还是一百万个元素,通过键查找对应的值都在几乎恒定的极短时间内完成。
1. 字典核心操作方法与语法
- 创建字典:
user = {"id": 101, "name": "李四", "role": "admin"} - 写入与修改:
user["email"] = "lisi@example.com"(若键不存在则新增,若键已存在则直接覆盖旧值)。 - 常规读取:
name = user["name"]。若键不存在,程序会直接抛出KeyError异常。 - 安全读取(强烈推荐):
role = user.get("role", "guest")。当键不存在时,不会崩溃,而是返回预设的默认值"guest"。 - 删除键值对:
del user["role"]或email = user.pop("email")。
2. 字典实战代码示例
# 初始化学生档案字典
student = {
    "name": "王小明",
    "grade": "三年级",
    "score": 92
}

# 动态增加联系方式,并更新分数
student["contact"] = "13800000000"
student["score"] = 95

# 安全获取可能缺失的属性字段
address = student.get("address", "未知地址")
gender = student.get("gender", "未登记")

print(f"学生姓名: {student['name']}, 当前分数: {student['score']}")
print(f"居住地址查询结果: {address}")

# 遍历字典的所有键值对
for key, value in student.items():
    print(f"属性 [{key}] -> {value}")
示例输出:
学生姓名: 王小明, 当前分数: 95
居住地址查询结果: 未知地址
属性 [name] -> 王小明
属性 [grade] -> 三年级
属性 [score] -> 95
属性 [contact] -> 13800000000
四、列表与字典的核心维度全方位对比
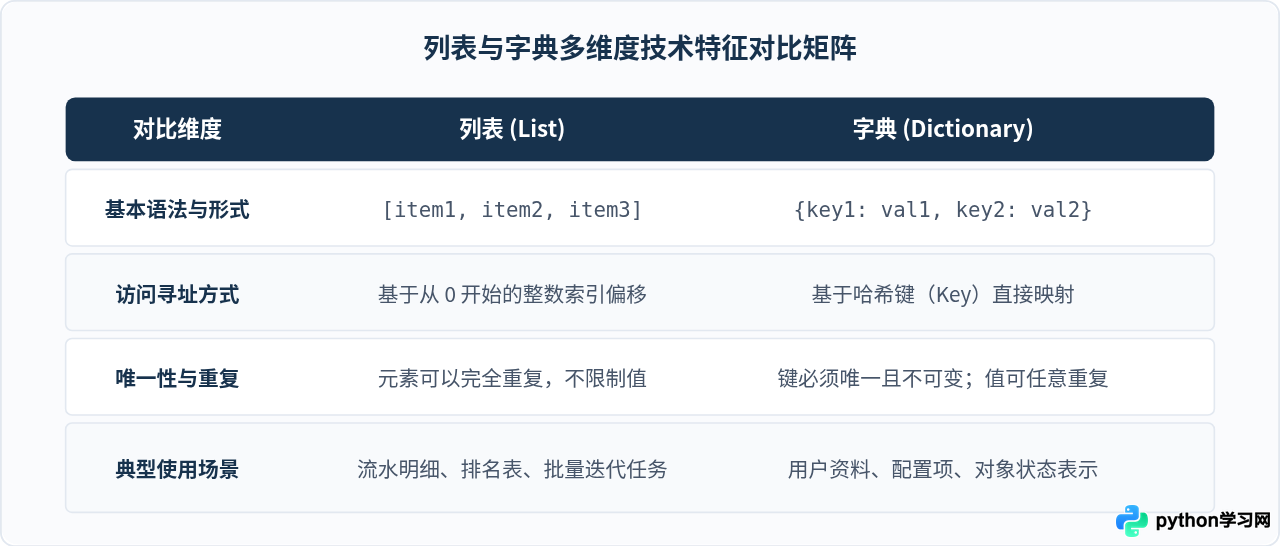
为了让初学者更直观地形成技术选型意识,我们从结构特性、访问机制、性能特征和适用场景对两者进行横向梳理:
五、嵌套结构与复合实战
在现实业务中,单一的列表或字典往往难以描述全部层级关系。最常见的模式是“列表嵌套字典”,例如从数据库或网络接口中获取的一组商品列表:
# 电子商城购物车数据(列表中嵌套多个字典)
cart = [
    {"id": "A101", "name": "机械键盘", "price": 299, "count": 1},
    {"id": "A102", "name": "无线鼠标", "price": 129, "count": 2},
    {"id": "A103", "name": "超大鼠标垫", "price": 49, "count": 1}
]

# 遍历购物车,统计总金额
total_price = 0
for item in cart:
    subtotal = item["price"] * item["count"]
    total_price += subtotal
    print(f"商品: {item['name']}, 单价: ¥{item['price']}, 数量: {item['count']}, 小计: ¥{subtotal}")

print("--------------------------------")
print(f"购物车结算总额: ¥{total_price}")
示例输出:
商品: 机械键盘, 单价: ¥299, 数量: 1, 小计: ¥299
商品: 无线鼠标, 单价: ¥129, 数量: 2, 小计: ¥258
商品: 超大鼠标垫, 单价: ¥49, 数量: 1, 小计: ¥49
--------------------------------
购物车结算总额: ¥606
六、初学者常见误区与避坑指南
在初学阶段,由于对可变类型理解不够深入,容易踩入以下几个典型陷阱:
- 误区一:边循环遍历列表边执行
remove()删除。 当从列表中删除某个元素时,后续元素的索引会立刻向前平移一位,导致循环索引跳过某些项。解决办法是:对原列表的切片副本进行遍历,或者使用列表推导式生成过滤后的新列表。 - 误区二:使用可变对象(如列表)作为字典的键。 字典的键必须可哈希(不可变),因此整数、浮点数、字符串、元组都可以作为键,但如果使用列表作为键,Python 会报
TypeError: unhashable type: 'list'。 - 误区三:直接使用等号复制列表造成变量混淆。
list_b = list_a并没有复制一份新的列表,它们指向内存中的同一个列表对象。修改list_b会导致list_a同步改变。若需独立副本,请使用list_b = list_a.copy()或list_b = list_a[:]。
七、知识总结与选型决策指南
为了在实际编码过程中迅速做出准确判断,读者可参考以下决策路径:
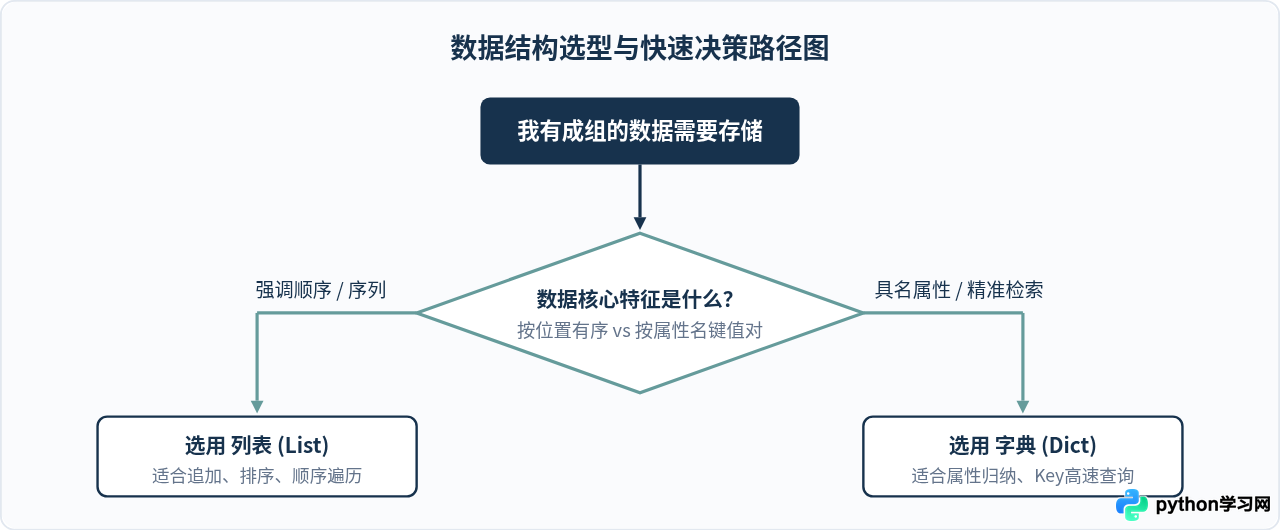
总的来说,列表和字典构成了 Python 处理结构化数据的基础骨架。记住两个核心原则:“关心位置排前后,使用列表;关心标签找对应,使用字典”。在日常练习中多结合两者的嵌套形式,就能轻松应对绝大多数实际业务场景的数据建模需求。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















