


Python切片技巧:怎么省略参数进行浅拷贝和隔项取值
深入解析Python切片中省略参数的底层运行机制,详解如何通过[:]实现列表浅拷贝,利用[::2]进行奇偶隔项取值与步长控制,以及内存引用与边界处理注意事项。
在 Python 中,切片操作符 [start:stop:step] 是处理列表、字符串和元组等有序序列最频繁使用的语法工具之一。初学者往往习惯显式传入每一个索引位置,但在实际工程开发中,合理省略冒号前后的参数,不仅能显著精简代码行数,还能高效实现诸如独立浅拷贝生成与等步长隔项采样等典型需求。本文将直击这两种最实用的切片场景,详细剖析参数缺省时的底层解析规则与内存表现。
一、切片基本结构与参数省略的缺省逻辑
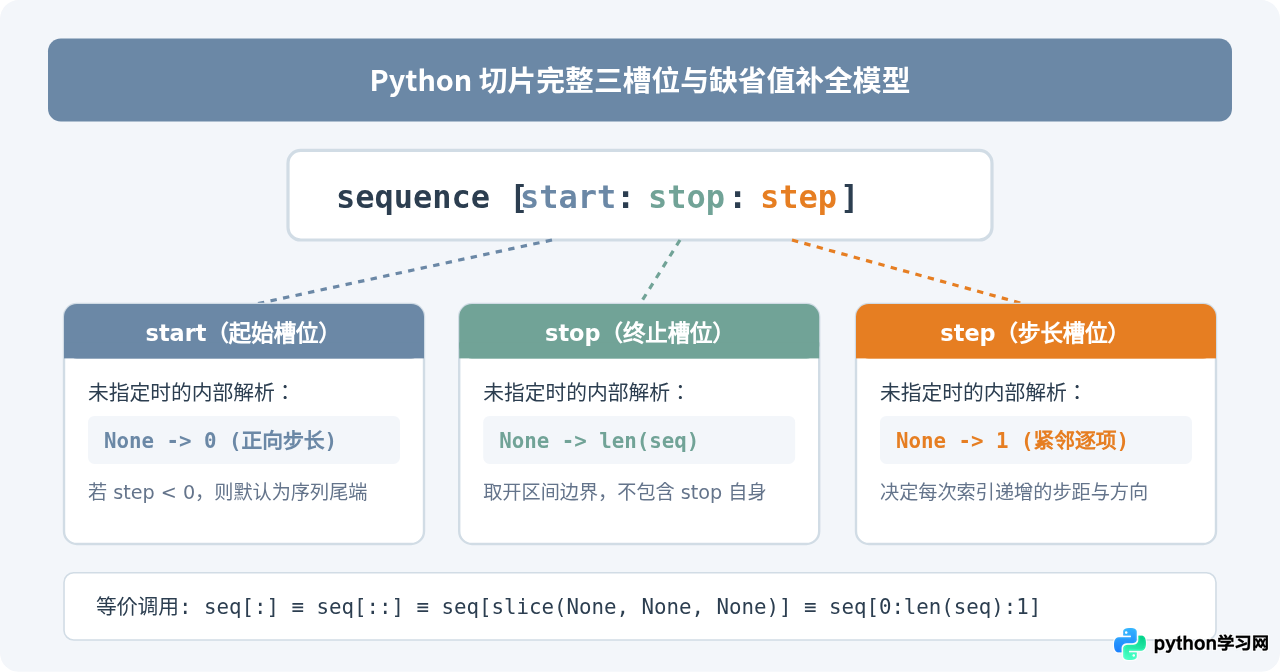
Python 切片完整语法由三个用冒号分隔的槽位组成:sequence[start:stop:step]。当开发者不填写具体整数时,Python 解释器并不会报出语法错误,而是自动将其对应位置赋为 None,并按照步长的正负方向套用内建默认值:
- start(起始索引):若省略且
step > 0(或未指定步长),默认取序列最左端0;若step < 0,默认取最右端-1。 - stop(终止索引,开区间):若省略且
step > 0,默认取序列总长度len(sequence);若step < 0,默认延伸包含序列第一个元素。 - step(步长与步进方向):若省略第二个冒号及后面的数值,默认值固定为
1,表示紧邻逐项向右提取。
这意味着表达式 lst[:]、lst[::] 与 lst[0:len(lst):1] 在逻辑结果上完全等价,均代表提取序列从头至尾的全部元素。
二、完全省略参数:利用 [:] 实现高效浅拷贝
在 Python 中对一个既有列表进行赋值操作时,常见的写法是直接变量赋值:b = a。但此时 b 仅仅是原列表 a 的另一个引用别名,二者在内存中指向完全相同的容器对象。一旦修改 b 中的元素,a 也会同步变更。
若希望得到一份既有元素的独立备份,最轻量级且广为采用的做法便是省略全部参数,执行 copied_list = original[:]。
1. 浅拷贝的操作代码与行为验证
通过下方代码可以清晰观察直接赋值与切片浅拷贝的本质差异:
# 原始一维列表
original = [10, 20, 30]

# 直接引用赋值 vs 切片拷贝
alias_list = original
sliced_list = original[:]

# 身份判断 (内存对象是否相同)
print(alias_list is original)   # 输出: True  (指向同一底层列表)
print(sliced_list is original)  # 输出: False (切片创建了全新的列表容器)

# 修改切片副本
sliced_list[0] = 999
print(sliced_list)  # 输出: [999, 20, 30]
print(original)     # 输出: [10, 20, 30] (原列表内容保持不变)
2. “浅”拷贝的边界与潜在陷阱
切片所实现的拷贝被严格定义为浅拷贝(Shallow Copy)。其根本原因在于:Python 的列表本身并不直接存放具体数值对象,而是存放指向这些对象的指针集合。当使用 original[:] 时,Python 确实在堆内存中开辟了一块全新的列表容器空间,但该新容器内的元素指针仍然原封不动地指向原列表所引用的各个对象。
如果列表中包含可变对象(如嵌套列表、字典),新旧列表将共同引用这些子对象:
# 含有可变子对象的嵌套列表
nested_orig = [1, [20, 30]]
nested_copy = nested_orig[:]

# 修改最外层非嵌套元素
nested_copy[0] = 100
print(nested_orig[0])  # 输出: 1 (外层容器互不干扰)

# 修改共享的嵌套子列表
nested_copy[1].append(40)
print(nested_orig[1])  # 输出: [20, 30, 40] (原列表中的子对象也被修改了!)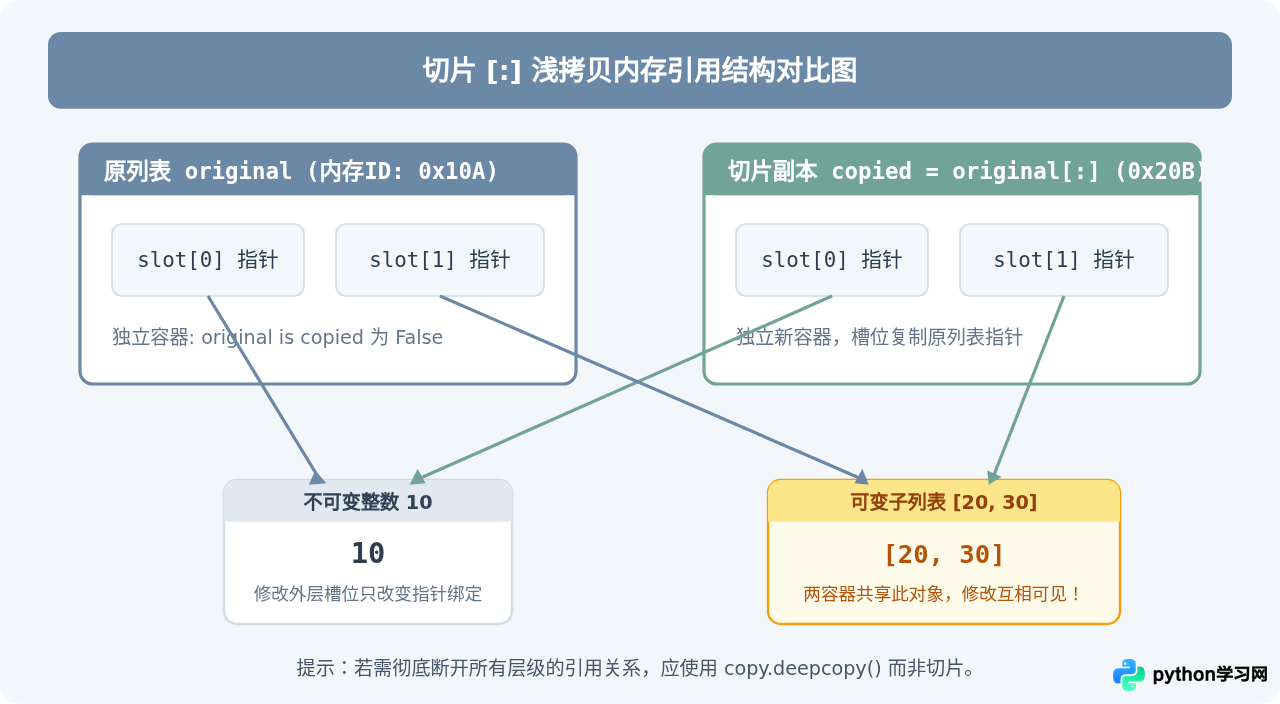
三、省略部分参数:利用步长进行隔项取值与采样
在数据清洗、序列处理或算法编写中,经常需要按特定频率提取序列中的元素,例如“抽取全部奇数位置的数据”或“每隔一个元素采样一次”。此时保留 step 步长参数,同时根据需求省略 start 或 stop,是最地道(Pythonic)的解法。
1. 偶数项与奇数项的隔项提取
列表索引自 0 开始计算。通过设置 step=2,可以轻松实现序列的交替取值:
- 提取偶数索引元素(第 1, 3, 5... 项):省略
start和stop,编写sequence[::2]。此时start自动取0,stop自动取末尾。 - 提取奇数索引元素(第 2, 4, 6... 项):将
start明确指定为1,同时省略stop,编写sequence[1::2]。
items = ["A", "B", "C", "D", "E", "F", "G", "H"]
# 对应索引:  0    1    2    3    4    5    6    7

# 1. 抽取偶数索引项 (索引 0, 2, 4, 6)
even_items = items[::2]
print(even_items)  # 输出: ['A', 'C', 'E', 'G']

# 2. 抽取奇数索引项 (索引 1, 3, 5, 7)
odd_items = items[1::2]
print(odd_items)   # 输出: ['B', 'D', 'F', 'H']
2. 限定区间范围的隔项截取
如果不需要扫描整个序列,而是仅在指定前 N 项或特定区间内执行隔项提取,只需补全 start 或 stop 中的某一个:
numbers = list(range(10))  # [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]

# 仅在前 6 个元素中隔项取值 (省略 start,限定 stop=6)
print(numbers[:6:2])   # 输出: [0, 2, 4]

# 从索引 3 开始向后每隔 2 项取一个 (限定 start=3,省略 stop)
print(numbers[3::2])   # 输出: [3, 5, 7, 9]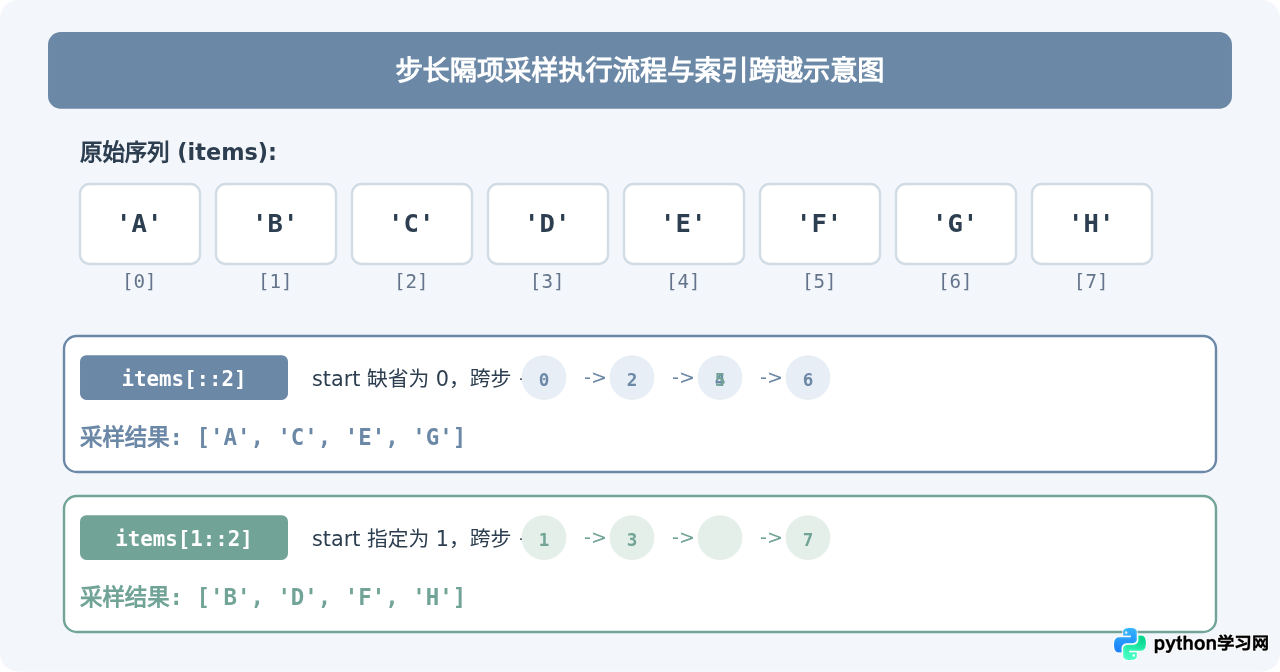
3. 负步长下的参数省略与逆序翻转
当 step 被赋为负整数(最典型的是 step = -1)时,省略参数的默认规则会发生对称性翻转:
sequence[::-1]:省略start时,默认起点不再是0,而是序列最末尾元素的索引(即len-1);省略stop时,默认终点延伸越过索引0(包含首项)。因此该写法能以极简语法生成序列的倒序排列新副本。sequence[::-2]:从末项开始,反向隔项向前倒序抽取。
letters = ["A", "B", "C", "D", "E"]

# 完整逆序生成
print(letters[::-1])  # 输出: ['E', 'D', 'C', 'B', 'A']

# 逆序隔项抽取
print(letters[::-2])  # 输出: ['E', 'C', 'A']
四、常见避坑指南与边界特性
掌握了参数省略的核心逻辑后,在实际项目编码中还需留意以下三项容易忽视的关键细节:
1. 字符串与元组的切片优化
对列表执行 lst[:] 时,由于列表是可变对象(Mutable),Python 必须在内存中开辟全新列表容器以保证隔离性。然而,若对不可变对象(如 str、tuple)执行 s[:],Python 解释器在内部通常会直接返回原对象的引用,而不会浪费内存开辟新对象(s[:] is s 返回 True)。因此,不要试图通过 str[:] 来期望切断不可变对象的内存身份。
2. 越界安全机制
与单元素索引取值(sequence[100] 会直接触发 IndexError)不同,切片操作对越界索引具有天然容错性:
nums = [1, 2, 3]

# 索引越界安全截断
print(nums[:100])    # 输出: [1, 2, 3],自动以 len(nums) 作为物理边界
print(nums[10:20])   # 输出: [],范围内无有效元素时返回空列表,不会抛出异常
3. 多维原生切片的语法限制
许多习惯使用 NumPy 或 Pandas 的开发者常误将多维矩阵切片写法 matrix[:, 1] 直接用于原生 Python 嵌套列表,这会引发运行时错误:
matrix = [[1, 2], [3, 4]]
# 错误写法: matrix[:, 1]
# 抛出异常: TypeError: list indices must be integers or slices, not tuple

# 原生 Python 正确写法: 借助列表推导式提取某一列
column_1 = [row[1] for row in matrix]
print(column_1)  # 输出: [2, 4]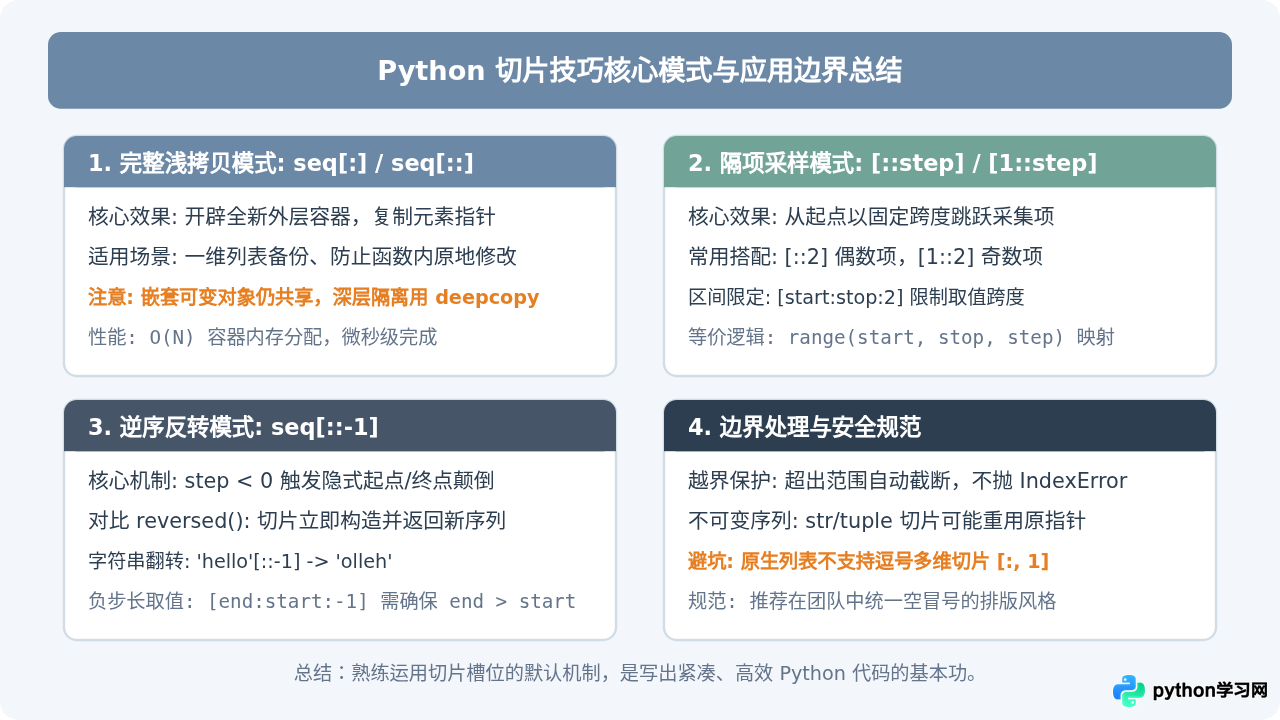
五、总结速查表
为了便于日常编码时快速核对,下表系统梳理了省略不同槽位参数时的常见切片形式与对应行为:
| 切片表达式 | 省略的参数槽位 | 等效内部展开形式 | 典型业务用途 |
|---|---|---|---|
seq[:] |
start, stop, step | seq[0:len(seq):1] |
一维可变列表的浅拷贝(创建独立新容器) |
seq[::2] |
start, stop | seq[0:len(seq):2] |
提取偶数项(索引 0, 2, 4...)或等距降采样 |
seq[1::2] |
stop | seq[1:len(seq):2] |
提取奇数项(索引 1, 3, 5...) |
seq[:5:2] |
start | seq[0:5:2] |
在前 5 项内进行隔项采样 |
seq[::-1] |
start, stop | seq[-1:-(len+1):-1] |
序列的全量倒序排列生成 |
只要理清 start、stop 与 step 在缺失时的默认回退原则,并时刻保持对内存中对象可变性的敏锐度,就能在保证代码健壮性的前提下,充分发挥 Python 切片简洁与优雅的表达优势。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















