


Python列表索引基础:正向与负数下标访问详解
深入解析Python列表的正向与负数下标访问机制,讲解底层推导转换原理、边界约束、IndexError排查及安全访问实践。
在 Python 中,列表(list)是一种有序、可变的序列容器。要提取或修改列表中的某个特定元素,最直接、最高效的手段就是通过“索引”(Index,又称下标)进行定位。Python 同时提供了自左向右的正向下标和自右向左的负数下标两种访问模式。本文将全面拆解这两种索引体系的对应关系、底层计算机制、常见操作模式及越界错误的防护策略,帮助读者扎实掌握列表的基础寻址逻辑。
一、双向索引体系:概念与映射对照
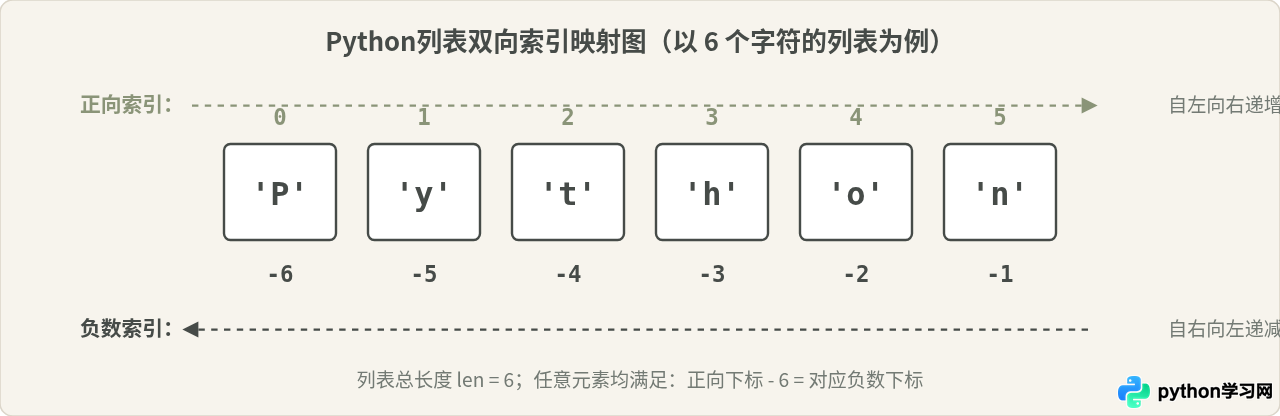
Python 序列的一个重要特征是支持“双向索引”。无论列表中存放的是字符串、数字还是其他对象,每个槽位在逻辑上都同时对应两个坐标:一个正数坐标和一个负数坐标。
- 正向下标(从 0 开始):表示从序列起始端开始偏移。第一个元素的下标是
0,第二个元素是1,依此类推,最后一个元素的下标是len(list) - 1。 - 负数下标(从 -1 开始):表示从序列末尾端逆向计数。倒数第一个元素是
-1,倒数第二个元素是-2,最前端的第一个元素对应下标-len(list)。
为什么负数索引是从 -1 开始,而不是从 -0 开始?在数学与计算机编码中,数值 +0 与 -0 等价,因此 -0 依然是 0。如果负数索引从 -0 开始,它就会直接指向序列的首个元素,从而破坏逆向计数的唯一性。因此,负向坐标从 -1 切入,完美避开了与零原点的冲突。
二、负数下标的底层运作机制
在底层实现中,计算硬件并不存在“反向物理地址”的概念。计算机内存地址是单向线性递增的。Python 虚拟机(CPython)在处理负数下标时,并没有建立两套独立的查找表,而是在读取时执行了一次非常高效的算术转换。
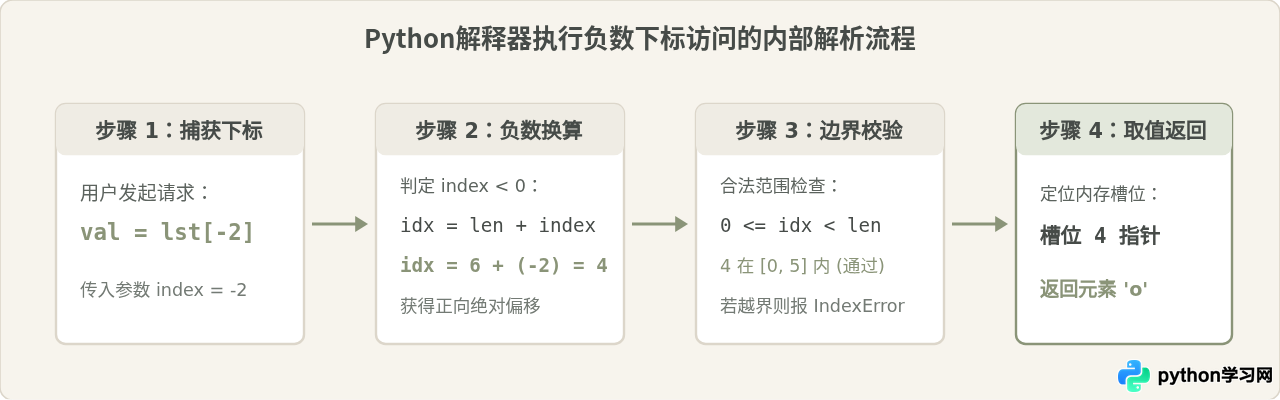
当开发者输入一个负数下标 index 时,解释器内部会自动将其与列表当前的元素个数 len(list) 相加:
actual_index = len(list) + index例如,对于长度为 6 的列表,访问 lst[-1] 在底层等价于 lst[6 + (-1)],即 lst[5];访问 lst[-2] 等价于 lst[6 + (-2)],即 lst[4]。这种转换完全由 CPython 底层在 C 语言层面完成,仅耗费一次寄存器加法指令,因此负数索引的执行开销微乎其微,与正向索引相比几乎没有性能差异。
三、核心操作实战:读取与就地修改
通过索引不仅可以“读取”对应位置的对象,还可以通过赋值语句对该位置“就地修改”(In-place modification)。
1. 元素读取示例
使用方括号语法 list[index] 即可取得指定下标的元素:
# 创建示例水果列表
fruits = ["apple", "banana", "cherry", "date", "elderberry"]

# 1. 使用正向索引读取首个及中间元素
first_item = fruits[0]
third_item = fruits[2]

# 2. 使用负数索引读取末尾及倒数元素
last_item = fruits[-1]
second_to_last = fruits[-2]

print("首个元素:", first_item)
print("第三个元素:", third_item)
print("末尾元素:", last_item)
print("倒数第二:", second_to_last)首个元素: apple
第三个元素: cherry
末尾元素: elderberry
倒数第二: date
2. 元素修改示例
列表是可变序列,只要该索引在有效范围内,即可直接使用 list[index] = new_value 更新原位置的内容:
scores = [88, 92, 79, 95]

# 将正向索引为 1 的项(92)修改为 94
scores[1] = 94

# 将倒数第一项(95)修改为 100
scores[-1] = 100

print("更新后的列表:", scores)更新后的列表: [88, 94, 79, 100]
关键限制提示:索引赋值只能覆盖“已经存在”的元素位置,绝不能通过索引赋值来扩展列表长度。例如,对于包含 4 个元素的列表,执行 scores[4] = 99 不会像某些弱类型脚本语言那样自动填充空洞并扩容,而是会直接抛出 IndexError。若需向末尾追加新元素,必须使用 scores.append(99)。
四、边界条件与 IndexError 异常排查
初学者在使用列表下标时最容易遇到的报错是 IndexError: list index out of range。理解列表下标的严格合法边界,是编写稳定代码的前提。
1. 合法索引区间
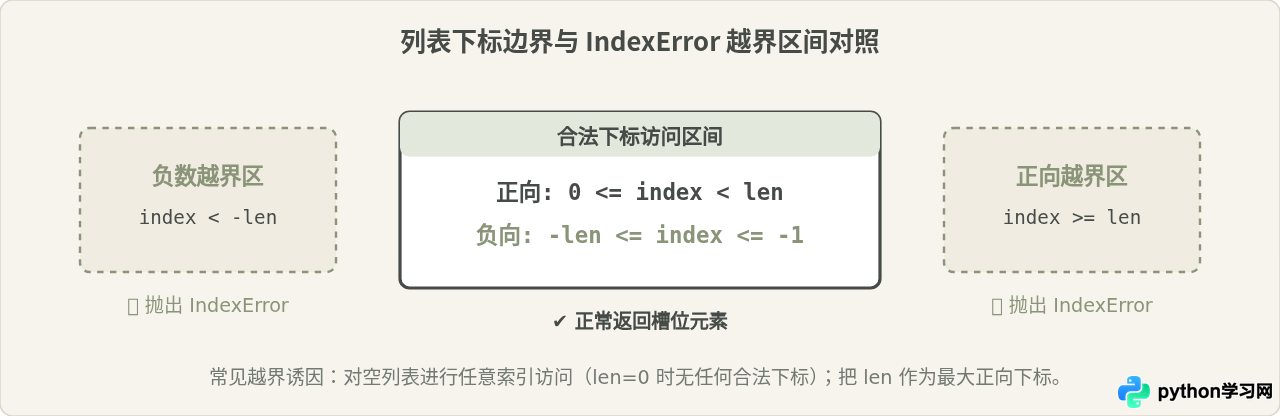
设列表长度为 $N = \text{len}(lst)$:
- 正向下标有效闭区间:$[0, N - 1]$
- 负数下标有效闭区间:$[-N, -1]$
一旦输入的下标 $\ge N$ 或 $< -N$,Python 解释器在步骤 3 的范围校验阶段便会中断执行并抛出异常。
2. 两种典型越界场景与防御写法
场景一:“差一错误”(Off-by-one Error):由于习惯从 1 开始数数,误以为末尾元素的正向下标是 len(lst)。事实上,末尾下标永远是 len(lst) - 1,而 lst[-1] 是更加优雅、不易出错的写法。
场景二:操作空列表:若列表可能为空,访问 lst[0] 或 lst[-1] 都会引发崩溃。生产环境下推荐采用前置长度判断或异常捕获进行防御:
def get_latest_log(log_list):
    # 防御方式 1:前置判空
    if not log_list:
        return "暂无日志"
    return log_list[-1]

def safe_fetch(items, idx):
    # 防御方式 2:显式捕获 IndexError
    try:
        return items[idx]
    except IndexError:
        return None
五、容易混淆的概念辨析
在讨论列表索引时,常有一些看似合理但不够精确的说法,需要予以辨析:
1. “下标越界在 Python 中只是返回 None”?
辨析:这是与字典 dict.get() 方法混淆产生的误解。列表使用单下标语法访问时,只要越界就会无条件抛出 IndexError,绝对不会默默返回 None。这一严格的设计能够确保逻辑错误尽早暴露,避免错误数据在链路中扩散。
2. “切片(Slicing)和单下标访问是一回事”?
辨析:虽然切片也是通过方括号表达(如 lst[0:10]),但两者的处理逻辑完全不同:
- 单下标索引:返回指定位置的单个元素对象;超出边界时抛出
IndexError。 - 切片访问:返回一个全新的子列表;更重要的是,切片语法对边界极其宽容,即使切片范围超出列表实际长度,Python 也只会返回截断后的结果或空列表,绝不抛出
IndexError。
nums = [10, 20, 30]

# 单下标越界:直接报错
# print(nums[5])  --> 抛出 IndexError

# 切片越界:安全返回空列表,不报错
sub_list = nums[5:10]
print("切片越界结果:", sub_list)切片越界结果: []
六、索引使用场景与避坑决策总结
熟练运用列表下标,可以使代码表意更清晰、逻辑更精简。下表与图示总结了正向与负数下标的常见场景与规范原则。
| 操作目标 | 推荐代码 | 替代但繁琐的写法 | 注意事项 |
|---|---|---|---|
| 获取首个元素 | lst[0] |
lst[-len(lst)] |
必须确保 len(lst) > 0 |
| 获取最后一个元素 | lst[-1] |
lst[len(lst) - 1] |
推荐优先使用负数下标 -1,简洁且不易手误 |
| 获取倒数第 k 个元素 | lst[-k] |
lst[len(lst) - k] |
合法条件为 1 <= k <= len(lst) |
| 原地修改特定位置 | lst[i] = new_val |
- | 下标必须已存在,不可用于新增扩容 |
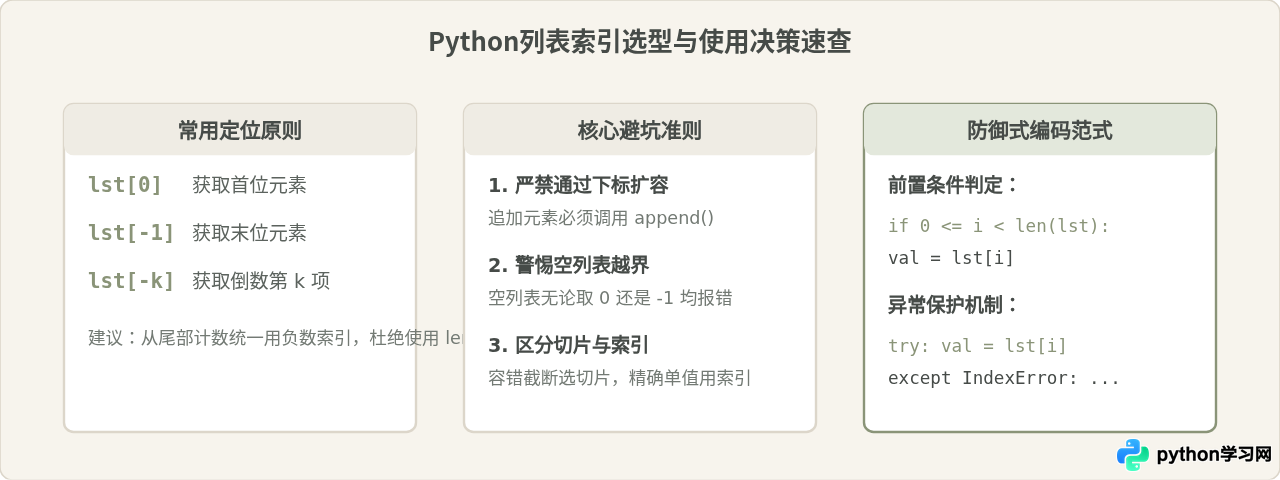
总结而言,Python 的列表索引机制兼顾了严谨性与便利性。正向下标贴合计算机底层的零基偏移习惯,负数下标则提供了优雅的倒序访问语法糖。在实际开发中,理解两者在底层的统一性,牢记合法范围并编写具备前置防御的代码,是写出健壮 Python 程序的坚实基石。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















