


零基础自学Python需要多久?合理的学习路线规划
零基础自学Python通常需要3到6个月。本文详细拆解不同学习目标对应的时间消耗,提供涵盖核心语法、工程素养、专业库及实战项目的四阶段学习路线与每日实操方法。
在每天能够保证 1.5 到 2 小时持续专注投入的前提下,零基础自学者掌握 Python 基础编程并达到独立编写实用脚本通常需要 2 到 3 个月;若要达到具备初级数据分析、自动化测试或后端开发等岗位能力的水平,整体学习周期通常在 4 到 6 个月(累计有效学习时间约为 200 到 300 小时)。学习周期的长短并不取决于记忆了多少语法规则,而取决于目标方向的界定、调试解决报错的独立程度以及实践代码的编写量。本文将围绕不同应用场景下的时间成本测算、四阶段渐进式路线拆解、每日自学闭环执行以及典型陷阱的规避方法展开系统说明。
一、学习周期评估:不同目标所需的真实时间成本
很多人在询问自学时长时,容易把“学完一本语法书”与“能用 Python 解决实际问题”混为一谈。语法知识只是工具箱中的构件,不同业务目标所需的类库生态、计算逻辑与工程规范差异极大,对应的学习周期也截然不同。
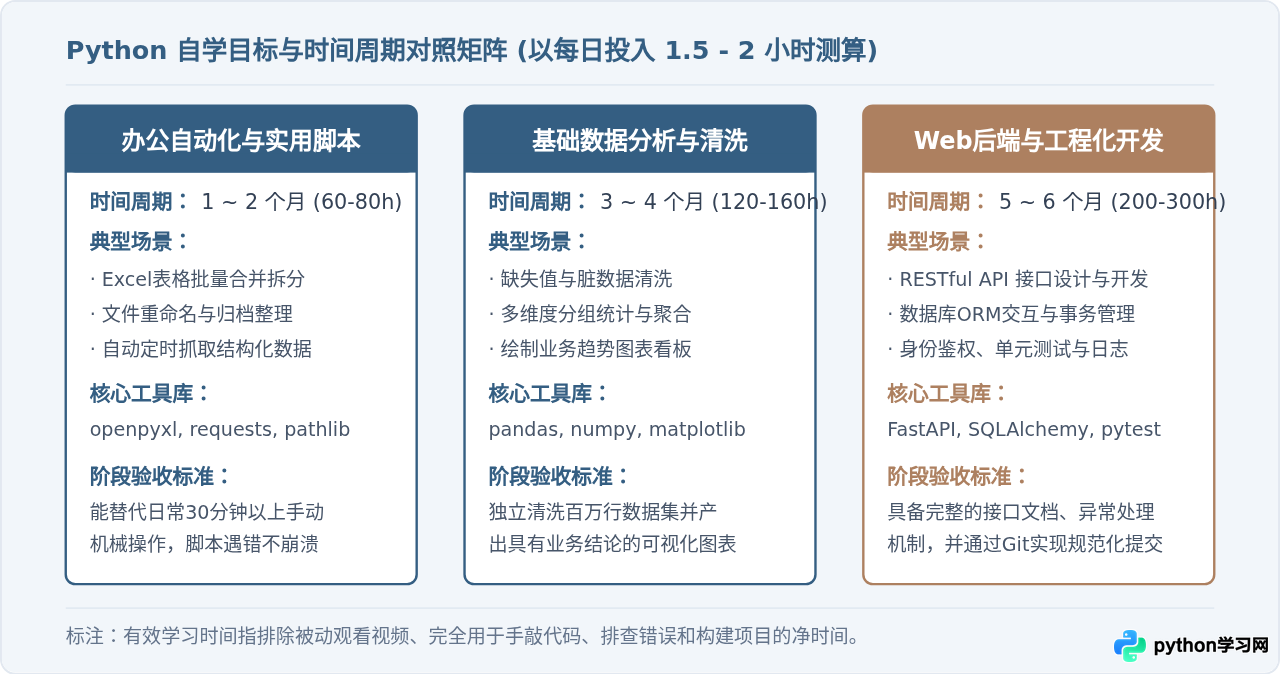
1. 办公自动化与脚本编写(约 1 ~ 2 个月)
如果自学目标是处理本地文件、合并或清洗几百个 Excel 报表、抓取公开网页数据并发送邮件,学习周期相对最短。这一阶段的重点是 Python 的基础语法(变量、列表、字典、循环、判断)以及特定场景的常用库(如 openpyxl、requests、pathlib)。学习者不需要深入掌握复杂的类继承或大型架构设计,只需能够将业务操作转化为自上而下的逻辑流即可。
2. 数据分析与可视化(约 3 ~ 4 个月)
进入数据分析领域后,仅懂基础语法已不足以支撑实际工作。学习者必须掌握矩阵与表格计算的核心库:numpy 与 pandas。这一阶段的难点在于从“单行循环处理”转变为“矢量化数组计算思维”。除了数据清洗、缺失值填充、分组聚合计算外,还需要学会使用 matplotlib 或 seaborn 输出标准化图表,并能够通过 SQL 进行简单的数据读取与关联。
3. Web 后端或自动化测试工程(约 5 ~ 6 个月)
走向职业化开发路径意味着需要理解软件工程的规范化标准。除了 Python 语言本身,还需要理解 HTTP 协议通信细节、关系型数据库(如 SQLite、PostgreSQL)设计、ORM 映射工具(如 SQLAlchemy)、接口框架(如 FastAPI 或 Django)以及版本控制工具 Git。在这一阶段,代码的稳健性、异常捕获规范与单元测试覆盖率成为核心要求。
二、四阶段循序渐进的学习路线规划
合理的路线规划应该保证每个阶段都有明确的交付物。避免在一开始就陷入海量第三方库的琐碎 API 中,而是遵循“核心语法 → 基础工程规范 → 专业库定向深耕 → 完整项目交付”的演进路径。
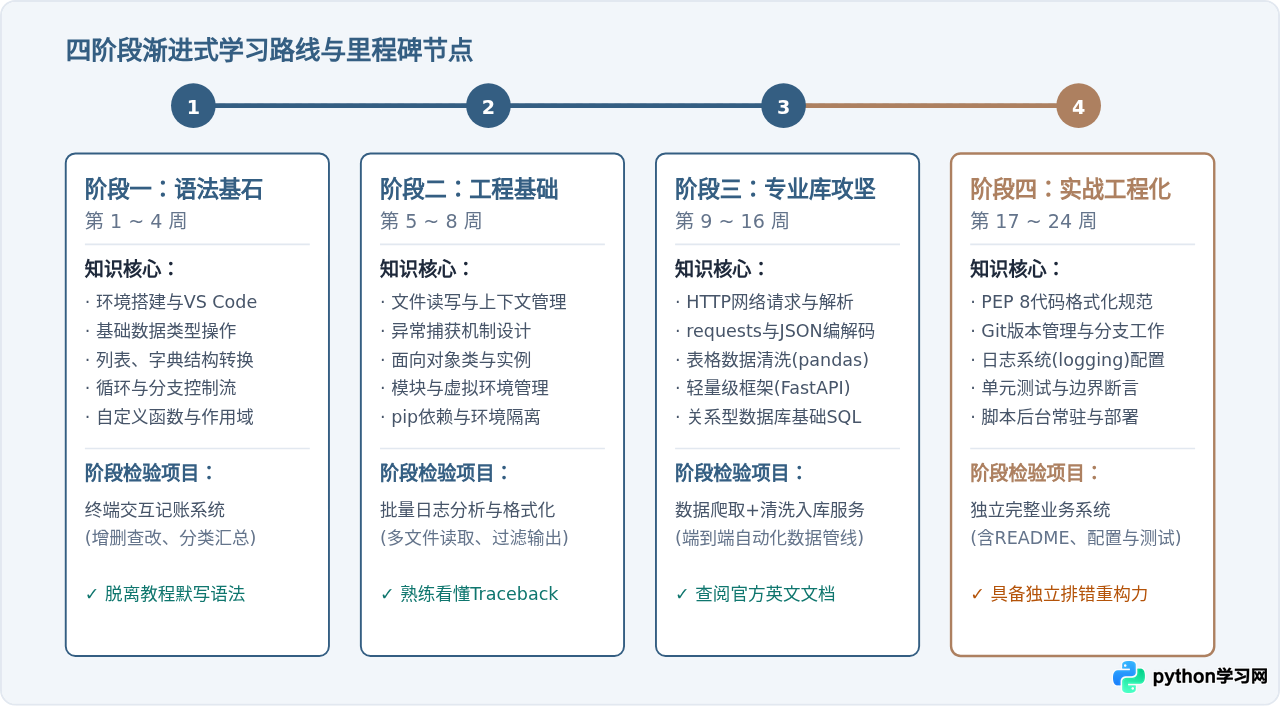
阶段一:语言核心语法与计算思维(第 1 ~ 4 周)
该阶段的目标是掌握 Python 语言的基本控制能力,建立将现实问题转换为计算机逻辑的思维习惯。初学者无需安装庞大的重型 IDE,推荐使用 Python 官方最新稳定版(如 3.10 或更高版本)配合 VS Code 编辑器。
需要系统掌握的核心知识点包括:
- 变量与内存概念:整数(int)、浮点数(float)、布尔值(bool)和字符串(str)的常用操作,字符串格式化(f-string)。
- 组合数据类型:列表(list)的增删查改与切片、元组(tuple)的不可变性、字典(dict)的键值映射机制以及集合(set)的去重特性。
- 控制流逻辑:
if / elif / else条件分支逻辑,for遍历循环与while状态循环,熟练掌握break、continue的控制转移。 - 函数封装:参数传递(位置参数、默认参数、可变参数)、返回值
return以及局部变量和全局作用域的概念。
阶段二:模块化、文件处理与面向对象基础(第 5 ~ 8 周)
自学进入第二个月,代码量逐渐增加,必须从“写单文件面条代码”过渡到“模块化管理”。这一阶段决定了后续代码的可维护性。
重点攻克内容包括:
- 文件系统交互:使用内置的
pathlib库遍历目录、判断文件类型;掌握上下文管理器with open(...)正确读写文本、CSV 和 JSON 文件。 - 异常处理机制:明确常见错误类型(
ValueError、KeyError、FileNotFoundError),掌握try...except...finally结构,学会编写不会因单次脏数据输入而全局崩溃的健壮代码。 - 面向对象编程(OOP):理解类(class)与实例对象(instance),掌握属性定义、
__init__构造函数以及实例方法,学会有节制地使用继承与组合。 - 虚拟环境规范:掌握通过命令行创建虚拟环境与管理依赖的流程,避免全局 Python 环境被污染。
# 虚拟环境配置与依赖管理操作示例 (在项目根目录下执行)
python3 -m venv .venv

# 激活虚拟环境 (macOS / Linux)
source .venv/bin/activate
# Windows PowerShell 执行: .\.venv\Scripts\Activate.ps1

# 安装与导出生产依赖
pip install requests openpyxl pandas
pip freeze > requirements.txt
阶段三:专业方向库与工具链攻坚(第 9 ~ 16 周)
从第三个月开始,必须明确具体的应用方向,不再进行无目的的泛泛学习。根据主流需求,主要分为以下两个典型方向:
方向 A:数据采集与处理分析
- 通过
requests模拟 HTTP 请求,设置 User-Agent 与超时参数,解析 JSON 响应或通过BeautifulSoup解析 HTML 节点。 - 使用
pandas读取多种格式源数据(Excel、CSV、数据库),掌握DataFrame的索引切片、条件过滤、缺失值处理(fillna/dropna)以及分组聚合(groupby)。
方向 B:轻量 Web 开发与自动化测试
- 学习
FastAPI构建符合 RESTful 规范的后端接口,理解路径参数、查询参数、请求体校验机制(Pydantic)。 - 掌握通过
pytest编写单元测试用例,理解测试断言、夹具(fixture)与测试覆盖率的概念。
阶段四:实战项目工程化与交付运维(第 17 ~ 24 周)
最后一个阶段的核心任务是交付一个具备生产可用性的完整项目。很多自学者在写出可用代码后就草草结束,忽略了代码规范和工程化交付,导致在求职或实际协作中暴露严重短板。
工程化交付要求实现:
- 遵循 PEP 8 命名规范,使用类型注解(type hints)提升代码可读性与 IDE 补全效率。
- 使用标准库
logging模块替代随意使用的print(),分别记录 INFO、WARNING、ERROR 级别的带时间戳日志。 - 通过 Git 进行本地版本控制,熟练掌握
git add、git commit、分支新建与合并冲突解决。 - 通过系统定时任务(Linux Crontab 或 Windows 任务计划程序)配置脚本后台静默运行与错误预警。
三、每日高效自学执行工序与学习循环
很多自学者花费了时间却见效甚微,根源在于陷入了“被动看视频”的认知陷阱。编程是一项高度依赖“肌肉记忆”和“排错推理”的实践技能。建立一个固定的单日 90 分钟操作闭环,能够显著提升吸收效率。
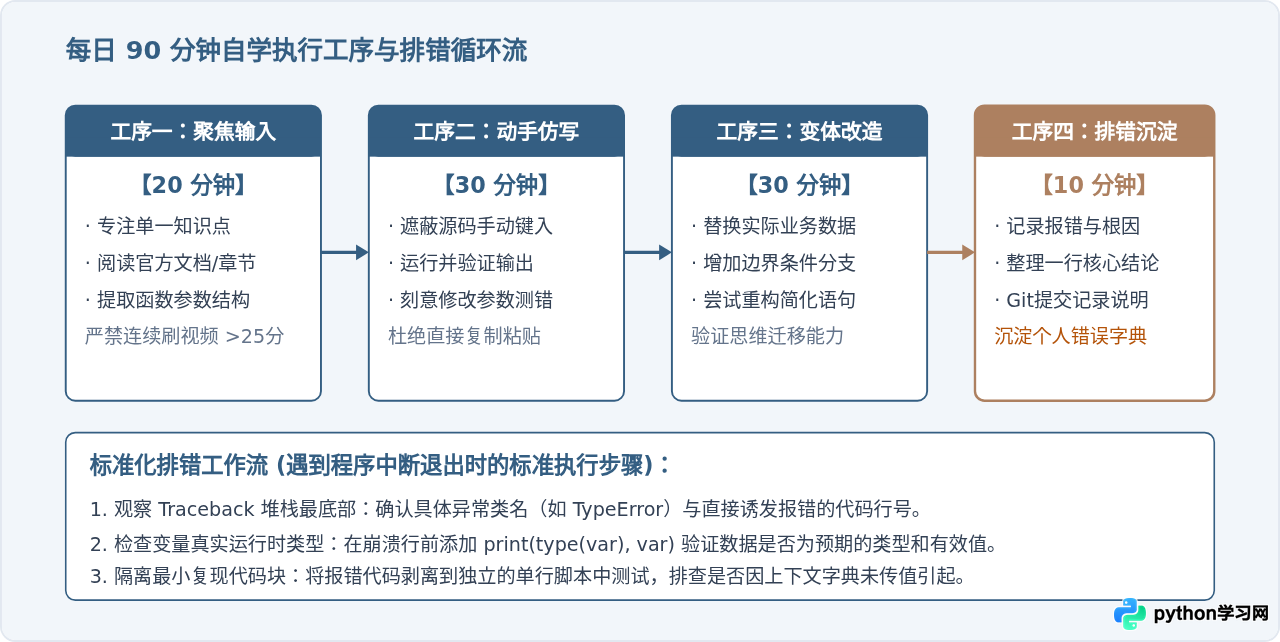
步骤一:单点聚焦输入(20分钟)
每次只学习一个单一知识点或单个库函数的用法。比如今天只学习“列表推导式的条件过滤”,而不是一口气把字典、集合、生成器全部看完。阅读官方文档或精炼教材中的对应小节,在草稿本或编辑器中记录该语法的原型结构。
步骤二:手敲验证与刻意造错(30分钟)
将教程范例最小化,关闭任何代码参考窗口,完全凭借记忆在本地环境敲入代码。运行成功后,主动改变参数、漏写冒号、传入非预期类型,观察终端弹出的错误信息(Traceback)。只有亲眼见过并解决过每种报错,在后续编写大型代码时才不会对报错产生恐惧心理。
# 实操训练:解析日志文件并统计状态码出现频次 (标准完整示例)
from pathlib import Path
from collections import Counter

def analyze_access_log(log_path: Path) -> Counter:
    if not log_path.exists():
        raise FileNotFoundError(f"指定的日志文件不存在: {log_path}")

    status_counter = Counter()

    with log_path.open(mode="r", encoding="utf-8") as file:
        for line_num, line in enumerate(file, start=1):
            line_str = line.strip()
            if not line_str:
                continue
            # 假定单行日志格式为: IP - - [时间] "方法 路径 协议" 状态码 响应长度
            parts = line_str.split()
            if len(parts) >= 9:
                status_code = parts[8]
                status_counter[status_code] += 1
            else:
                # 记录不规则脏数据行,防止程序意外中断
                print(f"[警告] 第 {line_num} 行格式异常,跳过解析")

    return status_counter

# 示例调用
# log_file = Path("access.log")
# result = analyze_access_log(log_file)
# print("状态码统计结果:", dict(result))
步骤三:变体改造与微型拓展(30分钟)
基于刚刚验证通过的代码片段,设计一个贴近自己生活或工作的小需求进行改写。例如:将上述单文件解析逻辑改造成“遍历整个目录下的所有 .log 文件,并将汇总统计结果输出到一个新的 CSV 文件中”。在改造过程中碰壁并查阅文档,是掌握编程知识最快的方式。
步骤四:记录错误沉淀卡片(10分钟)
在练习结束前,用 10 分钟在笔记本或 Markdown 文档中记录今天遇到的核心报错。格式统一为三要素:【出现的错误信息】、【根本原因】、【正确的修复方式】。当这本“排错字典”积累达到 50 条时,自学者通常已经具备了初级的独立编码能力。
四、自学过程中的常见误区与避坑指南
在自学 Python 的过程中,很多人花费了几个月甚至半年时间却无法独立做项目,通常是因为踩入了以下几个典型陷阱:
很多初学者收集了上百 G 的视频课程,每天倍速观看数小时,以为“看懂了视频中的演示”就等于“自己掌握了”。编程本质上是一门输出型技能,被动输入无法建立神经突触连接。检验学习效果的唯一标准是:能否在白纸或空白文件中,独立敲出可运行的代码。
Python 拥有极其庞大的生态系统,哪怕是拥有数年经验的工程师也无法记住所有内置函数和库的入参顺序。学习的重点在于理解数据结构的特性(如哈希表的查找时间复杂度是 O(1),列表的线性查找是 O(n))与模块的设计逻辑。具体的参数名和调用方式应习惯于在终端通过
help(obj) 或官方文档查阅。
自学者在第四阶段选择综合项目时,往往容易设定过大的目标(如做一个完整的电商平台或复杂的分布式爬虫系统)。一旦遇到复杂的前后端鉴权、并发锁或跨源资源共享问题,容易卡壳数周进而放弃。正确的做法是坚持“MVP 原则”(最小可行性产品):第一版只实现一个最核心的功能,调通后再像搭积木一样逐步迭代增强。
五、总结:能力模型与自学成果验收全景
评估自学 Python 是否达到预定目标,不能单纯以学习天数来计算,而应从掌握层次、工程规范和排错能力三个维度进行量化核验。下图展示了从纯语法入门到具备工程落地能力的完整层级模型。
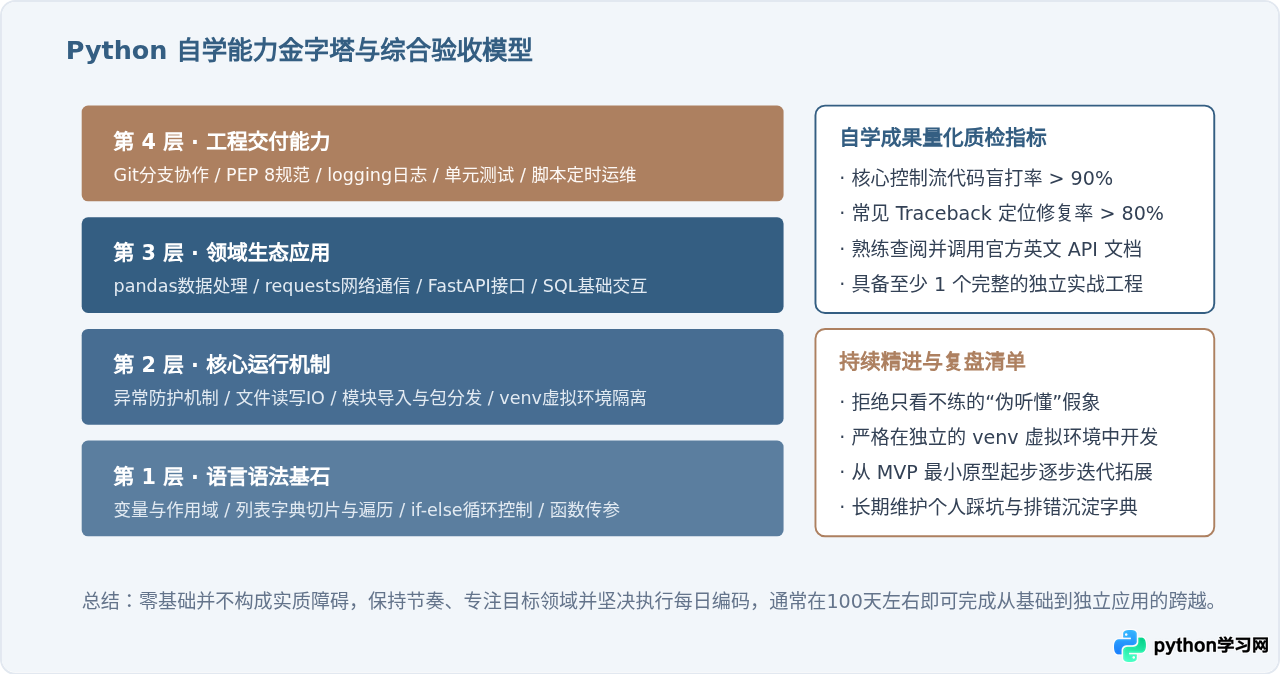
自学 Python 是一个重构逻辑思维方式的过程。明确学习方向、保持每天 1.5 到 2 小时的固定编码节奏、严格遵循“四阶段路线”推进,并在实践中不断通过排错闭环来强化工程能力,零基础学习者完全可以在 3 到 6 个月内建立起扎实的编程基础,并能够独立开发出解决实际业务问题的应用程序。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















