


Python NLP库(spaCy/NLTK)安装报错常见原因与修复
系统梳理Python自然语言处理库spaCy和NLTK在安装与资源配置过程中的高频报错,针对C/C++编译链缺失、Wheel匹配失败、SSL证书校验及语料模型拉取超时等问题提供详实修复方案与验证流程。
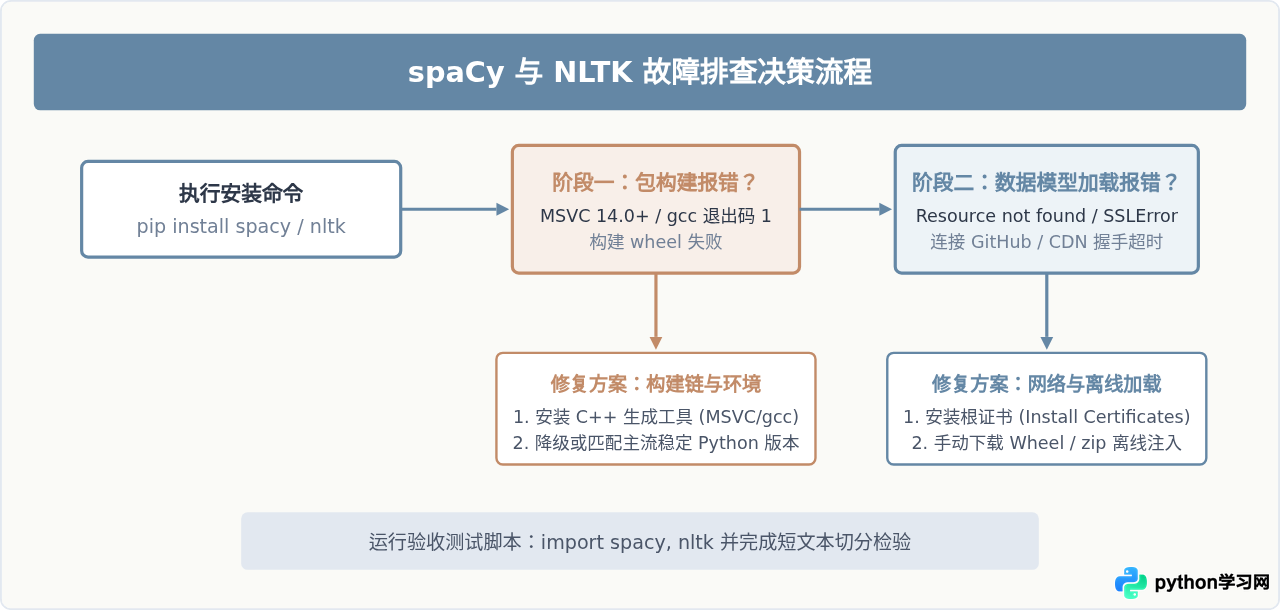
安装与配置 spaCy 和 NLTK 的异常主要出现在两个阶段:一是通过 pip 安装主程序包时的底层 C/C++ 编译器缺失与 Wheel 预编译包版本不匹配;二是加载分词与语言模型时因网络协议、SSL 根证书或索引路径引发的下载中断。理清这两个截然不同的出错层级,能够避免盲目重装并迅速恢复运行。
在 Python 自然语言处理开发中,spaCy 与 NLTK 承担着基础分词、词性标注及句法依存分析等核心任务。许多初学者在初次执行 pip install spacy 或运行 nltk.download() 时,经常遇到长串红色错误日志。排查此类报错不需要重装整个 Python 环境,遵循系统性的排查顺序可以精准定位问题根源。
一、spaCy 安装阶段:C/C++ 编译链与 Wheel 缺失
在 Windows、Linux 或 macOS 上安装 spaCy 时,最典型的报错表现为构建轮子失败。控制台通常抛出以下两类日志:
error: Microsoft Visual C++ 14.0 or greater is required. Get it with "Microsoft C++ Build Tools": https://visualstudio.microsoft.com/visual-cpp-build-tools/
[end of output]
note: This error originates from a subprocess, and is likely not a problem with pip.
ERROR: Failed building wheel for spacy
在 Linux 或 macOS 系统中,报错信息则往往是:
x86_64-linux-gnu-gcc -pthread -Wno-unused-result -Wsign-compare ... -fPIC -I...
error: command 'gcc' failed with exit status 1
ERROR: Failed building wheel for thinc / cymem / murmurhash
根本原因分析
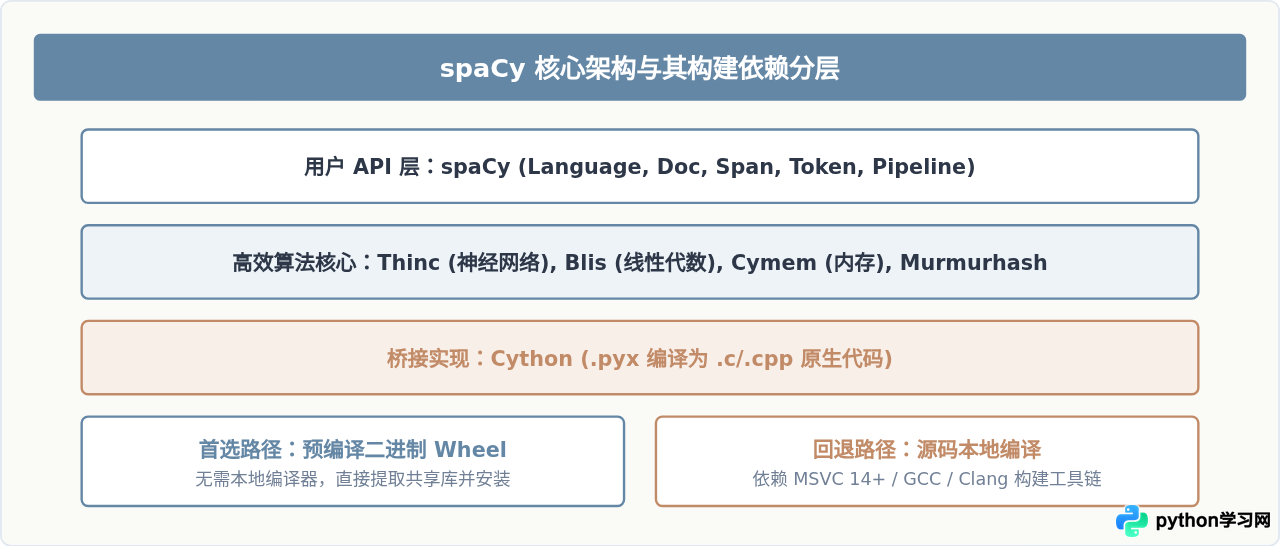
与绝大部分纯 Python 库不同,spaCy 的核心架构追求工业级的高效吞吐,其底层的矩阵运算库 Thinc、内存管理模块 Cymem、字符串哈希组件 Murmurhash 及分词骨架均由 Cython 编写,并在运行时直接与 C/C++ 扩展交互。
当满足以下任意条件时,pip 无法直接获取官方预先编译好的二进制轮子(Wheel 包),只能退回源码编译模式(Source Distribution):
- 使用过新的 Python 解释器版本(例如 Python 3.12 或 3.13 刚发布时,对应平台的预编译二进制文件尚未构建上传至 PyPI)。
- 系统属于较为冷门或特定的硬件架构(如某些基于 ARM 或 RISC-V 的 Linux 服务器)。
- 本地
pip、setuptools或wheel版本过旧,无法正确识别现代 Wheel 标签。
一旦退回源码编译,系统若未配置原生 C/C++ 编译器和 Python 头文件开发包,安装过程就会立刻终止。
系统性修复步骤
第一步:更新基础构建工具。在全新虚拟环境中,优先升级工具包,以便正确解包较新的预编译轮子:
python -m pip install --upgrade pip setuptools wheel第二步:按操作系统补全编译工具。
- Windows 环境:访问微软官方网页下载并安装 Visual Studio 生成工具 (Build Tools for Visual Studio)。在安装程序界面中勾选“使用 C++ 的桌面开发”,右侧勾选默认的 MSVC v143 编译器以及 Windows 10/11 SDK。安装完成后无需重启整机,重新打开 PowerShell 即可。
- Linux (Ubuntu/Debian) 环境:终端执行以下命令补全编译器及 Python 头文件:
sudo apt-get update sudo apt-get install -y build-essential python3-dev - macOS 环境:确保系统已初始化命令行工具:
xcode-select --install
第三步:调整 Python 版本作为最省事的备选。如果受限于内网或权限无法安装几吉字节的 Visual Studio 编译器,最直接的方式是使用当前受官方预编译轮子全面支持的 Python 版本(如 Python 3.10 或 3.11),此时 pip install spacy 可直接下载几十兆的预编译文件,秒级完成安装。
二、NLTK 语料包缺失与资源索引变动
NLTK 本身是纯 Python 实现的库,通过 pip install nltk 安装往往非常顺利,但初学者在调用分词或标注函数时,几乎都会撞上下面的运行时异常:
LookupError:
**********************************************************************
  Resource punkt_tab not found.
  Please use the NLTK Downloader to obtain the resource:

  >>> import nltk
  >>> nltk.download('punkt_tab')

  For more information see: https://www.nltk.org/data.html

  Attempted to load tokenizers/punkt_tab/english/
  Searched in:
    - 'C:\\Users\\username/nltk_data'
    - 'D:\\Python310\\nltk_data'
    - 'D:\\Python310\\share\\nltk_data'
    - 'D:\\Python310\\lib\\nltk_data'
**********************************************************************
新旧版本差异与原因
与自带小型内置词表的轻量库不同,NLTK 采用“代码逻辑与数据包分离”的设计:pip 安装的仅为 Python 算法代码,而词料库(Corpora)、词性标注集和分词模型(Models)存放在外部服务器上。
特别需要注意的是,在 NLTK 3.9 版本之后,默认的分词机制由传统的 punkt 升级为 punkt_tab 数据包格式。许多历史教程仅提及执行 nltk.download('punkt'),在新版环境下依旧会触发 Resource punkt_tab not found 报错。
修复与规范下载方式
在终端或独立脚本中一次性拉取常用语料资源:
# 在命令行直接执行下载模块
python -m nltk.downloader punkt punkt_tab stopwords averaged_perceptron_tagger
如果是在自动化脚本或开发环境启动时自动检测并补齐,可编写以下容错加载代码:
import nltk

def ensure_nltk_resources():
    required_packages = ['punkt', 'punkt_tab', 'stopwords']
    for pkg in required_packages:
        try:
            nltk.data.find(f'tokenizers/{pkg}')
        except LookupError:
            print(f"正在自动拉取缺失的 NLTK 数据包: {pkg}")
            nltk.download(pkg, quiet=True)

ensure_nltk_resources()
三、网络阻断、SSL 证书验证与离线部署方案
不管是执行 python -m spacy download zh_core_web_sm,还是调用 nltk.download(),国内开发者最常遇到的第二道屏障是网络握手超时或 TLS 证书被阻断。
urllib.error.URLError: <urlopen error [SSL: CERTIFICATE_VERIFY_FAILED] certificate verify failed: unable to get local issuer certificate (_ssl.c:1007)>
# 或者:
requests.exceptions.ConnectionError: HTTPSConnectionPool(host='raw.githubusercontent.com', port=443): Max retries exceeded with url...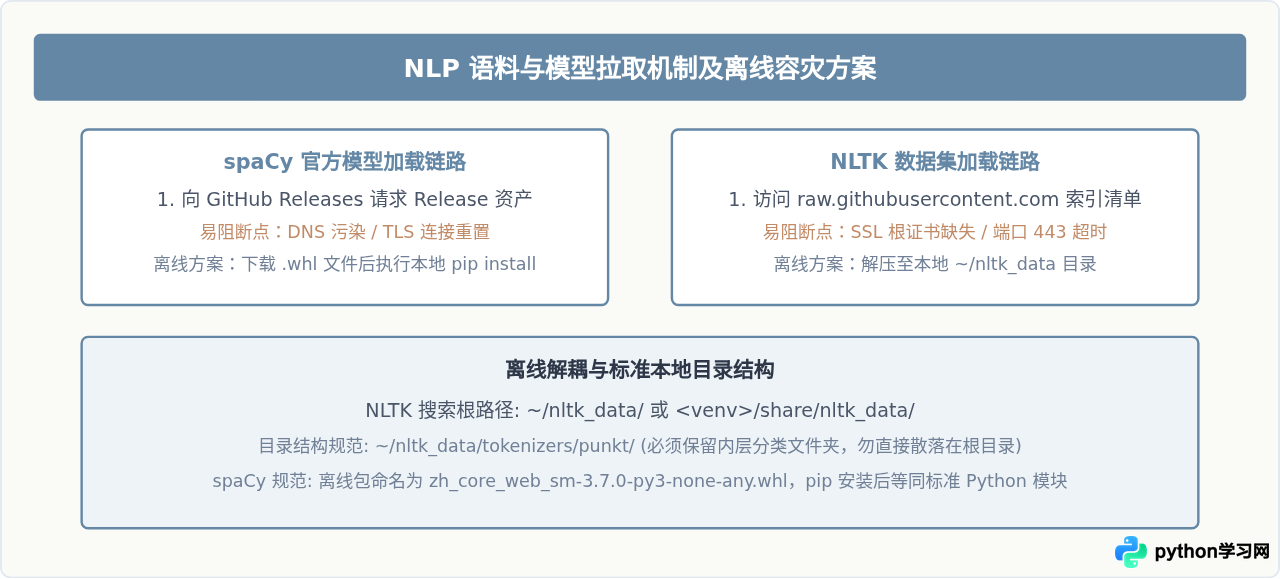
1. 针对 macOS 的 SSL 证书缺失修复
在 macOS 系统中,如果是从官方 Python.org 下载安装的 Python,其内建环境不直接继承系统的根钥匙串(Keychain)。安装目录下自带了一个证书更新脚本,执行后即可修复该报错:
# 替换对应的 Python 版本号
/Applications/Python\ 3.10/Install\ Certificates.command
2. spaCy 模型的官方镜像与本地 Wheel 离线安装
spacy download <model_name> 本质上是计算出模型对应的 GitHub Release 压缩包链接,并调用 pip 联网拉取。当网络阻断时,直接绕过在线下载指令:
- 手动在能稳定访问外网的设备或浏览器中打开 spaCy 官方模型仓库(
github.com/explosion/spacy-models/releases)。 - 根据安装的 spaCy 版本选择对应型号(例如中文小型模型
zh_core_web_sm-3.7.0-py3-none-any.whl)。 - 下载至本地后,直接用 pip 离线安装该 wheel 文件:
pip install ./zh_core_web_sm-3.7.0-py3-none-any.whl
安装完成后,在代码中便可直接引入:
import spacy

# 方式一:按模型包名加载
nlp = spacy.load("zh_core_web_sm")

# 方式二:直接作为 Python 模块导入(规避名称解析问题)
import zh_core_web_sm
nlp = zh_core_web_sm.load()
3. NLTK 语料包的手动离线放置规范
若无法连接 raw.githubusercontent.com 下载,可从官方数据仓库(github.com/nltk/nltk_data)直接打包下载 zip 文件。放置时务必保持以下层级关系:
- Windows 目录:
C:\Users\<用户名>\nltk_data\tokenizers\punkt\ - macOS / Linux 目录:
~/nltk_data/tokenizers/punkt/
常见误区是将压缩包直接解压在 nltk_data 根目录下。注意 NLTK 内部检索时严格按 <资源类别>/<包名>/<具体文件>(如 tokenizers/punkt_tab/english/)进行相对寻址。
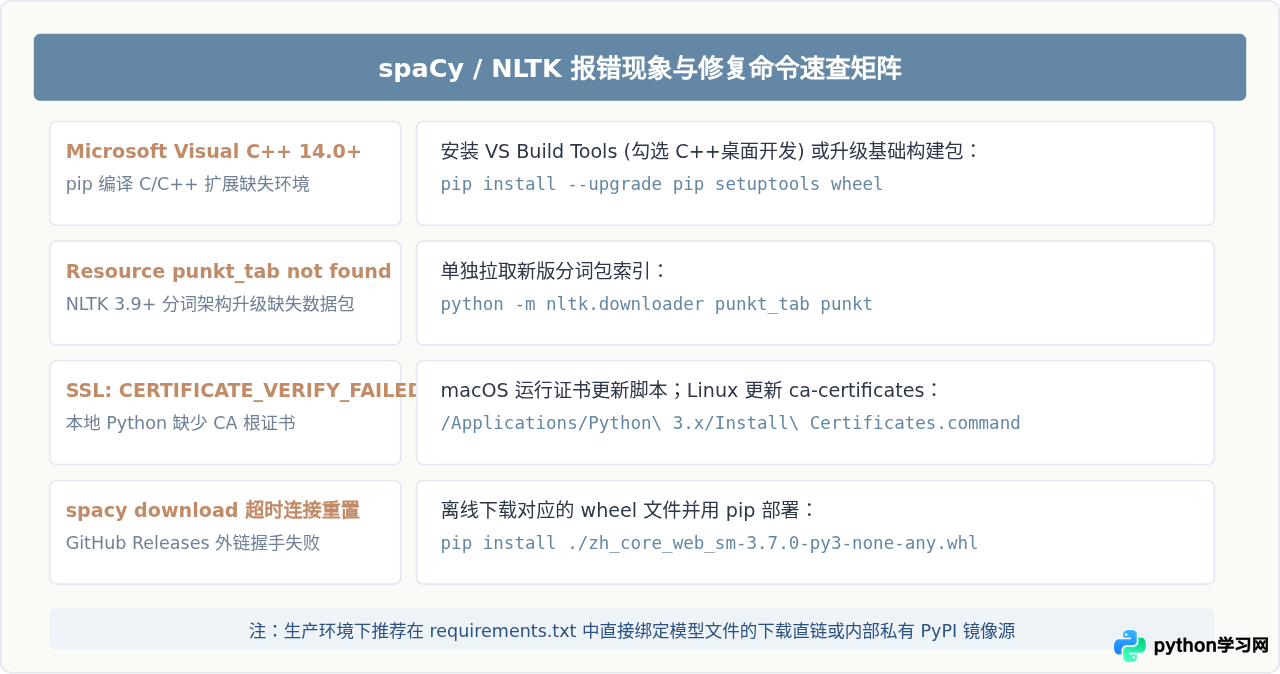
四、常见报错与修复方案速查
下表对安装与配置阶段的高频错误、根本成因及对应处理手段进行了横向对比:
五、安装结果检验与端到端测试
完成环境修复后,编写一个短小的验证脚本测试基础流水线是否运转顺畅。该脚本不需要依赖外部大型数据文件,只针对两者的分词与解析逻辑进行核验:
import sys

def verify_nlp_environment():
    print(f"当前 Python 环境: {sys.version.split()[0]}")

    # 1. 验证 NLTK 分词管道
    try:
        import nltk
        from nltk.tokenize import word_tokenize
        tokens = word_tokenize("Language processing with Python is powerful.")
        print(f"[OK] NLTK 分词检验成功,产出单元数量: {len(tokens)}")
    except Exception as e:
        print(f"[FAIL] NLTK 验证异常: {e}")

    # 2. 验证 spaCy 及其语言模型
    try:
        import spacy
        nlp = spacy.blank("zh")  # 即使未下载完整重量级模型,也可先测试核心空白管道
        doc = nlp("自然语言处理环境安装完成。")
        print(f"[OK] spaCy 基础管道加载成功,分词结果: {[t.text for t in doc]}")
    except Exception as e:
        print(f"[FAIL] spaCy 验证异常: {e}")

if __name__ == "__main__":
    verify_nlp_environment()
保存上述脚本为 test_nlp_env.py 并运行。若控制台输出两个 [OK] 状态,则说明系统底层的 C/C++ 依赖与基础数据分发路径均已配置妥当,后续无论加载复杂预训练模型还是自定义命名实体识别管道,都不会再受到编译与网络握手异常的干扰。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















