


Python字符串格式化对比:%操作符、format()与f-string优劣分析
深入对比Python中%操作符、str.format()与f-string三种字符串格式化方式的语法结构、底层执行机制、性能表现、常见陷阱与技术选型建议。
在 Python 脚本编写与工程开发中,字符串格式化是最基础且高频的操作。Python 语言在发展历程中先后演进出了三种核心格式化方案:沿袭 C 语言传统的 % 操作符(printf 风格)、Python 2.6 引入的 str.format() 方法,以及 Python 3.6 确立的 f-string(格式化字符串字面值,PEP 498)。本文将客观对比这三种方案的语法特征、解析机制、执行性能及适用场景,帮助读者建立清晰的选型标准。
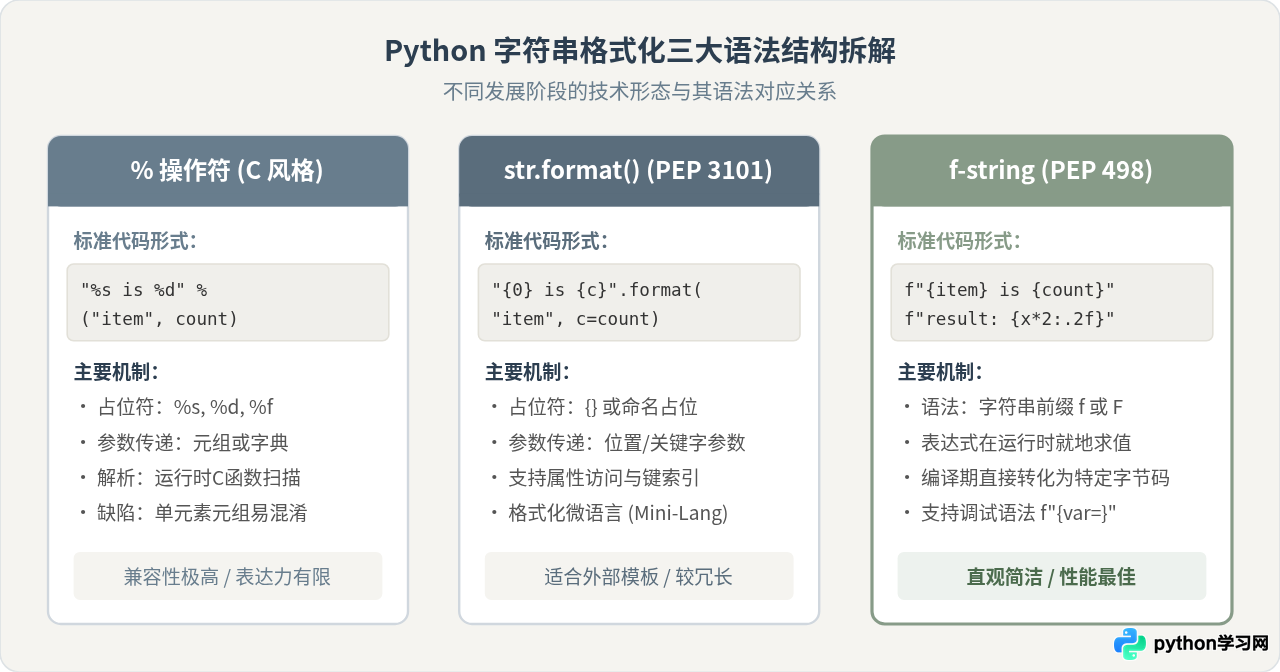
一、三种格式化语法的演进与实现细节
要透彻理解三者的差异,首先需要了解它们在实际编码中的书写方式以及底层的传参规则。
1. % 操作符(printf 风格)
% 操作符自 Python 诞生之初便存在。它的语法灵感直接来源于 C 语言的 printf 函数族。使用时,字符串内部包含 %s、%d、%f 等格式说明符,后跟 % 操作符和一个值或元组。
# 单变量与多变量格式化示例
name = "Alice"
score = 95.5
rank = 1

# 单个变量可以不使用括号
print("Hello, %s" % name)

# 多个变量必须按顺序打包为元组
print("Rank %d: %s scored %.1f points" % (rank, name, score))

# 使用字典传参(需指定名称)
info = {"target": "Server", "status": 200}
print("Target: %(target)s, Status: %(status)d" % info)陷阱提醒:当要格式化的变量本身恰好是一个元组时,若不加外层括号包裹,解释器会将其解包并与占位符数量核对,直接导致 TypeError: not all arguments converted during string formatting。
2. str.format() 方法
为了摆脱 % 操作符传参类型的繁琐限制,Python 2.6 引入了 str.format()。该方法引入了统一的花括号 {} 占位语法,以及一套功能强大的格式规范迷你语言(Format Specification Mini-Language)。
# 位置参数、索引与关键字参数
print("Item: {}, Price: {:.2f}".format("Book", 49.9))
print("Coordinates: {latitude}, {longitude}".format(latitude="31.23N", longitude="121.47E"))

# 访问对象属性与容器索引
class ServerNode:
    def __init__(self, ip, port):
        self.ip = ip
        self.port = port

node = ServerNode("192.168.1.100", 8080)
print("Connected to {0.ip}:{0.port}".format(node))

payload = ["cluster-01", "active"]
print("Cluster: {0[0]}, State: {0[1]}".format(payload))
format() 的核心优势在于解耦了占位符与变量实参,模板字符串本身是一个纯粹的普通字符串变量,可以存储在配置文件或数据库中,待后续动态传入数据进行渲染。
3. f-string(格式化字符串字面值)
Python 3.6 发布的 PEP 498 正式引入了 f-string。与前两者不同,f-string 并不是一个函数或操作符,而是在编译阶段由 Python 语法解析器(Parser)直接识别的特殊字面值标记。
user = "Developer"
metrics = [88, 92, 95]

# 直接嵌入变量与任意合法 Python 表达式
print(f"User: {user.upper()}, Average Score: {sum(metrics) / len(metrics):.2f}")

# 格式控制与对齐排版
val = 42
print(f"Binary: {val:08b}, Hex: {val:#x}, Pad: {val:>6d}")

# Python 3.8+ 调试语法快捷打印(输出变量名与值)
status_code = 404
print(f"{status_code=}")  # 输出: status_code=404
二、底层执行机制与性能深度对比
在性能敏感的数据处理、网络服务或高频日志拼接场景中,格式化的开销差异十分明显。三种格式化方案在 Python 解释器内部的编译与执行链路存在本质不同。
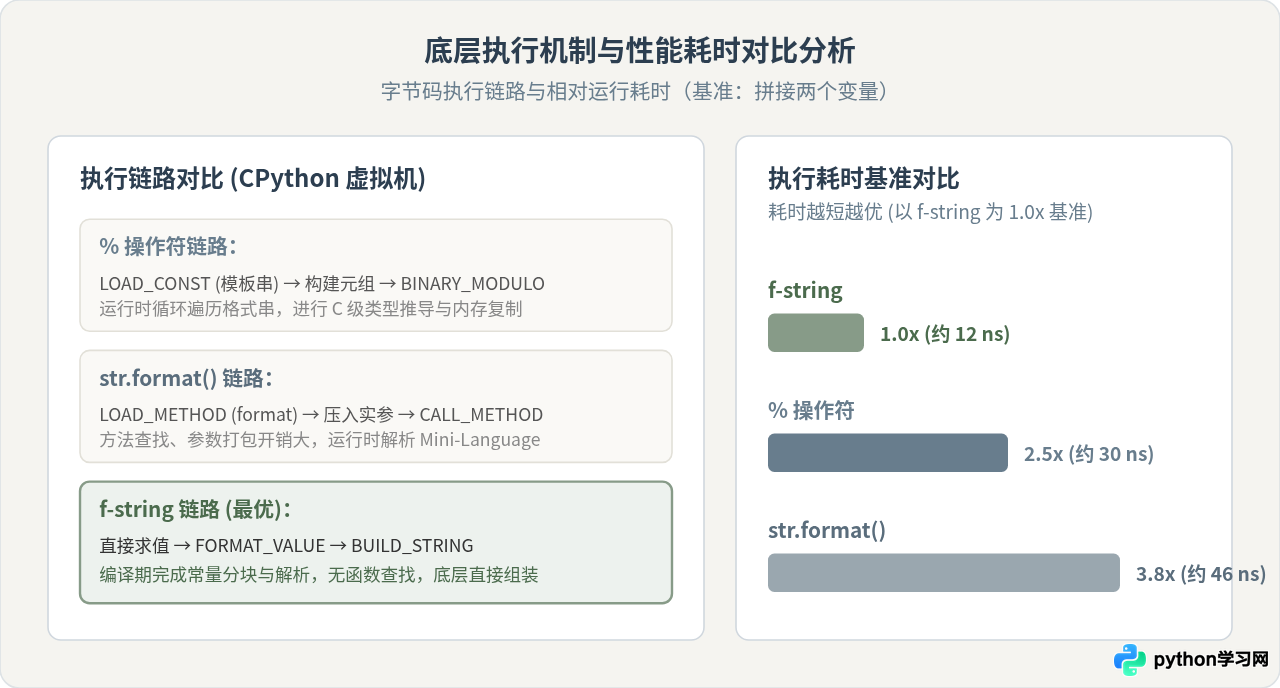
从底层字节码层面可以清楚地看到性能差异的根源:
- f-string 的速度优势:在词法分析阶段,
f-string会被解析为一系列表达式节点。生成的字节码仅包含表达式计算、FORMAT_VALUE操作码以及最终将所有字符串部分直接拼合的BUILD_STRING指令。它完全避免了运行时解析格式控制串的开销。 - format() 的开销劣势:
str.format()是常规的方法调用,需要经过属性查找(LOAD_METHOD)、构建参数列表、开辟 Python 函数调用栈帧,并在运行时重新解析格式说明字符串。 - % 操作符的中等性能:
%是由 CPython 解释器底层的PyString_Format或PyUnicode_FormatC 函数实现的,跳过了复杂的 Python 方法调用栈,但每次仍需逐字符扫描格式串并解析占位符。
三、关键功能维度横向评测
除了纯粹的速度对比,代码的可维护性、灵活性与安全边界往往是生产环境选型的主要考量因素。
| 特性维度 | % 操作符 | str.format() | f-string |
|---|---|---|---|
| 引入版本 | Python 1.0+ (基础支持) | Python 2.6 / 3.0 | Python 3.6+ (PEP 498) |
| 可读性与内聚性 | 较差(变量与占位符割裂) | 中等(需在末尾传参) | 极高(就地内嵌,直观自然) |
| 表达式支持 | 仅支持值/变量传递 | 仅支持属性与字典键访问 | 支持任意合法 Python 表达式 |
| 动态外部模板 | 支持(基于字典传参) | 极佳(模板可与数据彻底解耦) | 不支持(必须在编译期静态定义) |
| 注入安全风险 | 低(仅类型格式化错误) | 存在属性越权读取风险 | 无用户输入格式串注入风险 |
1. 可读性对比:为什么 f-string 降低了心智负担?
当格式化字符串较长、参数数量超过 3 个时,% 和 format() 要求开发者的视线在模板串与末尾的参数列表之间反复来回对应。如果顺序出错,就会产生难以排查的逻辑 Bug。而 f-string 将表达式直接写在花括号内部,达到了“所见即所得”的效果。
2. 安全性考量:format() 的属性遍历隐患
str.format() 允许通过 {0.__class__} 等语法访问传入对象的属性。如果应用程序允许外部用户自定义 format 模板串并在服务端渲染,攻击者可能借此读取敏感内部配置:
# 潜在的安全风险示例(不要对不受信任的用户输入使用 format)
user_template = "{user.__init__.__globals__[SECRET_KEY]}"
# 若将全局对象传入 format,可能导致私密信息泄露相比之下,f-string 是静态源码级别的语法结构,用户输入的字符串只会被当作普通纯文本处理,天然杜绝了将外部输入作为动态格式化模板所引发的越权风险。
四、从旧语法平滑迁移到 f-string 的实操指南
在现有代码仓库的重构工作中,将老旧的 % 操作符和 format() 转换为 f-string 是提升代码质量的重要步骤。以下是推荐的四个平滑迁移步骤:
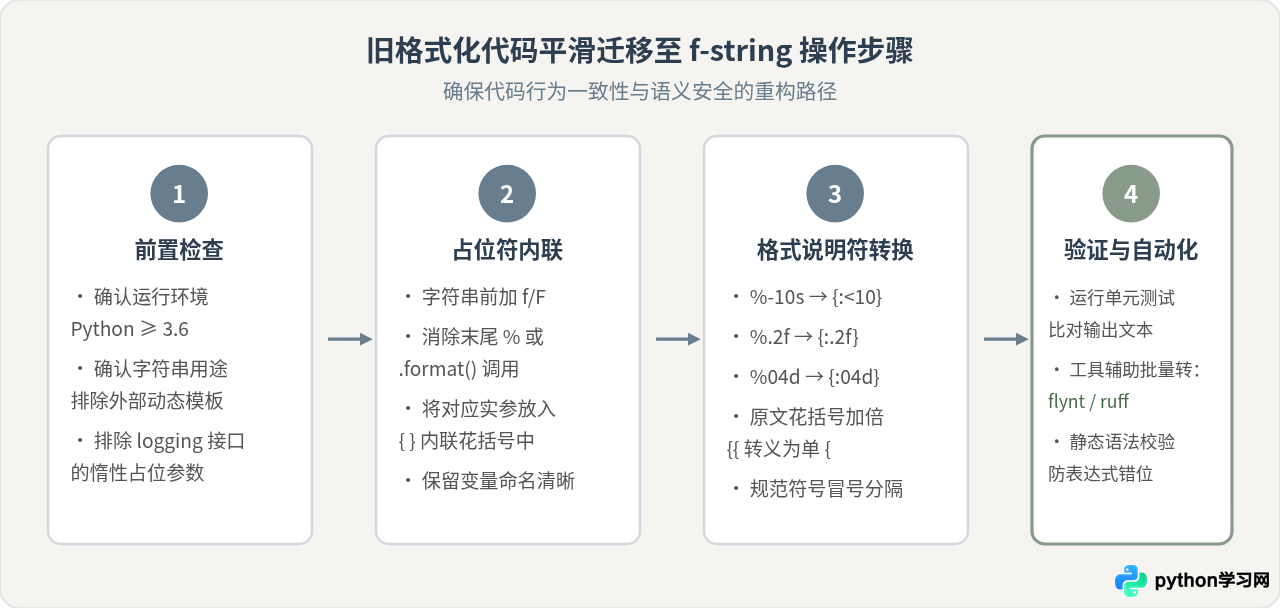
迁移示例:格式说明符的对应改造
# 改造前(% 操作符)
msg_old = "ID: %05d, Balance: $%8.2f, State: %-6s" % (uid, balance, state)

# 改造后(f-string):保持对齐、补零与浮点精度一致
msg_new = f"ID: {uid:05d}, Balance: ${balance:8.2f}, State: {state:<6}"

# 改造前(format 方法)
log_old = "Process [{pid}] took {duration:.3f}s".format(pid=proc.pid, duration=delta)

# 改造后(f-string)
log_new = f"Process [{proc.pid}] took {delta:.3f}s"工程建议:对于成百上千个文件的存量工程,推荐使用成熟的开源自动化工具(如 flynt)进行自动扫描与无损替换,再通过项目的单元测试套件完成最终确认。
五、选型决策指南:不同场景的最佳实践
虽然 f-string 在大多数场景下都具备压倒性优势,但并不意味着其余两种方式完全没有立足之地。合理的架构设计应根据具体的使用边界进行选型。
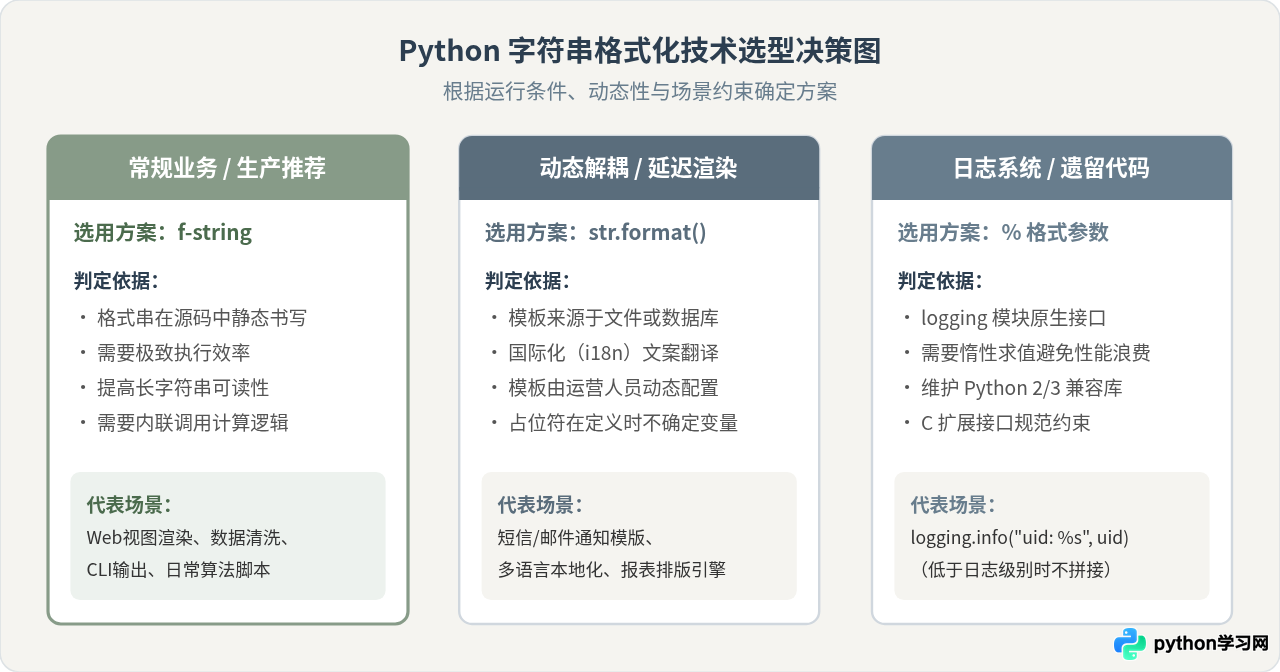
特别说明:标准库 logging 模块的惰性格式化特性
很多开发者习惯直接在日志中书写 logging.debug(f"Process result: {heavy_calc()}")。这种写法存在性能陷阱:无论当前的日志级别是否开启了 DEBUG,f-string 内部的表达式 heavy_calc() 与字符串拼接都会无条件立即执行。
标准库 logging 的标准设计是传入 % 占位符和参数列表:
# 推荐的日志实践:由 logging 模块负责惰性求值
logging.debug("Process ID: %s, Result: %s", proc_id, heavy_calc_func)
# 只有当当前的有效日志等级允许输出 DEBUG 时,logging 内部才会执行 % 格式化
六、总结
综合以上分析,三种 Python 字符串格式化机制的优劣与应用定位非常清晰:
- f-string(首选):在 Python 3.6+ 环境下,语法最为优雅直观,执行性能由于底层特化字节码而显著领先,是绝大多数日常开发、数据分析与 Web 服务的首选方案。
- str.format()(动态方案):保留了字符串模板与具体数据的解耦能力,在外部动态配置、邮件模板、多语言本地化(i18n)等必须运行时加载模板的场景中仍具备不可替代的价值。
- % 操作符(特定场景):虽然语法逐渐边缘化,但在
logging标准库的惰性格式化机制以及维护极度老旧的代码库时,依然有其特定的存在意义。
理清三者的底层运行机制与语法边界,能帮助我们在编写 Python 代码时兼顾执行性能、可读性与架构灵活性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















