


Python 3多进程与多线程的核心区别及选型指南
深入解析 Python 3 中多进程与多线程的底层内存模型、GIL 机制与资源开销,提供详尽的横向对比、标准生产级代码实操与系统化选型决策指南。
在 Python 3(CPython 官方实现)中,多进程与多线程的本质分水岭在于内存隔离级别与全局解释器锁(GIL, Global Interpreter Lock)。简而言之:面对矩阵计算、图像转码、数据清洗等 CPU 密集型任务,必须选用多进程(multiprocessing),借助独立进程空间绕开 GIL 限制以利用物理多核;而对于网络爬虫、远程 API 调用、文件读写等 I/O 密集型任务,应当首选多线程(threading 或 ThreadPoolExecutor),在极低的内存开销与快速的共享内存优势下承载高并发。本文将系统拆解两者的底层机制、关键维度差异、标准编码范式与选型决策路径。
一、底层架构解析:内存模型与 GIL 的作用边界
要透彻理解多进程与多线程的分工,必须回到操作系统与 CPython 虚拟机的协作模型。操作系统中,进程是资源分配的最小单位,拥有专属于自己的虚拟内存空间、文件描述符表以及全局变量;线程则是系统调度的最小单位,同属于一个进程的多个线程天然共享该进程内的堆内存与全局上下文。
在大多数编译型语言(如 C++、Java 或 Go)中,只要创建多个线程,操作系统调度器就会自然将它们分发到不同的物理 CPU 核心上并行运算。但在 CPython 中,为了简化内存管理并保证底层 C 扩展的线程安全,虚拟机引入了全局解释器锁(GIL)。GIL 是一把互斥锁,其核心规则十分明确:无论宿主机配备了多少物理核心,在任意给定的时间微元内,单个 Python 解释器进程中只允许一个线程执行 Python 字节码。
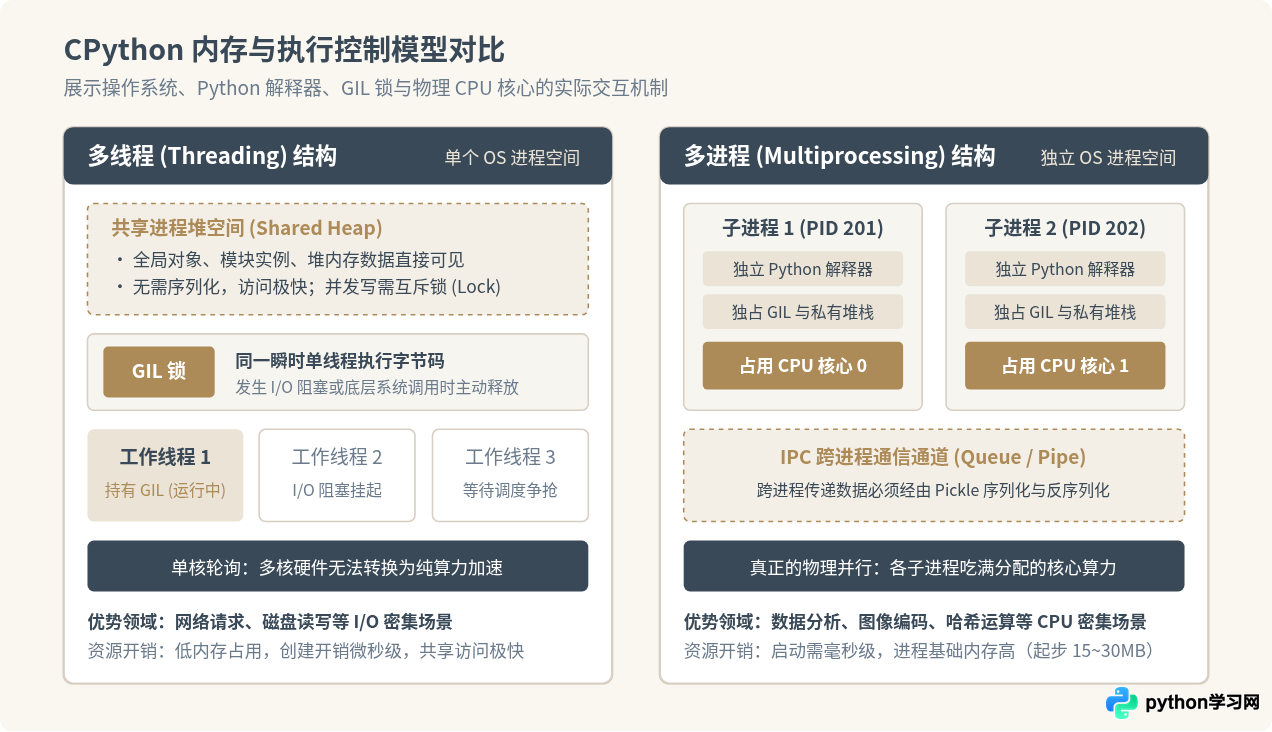
这意味着:如果你用多线程去执行两个独立的百万次循环计算,两个线程不仅不会同时在两个 CPU 核心上奔跑,反而会因为在同一个 CPU 核心上频繁发生线程上下文切换与争夺 GIL 锁,导致最终耗时比单线程顺序执行还要更长。
然而,当线程遇到网络 I/O、磁盘 I/O 或者执行显式释放 GIL 的底层 C 语言扩展函数(例如 NumPy 矩阵底层乘法、OpenCV 核心图像滤波)时,CPython 会在发起系统调用前主动释放 GIL。此时,被阻塞的线程退让等待,其他处于就绪状态的线程便能立刻拿到 GIL 并继续工作。这正是多线程在 I/O 密集型场景下依然具备高吞吐能力的根本原因。
二、多维度横向深度比对
在工程实践中,判断选型不仅依赖于计算特性的区分,还需要全面权衡内存开销、数据通信成本、容错健壮性以及跨平台环境的细节表现。
1. 内存消耗与创建耗时
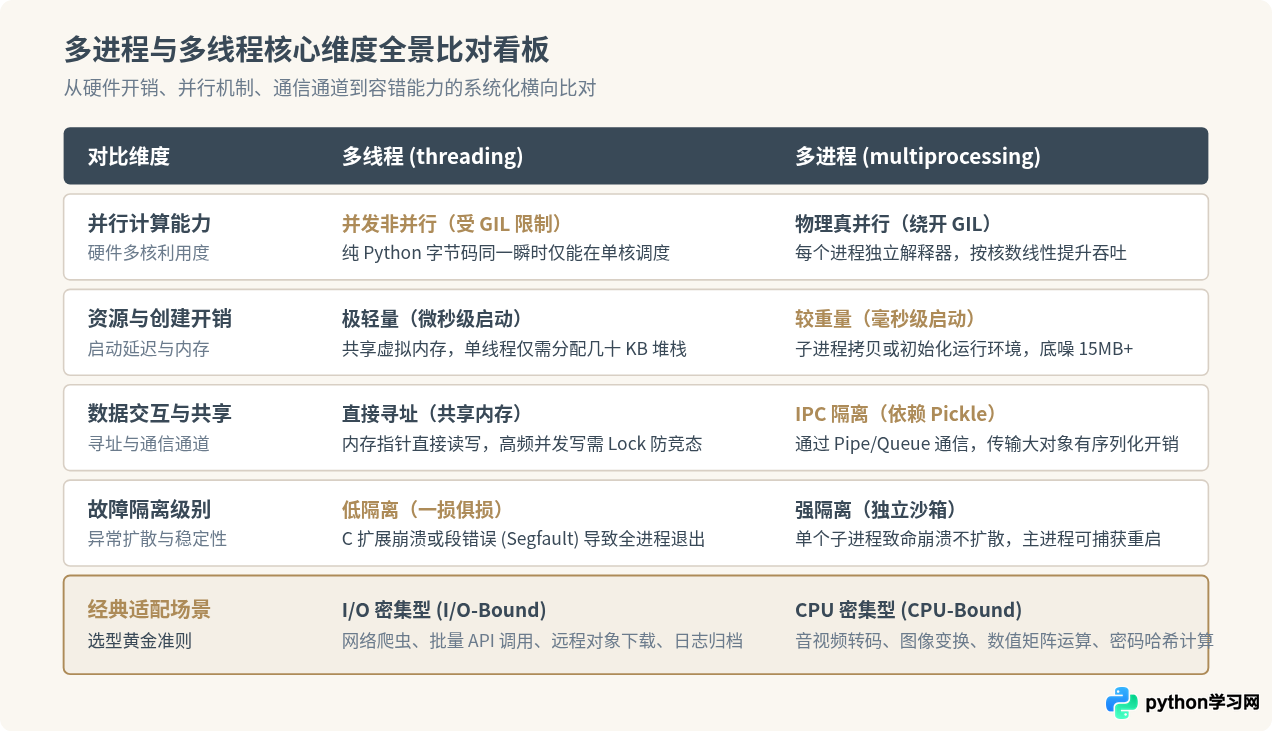
多线程工作在同一进程内部,单线程默认的堆栈通常在几十 KB 到几 MB 之间,创建耗时仅微秒级。在一台普通的 8 核 16GB 机器上,启动几百甚至上千个轻量级工作线程进行 I/O 监听完全可行。
多进程则完全不同。即使采用最轻巧的进程载入方式,启动一个最小化的 CPython 子进程底噪内存也在 15MB~30MB 左右。如果主进程中预先加载了 Pandas、PyTorch 等大型第三方库,子进程的内存占用可能瞬间飙升至数百兆甚至数吉字节。此外,子进程需要经历解释器初始化、模块重新导入等步骤,耗时常在数十至数百毫秒。
2. 通信开销与对象序列化
在多线程中,线程 A 往全局列表追加一个对象,线程 B 立刻就能通过相同的内存指针读到它,开销趋近于零。然而在多进程中,操作系统的虚拟内存隔离阻断了一切跨进程指针访问。主进程要给子进程发送一个任务参数,或者子进程要向主进程返回计算结果,必须经由进程间通信机制(IPC,如 Pipe 或 Queue)。
这一过程背后涉及 pickle 序列化与反序列化:数据对象被先压成二进制流,写入系统管道,在目标端读取后再解构成 Python 对象。如果任务本身计算只需 1 毫秒,但在 IPC 管道中序列化一个 200MB 的数据集耗费了 500 毫秒,多进程带来的并发加速就会被严重的通信延迟彻底抵消。
3. 容错隔离度与健壮性
当编写复杂的系统底层服务时,容错隔离不可忽视。在多线程模型下,如果某个线程调用的底层动态链接库(.so/.dll)发生了内存非法访问或段错误(Segmentation Fault),整个 Python 宿主进程会直接闪退,所有工作线程瞬间中断。而在多进程模型中,子进程拥有独立的地址空间,就算子进程遭遇段错误意外崩溃,主进程依然存活,可以通过监听子进程的退出状态码及时拉起新进程恢复服务。
三、标准实操范例:现代并发池的高效写法
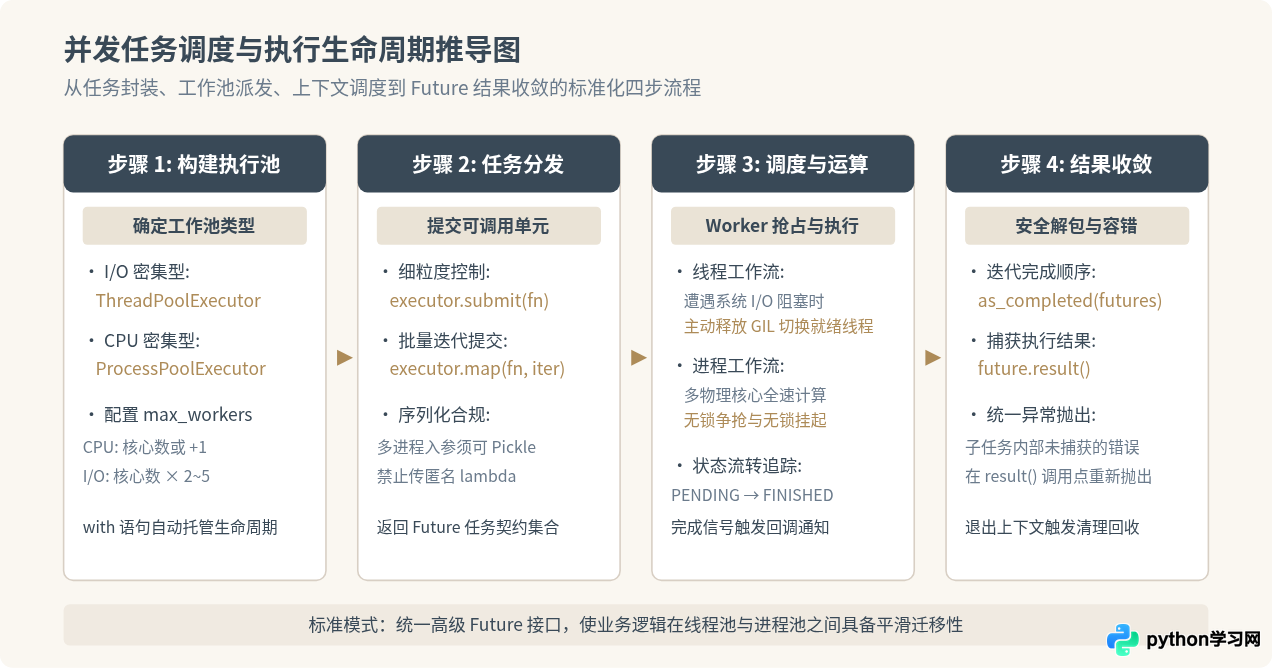
在 Python 3 中,编写并发任务强烈建议优先采用标准库 concurrent.futures。它封装了底层繁琐的线程/进程管理逻辑,向外提供了高度统一的 Executor 抽象,使得多线程与多进程的代码骨架几乎可以无缝平移。
1. I/O 密集型标准实现:ThreadPoolExecutor
以下示例展示如何使用线程池并发抓取批量目标 URL。通过 as_completed 可以在任意任务完成的第一时间回收数据,而无需按照提交顺序硬性等待。
import urllib.request
import urllib.error
from concurrent.futures import ThreadPoolExecutor, as_completed

URLS = [
    "https://httpbin.org/delay/1",
    "https://httpbin.org/status/200",
    "https://httpbin.org/status/404",
    "https://httpbin.org/bytes/1024",
]

def fetch_resource(url: str, timeout: int = 5) -> tuple[str, int]:
    """模拟网络 I/O 请求,返回 URL 及对应字节数"""
    req = urllib.request.Request(url, headers={"User-Agent": "PyWorker/1.0"})
    with urllib.request.urlopen(req, timeout=timeout) as response:
        content = response.read()
        return url, len(content)

def main() -> None:
    # I/O 密集型任务中,工作线程数通常可设为核心数的 2 到 5 倍
    max_workers = 4
    with ThreadPoolExecutor(max_workers=max_workers) as executor:
        # 使用字典将 Future 对象与原始入参绑定,便于异常追溯
        future_to_url = {
            executor.submit(fetch_resource, url): url for url in URLS
        }

        for future in as_completed(future_to_url):
            target_url = future_to_url[future]
            try:
                url, size = future.result()
                print(f"[成功] {url} 响应字节: {size}")
            except urllib.error.HTTPError as exc:
                print(f"[HTTP错误] {target_url} 状态码: {exc.code}")
            except Exception as exc:
                print(f"[未知异常] {target_url} 抓取失败: {exc}")

if __name__ == "__main__":
    main()
2. CPU 密集型标准实现:ProcessPoolExecutor
以下示例模拟批量图像像素滤波或高耗时数学计算。编写多进程代码时,必须遵守 if __name__ == '__main__': 守卫规范,防止进程派生时产生递归死循环。
import math
import os
from concurrent.futures import ProcessPoolExecutor, as_completed

def compute_heavy_task(number: int) -> tuple[int, int, int]:
    """CPU 密集型纯算力任务:模拟复杂的素数校验或多项式计算"""
    pid = os.getpid()
    count = 0
    # 模拟耗时算力消耗
    for i in range(1, number + 1):
        if number % i == 0:
            count += 1
    return pid, number, count

def main() -> None:
    # 测试数据集
    workload = [12_000_003, 12_000_011, 12_000_017, 12_000_029]

    # CPU 密集型任务建议设为实际物理/逻辑核心数,避免不必要的进程抢占开销
    worker_count = os.cpu_count() or 2
    print(f"主进程 PID: {os.getpid()},启用 {worker_count} 个子进程工作池...")

    with ProcessPoolExecutor(max_workers=worker_count) as executor:
        futures = [executor.submit(compute_heavy_task, num) for num in workload]

        for future in as_completed(futures):
            try:
                worker_pid, target_num, divisors = future.result()
                print(f"[完成] Worker PID={worker_pid} 处理 {target_num},因子数: {divisors}")
            except Exception as exc:
                print(f"[处理异常] 任务抛出错误: {exc}")

if __name__ == "__main__":
    # 多进程必须在此入口保护下启动
    main()
四、避坑指南:四大高频陷阱与防御规范
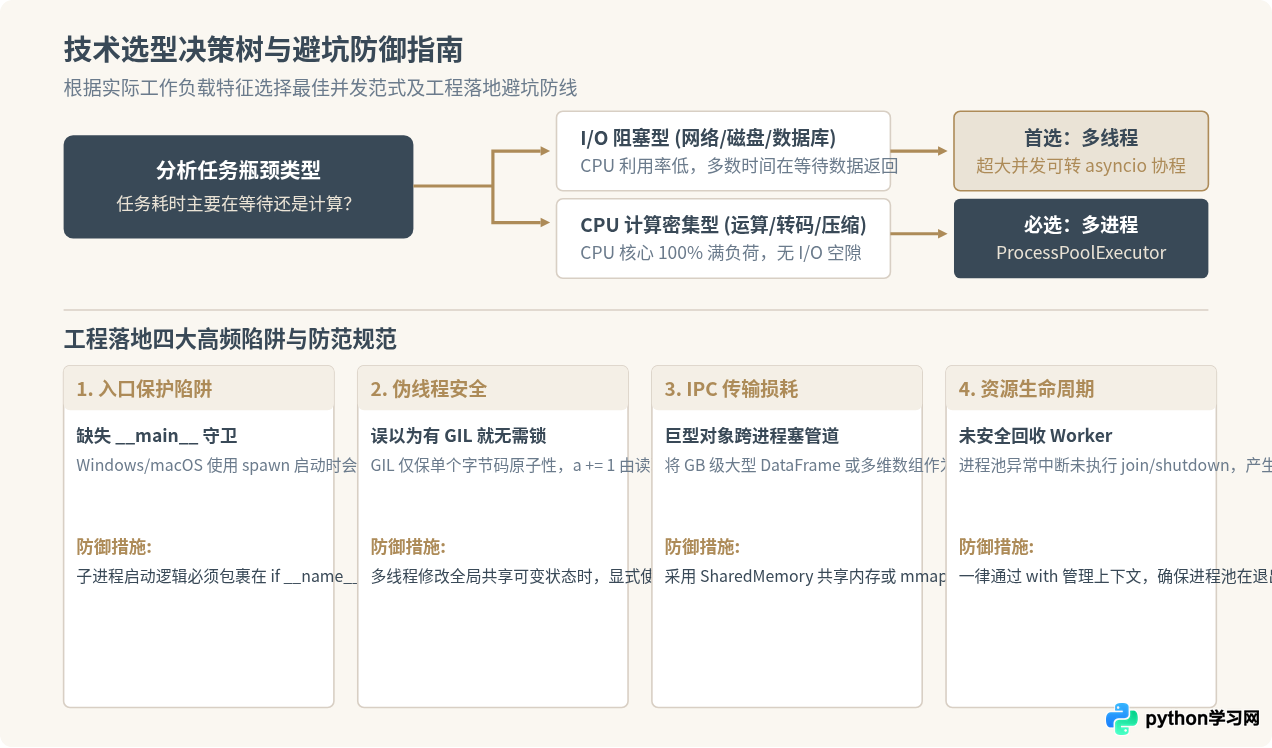
陷阱 1:误以为“有 GIL 保护就不需要线程锁”
很多初学者常有误解:“既然 Python 的 GIL 保证同一时刻只能有一个线程执行字节码,那我的多线程程序天然就是线程安全的,不需要加 Lock 了吧?”
答案是极其危险的否定。GIL 只能保护 CPython 虚拟机内部的数据结构(如字典对象的引用计数递增)不被破坏,它绝不保证高级 Python 复合语句的事务原子性。例如看似简单的一行代码:
counter += 1在 Python 字节码层面上,这行代码由 4 条底层操作指令拼装而成:LOAD_GLOBAL(读取当前值)、LOAD_CONST(加载常数 1)、BINARY_ADD(执行加法)、STORE_GLOBAL(写回变量)。在执行这 4 条指令的中途,线程的调度片可能耗尽,GIL 会被强制释放并切换到另一个线程。如果两个线程同时读取了旧值,就会发生经典的“脏写覆盖”,导致最终累加结果远小于预期。
避坑结论:只要有多个线程对非原子类型的共享数据执行读取并写入(Read-Modify-Write)操作,无论在任何 Python 版本下,都必须显式搭配 threading.Lock 进行互斥保护。
import threading

counter = 0
counter_lock = threading.Lock()

def safe_increment() -> None:
    global counter
    for _ in range(100_000):
        # 正确做法:使用互斥锁保护竞态区间
        with counter_lock:
            counter += 1
陷阱 2:Windows / macOS 下缺少入口保护导致“进程炸弹”
Linux 系统默认采用 fork 系统调用克隆子进程,子进程直接获得父进程内存页的 Copy-on-Write 镜像;但 Windows 以及现代 macOS(Python 3.8+ 默认)采用 spawn 启动模式。在 spawn 模式下,操作系统会全新拉起一个干净的 Python 解释器,并从头重新导入入口脚本模块。
如果你的主文件顶层直接写着 p = Process(target=worker) 而没有放在 if __name__ == '__main__': 之后,子进程在执行 import 阶段就会再次触发该语句,进而派生出孙子进程,如此往复引发系统级 Fork 炸弹,迅速耗尽系统 PID 和内存导致系统假死。
陷阱 3:跨进程传输不可 Pickle 对象(PicklingError)
在向 ProcessPoolExecutor 提交任务时,所有作为参数传入的数据,以及目标函数本身的返回值,都必须满足 pickle 序列化协议。常见的不可序列化对象包括:打开的文件句柄、数据库连接对象(如 sqlite3 连接)、带有外部 C 指针的 socket 套接字、以及在函数内部动态定义的嵌套函数或未命名的 lambda 表达式。如果尝试传递这些对象,代码将抛出难以追踪的 PicklingError。
防御方案:在传递复杂资源时,只向子进程传递轻量级的连接元数据(如数据库连接字符串、文件路径、记录主键 ID 范围),让每个子进程在自己的函数内部独立建立连接和打开句柄,用完即关。
陷阱 4:关于 Python 3.12/3.13 自由线程(Free-Threaded)的现实认知
近年来 Python 社区推出了诸如 PEP 684(针对子解释器的独立 GIL)以及 PEP 703(Python 3.13 实验性引入的自由线程构建版本 python3.13t,支持编译期禁用 GIL)。这是否意味着多进程即将被多线程完全取代?
现实结论是否定的:
- 生态成熟度:当前的无 GIL 构建版本仍处于实验性预览阶段。大量的经典 C 扩展(如 NumPy、Pandas、SciPy、TensorFlow)需要耗费数年时间重写底层引用计数与锁机制才能完全保证在无 GIL 下平稳运行。
- 单核性能损耗:为了在没有全局 GIL 的环境下保护原子操作,解释器需要引入更细粒度的无偏锁或偏向锁,这在纯单线程场景下会带来 5%~10% 的基础性能惩罚。
- 工程选型定论:在目前及未来可预见的生产环境主力版本中,多进程依然是榨干多核物理算力最稳定、最成熟的工业级方案。
五、工程落地选型总结速查表
为了帮助开发者在实际架构设计中做出快速、精准的技术决策,下表总结了典型的工程任务特征及其推荐方案:
| 业务工作负载特征 | 典型任务案例 | 推荐技术选型 | 核心决策依据 |
|---|---|---|---|
| 高并发、轻量级 I/O 等待 | 批量抓取网页、微服务 HTTP 探测、短文本下载 | ThreadPoolExecutor 或 asyncio | 等待耗时远大于计算,线程开销极小,轻量快速 |
| 持久数据库事务与磁盘文件批量读写 | 跨表数据转存、大文件拆分存储 | ThreadPoolExecutor | I/O 系统调用期间 GIL 自动释放,并发调度高效 |
| 纯 CPU 算力、无 I/O 等待 | 矩阵乘法运算、音视频重编码、3D 渲染 | ProcessPoolExecutor | 彻底绕开 GIL,充分吃满全部物理 CPU 核心 |
| 大型数据批量预处理 | GB 级文本切词、特征工程数据清洗 | 多进程 + 共享内存 (SharedMemory) | 规避单核限制,同时消除高额 IPC 序列化性能损耗 |
| 高连接数高频轻交互 | IM 聊天室服务、网关反向代理、物联网遥测监听 | asyncio (单线程事件循环) | 无需操作系统线程上下文切换,单机支撑数万长连接 |
通过清晰界定任务在 CPU 运算与 I/O 等待上的时间分配,并严格遵守多进程的序列化约束与多线程的显式互斥锁规范,开发者便能在 Python 3 的多核并发世界中构建出兼具极致吞吐与稳健防御的高性能工业级应用。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















