


Python离线翻译库推荐:不依赖网络的本地文本翻译方案
在不依赖外部网络与商业API调用的前提下,如何利用Python实现高质量本地文本离线翻译。全面解析Argos Translate、Helsinki-NLP MarianMT与CTranslate2三大主流离线方案,提供完整的离线安装、代码示例、长文本分句处理与工程避坑指南。
一、认识真正的“离线翻译”与选型维度
很多开发者在需要本地翻译功能时,第一反应往往是使用 pip install googletrans 或 pip install translate 等常用库。但把代码部署到无外网物理服务器或断开 Wi-Fi 测试时,程序会立刻抛出 ConnectionRefusedError 或 ReadTimeout 异常。
这是因为这类库本质上属于“在线 API 的 HTTP 客户端”或“网页翻译接口的爬虫封装”,翻译过程完全发生在远程服务器上。真正的本地离线翻译必须具备两项基本特征:
- 模型权重完全驻留本地磁盘:翻译模型文件(如
.argosmodel、safetensors或量化二进制包)存放在本机目录,加载时不需要向远程服务器发送哈希校验或鉴权请求。 - 本地计算引擎完成文本解码:依靠本地 CPU 或 GPU 的矩阵运算库(如 OpenNMT、ONNX Runtime、LibTorch 或 CTranslate2)在宿主机内存中完成从“源语言分词 -> 向量编码 -> 自注意力解码 -> 目标语言生成”的全部推理计算。
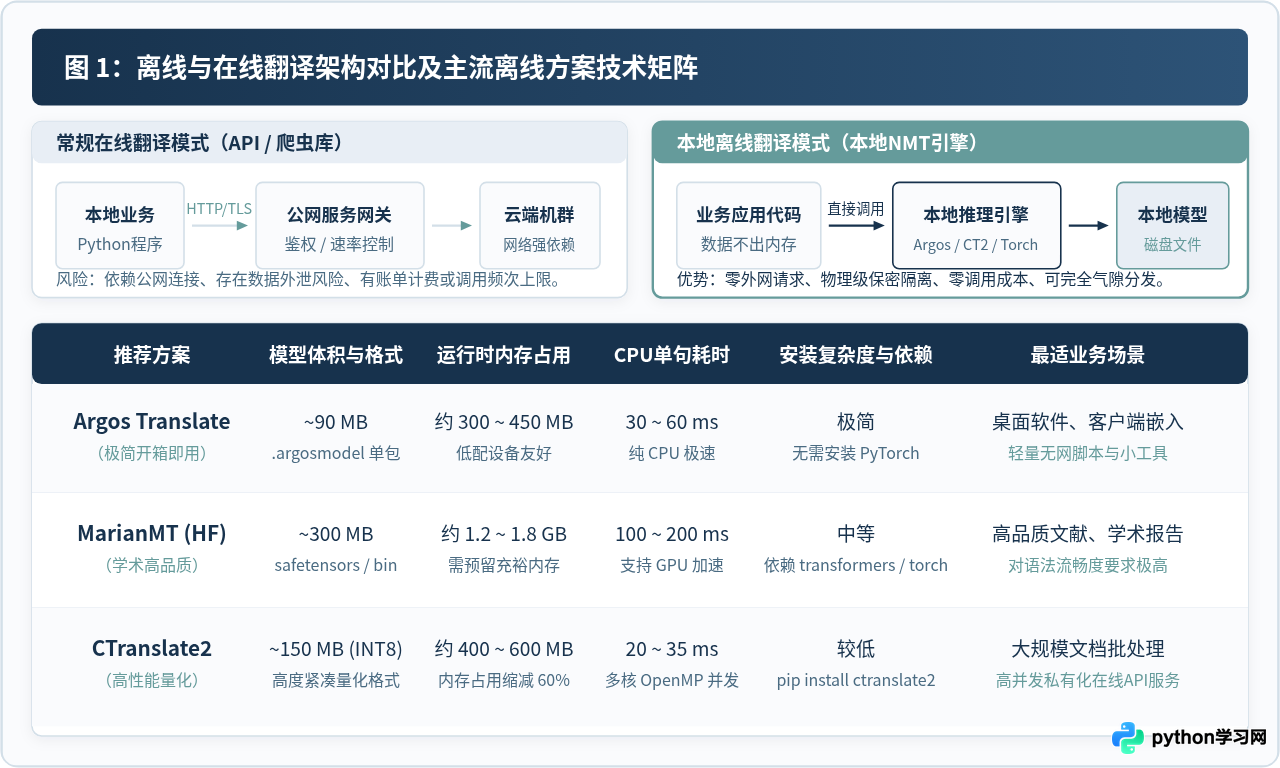
在离线环境下选型时,通常需要平衡三个核心约束条件:
- 资源消耗与环境门槛:设备是否有独立显卡?可用物理内存是 512MB 还是 8GB?是否允许安装庞大的 PyTorch 生态(动辄 1~2GB 体积)?
- 翻译质量与语法自然度:任务是对错误容忍度较高的数据清洗、关键词提取,还是要求语句通顺自然的学术文献、产品文档?
- 并发吞吐与处理延迟:是单句即时交互,还是需要批量处理百万量级的离线日志或网页文本?
二、极简轻量级首选:Argos Translate
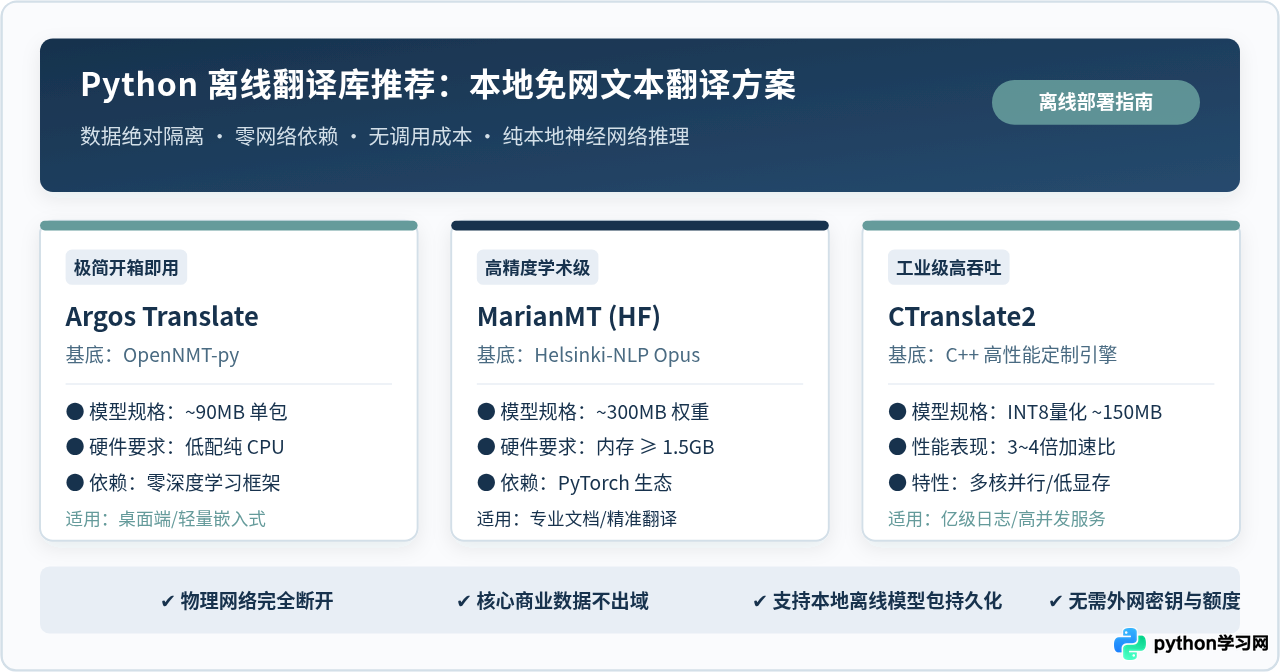
如果你的目标环境是一台普通办公 PC、无显卡的轻量云主机,或者需要把翻译功能嵌入到单文件打包的桌面软件中,Argos Translate 是首选方案。它是一个完全开源的神经机器翻译库,底层基于 OpenNMT 构建,不需要安装重量级的 PyTorch 或 TensorFlow,自身体积小、依赖极简。
1. 工作机制与离线包获取
Argos Translate 将分词器、词表与轻量化神经模型统一压缩为后缀名为 .argosmodel 的单一压缩包(例如中译英模型约 85MB,英译法模型约 90MB)。在无网环境使用时,只需在有网机器上预先下载好对应语言包,通过内部制品库或 U 盘拷贝至目标机器,随后通过 Python 代码即可直接挂载。
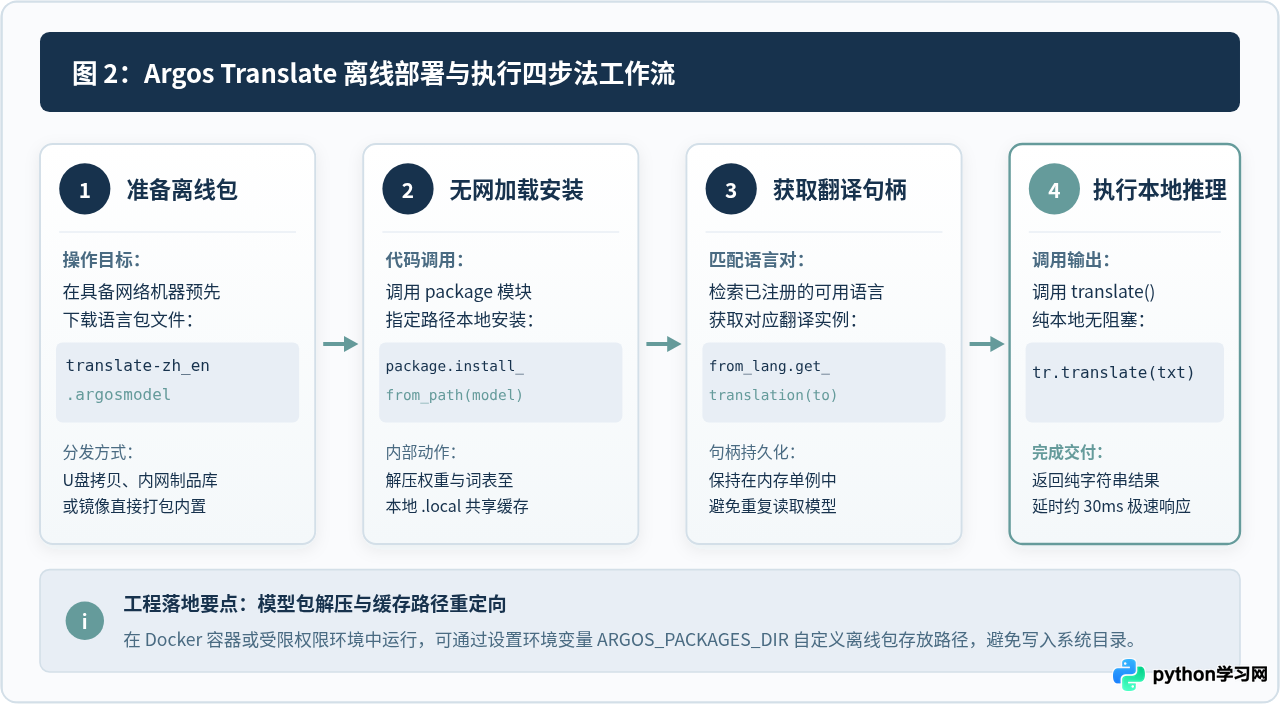
2. 离线安装与翻译执行完整代码
首先在离线环境的目标 Python 环境中安装基础库(可在有网机器使用 pip download argostranslate 离线转存 wheel 包):
pip install argostranslate以下代码演示了如何在不产生任何外部网络探测的前提下,由本地文件安装模型包并执行中文到英文的离线翻译:
import os
from pathlib import Path
import argostranslate.package
import argostranslate.translate

def setup_offline_argos(model_file_path: str):
    """
    离线安装本地 .argosmodel 语言包
    """
    if not os.path.exists(model_file_path):
        raise FileNotFoundError(f"未找到指定的离线模型文件: {model_file_path}")

    # 直接由本地路径安装模型包到本地缓存目录
    argostranslate.package.install_from_path(model_file_path)
    print(f"成功加载并注册离线语言包: {model_file_path}")

def get_argos_translation_pipeline(from_code: str = "zh", to_code: str = "en"):
    """
    根据语言代号获取离线翻译管道句柄
    """
    installed_languages = argostranslate.translate.get_installed_languages()

    # 查找源语言与目标语言对象
    from_lang = next((lang for lang in installed_languages if lang.code == from_code), None)
    to_lang = next((lang for lang in installed_languages if lang.code == to_code), None)

    if not from_lang or not to_lang:
        raise ValueError(f"未安装满足 {from_code} -> {to_code} 的离线语言包,请确认已导入对应模型。")

    translation = from_lang.get_translation(to_lang)
    if not translation:
        raise RuntimeError(f"未找到从 {from_lang.name} 直接翻译到 {to_lang.name} 的路径。")
    return translation

# ================= 实际离线调用示例 =================
if __name__ == "__main__":
    # 1. 指定事先存放在本地的语言包文件(示例路径,请替换为实际绝对路径)
    local_model_path = os.path.abspath("./models/translate-zh_en-1_9.argosmodel")

    # 2. 如果尚未安装到本地环境,则执行安装
    # setup_offline_argos(local_model_path)

    # 3. 获取翻译器实例(建议初始化后常驻内存复用,避免单句重复构建)
    translator = get_argos_translation_pipeline("zh", "en")

    source_text = "本地离线神经网络翻译方案可以有效保障数据安全与隐私。"
    translated_result = translator.translate(source_text)

    print("【源文本】:", source_text)
    print("【译文】:", translated_result)
    # 示例输出:
    # 【源文本】: 本地离线神经网络翻译方案可以有效保障数据安全与隐私。
# 【译文】: Local offline neural network translation solutions can effectively protect data security and privacy.~/.local/share/argos-translate)。如果应用程序运行在只读文件系统或无 HOME 目录的 Docker 容器中,可在导入库之前声明环境变量 os.environ["ARGOS_PACKAGES_DIR"] = "/opt/app/argos_packages",从而显式控制数据解压存放路径。
三、学术级高品质方案:Transformers + Helsinki-NLP (MarianMT)
如果业务对翻译准确度、学术文献的长难句语法结构有更高要求,且运行环境具备 2GB 以上可用物理内存(或有 NVIDIA GPU 加速),基于 Hugging Face Transformers 的 Helsinki-NLP / Opus-MT 系列模型是业内公认质量出色的开源神经翻译方案。
1. 离线化文件准备
该方案基于赫尔辛基大学在欧洲语言资源协会开源的一系列双语翻译模型。为了实现 100% 离线运行,需要在一台联网机器上将模型目录完整保存下来。以中译英模型 Helsinki-NLP/opus-mt-zh-en 为例,需要下载以下核心文件并存入名为 opus-mt-zh-en 的文件夹中:
config.json(网络结构与超参数)pytorch_model.bin或model.safetensors(模型权重,约 312MB)source.spm与target.spm(SentencePiece 分词词表)tokenizer_config.json与vocab.json(分词映射配置)
2. 强制离线加载与文本翻译代码
编写 Python 代码加载本地权重时,必须传递 local_files_only=True 参数。该参数是确保 Transformers 绝不向 Hugging Face Hub 发起网络探测的关键保险:
import os
from transformers import MarianMTModel, MarianTokenizer

class OfflineMarianTranslator:
    def __init__(self, model_directory: str, device: str = "cpu"):
        """
        加载纯本地 Hugging Face MarianMT 离线权重
        """
        if not os.path.isdir(model_directory):
            raise NotADirectoryError(f"模型目录不存在: {model_directory}")

        self.device = device
        print(f"正在从本地目录加载分词器与模型权重: {model_directory} ...")

        # 核心关键点:local_files_only=True 严格杜绝网络请求
        self.tokenizer = MarianTokenizer.from_pretrained(
            model_directory,
            local_files_only=True
        )
        self.model = MarianMTModel.from_pretrained(
            model_directory,
            local_files_only=True
        ).to(self.device)

        # 设置模型为评估模式(关闭 Dropout)
        self.model.eval()
        print("本地模型加载完成,处于离线就绪状态。")

    def translate_batch(self, text_list: list[str], max_length: int = 512) -> list[str]:
        """
        支持单句与多句批处理翻译
        """
        # 1. 本地分词器编码
        encoded_inputs = self.tokenizer(
            text_list,
            return_tensors="pt",
            padding=True,
            truncation=True,
            max_length=max_length
        ).to(self.device)

        # 2. 本地模型生成解码 (可通过 num_beams 调整束搜索宽度)
        generated_tokens = self.model.generate(
            **encoded_inputs,
            num_beams=4,
            max_length=max_length,
            early_stopping=True
        )

        # 3. 将 Token IDs 解码还原为自然文本
        results = [
            self.tokenizer.decode(t, skip_special_tokens=True)
            for t in generated_tokens
        ]
        return results

# ================= 运行示例 =================
if __name__ == "__main__":
    local_dir = os.path.abspath("./models/opus-mt-zh-en")

    # 实例化翻译器(若有 CUDA GPU,可设 device="cuda")
    translator = OfflineMarianTranslator(model_directory=local_dir, device="cpu")

    test_sentences = [
      "深度学习模型在本地边缘计算设备上的推理效率正在快速提升。",
      "该模块不需要任何公网访问权限,可直接部署在涉密内部网络中。"
    ]

    translations = translator.translate_batch(test_sentences)
    for src, tgt in zip(test_sentences, translations):
        print(f"原句: {src}")
        print(f"译文: {tgt}
")
    # 示例输出:
    # 原句: 深度学习模型在本地边缘计算设备上的推理效率正在快速提升。
    # 译文: The inference efficiency of deep learning models on local edge computing devices is improving rapidly.
    #
    # 原句: 该模块不需要任何公网访问权限,可直接部署在涉密内部网络中。
    # 译文: The module does not require any public network access and can be deployed directly in classified internal networks.
四、工业级高吞吐引擎:CTranslate2
虽然原生 PyTorch 能够满足功能需求,但在处理大规模离线文档或高并发内部服务时,原生 Python/PyTorch 推理往往受制于 GIL 锁竞争、显存占用高以及 CPU 单核性能利用不充分的问题。CTranslate2 是一款由 OpenNMT 团队开发的工业级专用推理引擎,采用现代 C++ 重写,在离线翻译吞吐场景下表现极其强悍。
| 性能与工程维度 | PyTorch 原生 MarianMT | CTranslate2 (INT8 量化) |
|---|---|---|
| 模型文件磁盘体积 | 约 312 MB (FP32) | 约 78 MB (减小 75%) |
| 常驻运行时内存 | 约 1.4 GB | 约 380 MB (降低 70% 以上) |
| 多核 CPU 推理吞吐 | 基准 1.0x (约 80 词/秒) | 3.5x ~ 4.2x (约 320 词/秒) |
| 外部重量级依赖 | 依赖 PyTorch 全家桶 | 仅依赖极小预编译库 ctranslate2 |
1. 模型离线转换(在有网/开发机预执行)
CTranslate2 提供了命令行转换工具,可以将下载好的 Hugging Face 模型一键转换为 INT8 高性能二进制格式:
# 在安装有 ctranslate2 和 transformers 的机器上执行预转换
ct2-transformers-converter --model ./models/opus-mt-zh-en                            --output_dir ./models/opus-mt-zh-en-ct2-int8                            --quantization int8
执行完成后,生成的 opus-mt-zh-en-ct2-int8 目录即为全部生产运行时依赖,体积仅几十兆,非常适合随应用整体打包。
2. 离线批量高吞吐推理代码
在离线生产环境中,直接通过 Python 绑定调用 CTranslate2,并配合轻量分词器:
import os
import ctranslate2
import sentencepiece as spm

class FastOfflineCT2Translator:
    def __init__(self, ct2_model_dir: str, spm_model_path: str, cpu_threads: int = 4):
        """
        高性能离线量化推理引擎
        """
        if not os.path.exists(ct2_model_dir):
            raise FileNotFoundError(f"未找到CTranslate2模型目录: {ct2_model_dir}")
        if not os.path.exists(spm_model_path):
            raise FileNotFoundError(f"未找到SentencePiece模型: {spm_model_path}")

        # 初始化 C++ 推理核心,指定工作线程数与计算类型
        self.translator = ctranslate2.Translator(
            ct2_model_dir,
            device="cpu",
            intra_threads=cpu_threads,
            compute_type="int8"
        )
        # 加载分词器词表
        self.sp = spm.SentencePieceProcessor()
        self.sp.load(spm_model_path)
        print("CTranslate2 INT8 离线翻译引擎加载成功。")

    def translate_sentences(self, texts: list[str]) -> list[str]:
        # 1. 分词转换:将输入句子切分为 Subword 符号序列
        source_tokens = [self.sp.encode(text, out_type=str) for text in texts]

        # 2. 批量推理:底层多核并行快速解码
        results = self.translator.translate_batch(
            source_tokens,
            beam_size=4,
            max_batch_size=32
        )

        # 3. 反分词:将生成的 Subword 标记组装回常规标点字符串
        translated_texts = [
            self.sp.decode(item.hypotheses[0])
            for item in results
        ]
        return translated_texts

# ================= 实际离线执行示例 =================
if __name__ == "__main__":
    model_dir = os.path.abspath("./models/opus-mt-zh-en-ct2-int8")
    spm_path = os.path.abspath("./models/opus-mt-zh-en/source.spm")

    # engine = FastOfflineCT2Translator(model_dir, spm_path, cpu_threads=4)
    # outputs = engine.translate_sentences(["这是一个高性能离线计算流水线。"])
    # print(outputs)
五、离线翻译工程化落地要点与避坑指南
在实际将离线翻译部署到无网生产环境时,除了选定模型之外,文本预处理与数据流水线的严谨设计往往直接决定了系统的稳定性。
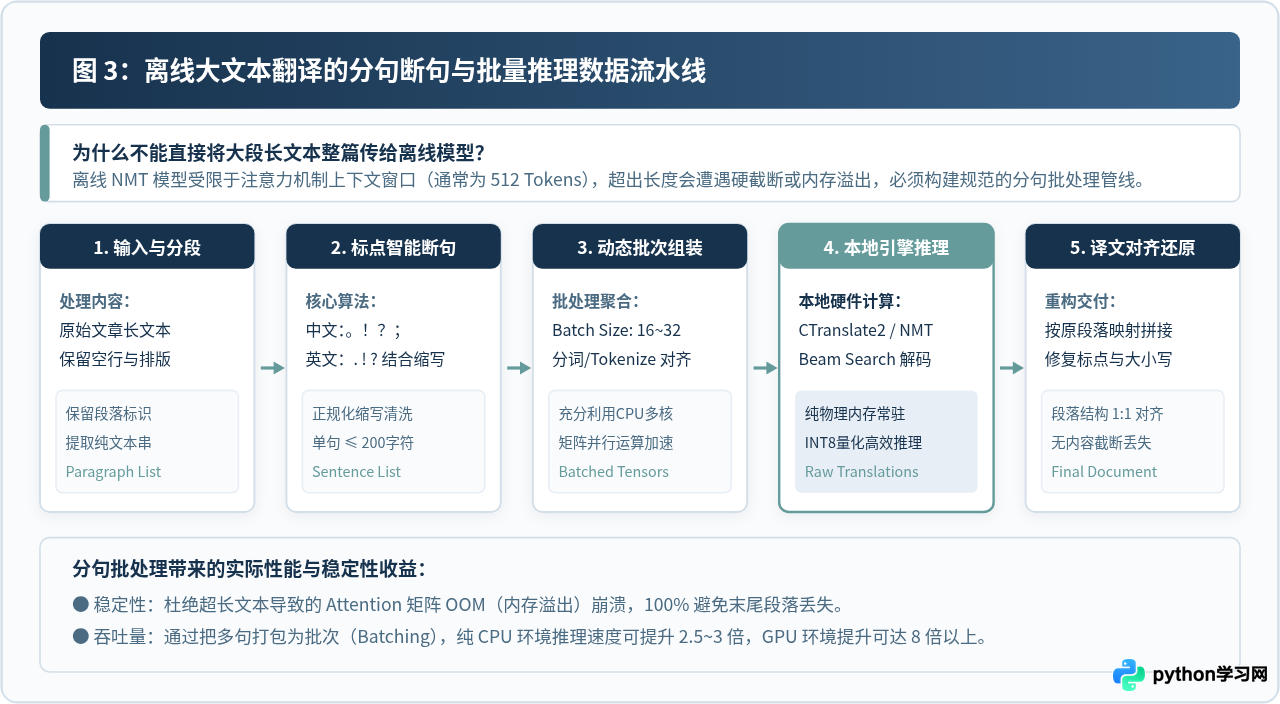
1. 必须实施分句断句,杜绝长文本直接输入
绝大多数神经翻译模型(无论是 Argos 还是 MarianMT)都有硬性的上下文长度上限(常用配置为 512 个 token)。如果开发者直接把一篇包含数千字的文章或长段落作为单一字符串传入 translate(),会产生严重后果:
- 末尾文本丢失截断:模型在达到 512 token 后直接结束解码,导致长文本后半部分完全丢失。
- 注意力显存/内存剧烈膨胀:自注意力机制的计算开销与序列长度呈二次方增长($O(N^2)$),直接输入超长单行会导致内存突增甚至 OOM 闪退。
工程规范解法:在文本进入翻译引擎前,必须使用基于正则表达式或轻量 NLP 规则库对文章进行段落与断句切分,按照句子颗粒度打包为批次(如每批 16~32 句)送入模型,完成推理后再依据原始段落索引无损拼装还原。
2. 提供工业级长文本处理实现模板
下面给出一段可直接复用的离线长文本清洗与批量翻译包装器:
import re

def split_chinese_sentences(text: str) -> list[str]:
    """
    按中文句子边界(句号、感叹号、问号、分号)安全断句,保留段落排版逻辑
    """
    if not text:
        return []

    # 按照常见句末标点符号拆分,同时保留标点
    pattern = r'([^。!?!?;;
]+[。!?!?;;
]?)'
    matches = re.findall(pattern, text)

    sentences = []
    for sentence in matches:
        s = sentence.strip()
        if s:
            sentences.append(s)
    return sentences

def translate_long_article(raw_article: str, translator_func, batch_size: int = 16) -> str:
    """
    长文章离线批量流水线包装器
    :param raw_article: 原始完整长文本
    :param translator_func: 接收 list[str] 并返回 list[str] 的翻译函数对象
    :param batch_size: 批处理大小
    """
    paragraphs = raw_article.split('
')
    translated_paragraphs = []

    for para in paragraphs:
        if not para.strip():
            translated_paragraphs.append("")
            continue

        sentences = split_chinese_sentences(para)
        para_translations = []

        # 分批次送入翻译引擎
        for i in range(0, len(sentences), batch_size):
            batch = sentences[i:i + batch_size]
            translated_batch = translator_func(batch)
            para_translations.extend(translated_batch)

        # 将句子重新组合为段落(英文译文之间拼接空格)
        translated_paragraphs.append(" ".join(para_translations))

    return "
".join(translated_paragraphs)
3. 离线服务“冷启动预热”技巧
在后端服务(如 FastAPI / Flask 或后台处理 Worker)启动时,虽然模型权重已经读取至内存,但底层的推理计算图、底层线性代数库缓存(如 MKL / OpenBLAS)通常在初次执行时才会发生实际内存分配。如果不做预热,第一位用户请求往往会出现 2~5 秒的“首字卡顿”。
最佳实践:在服务初始化加载完模型之后,立即在代码内部喂入一句极短的样例(如 translator.translate("你好")),使其完成计算图初始化与物理内存锁定,后续业务请求即可立即达到稳定的毫秒级响应。
六、方案选择决策树与全文总结
为了帮助读者根据实际硬件环境与业务目标迅速确定技术路线,下图总结了完整的决策路径:
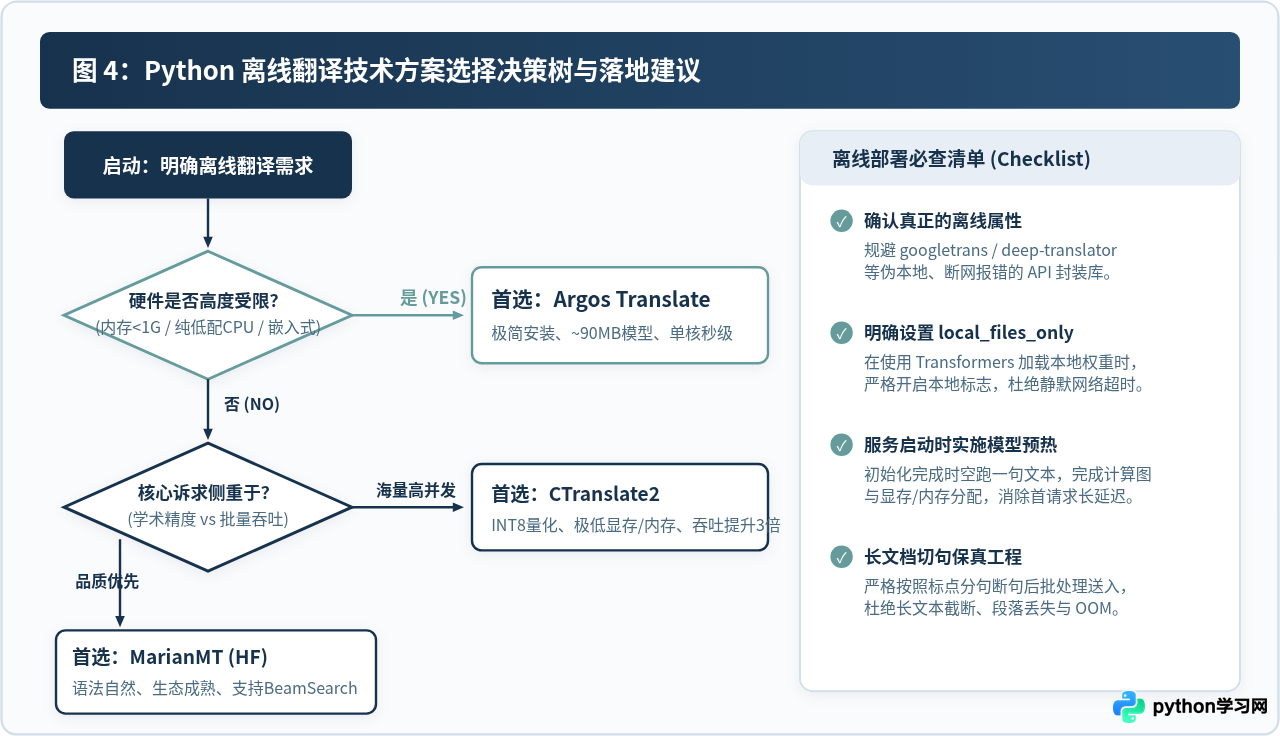
回顾本文推荐的三种本地离线方案,可以根据不同场景的侧重点直接做决定:
- 极简便携、桌面集成、低配纯 CPU:选用 Argos Translate。安装包体最小,零大型深度学习框架负担,模型包单文件便于物理隔离分发。
- 学术文献、专业书籍、质量优先:选用 Helsinki-NLP MarianMT。语法自然流利,配合
local_files_only=True严格确保数据隐私不外泄。 - 高并发吞吐、大规模批处理、内存受限生产环境:选用 CTranslate2 配合 INT8 量化模型。以极低的内存和磁盘占用,换取数倍于原生 PyTorch 的批量解码性能。
真正可靠的离线文本翻译架构,始于彻底切断远程网络依赖,终于严谨的长文本分句与工程调度。选择契合当前系统算力与业务精度的方案,即可在没有外部网络支持的前提下,构建出坚固、安全且高效的本地自然语言处理能力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















