


Python在人工智能和大数据领域真的不可替代吗?
深入剖析Python在AI与大数据领域的真实地位与技术边界,解答Python是否真的不可替代,解析上层胶水生态与底层高性能计算引擎的分工协作关系。
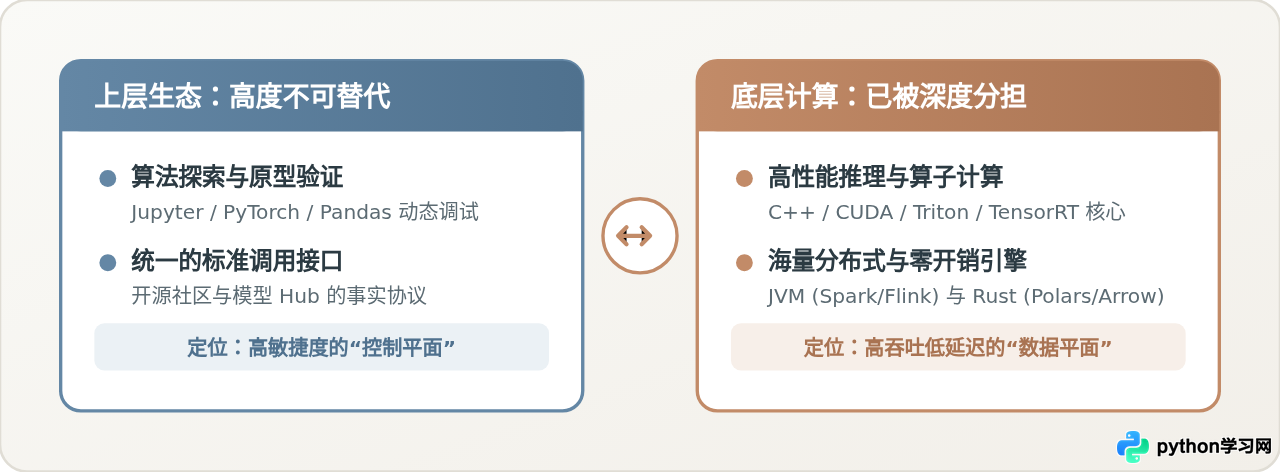
一、系统分层架构:为什么 Python 给人“不可替代”的直观印象?
初学者或非工程人员常有一种直观印象:写一段 Python 代码就能训练前沿大模型,调用一个 Pandas 方法就能秒级过滤数百万条数据,因此误以为“所有脏活累活都是 Python 跑出来的”。要看清 Python 的不可替代性边界,必须拆解现代系统的实际分层架构。
在工程实现中,AI 与大数据技术栈遵循着严格的“双层架构设计”:上层是负责面向算法工程师的控制平面(Control Plane),下层则是面向物理硬件的数据平面(Data Plane)。
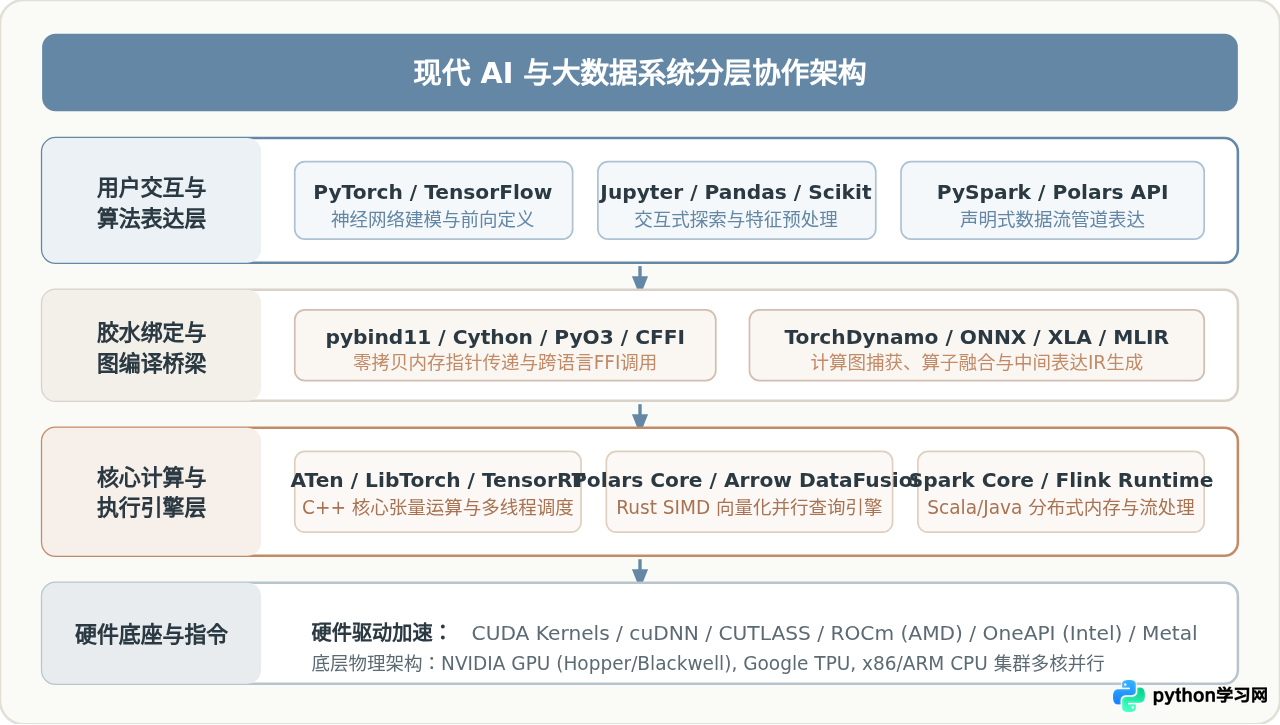
在这个分层结构中,各层的具体职责边界极其清晰:
- 顶层交互与建模(Python):工程师使用简洁的 Python 语法编写矩阵乘法、卷积层声明或数据管道描述。这部分代码主要负责构建计算逻辑图与分发任务,本身只消耗极少的 CPU 解释时间。
- 胶水桥梁与图编译(pybind11 / Cython / TorchDynamo):Python 代码不会直接在 CPU 循环里逐个累加浮点数,而是将数据指针与运算图通过 C-FFI 接口直接推送到底层静态库。
- 计算内核与硬件执行(C++ / CUDA / Rust / JVM):PyTorch 底层的 ATen 库是纯 C++ 实现,GPU 显存内运行的是手写的 CUDA / CUTLASS 内核;数据分析库 Polars 底层是多线程 SIMD 加速的 Rust 引擎;Spark 底层则是 Scala 实现的 JVM 字节码。
因此,Python 在这一层面的“不可替代”,其实是“不可替代的高层抽象表达接口”。如果强行把底层 C++ 替换成纯 Python 解释执行,矩阵计算吞吐量会暴跌两到三个数量级;而如果把上层 Python 接口换成 C++,算法研发人员的试验迭代效率同样会遭受灾难性倒退。
二、人工智能领域:Python 的真正护城河与被替代的环节
在人工智能尤其是深度学习与大语言模型(LLM)领域,Python 的护城河并不在解释器本身,而在于长期积累形成的生态飞轮(Ecosystem Flywheel)与科研协作共识。
1. 为什么上层难以替代:飞轮效应与交互调试
全球顶级高校与研究机构在发布前沿模型论文时,几乎百分之百首选附带 Python/PyTorch 代码仓库。预训练权重格式、分词器标准、Hugging Face 平台协议均原生锚定 Python。任何新编程语言即使在语法或单线程速度上超越 Python,若缺乏这数以万计开箱即用的模型权重与算子绑定,算法团队迁移的沉没成本将高到无法承受。
此外,算法探索阶段伴随着极高的不确定性。工程师需要使用 Jupyter Notebook 交互式地查看单步张量形状、打印中间梯度、即时绘制特征分布。Python 的动态类型与即时解释机制,恰好完美迎合了这种探索式工作流。
2. 真实落地链条:从训练到推理的语言流转
然而,当模型完成算法验证并走向商业化生产环境时,脱离 Python 往往是必经之路。一个工业级 AI 项目的生命周期包含清晰的语言交接流程:
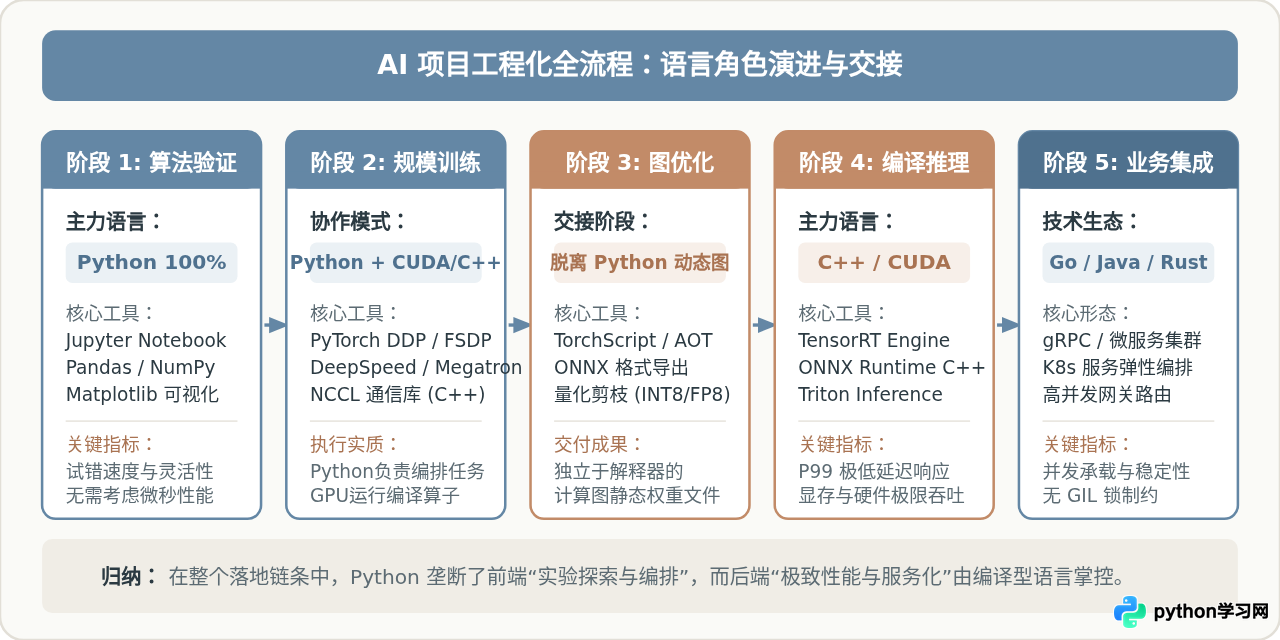
如图 2 所示,在阶段 3 和阶段 4 中,工程团队会主动将模型从 Python 运行时中“剥离”出来:
- 脱离解释器:通过
torch.jit.trace、torch.compile或 ONNX 导出静态计算图,消除全局解释器锁(GIL)对多线程调度的干扰。 - 引擎替换:在线推理引擎(如 TensorRT、ONNX Runtime C++、Triton Inference Server)通常直接由 C++ 编写,实现微秒级延迟响应与高吞吐显存重用。
- 微服务接入:外部高并发请求网关与鉴权调度通常采用 Go、Java 或 Rust 实现,仅把推理引擎当作共享库或 gRPC 后端调用。
初学者容易直接使用 Flask/FastAPI 包装 PyTorch 原生模型提供高并发线上 API。在高 QPS 场景下,由于 Python GIL 的存在以及动态图执行开销,显卡利用率往往不足 30%,且延迟波动极大(P99 剧增)。正规工业做法必须经过计算图固化与编译型推理引擎加载。
三、大数据处理领域:JVM 的长期统治与现代编译型引擎的冲击
与 AI 领域 Python 的高统治力相比,在大数据基础设施领域,Python 从未成为绝对的主宰,甚至在相当长一段时间内处于辅助地位。
1. 大数据底层基础设施的 JVM 基因
工业级分布式大数据基础设施(Hadoop HDFS、Apache Spark、Apache Flink、Apache Kafka、Elasticsearch)全部扎根于 JVM 生态(Java 与 Scala)。在超大规模分布式集群中,JVM 提供了成熟的高并发多线程模型、内存堆外管理以及强大的网络通信框架(如 Netty)。
虽然社区推出了 PySpark 让数据工程师能用 Python 语法提交任务,但其底层运行机理揭示了性能代价:
# 示例:PySpark 中高开销的自定义 Python UDF(需跨进程传递数据)
from pyspark.sql import SparkSession
from pyspark.sql.functions import udf
from pyspark.sql.types import StringType

spark = SparkSession.builder.appName("DataPipeline").getOrCreate()

# 警告:普通 Python UDF 会迫使 JVM 将数据序列化、通过 Socket 传给 Python Worker,再反序列化回 JVM
@udf(returnType=StringType())
def parse_record(text: str) -> str:
    # 纯 Python 逻辑:在海量数据遍历时会引发严重性能瓶颈
    return text.strip().lower()

# 正确做法:优先使用 Spark SQL 原生内置函数(完全在 JVM 内存中零拷贝执行)
如上述代码所示,在分布式集群上执行原生 Python 代码,必须启动专门的 Python Worker 子进程,数据需在 JVM 与 Python 进程间频繁序列化(Py4J / Pickle),吞吐量往往显著低于纯 Scala 或 Spark 原生 Catalyst 表达式。
2. 新一代高性能编译型引擎的兴起:Rust 与 C++
近年来,大数据处理领域正在发生一场底层架构更迭:基于 Apache Arrow 内存列式标准的向量化计算引擎正在全面替代老旧实现。
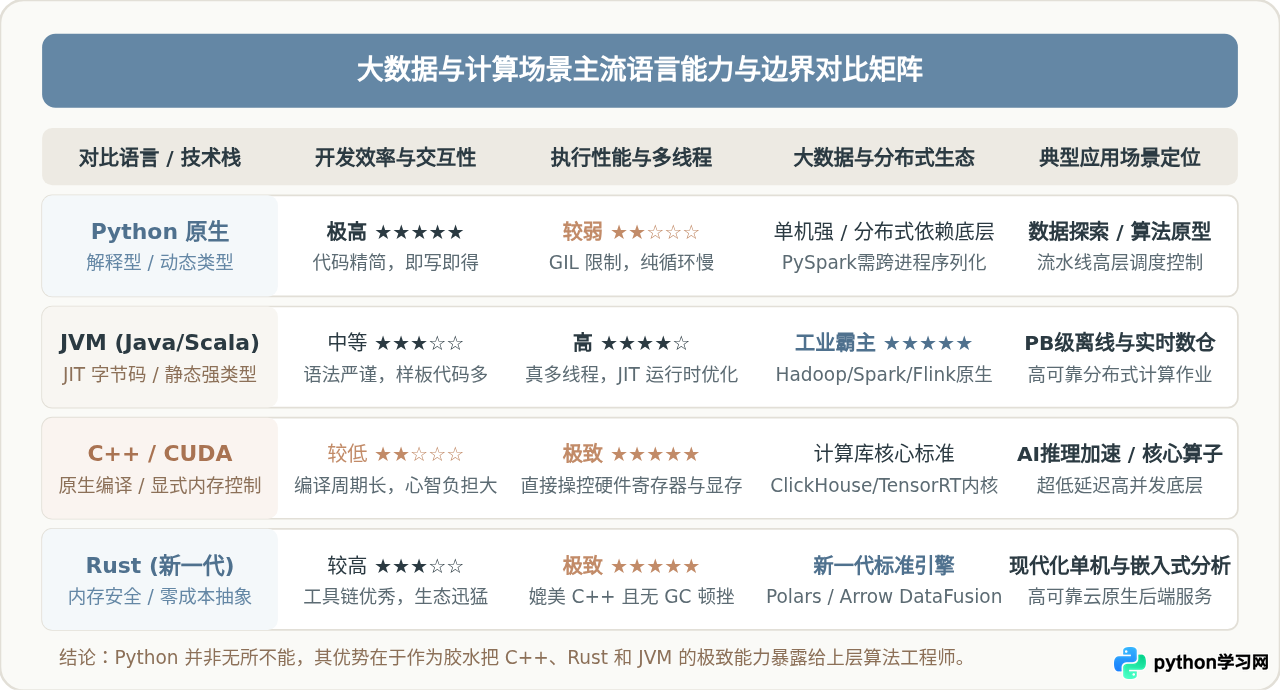
典型代表如 Polars(基于 Rust)和 DuckDB(基于 C++)。在这些新引擎中,用户虽然依然在 Python 中敲下代码,但底层的查询优化器、向量化执行引擎(SIMD 指令加速)与多核多线程调度全部由编译型语言掌控。Python 在这里退化为纯粹的“配置式 DSL(领域特定语言)”。
四、生产实践:如何做出理性的技术选型与替代决策?
读者在实际开发或技术架构选型时,不应盲目崇拜某一种语言,而应依据业务阶段、吞吐要求、数据体量与团队结构建立清晰的判断路径。
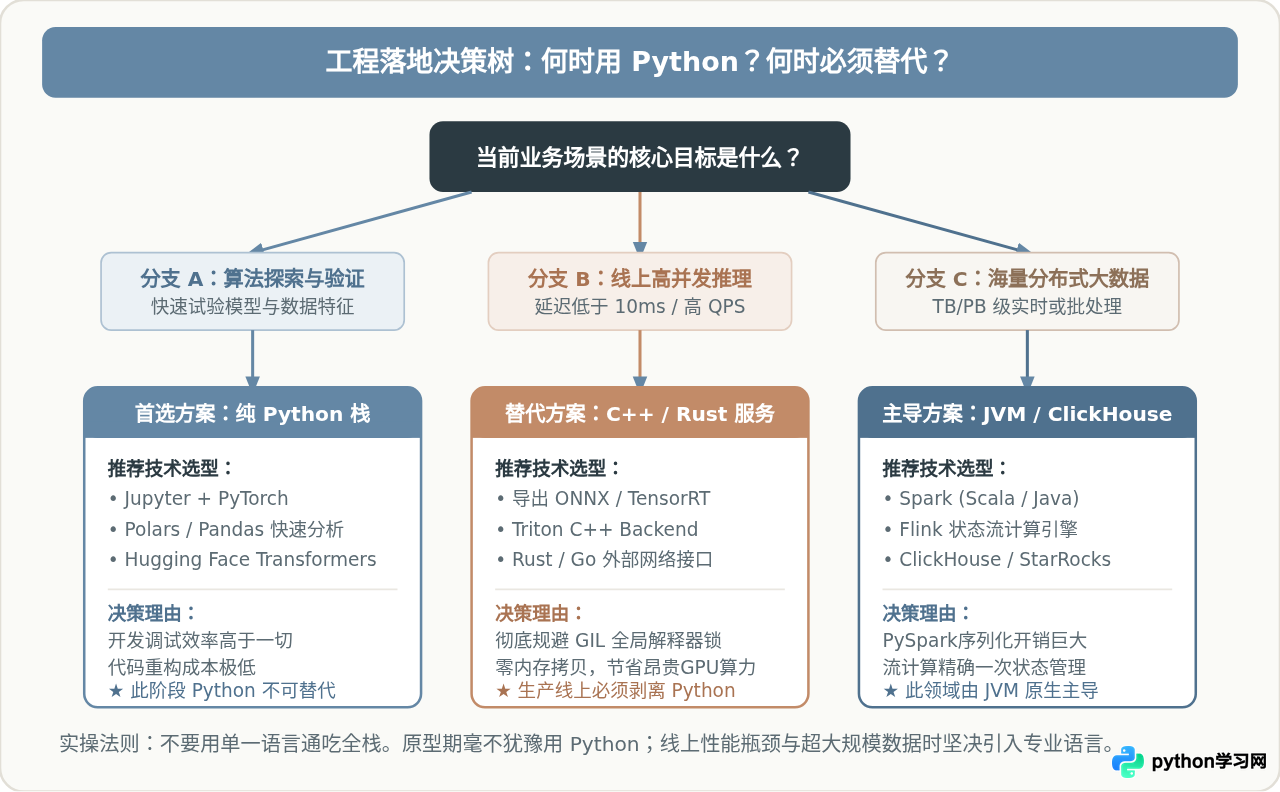
在具体工程实践中,可以依照以下可执行的步骤进行技术选型与交接:
步骤 1:明确当前阶段的核心约束
如果业务目标是“一周内验证某种新算法在业务数据上的准确率指标”,那么毫不犹豫采用纯 Python 栈。在这个阶段,开发者的脑力时间远比服务器运行的毫秒级算力更昂贵。过早引入 C++ 重构或 JVM 编译只会拖垮迭代节奏。
步骤 2:识别系统性能瓶颈所在
当原型算法跑通后,通过 Profiler 工具(如 cProfile 或 Py-Spy)进行性能画像分析:
- 如果 90% 的耗时在底层的张量乘法或 BLAS 库调用中,说明 Python 并不是瓶颈,底层硬件优化才有效,无需重写上层业务逻辑。
- 如果耗时集中在 Python 自身的密集循环、字典查找、字符串解析或 GIL 导致的线程阻塞上,则必须将这部分核心模块用 C++、Cython 或 Rust 重写并打包为 Python 扩展包。
步骤 3:构建跨语言混合生产架构
成熟技术团队的标准实践绝非“全盘用 A 替代 B”,而是“各司其职”:
数据清洗与特征工程
单机中大规模数据首选 Python + Polars / DuckDB;百亿级分布式数据选用 Spark (Scala/SQL) 或 Flink。
算法探索与模型训练
无争议选用 Python + PyTorch / JAX,深度依托开源生态的模型权重与前沿库。
线上实时高性能推理
将模型导出为 ONNX / TensorRT,在线推理引擎采用 C++ / Triton,网络层使用 Go / Rust。
五、不可替代性综合评估与总结
回到最初的问题:“Python在人工智能和大数据领域真的不可替代吗?”我们可以给出一个严谨且不失客观的定论:
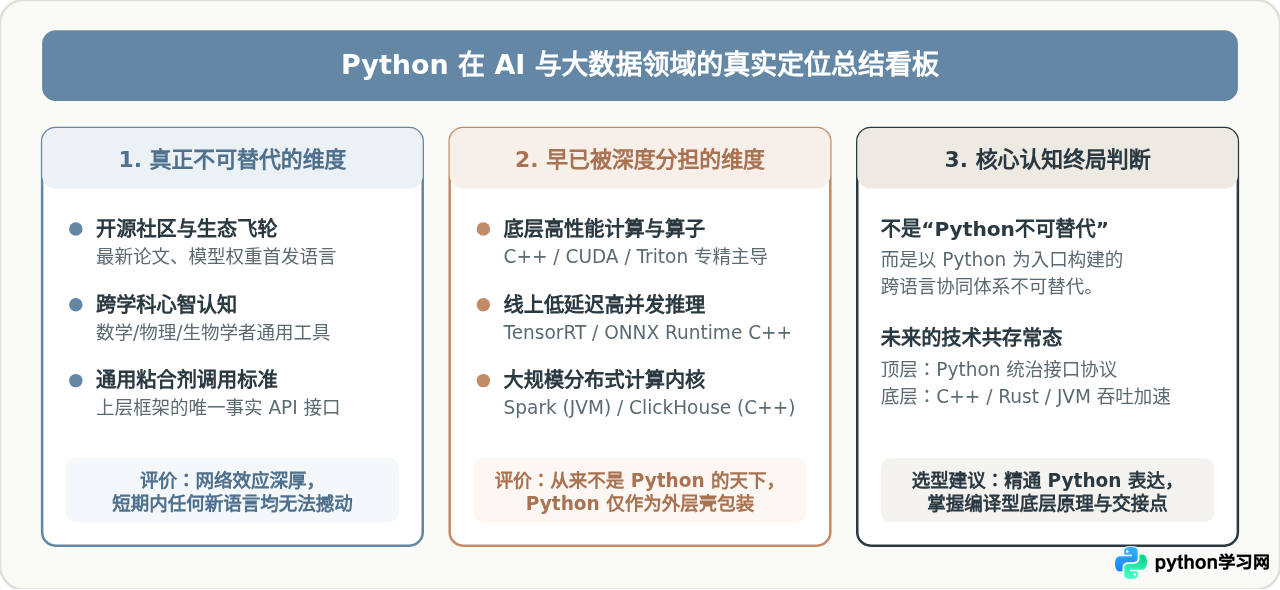
- 不可替代的是“顶层生态标准”,而非“语言计算内核”:Python 凭借其极低的语法心智负担与强大的动态黏合力,已经成为全球计算机科学界与跨学科专家共同使用的“交互协议”。重造一个语言容易,重造数十万算法库构筑的学术与工业飞轮几乎不可能。
- 底层运算从来就不是 Python 的属地:Python 从未统治过硬件底层。现代 AI 与大数据系统的高性能本质,是底层 C++、CUDA、Rust 和 JVM 工程师在幕后支撑的结果。
- 工程师的核心竞争力演进:对于现代工程师而言,单纯掌握 Python 基础语法已经不足以应对严苛的生产级工程要求。理解 Python 与底层编译型引擎之间的内存交互原理、掌握跨语言 FFI 机制并具备在生产端进行架构解耦与替代的能力,才是真正核心的工程素养。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















