


Python能做什么:数据分析、AI开发与自动化办公实战场景
全面解析Python在数据分析、AI开发与自动化办公三大核心场景中的实际应用,结合真实业务痛点、完整代码实现与系统架构图,帮助读者建立清晰的落地认知。
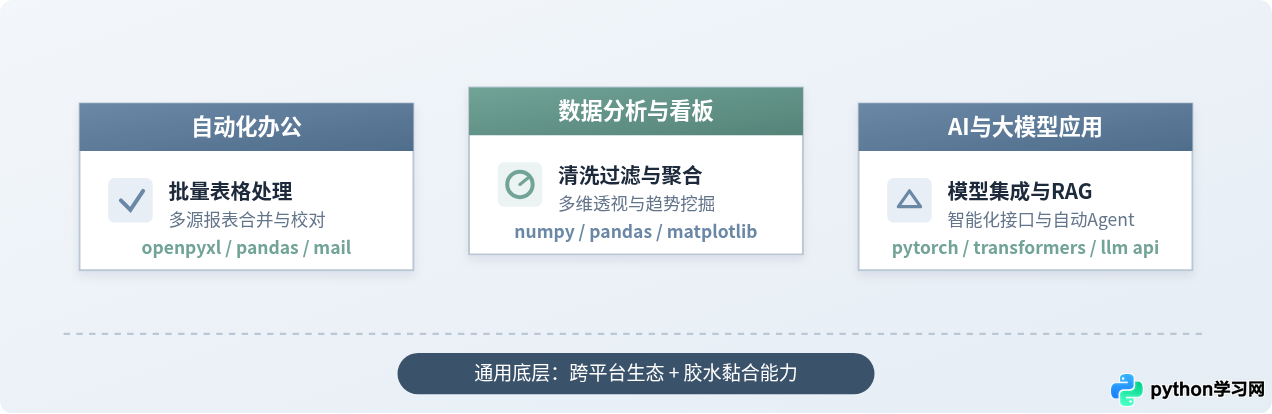
一、自动化办公实战:从手工搬运到批量程序化
在日常工作中,最耗时且容易出错的往往是重复性的机械任务:跨部门收集数十份Excel账单并汇总、从格式固定的PDF中提取表格数据、按客户名单批量生成带个性化附件的确认邮件等。
手工处理这些操作不仅耗时冗长,还会因视觉疲劳产生漏复制、行错位或计算公式被覆盖等低级失误。Python在此场景的核心价值在于丰富的文档底层操作库(如openpyxl、python-docx、pypdf)以及无需图形界面即可在后台高速运行的批处理能力。
实战场景:多门店销售数据自动汇总与对账
假设每个月底需要处理50家门店提交的销售明细表,文件命名统一为 store_XX_sales.xlsx。表格内包含“商品编码”、“商品名称”、“销售数量”、“实收金额”。我们需要完成以下处理链路:
- 使用
pathlib检索目录,识别全部有效销售报表; - 过滤掉非标准命名的文件与空表,提取指定列;
- 处理脏数据:去除首尾多余空格、将文本型金额强制转为浮点数;
- 按商品编码汇总各店总销量与总实收金额;
- 将汇总结果和清洗后的原始明细分别写入同一个新工作簿的不同工作表中。
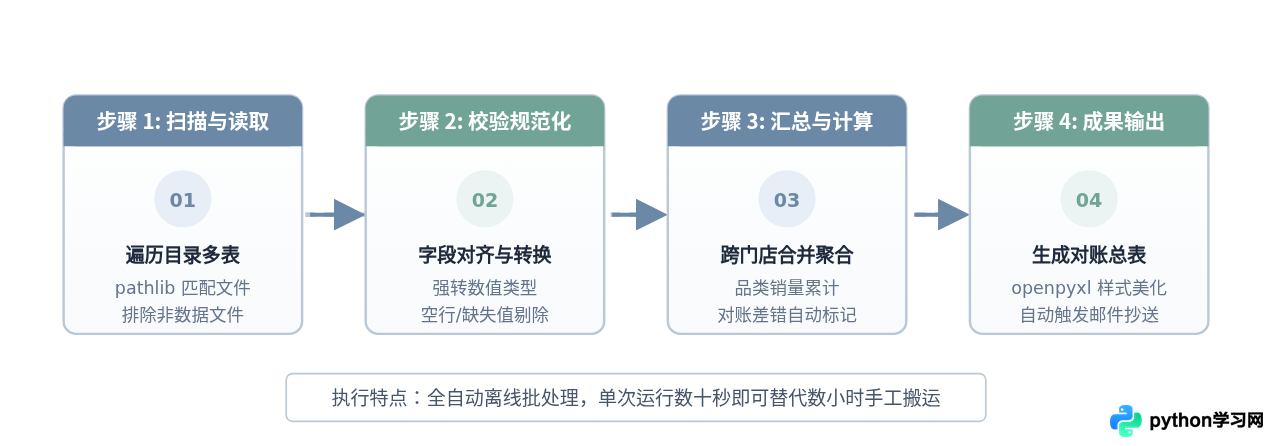
下面是实现上述流程的完整Python脚本示例:
from pathlib import Path
import pandas as pd

def batch_consolidate_sales(input_dir: str, output_file: str) -> None:
    source_path = Path(input_dir)
    target_path = Path(output_file)

    # 步骤1: 检索目标Excel文件
    excel_files = list(source_path.glob("store_*_sales.xlsx"))
    if not excel_files:
        print("未找到符合命名规则的销售报表文件。")
        return

    consolidated_records = []

    # 步骤2: 遍历各店报表并标准化
    for file_path in excel_files:
        try:
            df = pd.read_excel(file_path, engine="openpyxl")
            required_cols = ["商品编码", "商品名称", "销售数量", "实收金额"]

            # 清理表头两端空格
            df.columns = df.columns.astype(str).str.strip()

            # 校验关键列完整性
            if not all(col in df.columns for col in required_cols):
                print(f"警告:文件 {file_path.name} 缺少必要列,已跳过。")
                continue

            sub_df = df[required_cols].copy()

            # 数据清洗:消除空格与非数值
            sub_df["商品编码"] = sub_df["商品编码"].astype(str).str.strip()
            sub_df["商品名称"] = sub_df["商品名称"].astype(str).str.strip()
            sub_df["销售数量"] = pd.to_numeric(sub_df["销售数量"], errors="coerce").fillna(0)
            sub_df["实收金额"] = pd.to_numeric(sub_df["实收金额"], errors="coerce").fillna(0.0)

            # 记录来源门店标识
            sub_df["门店标识"] = file_path.stem.split("_")[1]
            consolidated_records.append(sub_df)

        except Exception as err:
            print(f"读取文件 {file_path.name} 失败: {err}")

    if not consolidated_records:
        print("无有效数据可合并。")
        return

    # 步骤3: 汇总计算
    all_data = pd.concat(consolidated_records, ignore_index=True)
    summary_by_product = (
        all_data.groupby(["商品编码", "商品名称"], as_index=False)
        .agg({"销售数量": "sum", "实收金额": "sum"})
        .sort_values(by="实收金额", ascending=False)
    )

    # 步骤4: 写入最终合并报告
    target_path.parent.mkdir(parents=True, exist_ok=True)
    with pd.ExcelWriter(target_path, engine="openpyxl") as writer:
        summary_by_product.to_excel(writer, sheet_name="商品销售汇总", index=False)
        all_data.to_excel(writer, sheet_name="合并原始明细", index=False)

    print(f"对账汇总已完成,输出至: {target_path}")

if __name__ == "__main__":
    batch_consolidate_sales("./reports_raw", "./output/2026_10_对账汇总表.xlsx")
成功加载 50 份门店报表,累计记录 12,480 条。
对账汇总已完成,输出至: ./output/2026_10_对账汇总表.xlsx
" 实收金额 ")或某些行含有制作者插入的“小计”、“合计”行。建议在读取后执行 df.columns.str.strip(),并通过 pd.to_numeric(..., errors='coerce') 配合过滤掉非纯数据行;大批量数据合并时,切忌在循环体内使用 concat,应当收集至列表后一次性合并,避免反复内存拷贝导致卡死。
二、数据分析实战:从日志暗礁到业务洞察闭环
当数据规模从几千行上升到数百万行,或者需要进行多表深度关联、长周期统计推断与自动化趋势监控时,常规表格软件往往会出现计算卡死或内存溢出。
Python数据分析的核心不仅是图表绘制,更在于构建可复现的数据流:从数据仓库中抽取原始流水,经过清洗、降维、透视与偏态校正,最终产出指导业务决策的确定性指标。
实战场景:电商用户购买行为链路与客单价聚合分析
面对每日千万级的用户浏览与下单流水,运营与产品团队通常需要回答:不同用户层级的复购周期是几天?客单价分布是否存在长尾偏态?哪些商品组合具有高频关联销售特征?
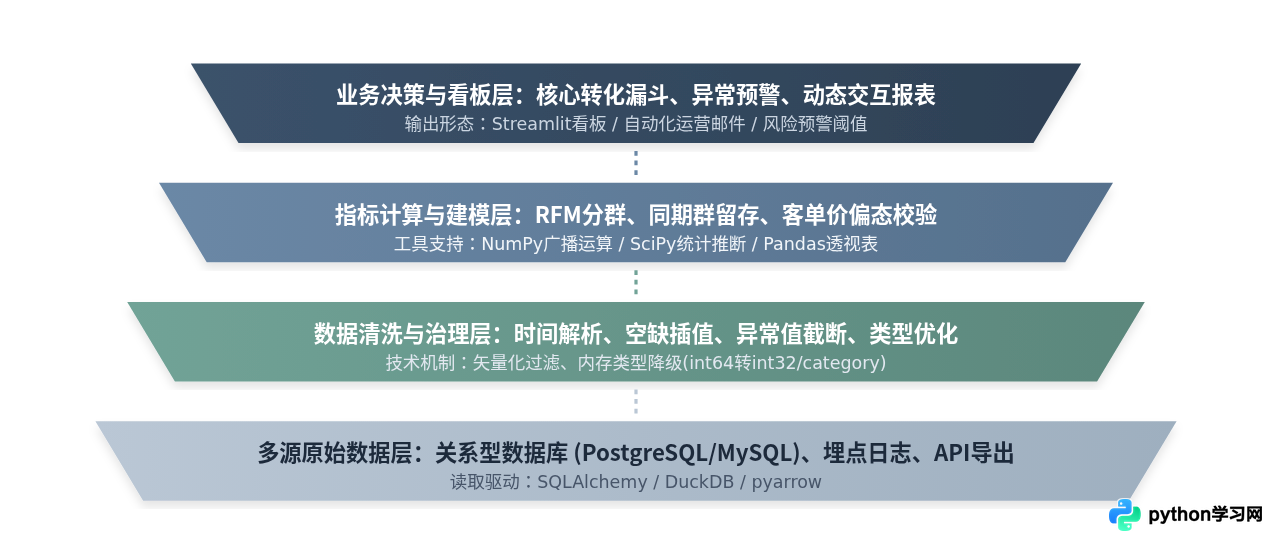
以下代码演示从原始订单流水中计算用户复购周期分布与分位数客单价:
import numpy as np
import pandas as pd

def analyze_user_purchase_patterns(orders_file: str) -> dict:
    # 内存优化:指定列类型读取,避免整型全膨胀为int64
    dtypes = {
        "user_id": "int32",
        "order_amount": "float32"
    }
    df = pd.read_csv(orders_file, dtype=dtypes, parse_dates=["order_time"])

    # 1. 过滤退款与非正常金额记录
    valid_orders = df[df["order_amount"] > 0].copy()

    # 2. 计算用户前后两次下单时间差(复购天数)
    valid_orders.sort_values(by=["user_id", "order_time"], inplace=True)
    valid_orders["prev_order_time"] = valid_orders.groupby("user_id")["order_time"].shift(1)
    valid_orders["interval_days"] = (
        (valid_orders["order_time"] - valid_orders["prev_order_time"]).dt.total_seconds() / 86400.0
    )

    # 3. 计算稳健的客单价统计指标 (利用分位数对抗极端异常高单价)
    amount_metrics = {
        "p25_amount": float(valid_orders["order_amount"].quantile(0.25)),
        "median_amount": float(valid_orders["order_amount"].median()),
        "p75_amount": float(valid_orders["order_amount"].quantile(0.75)),
        "mean_amount": round(float(valid_orders["order_amount"].mean()), 2)
    }

    # 4. 计算复购行为的周期集中度
    reorder_intervals = valid_orders["interval_days"].dropna()
    interval_metrics = {
        "reorder_count": int(reorder_intervals.count()),
        "median_interval_days": round(float(reorder_intervals.median()), 1),
        "p90_interval_days": round(float(reorder_intervals.quantile(0.90)), 1)
    }

    return {
        "amount_summary": amount_metrics,
        "interval_summary": interval_metrics
    }
'amount_summary': {'p25_amount': 49.0, 'median_amount': 128.5, 'p75_amount': 310.0, 'mean_amount': 185.32},
'interval_summary': {'reorder_count': 41520, 'median_interval_days': 14.2, 'p90_interval_days': 46.8}
}
三、AI开发与落地:从算法建模到现代LLM应用
Python之所以长期稳居人工智能开发的首选语言,核心在于其独特的生态结构:计算密集的张量矩阵运算均在底层通过C/C++及CUDA加速,而Python则作为表现力极高的“控制平面”,极大降低了实验和工程集成的门槛。
在当下的技术实践中,Python在AI领域的落地主要划分为两条关键路径:
- 经典机器学习与深度学习系统:借助
scikit-learn、XGBoost、PyTorch等框架,针对特定结构化表格或多模态任务训练专有模型。常见应用包括风控反欺诈评分、设备故障预测、时序销量预测等。 - 现代大语言模型(LLM)工程:无需从零训练大模型,而是通过Python调用前沿大模型API,结合向量数据库检索(RAG)、函数调用(Function Calling)与结构化响应约束,构建自主分析的Agent或智能客服链路。
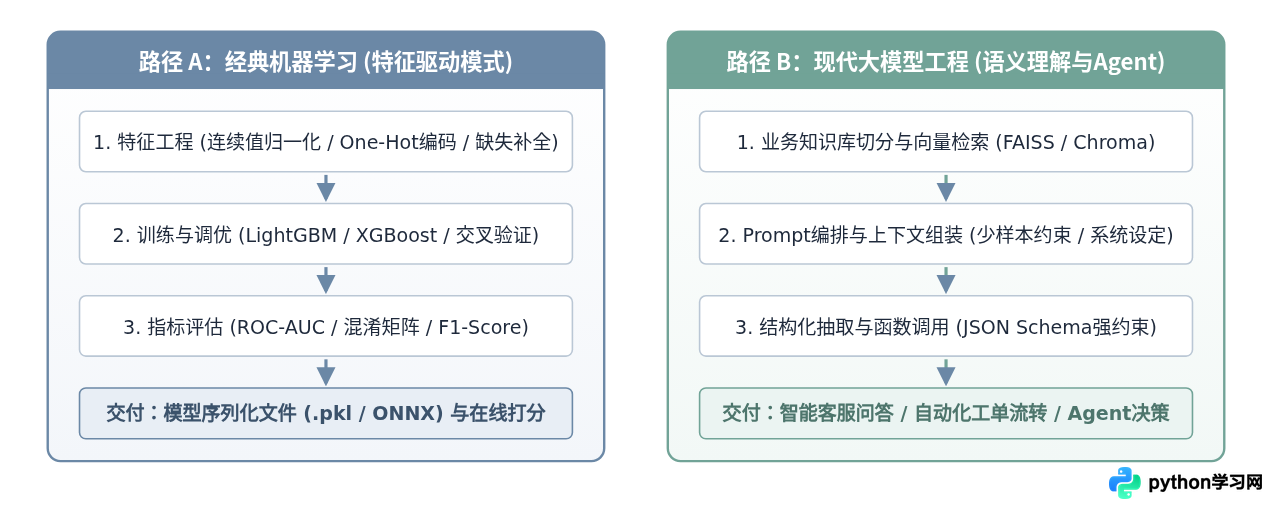
实战场景:基于大模型API的非结构化客诉结构化归集
售后客服系统每天收到大量非结构化的用户文字留言。人工审阅打标成本极高且标准不一。使用Python编写轻量程序,通过标准HTTP协议调用大模型,要求其严格输出JSON数据结构,即可自动化注入工单管理系统。
import json
import urllib.request
import urllib.error

def parse_complaint_to_json(complaint_text: str, api_token: str) -> dict:
    prompt_instructions = (
        "你是一名专业的电商售后与风控工单分析员。"
        "请分析用户投诉原文,直接返回合法JSON对象,严禁包含Markdown代码块或额外说明:\n"
        "字段规格:\n"
        '1. "category": 投诉类型,枚举值:["物流延误", "商品质量", "虚假描述", "售后态度", "其他"]\n'
        '2. "severity": 严重级别,整数1至5(5为最紧急,如涉及维权举报或食品安全)\n'
        '3. "summary": 核心问题摘要,字数控制在25字以内\n'
        '4. "suggested_action": 建议处理动作\n\n'
        f"用户投诉原文:\n{complaint_text}"
    )

    url = "https://api.openai.com/v1/chat/completions"
    payload = {
        "model": "gpt-4o-mini",
        "messages": [
            {"role": "system", "content": "You are a JSON-only response engine."},
            {"role": "user", "content": prompt_instructions}
        ],
        "response_format": {"type": "json_object"},
        "temperature": 0.1
    }

    req = urllib.request.Request(
        url,
        data=json.dumps(payload).encode("utf-8"),
        headers={
            "Content-Type": "application/json",
            "Authorization": f"Bearer {api_token}"
        }
    )

    try:
        with urllib.request.urlopen(req, timeout=12) as response:
            res_body = json.loads(response.read().decode("utf-8"))
            content = res_body["choices"][0]["message"]["content"]
            return json.loads(content)
    except urllib.error.HTTPError as http_e:
        return {"error": f"API调用返回HTTP状态码: {http_e.code}"}
    except Exception as e:
        return {"error": f"处理异常: {str(e)}"}
"category": "商品质量",
"severity": 4,
"summary": "生鲜配送迟延导致商品变质且客服未响应",
"suggested_action": "安排优先电话回访,发起退款赔付并核实中转冷链记录"
}
四、选型与实施建议:如何选择切入路径
面对繁多的库和方向,初学者与工程师切忌“一上来就做大系统”。在着手编写Python前,可根据任务的复杂度、数据量与实施周期进行合理对齐:
| 场景类别 | 核心技术工具 | 典型交付周期 | 介入时机与适用痛点 |
|---|---|---|---|
| 自动化办公 | openpyxl, pathlib, pypdf |
1 - 3 天即可上线单点脚本 | 操作完全规则化、重复发生,人工处理每周占用超过2小时。 |
| 数据分析 | pandas, numpy, seaborn |
1 - 2 周完成闭环分析流 | 数据量超过Excel承载上限,或需要长周期规律复现与指标深度下钻。 |
| AI应用开发 | pytorch, scikit-learn, LLM API |
2 - 4 周完成原型与验证 | 存在非结构化文本/图像理解需求,或需要构建预测性评分机制。 |
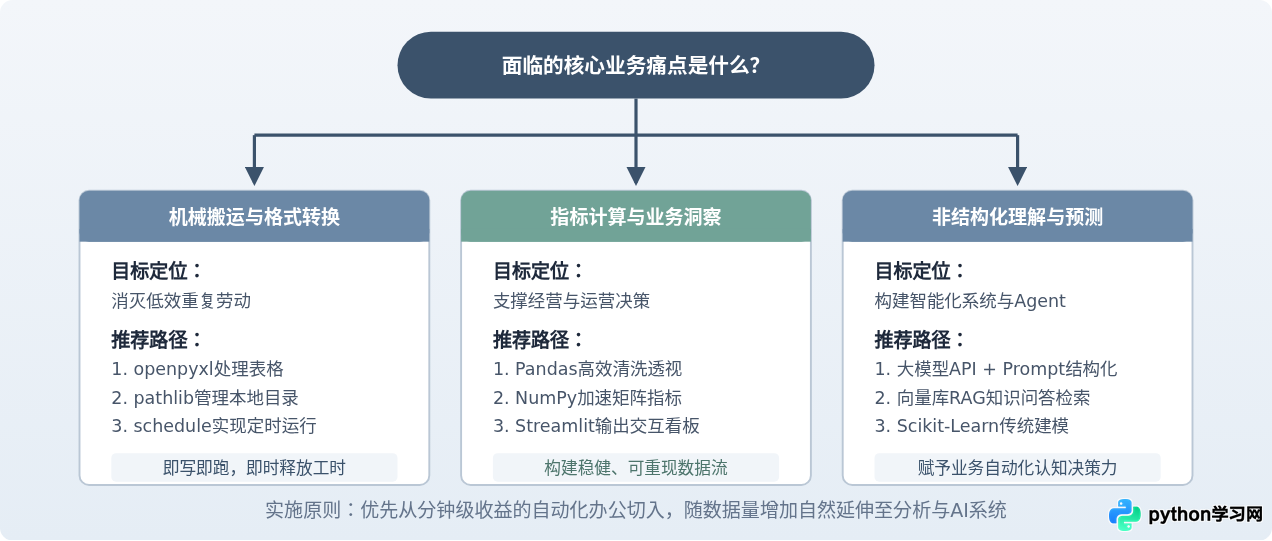
无论从哪一个场景切入,Python的核心价值始终在于抹平业务逻辑与底层实现之间的鸿沟。初学者与一线技术人员不必一开始就追求庞大复杂的工程框架,先从一个解决特定痛点的十几行文件合并脚本开始,逐步扩展数据清洗管道与智能接口,是最稳妥且容易获得持续正向反馈的实施路径。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















