


Python打包exe后体积过大?减小文件大小的优化方法
针对Python使用PyInstaller打包exe文件体积臃肿过大的问题,深入分析依赖递归收集与环境污染根源,提供基于纯净虚拟环境、模块精准排除、轻量库替代与UPX压缩的系统级瘦身优化方法。
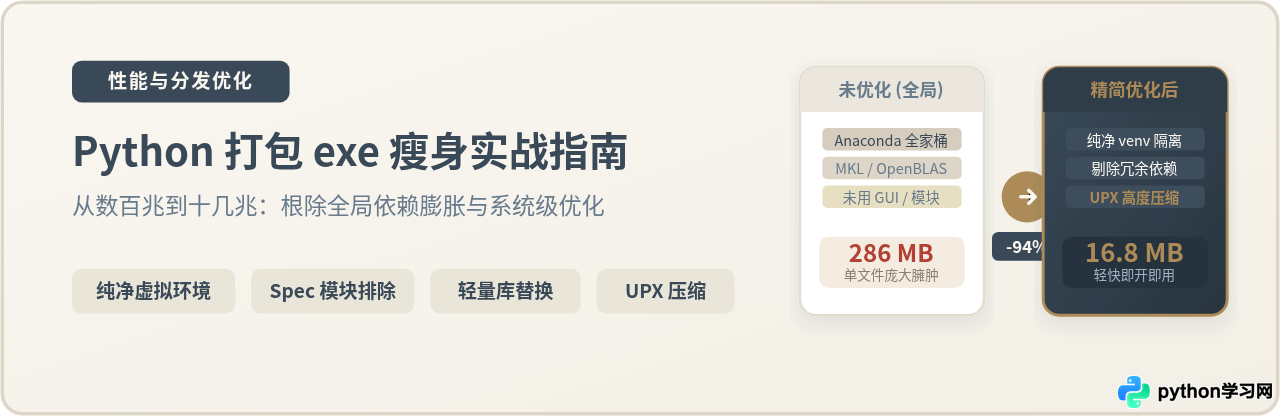
Python 脚本在打包成可执行文件(exe)后体积动辄飙升至数百兆,根本原因并非脚本代码量过大,而是打包工具在解析代码依赖时,将全局 Python 环境中连带的所有相关第三方模块、运行时解释器、底层动态链接库(DLL)及测试调试资产全量封装进了产物中。减小文件大小的最直接路径,是建立专用的纯净虚拟环境从源头阻断无关依赖,配合在 Spec 配置中精细排除冗余组件、替换过重第三方依赖,并在必要时结合 UPX 压缩与编译型工具进行多级瘦身。
一、为什么几十行的代码,打包后会有数百兆?
初次使用 PyInstaller 等工具打包 Python 程序的开发者,常会遇到一个普遍现象:一个只包含几十行网络请求或数据处理逻辑的脚本,生成出来的单文件 .exe 经常达到 150MB 甚至超过 300MB。要彻底解决体积膨胀,首先需要理解打包工具的内在工作原理。
Python 是一门动态解释型语言,原生并不具备直接将代码编译为机器指令可执行文件的机制。PyInstaller 在打包时,实际上执行了以下三项核心工作:
- 内嵌 Python 解释器与标准库:将 Python 的动态链接库(如
python3x.dll)、标准库字节码以及基础支持文件打包进去,这部分属于固定开销,体积通常在 10MB 至 18MB 左右。 - 递归遍历并收集依赖树:PyInstaller 会通过抽象语法树(AST)静态分析脚本中的所有
import语句。一旦检测到某个模块,它会连带将该模块所声明的所有深层依赖、C 语言扩展文件(.pyd)以及附带的运行时支持库(如 MKL、OpenBLAS、Qt 资源库)一并复制进打包目录。 - 单文件自解压封包(--onefile):在指定单文件参数后,PyInstaller 会将上述所有解释器文件、依赖包和资源压缩并包裹在一个自解压的可执行文件壳中。当用户在操作系统中双击运行该 exe 时,程序会在系统临时目录(如 Windows 下的
%TEMP%/_MEIxxxxxx)中解包并启动解释器。
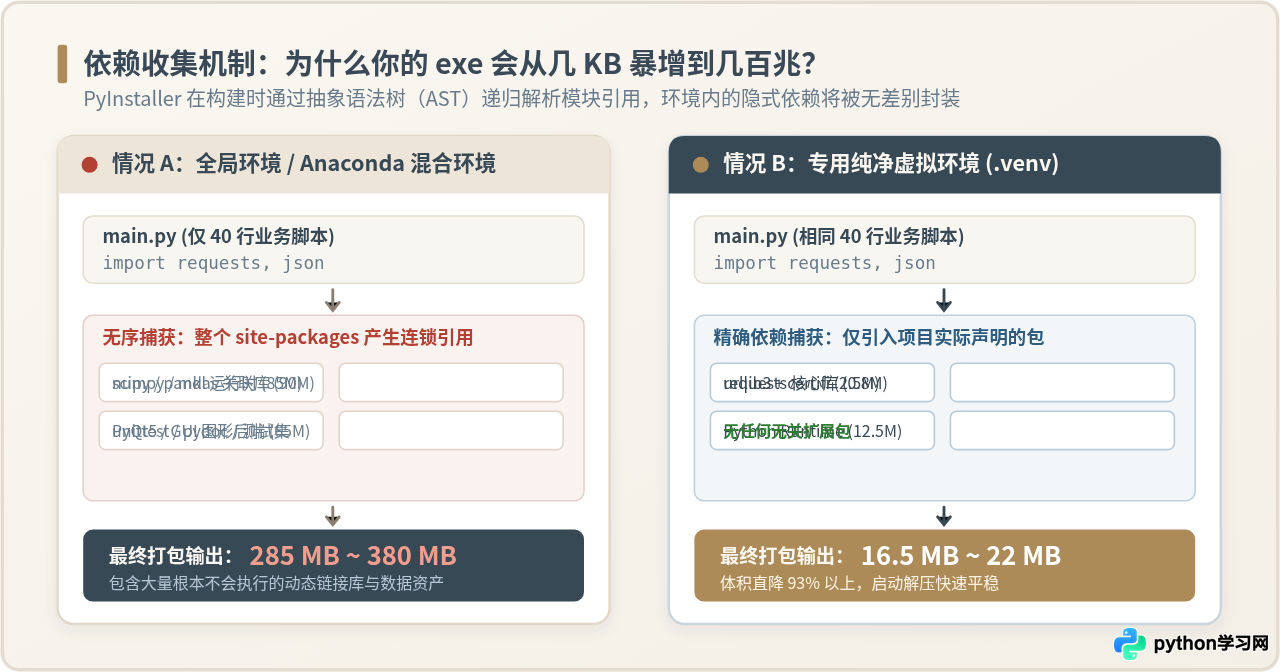
问题的关键在于运行环境的污染程度。如果开发者在系统的全局 Python 环境或者 Anaconda 的 base 环境中直接执行打包,环境中可能已预装了大量复杂的科学计算库(如 NumPy、SciPy、Pandas、Matplotlib)和图形界面框架(如 PyQt5、Tkinter)。即使你的业务代码只用到了 requests,某些基础模块内部弱引用的连带导入也会触发连锁反应,导致打包工具把整套庞大的计算栈与底层线性代数加速库全部打包入内。
二、首要优化:搭建干净独立的虚拟环境
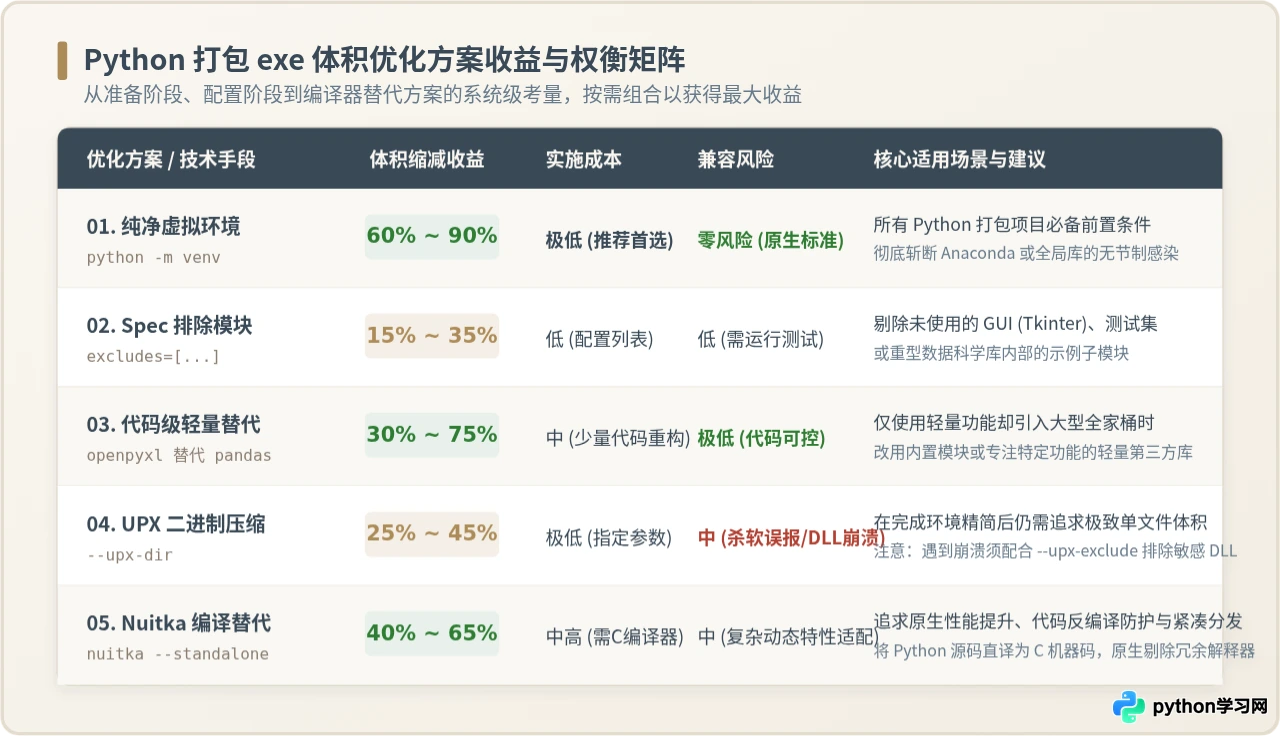
在所有瘦身手段中,建立纯净的虚拟环境是效果最显著、实施成本最低且零副作用的方法。绝大多数体积从 300MB 降至 20MB 以内的优化案例,超过 80% 的体积缩减都来自这一步。
虚拟环境能够让当前项目的依赖集合与操作系统的全局环境彻底隔离。在一个全新的虚拟环境中,只安装当前脚本所必须依赖的库和打包工具,能够从物理上斩断任何多余模块被意外捞取的可能。
实施步骤与命令指南
推荐直接使用 Python 自带的标准库模块 venv,避免引入额外的环境管理工具:
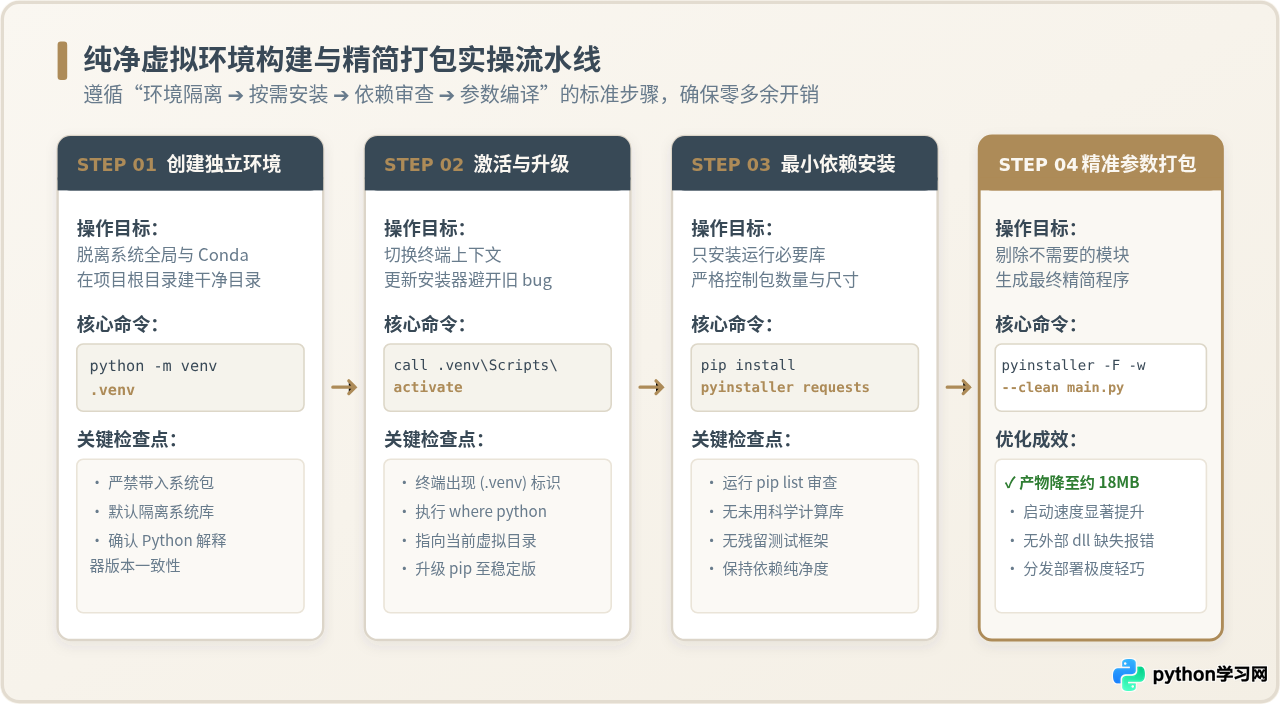
第一步:在项目根目录创建纯净虚拟环境
# 进入项目所在文件夹
cd /path/to/my_project

# 使用系统 Python 创建名为 .venv 的独立虚拟环境
python -m venv .venv
第二步:激活虚拟环境并升级基础工具
# Windows 系统(CMD / PowerShell)
.venv\Scripts\activate

# macOS / Linux 系统
source .venv/bin/activate

# 确认当前环境已切换:命令行前缀应带有 (.venv)
python -m pip install --upgrade pip
第三步:仅安装当前业务脚本需要的依赖与打包工具
以一个仅需要网络请求与 JSON 格式处理的脚本为例,严格按需安装对应包:
# 仅安装必要模块与 PyInstaller
pip install requests pyinstaller
第四步:执行依赖审查,确认没有无关包潜入
在打包前,务必运行 pip list 检查当前虚拟环境中的已装依赖:
pip list

# 示例输出(标准纯净状态):
# Package            Version
# ------------------ ---------
# certifi            2024.7.4
# charset-normalizer 3.3.2
# idna               3.7
# pip                24.2
# pyinstaller        6.10.0
# requests           2.32.3
# urllib3            2.2.2
在确认环境中仅存在目标库及其最小直接依赖后,再执行常规打包:
pyinstaller -F -w main.py仅通过此项改进,以往因混用 Anaconda 基础环境而生成的 280MB 文件,通常可以直接缩减至 15MB ~ 25MB。
三、精细化控制:利用 Spec 文件精准排除冗余组件
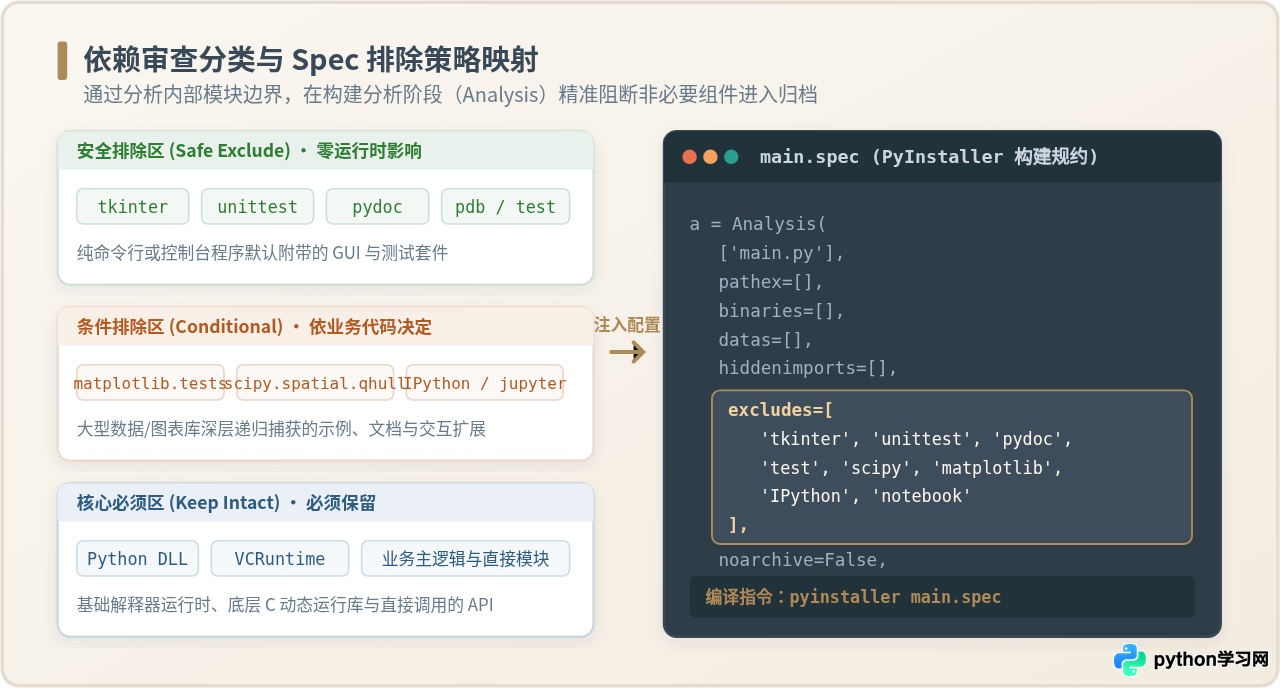
即使在干净的虚拟环境中,部分基础库为了兼顾多平台和可选功能,也会默认引入某些开发者并不需要的模块。例如:
- Python 标准库自带的图形界面模块
tkinter:如果你的程序是一个纯后台脚本或控制台工具,它完全没有被打包的必要。 - 单元测试框架与文档模块:
unittest、pydoc、pdb等开发调试组件往往会被某些库的内部钩子捕获。 - 大型科学计算库中的示例与测试子模块:例如
numpy.core._multiarray_tests或scipy.spatial.qhull。
1. 命令行参数排除方式
在执行 pyinstaller 命令时,可以通过多次指定 --exclude-module(或简写为 --exclude)参数来显式剔除特定模块:
pyinstaller -F -w --exclude-module tkinter --exclude-module unittest --exclude-module pydoc main.py2. 编写与维护 .spec 配置文件(推荐)
对于需要长期维护或依赖较复杂的项目,推荐通过编辑 .spec 规格文件来进行精细化管理。首先生成初始 spec 文件:
# 生成 spec 文件而不进行实际构建
pyi-makespec -F -w main.py
打开生成的 main.spec,在 Analysis 配置对象的 excludes 列表中填入需要排除的模块名称:
# -*- mode: python ; coding: utf-8 -*-

block_cipher = None

a = Analysis(
    ['main.py'],
    pathex=[],
    binaries=[],
    datas=[],
    hiddenimports=[],
    hookspath=[],
    hooksconfig={},
    runtime_hooks=[],
    excludes=[
        'tkinter',      # 排除不需要的默认 GUI
        'unittest',     # 排除单元测试框架
        'pydoc',        # 排除文档生成器
        'pdb',          # 排除调试器
        'test',         # 排除内置测试套件
        'multiprocessing', # 若未使用多进程可安全排除
        'IPython',      # 排除交互式外壳
    ],
    win_no_prefer_redirects=False,
    win_private_assemblies=False,
    cipher=block_cipher,
    noarchive=False,
)

pyz = PYZ(a.pure, a.zipped_data, cipher=block_cipher)

exe = EXE(
    pyz,
    a.scripts,
    a.binaries,
    a.zipfiles,
    a.datas,
    [],
    name='main',
    debug=False,
    bootloader_ignore_signals=False,
    strip=False,
    upx=True,
    console=False,
)
配置完成后,直接通过 spec 文件启动构建:
pyinstaller main.specModuleNotFoundError。因此每次修改 excludes 后,务必在无 Python 环境的裸机或虚拟机中进行全路径功能测试。
四、代码级改造:用轻量库替代“巨无霸”依赖
打包后体积居高不下的另一个根源,常常隐蔽在业务代码的架构选型中。许多开发者在实现简单功能时,习惯性随手引入日常数据分析使用的大型全家桶,这直接决定了打包产物的体积下限。
典型场景对比与轻量替代方案
| 业务需求场景 | 习惯性引入的大型依赖 | 推荐的轻量替代方案 | 打包体积收益 |
|---|---|---|---|
| 读写 Excel / 表格文件 | pandas (连带引入 numpy, pytz, dateutil, openpyxl) |
仅引入 openpyxl 或内置的 csv 模块 |
减少约 70MB ~ 110MB |
| 简单 HTTP 接口请求 | requests (连带引入 urllib3, certifi, charset-normalizer, idna) |
标准库 urllib.request (零额外依赖) |
减少约 8MB ~ 15MB |
| 简单二维图表绘制 | matplotlib (连带引入 PIL, kiwisolver, fonttools, numpy) |
轻量图表库或输出 SVG / HTML 报表 | 减少约 80MB ~ 140MB |
| 轻量配置与文本解析 | PyYAML |
标准库 json 或 configparser |
减少约 3MB ~ 6MB |
以读写 Excel 文件为例,如果在脚本中仅仅是为了读取几列单元格数据,直接导入 Pandas 会付出巨大的体积代价:
# 重度依赖写法(打包后增加近 100MB 运行时)
import pandas as pd

def read_data(filepath):
    df = pd.read_excel(filepath)
    return df.to_dict(orient="records")

# 轻量化改造写法(仅引入单一专用库,无底层 C 扩展加速包开销)
from openpyxl import load_workbook

def read_data_optimized(filepath):
    wb = load_workbook(filename=filepath, read_only=True)
    sheet = wb.active
    rows = list(sheet.iter_rows(values_only=True))
    headers = rows[0]
    return [dict(zip(headers, row)) for row in rows[1:]]
在项目构思与编码阶段,充分利用 Python 强大的标准库(如 sqlite3、urllib、csv、dataclasses),尽量避免为了极小的一两个辅助函数而导入具有庞大底层 C 绑定的巨型库。
五、进阶压缩与替代工具:UPX 与 Nuitka
当虚拟环境已经保持纯净、冗余模块与依赖也已精简完毕后,如果还需要进一步缩减可执行文件尺寸,可以引入可执行文件压缩技术或编译器级替代方案。
1. 使用 UPX 对二进制文件进行深度压缩
UPX(Ultimate Packer for eXecutables) 是一款成熟的高性能可执行文件压缩器。它能够对 exe 内部封包的 .exe、.dll 以及 .pyd 二进制文件进行就地压缩。当程序执行时,UPX 引导头会在内存中自动完成解压并执行,磁盘文件体积通常能进一步下降 25% ~ 45%。
使用方法:
- 前往 UPX 官方发布页面下载对应操作系统的压缩包(例如 Windows 64 位的
upx-x.xx-win64.zip)。 - 解压获取
upx.exe,将其放置在独立工具目录中(例如C:/tools/upx/upx.exe)。 - 在 PyInstaller 打包命令中通过
--upx-dir指定工具路径:
pyinstaller -F -w --upx-dir "C:/tools/upx" main.py1. 杀毒软件误报:许多主流杀毒软件(特别是 Windows Defender)对使用了 UPX 加壳的可执行文件较为敏感,可能会将其启发式特征标记为未知风险或木马。
2. 64 位 DLL 兼容性崩溃:某些由特定 C++ 编译器生成的 64 位 DLL(例如部分 Qt 运行时或早期的 VCRuntime)在被 UPX 压缩后可能会出现启动内存访问违规。如果遇到程序闪退,可在 spec 文件中通过
upx_exclude=['vcruntime140.dll', 'qwindows.dll'] 进行个别排除。
2. 打包架构取舍:单文件模式(-F)与单目录模式(-D)
许多开发者执着于 -F(单文件模式),认为单文件在分发时更美观。但从体积和实际运行体验的角度来看,-D(单目录模式)往往更为稳妥:
- 启动延迟差异:单文件模式在每次运行启动时,都必须把数百兆压缩内容解压到系统的 Temp 目录,导致程序出现几秒至十几秒的“白屏”假死感;而目录模式直接读取本地 dll,秒级冷启动。
- 分发体积优化:单目录输出的结果是一个包含 exe 和依赖文件夹的结构。开发者可以使用专业的安装包制作工具(如 Inno Setup、NSIS)或标准的 7-Zip 进行二次高比率压缩打包。由于专业压缩软件采用了 LZMA2 固实压缩算法,整体安装包的分发体积往往显著小于单个 PyInstaller 封包。
3. 编译器级替代方案:Nuitka
如果需要从根本上摆脱“把整个 Python 解释器塞进 exe”的运行模型,Nuitka 是一个极为优秀的编译器替代工具。
与 PyInstaller 仅仅把代码和解释器打包不同,Nuitka 会直接将 Python 代码翻译转换为 C/C++ 源代码,并调用系统安装的 C 编译器(如 GCC、Clang 或 MSVC)将其编译为原生机器码二进制。
# 安装 Nuitka
pip install nuitka

# 使用 Nuitka 进行独立程序构建
nuitka --standalone --onefile --enable-plugin=upx --output-dir=build_out main.py
Nuitka 的主要优势:代码完全转化为 C 语言编译,摆脱了解释层反编译泄露源码的风险;依赖解析更加细致,只编译真正被调用的 C 模块,生成的最终文件体积通常更为紧凑,同时在纯计算密集型场景下还能获得一定的性能加速。
六、排查常见问题与最佳实践总结
1. 排除模块后提示 ModuleNotFoundError 的解决流程
如果过度使用 excludes 导致运行时报错,可以按照以下逻辑快速修复:
- 首先改用命令行模式(移除
-w或在 spec 中将console=True),运行生成的 exe 以便查看控制台输出的完整 Traceback。 - 定位缺失模块的具体名称。如果该模块属于某大库内部的动态加载分支(非直接 import),在打包参数中显式添加
--hidden-import <模块名>,或者在 spec 文件的hiddenimports列表中补齐。 - 重新构建并测试,直到所有功能分支均能平稳执行。
2. 优化方案执行优先级建议
为了在最短时间内获得最大的体积优化收益,建议遵循以下标准执行顺序:
- 必做项(第一优先级):新建并激活纯净的
python -m venv虚拟环境,只安装业务必须的包。此项即可解决 80% 以上的体积问题。 - 审查项(第二优先级):检查业务代码,排查是否无意中引入了
pandas、scipy、matplotlib等重量级库,评估使用轻量专用库替代的可行性。 - 精细项(第三优先级):导出
.spec文件,将确认未使用的tkinter、测试套件及冗余工具加入excludes列表。 - 进阶项(第四优先级):在完成功能验证与依赖裁剪后,若对体积仍有极致要求,再引入 UPX 或改用单目录+专业安装包分发方案。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















