


Python人工智能实战:100个经典案例的代码结构与逻辑解析
深入解析Python人工智能100个经典实战案例的代码骨架与逻辑流转,涵盖传统机器学习与深度学习通用架构、张量维度控制、训练状态流转及常见避坑实践。
一、AI实战案例的核心骨架:五层通用工程分层
查阅上百个真实 AI 项目的代码仓库可以发现,结构优良的代码往往不会将所有逻辑堆砌在单个脚本或单个函数中。无论是 Scikit-Learn 支撑的表格类预测,还是基于 PyTorch 实现的深度神经网络,均遵循明确的职责隔离原则。典型的实战项目通常被解耦为五个标准层次:
- 数据接入层(Data Ingestion):负责底层文件的 I/O 操作、原始格式转换以及异常字段过滤,对外输出整洁的原始结构。
- 特征与流水线层(Feature & Pipeline):实施标准化缩放、独热编码、图像几何变换或文本分词,并将连续数据封装为批次加载器(DataLoader)。
- 模型拓扑定义层(Model Definition):使用继承自
nn.Module或自定义 Estimator 的类,声明网络权重、注意力机制或树结构拓扑,并在前向计算中定义张量流动。 - 优化与评估层(Optimization & Evaluation):构建损失函数(Loss)、设定优化算法(Optimizer),并在循环迭代中推进反向传播求导与验证指标计算。
- 推理与持久化层(Serving & Persistence):对训练收敛的模型参数实施权重导出(如
.pt、.onnx),并封装着标准输入预处理与结果后处理的推理接口。
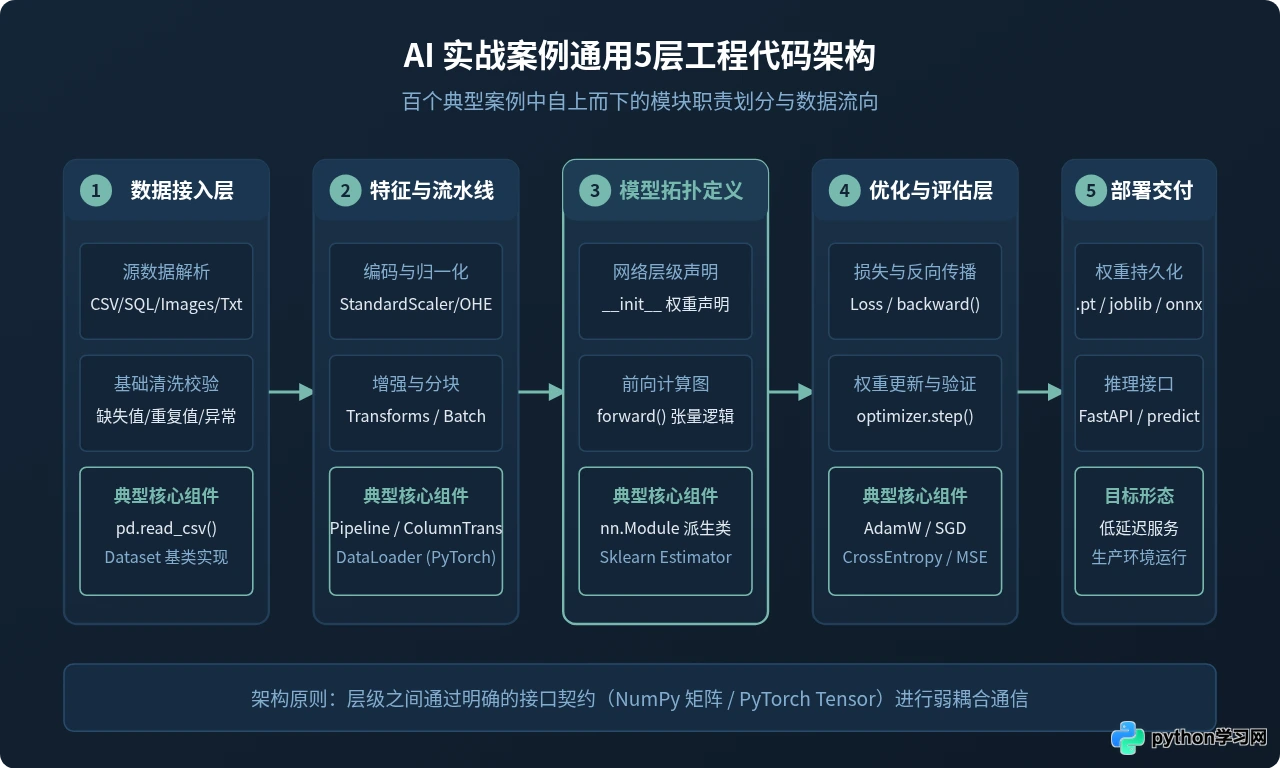
在很多初学者编写的项目中,特征转换与模型训练经常交叉调用,导致测试集评估时发生“数据泄露”(Data Leakage)。在标准架构中,第二层与第三层之间严格以规范化的张量或矩阵作为数据契约,各层模块能够独立进行单元测试与逻辑替换,这也是 100 个案例能够高效复用的根本原因。
二、核心逻辑拆解:机器学习与深度学习的双范式对比
在 100 个实战案例中,技术实现通常分为两大家族:以 Scikit-Learn、LightGBM 为代表的传统机器学习工程范式,以及以 PyTorch 为代表的深度学习动态计算图范式。理解这两种范式的骨架差异,是阅读和编写实战代码的关键。
1. 传统机器学习范式:高内聚的 Pipeline 模式
在预测房价、客户流失、违约风控等案例中,数据多为结构化表格。代码的核心逻辑是基于统一的 fit() 与 transform() 接口将预处理与算法串联:
# 传统机器学习典型工程结构示例
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.compose import ColumnTransformer
from sklearn.pipeline import Pipeline
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report

# 1. 数据接入与划分
data = pd.DataFrame({
    'age': [25, 45, 35, 50, 23],
    'city': ['Beijing', 'Shanghai', 'Shenzhen', 'Beijing', 'Guangzhou'],
    'target': [0, 1, 0, 1, 0]
})
X = data[['age', 'city']]
y = data['target']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 2. 特征工程流水线与模型串联
preprocessor = ColumnTransformer(
    transformers=[
        ('num', StandardScaler(), ['age']),
        ('cat', OneHotEncoder(handle_unknown='ignore'), ['city'])
    ]
)

pipeline = Pipeline(steps=[
    ('preprocessor', preprocessor),
    ('classifier', RandomForestClassifier(n_estimators=100, random_state=42))
])

# 3. 拟合与评估
pipeline.fit(X_train, y_train)
y_pred = pipeline.predict(X_test)
print("评估结果:
", classification_report(y_test, y_pred, zero_division=0))
2. 深度学习范式:显式的训练控制流
在图像检测、文本生成、时间序列建模等进阶案例中,由于需要进行细粒度的显存管理与梯度控制,代码逻辑转向显式循环。标准深度学习工程会明确拆解为 Dataset 数据封装、nn.Module 模型定义与包含 backward() 的训练引擎。
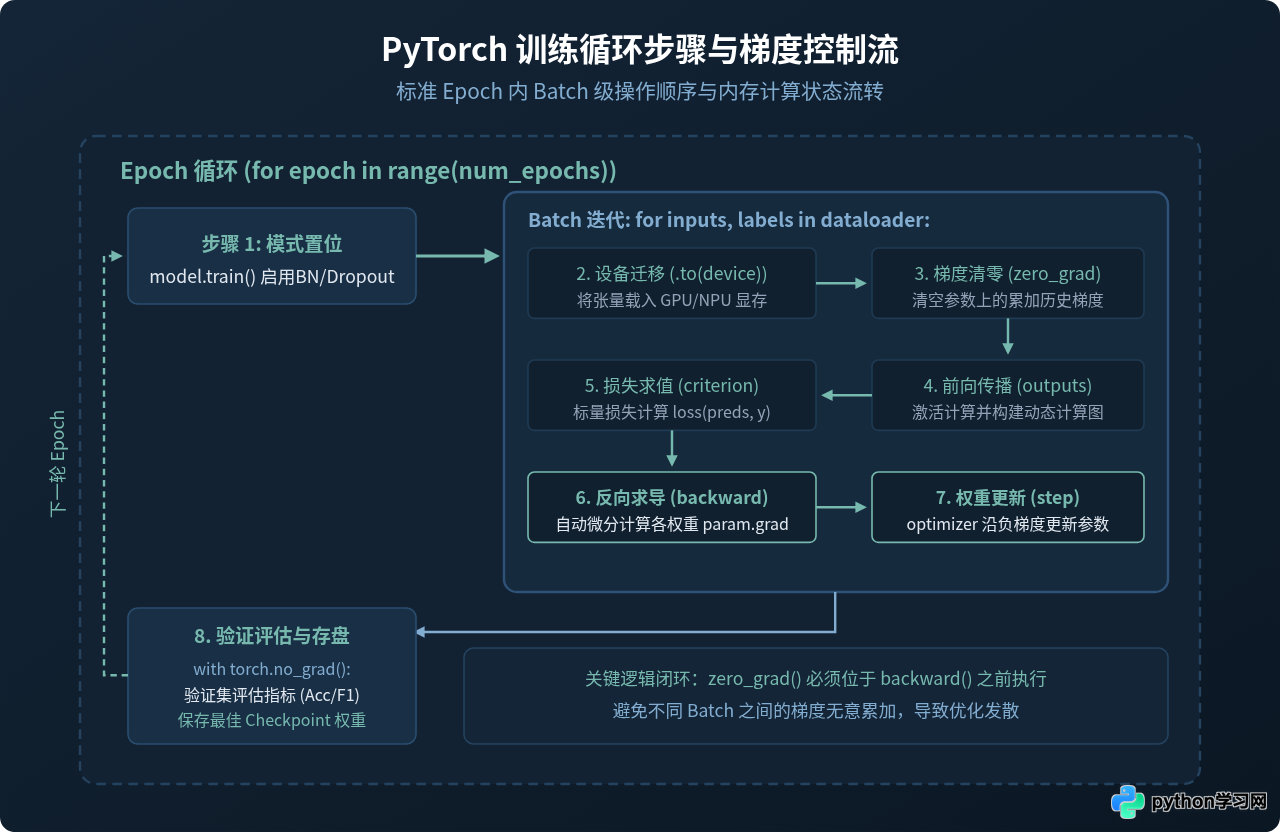
以下代码展示了深度学习案例中最经典的控制闭环。注意其严格的执行顺序:每次反向求导前必须调用 zero_grad(),否则历史累加的梯度会导致权重更新方向紊乱:
# 深度学习标准训练循环代码范式
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader, TensorDataset

# 1. 模拟数据集与 DataLoader 封装
features = torch.randn(100, 10)
labels = torch.randint(0, 2, (100,))
dataset = TensorDataset(features, labels)
train_loader = DataLoader(dataset, batch_size=16, shuffle=True)

# 2. 模型拓扑结构定义
class SimpleMLP(nn.Module):
    def __init__(self, input_dim, hidden_dim, output_dim):
        super(SimpleMLP, self).__init__()
        self.fc1 = nn.Linear(input_dim, hidden_dim)
        self.relu = nn.ReLU()
        self.fc2 = nn.Linear(hidden_dim, output_dim)

    def forward(self, x):
        x = self.relu(self.fc1(x))
        return self.fc2(x)

device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
model = SimpleMLP(input_dim=10, hidden_dim=32, output_dim=2).to(device)
criterion = nn.CrossEntropyLoss()
optimizer = optim.AdamW(model.parameters(), lr=1e-3)

# 3. 核心训练迭代
for epoch in range(5):
    model.train()  # 必须步骤:开启训练状态(激活 Dropout 与 BatchNorm)
    running_loss = 0.0
    for batch_x, batch_y in train_loader:
        batch_x, batch_y = batch_x.to(device), batch_y.to(device)

        # 梯度清零 -> 前向计算 -> 损失计算 -> 反向传播 -> 参数更新
        optimizer.zero_grad()
        outputs = model(batch_x)
        loss = criterion(outputs, batch_y)
        loss.backward()
        optimizer.step()

        running_loss += loss.item() * batch_x.size(0)

    epoch_loss = running_loss / len(train_loader.dataset)
    print(f"Epoch [{epoch+1}/5], Loss: {epoch_loss:.4f}")
三、深层逻辑剖析:张量维度变换与运行时状态机
阅读中复杂案例(如目标检测 YOLO、语义分割 U-Net、注意力机制 Transformer)时,最常遇到的障碍是矩阵维度的连续变换以及模型状态的混淆。掌握以下两项底层逻辑,可以快速厘清任何开源案例:
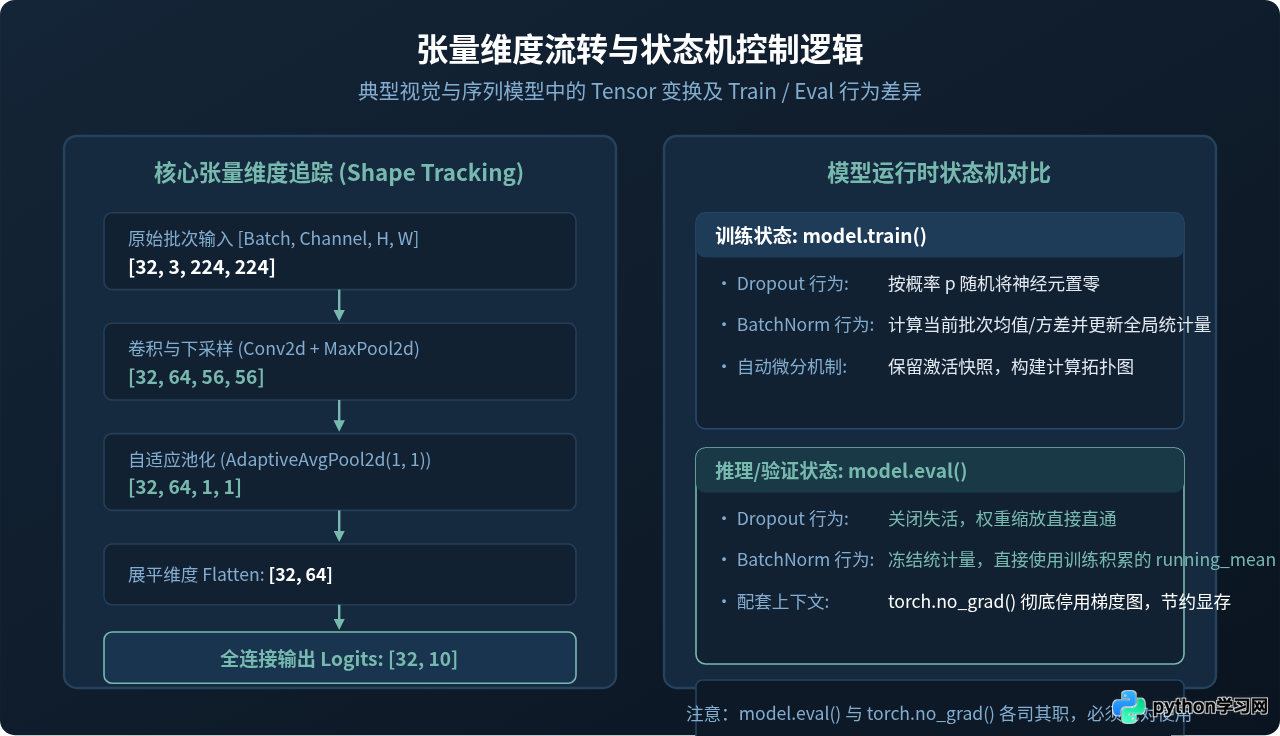
1. 张量维度追踪(Shape Alignment)
神经网络计算本质上是一系列高维矩阵乘法与投影。在视觉模型中,张量通常以 [Batch, Channel, Height, Width] 形式流动;在 NLP 和时序模型中,则以 [Batch, Sequence_Length, Embedding_Dim] 形式组织。每一层网络对形状的约束可以通过下式判定:
线性变换全连接层 nn.Linear(in_features, out_features) 要求输入张量的最后一维必须精准等于 in_features。当经历卷积与池化操作后,空间分辨率缩减,代码中通常借助 torch.flatten(x, 1) 或 x.view(x.size(0), -1) 将多维张量展平为二维矩阵,方可输入分类头。
2. 运行时状态机的双重机制
在很多测试或评估脚本中,开发者容易忽略 model.train() 与 model.eval() 的切换。这两个方法并不直接控制计算图的梯度计算,而是改变特定神经元的操作行为:
- Dropout 层:在
train()模式下以概率 \(p\) 随机丢弃神经元输入以抑制过拟合;在eval()模式下全部导通,并将输出乘以对应保留比例。 - BatchNorm 层:在
train()模式下利用当前 Batch 均值方差归一化,并更新滑动平均;在eval()模式下冻结参数,直接使用累积的历史统计量。 - 梯度上下文
torch.no_grad():独立于模型模式,用于告知 Autograd 引擎不要分配显存记录计算拓扑,从而大幅减少验证期间的显存占用并加速推理。
四、100个案例调试经验:四大高频代码陷阱与排查清单
在解析 100 个案例的过程中,有四种经典错误在初学乃至进阶代码中频繁出现。掌握诊断路径能够大幅提升代码排查效率:
| 序号 | 典型问题现象 | 根本代码逻辑成因 | 正确修改方案 |
|---|---|---|---|
| 1 | 验证集得分异常虚高,部署后性能崩溃 | 数据泄露(Data Leakage)。在划分训练集与测试集之前对整体数据调用了 fit_transform()。 |
严格先执行 train_test_split,仅在训练集上 fit(),测试集只执行 transform()。 |
| 2 | 训练过程中 Loss 震荡不降或发散至 NaN | 学习率过高未配置学习率衰减,或发生梯度爆炸,除以了零方差。 | 引入 torch.nn.utils.clip_grad_norm_ 进行梯度裁剪,并添加极小常数 eps=1e-8。 |
| 3 | GPU 显存暴涨直至 CUDA Out of Memory | 在统计整轮损失时直接累加了张量:total_loss += loss,保留了整张计算图的显存。 |
必须使用 loss.item() 提取 Python 标量浮点数,脱离 Autograd 显存跟踪。 |
| 4 | 推理输出结果完全随机,每次测试输出不一致 | 评估时未设置 model.eval(),Dropout 层仍在随机丢弃特征。 |
进入推理与验证流程前显式调用 model.eval() 并配合 with torch.no_grad(): 上下文。 |
五、实战能力沉淀:100个案例的模块化复用路径
学习这 100 个经典案例的目的不是死记硬背每个模型的具体参数,而是建立模块化的代码仓库。当面对新的工程任务时,开发者只需调取成熟的骨架,替换其中的数据预处理模块与输入输出头即可。
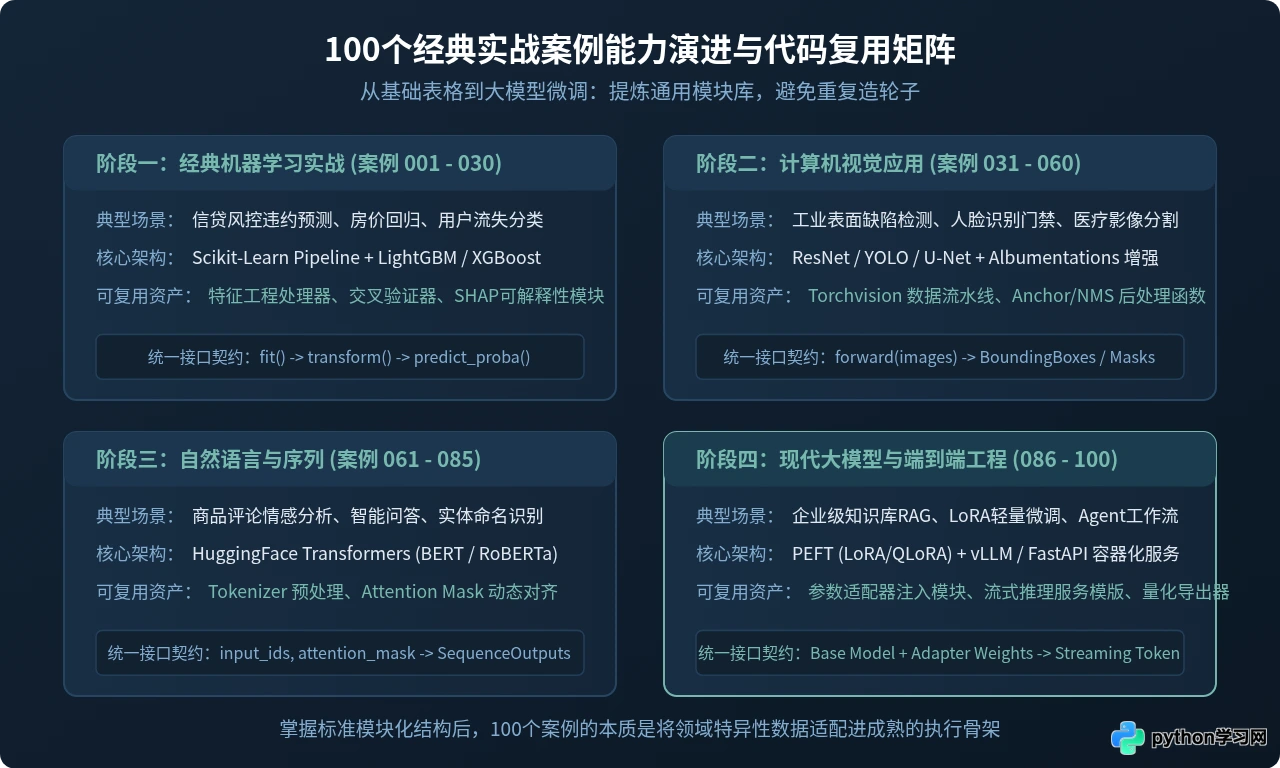
整个技术进阶遵循清晰的递进逻辑:从处理二维表格的特征工程模块,演进到处理二维网格图像的卷积模块,再到处理一维可变长序列的注意力与 Transformer 模块。每一步都在继承上一阶段工程规范的基础上,拓展特定领域的数据解析与后处理算法。
在组织个人或团队的 AI 代码资产时,建议将基础架构标准化为三大件:统一的 Config 配置模块(管理超参数与路径)、独立的 Engine 循环类(封装训练与验证步骤),以及插拔式的 Metrics 计算模块。这样在迁移案例时,能够最大限度保证代码整洁度与生产部署效率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















