


Python中tuple与list的区别及适用场景对比
深入对比Python中tuple(元组)与list(列表)的核心差异,从可变性原理、底层内存机制、运行性能到实际开发场景与选型决策,帮助开发者正确选择与高效使用序列类型。
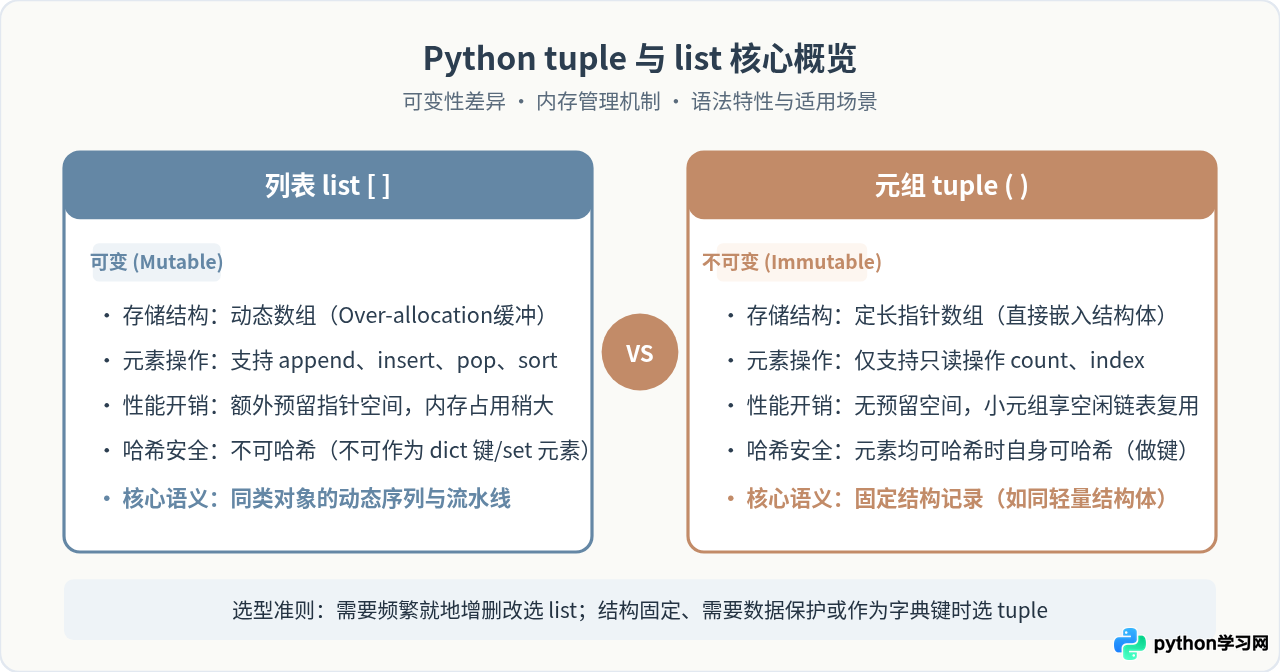
在 Python 中,元组(tuple)与列表(list)是最基础且最常用的两种内置序列结构。两者的根本差异在于可变性(Mutability)与设计语义(Semantics):列表是动态、可调整容量的异构数据集合,专为需要增删改的同类流水线设计;元组是静态、长度固定的不可变序列,用于表达固定字段结构、传递不可变参数及充当字典的哈希键。可变性的不同直接决定了两者在底层内存管理、运行性能以及安全边界上的显著分化。
一、底层数据模型与可变性机制
在 CPython 解释器实现中,list 和 tuple 都是基于数组存储对象引用的容器,存储的并非数据本体,而是指向 Python 对象的指针。然而,它们在内存生命周期和指针数组的维护策略上截然不同。
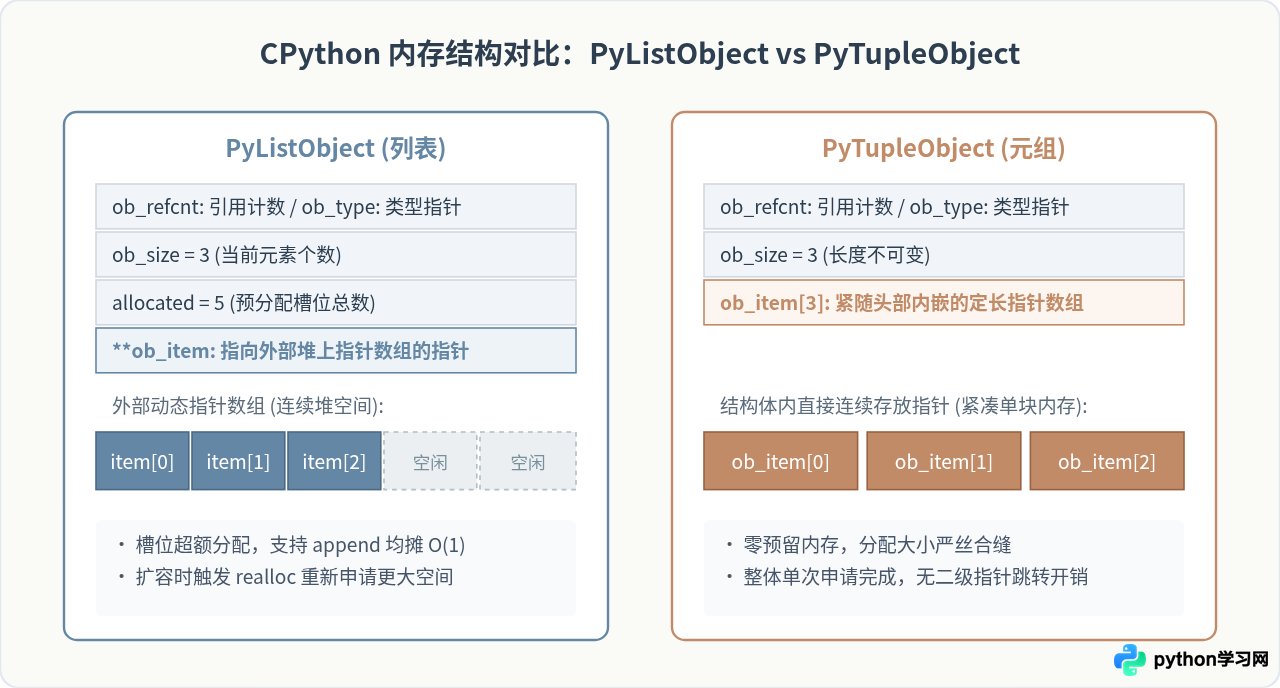
列表被实现为 PyListObject,其内部持有一个动态指针数组 ob_item 以及两个关键计数器:ob_size(当前已有元素个数)和 allocated(当前已分配的内存槽位总量)。为了确保通过 append() 向尾部追加元素达到均摊 O(1) 的时间复杂度,Python 采用了超额分配(Over-allocation)策略。当已分配空间不足时,会按比例开辟更大内存块并搬移指针。
元组被实现为 PyTupleObject,其大小在实例化时就已经固定。元组的指针数组直接内嵌在结构体末尾,内存块长度恰好容纳元素个数,完全不需要预留任何闲置槽位,生命周期内也不允许重新分配。
浅不可变性:元组引用的固定与被引用对象的变动
关于元组的不可变性,初学者最常产生误解的地方是包含复合对象时的行为。元组的“不可变”仅指元组本身持有的每个指针槽位(内存地址引用)不能被重新指向,但被指向的目标对象若自身是可变容器(如列表或字典),该对象内部的状态仍然可以被就地修改。
# 示例:元组内部元素的不可变与可变表现
t = (1, [10, 20], "apple")

# 1. 尝试修改元组的直接槽位(报错)
try:
    t[0] = 2
except TypeError as e:
    print(f"修改元组槽位失败: {e}")  # 示例输出: 'tuple' object does not support item assignment

# 2. 修改槽位指向的可变列表对象内部(成功)
t[1].append(30)
print(f"元组当前状态: {t}") # 示例输出: (1, [10, 20, 30], 'apple')避坑提示:在设计只读数据传输对象或字典键时,切勿向元组中放入列表等可变类型。只有当元组内每个层级的元素全部递归不可变时,整个元组才具备完全的数据安全性和可哈希性。
二、内存占用与执行效率差异
底层内存分配策略直接影响了运行时的内存足迹和对象创建速度。我们可以通过 Python 内置的 sys.getsizeof() 来直观测量同等元素数量下两者的内存消耗:
import sys

empty_list = []
empty_tuple = ()

list_data = [1, 2, 3, 4, 5]
tuple_data = (1, 2, 3, 4, 5)

print(f"空列表内存: {sys.getsizeof(empty_list)} 字节")   # 示例输出: 56 字节 (64位机器)
print(f"空元组内存: {sys.getsizeof(empty_tuple)} 字节")  # 示例输出: 40 字节
print(f"5元素列表: {sys.getsizeof(list_data)} 字节")    # 示例输出: 120 字节 (含动态冗余)
print(f"5元素元组: {sys.getsizeof(tuple_data)} 字节")   # 示例输出: 80 字节
在 64 位 CPython 环境中,包含 5 个整数引用的列表占用了 120 字节,而元组仅占用 80 字节,节约了整整三分之一的内存空间。若数据规模达到上百万条记录,两者的内存差异将极为明显。
小元组缓存池(free_list)与常量折叠
除了内存结构紧凑,CPython 还为 tuple 做了针对性的运行期优化:
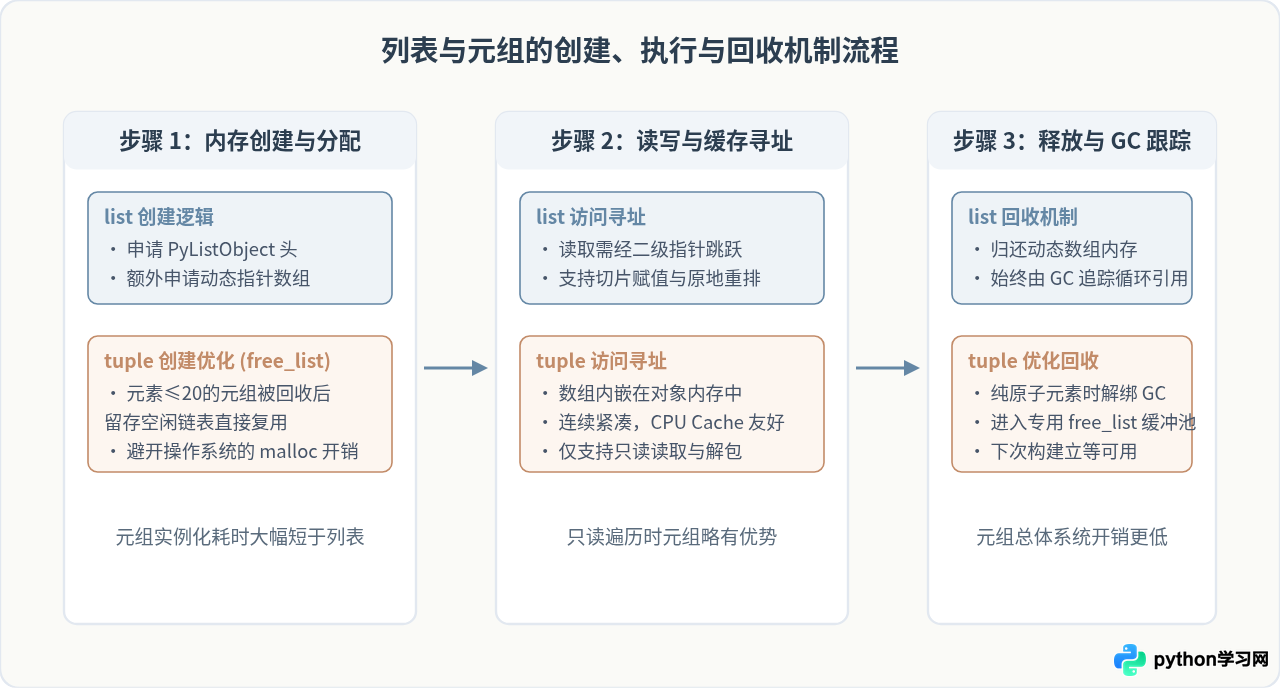
- 空闲列表复用机制:为了避免频繁向操作系统申请和归还微小内存,Python 为长度在 1 到 20 之间的元组维护了静态数组池
free_list。当一个元组生命周期结束时,其持有的内存块不会立即释放给操作系统,而是直接挂到该长度的空闲链表上。下一次创建相同大小的元组时,直接取出复用,节约系统调用耗时。 - 常量折叠(Constant Folding):在 Python 编译为字节码时,如果代码中出现由不可变字面量构成的元组(如
(1, 2, 3)),编译器会将其直接固化为常量表中的单个常量;而列表字面量[1, 2, 3]则必须在每次执行到该语句时通过BUILD_LIST指令动态构造。
三、语法特性与方法支持对比
由于可变性的根本对立,两者在内置方法和受支持的操作上有清晰的划分。列表作为动态容器拥有丰富的原地修改(In-place modification)方法,而元组仅保留只读查询能力。
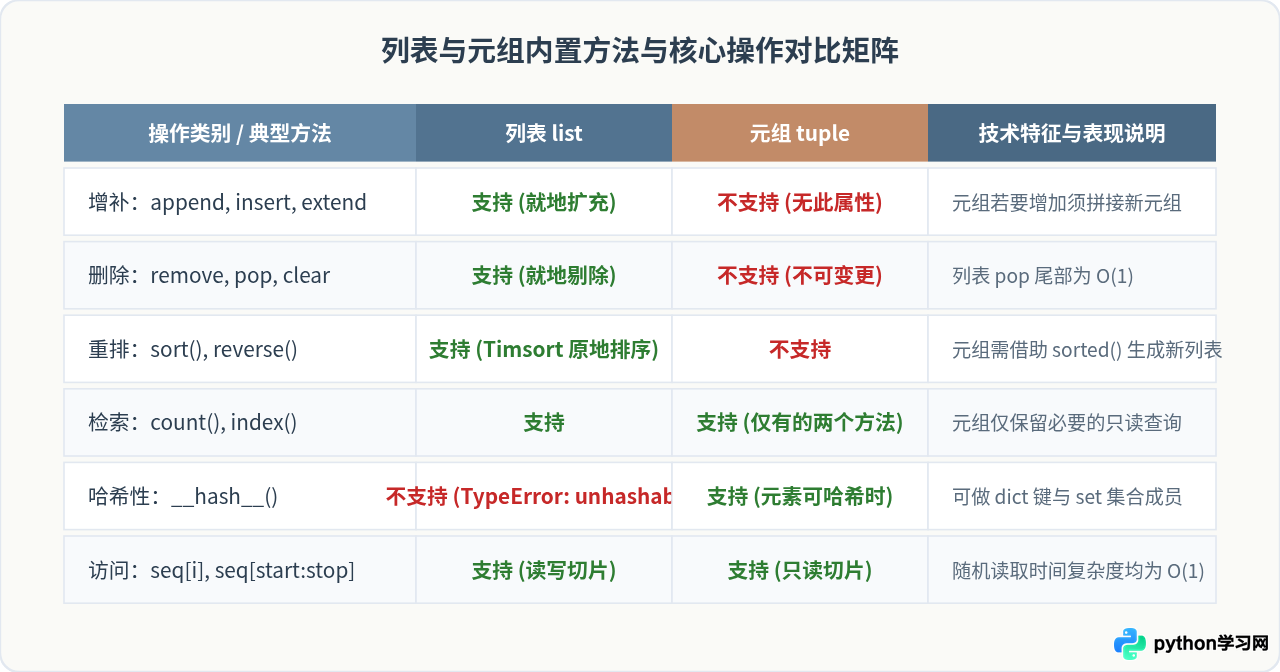
语法细节注意点
- 单元素元组的逗号约束:定义包含单个元素的元组时,圆括号本身仅代表运算优先级,必须紧跟一个英文逗号。例如
a = (42)会被解析为整数42,只有a = (42,)或a = 42,才是合法的单元素元组。 - 序列解包(Unpacking):两者都原生支持解包操作,但在表达固定字段时元组具有更好的直观语义。例如
x, y, *rest = (1, 2, 3, 4)或在循环中遍历字典的键值对for k, v in d.items():。 - 字典键(Dict Key)与集合(Set)成员:Python 的字典和集合依赖哈希表实现,键必须是可哈希(Hashable)对象。列表作为可变对象显式将
__hash__设为None,因此无法作为键;元组只要内部所有元素均可哈希,就可以安全作为多维坐标、复合键。
四、选型原则与典型开发场景对比
很多开发者在编码时习惯全盘使用列表,忽视了元组带来的安全性与性能收益。在工程实践中,选择使用 list 还是 tuple 应当遵循明确的语义与需求边界。
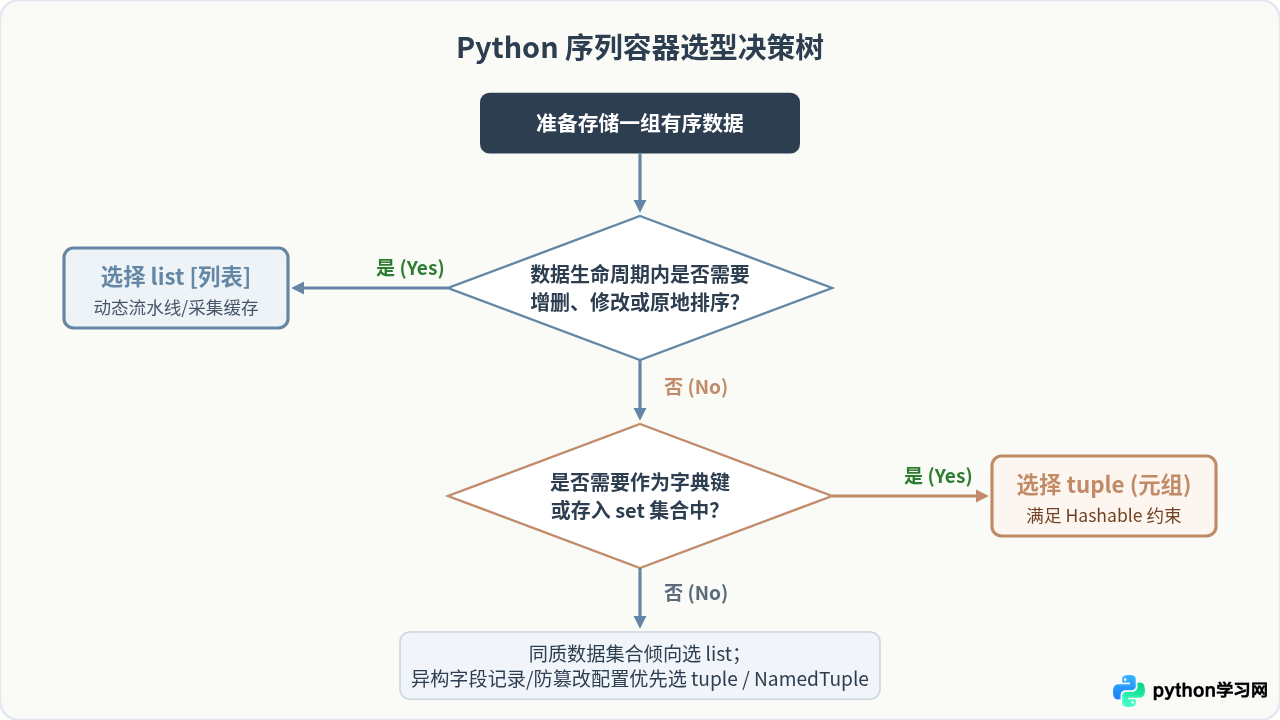
1. 适合使用 list 的典型场景
- 动态数据流与收集器:例如从数据库轮询拉取记录、遍历文件逐行追加内容、爬虫解析网页节点等,需要不断执行
append()或extend()的集合。 - 同构元素队列或堆栈:操作元素类型一致的数据,需要通过
pop()模拟先进后出(LIFO)栈,或者需要通过索引切片批量替换子段。 - 需要原地重排与清洗的数据:需要对数据执行
list.sort()就地排序以节约临时对象开销,或者通过list.reverse()原地反转。
2. 适合使用 tuple 的典型场景
- 多字段固定记录(Record):表示一个具有明确位置含义的不可变实体。例如二维坐标
point = (x, y)、RGB 颜色值color = (255, 128, 0)、数据库单行记录user = (1001, "Alice", "admin")。每个槽位代表不同的字段属性,位置是语义的关键部分。 - 函数的多返回值与解包:Python 函数使用
return a, b时,语法糖隐式打包为一个元组。由于返回值代表一个固定的处理结果,使用元组能够确保调用方不能恶意篡改函数产出的内部结构。 - 只读配置与常量组:例如全局系统配置
ALLOWED_EXTENSIONS = ('.jpg', '.png', '.webp'),使用元组传达“请勿在代码运行时修改该列表”的防卫性编程(Defensive Programming)契约。 - 复合字典键与去重集合:将空间坐标作为网格索引(如
grid[(x, y)] = cell),或者将多维筛选条件作为缓存装饰器的入参标识。
进阶延伸:当元组元素超过 3 个且位置难以记忆时,可考虑使用 Python 标准库中的 collections.namedtuple 或 typing.NamedTuple。它们保留了元组不可变性、低内存占用及可哈希特性的同时,赋予了每个字段可读性极强的属性访问方式(如 user.name),兼顾了性能与工程可维护性。
五、核心规则全景速查
为了帮助在实际编写与重构代码时迅速做出规范选择,以下汇总了元组与列表在各核心维度的对比结论:
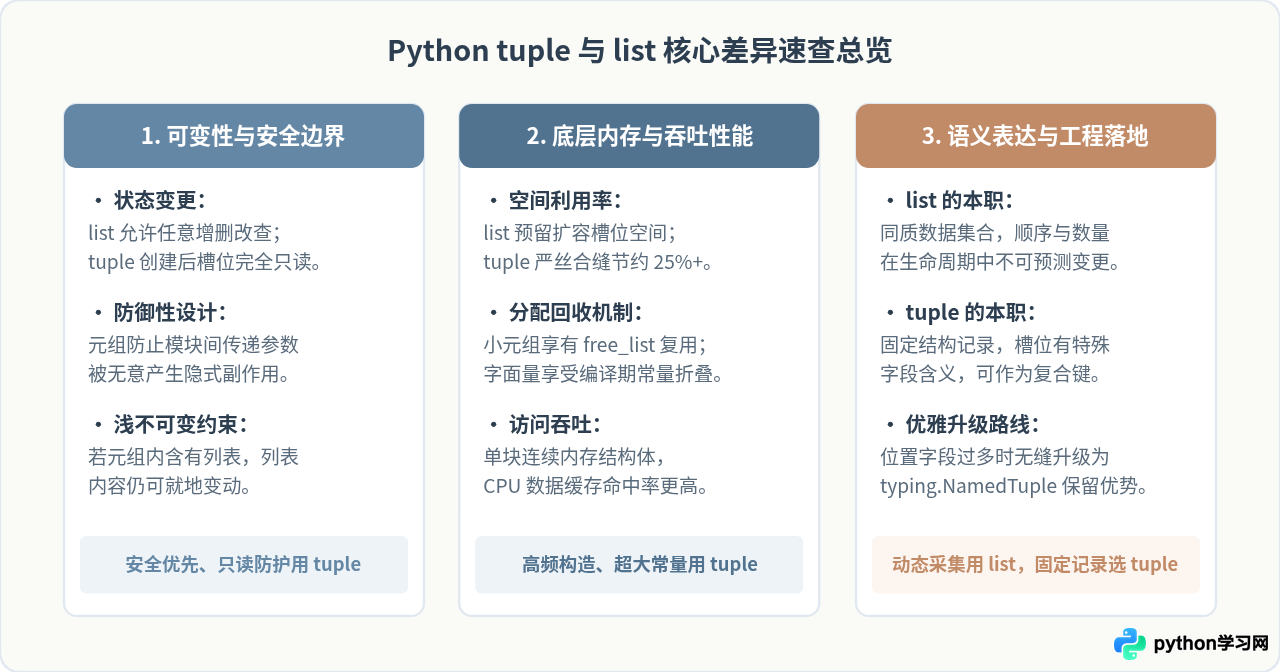
总结而言,在 Python 中不能简单把元组理解为“只读的列表”,而应理解为不可变的固定数据结构。遇到需要动态汇聚、过滤、排序的同类数据批处理时,果断采用 list;而在表达多字段记录、返回多维结果、设计字典哈希键或保护常量配置不受篡改时,坚决选用 tuple。掌握这一准则不仅能提升系统的内存与运行效能,更能让代码本身的意图表达更加纯粹、健壮。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















