


Python使用__slots__限制实例属性以节省内存
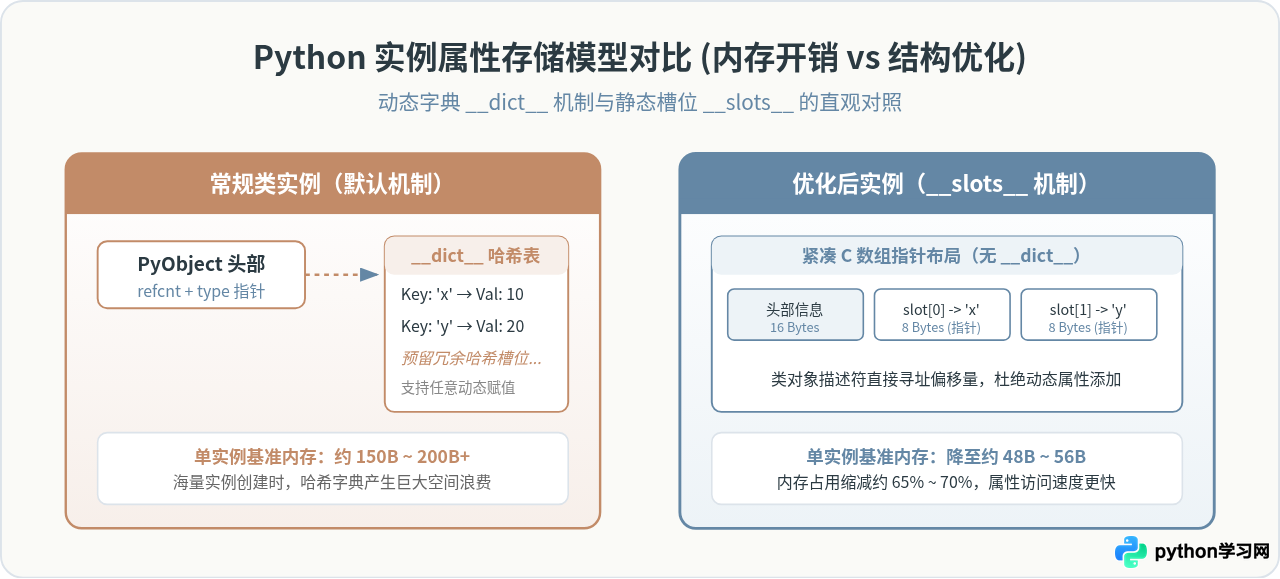
深入解析Python中__slots__的运行原理与内存优化机制。通过对比默认__dict__哈希表与紧凑槽位数组,展示如何限制实例属性、避免意外赋值,并在创建海量对象时实现60%以上的内存节省。
__dict__ 的字典用来动态存放实例属性。字典为了保证高效的哈希查找,内部维护了哈希桶与索引结构,单个实例的空字典就会产生上百字节的常驻内存开销。当程序需要实例化数万甚至数百万个轻量级对象(如几何坐标、网络数据包或行情数据)时,内存将迅速被这些分散的哈希字典吞噬。通过在类定义中显式声明 __slots__ 元组,Python 会用轻量级的数据描述符与紧凑 C 数组指针替代原本的 __dict__,既严格限制了实例只能绑定白名单内的属性,又能使单个实例的内存消耗下降约 60% 至 70%。
一、为什么默认实例会消耗大量内存
Python 作为一门动态语言,允许我们在对象创建后随意为其实例附加新属性,例如 obj.new_attr = 100。这种高度灵活性的底层支撑正是 __dict__ 字典。
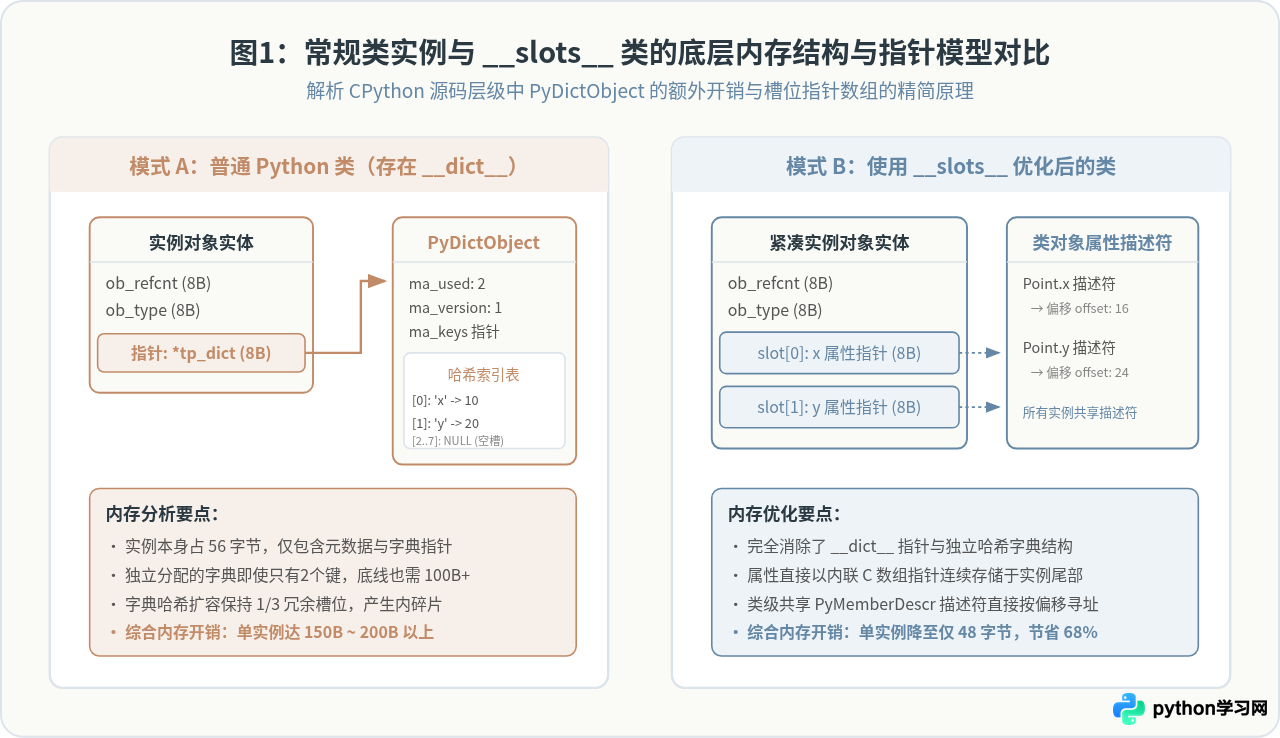
在 CPython 的底层实现中,普通类的实例对象本身其实非常轻量,它主要由对象头结构 PyObject_HEAD(包含引用计数 ob_refcnt 与类型指针 ob_type)以及一个指向该实例专属字典的指针 tp_dict 构成。然而,真正的大头内存开销隐藏在被引用的 PyDictObject 中。
哈希表为了降低哈希碰撞概率,通常保持着较为稀疏的负载因子,即便一个字典只存入两个键值对,CPython 也必须为其分配基础键表、哈希索引数组以及哈希条目空间。此外,每个属性名字符串还要作为键参与哈希计算。这种设计对于只创建少量对象的业务逻辑而言无关痛痒,但在批量数据处理、科学计算或高并发网络服务中,创建 100 万个简单对象就会产生数以百兆计的冗余字典结构。
为了直观证明这一点,我们可以通过标准库 sys.getsizeof() 观察普通实例及其字典的真实占用。需要注意的是,sys.getsizeof(obj) 默认只计算实例顶层容器本身的字节数,并不递归计算其属性字典的内容:
import sys

class NormalPoint:
    def __init__(self, x, y):
        self.x = x
        self.y = y

p = NormalPoint(10, 20)

print(f"实例对象浅层大小: {sys.getsizeof(p)} 字节")
print(f"实例 __dict__ 大小: {sys.getsizeof(p.__dict__)} 字节")
print(f"单实例基础内存总计: {sys.getsizeof(p) + sys.getsizeof(p.__dict__)} 字节")实例 __dict__ 大小: 104 字节
单实例基础内存总计: 152 字节
可以看到,仅仅存放 x 和 y 两个字段,普通实例及其专属字典就消耗了超过 150 字节的内存。如果存在 100 万个这样的点,单纯存储实例与字典骨架就需要约 150MB 内存,这还不包含属性值本身所占用的空间。
二、__slots__ 的声明方法与基本使用步骤
要解决海量同构实例的内存开销,标准做法是在类主体中显式定义 __slots__ 类属性。__slots__ 是一个由字符串构成的可迭代对象,用于声明该类实例允许拥有的全部属性名称。
一旦类中定义了 __slots__,CPython 的类构建机制就会发生本质改变:
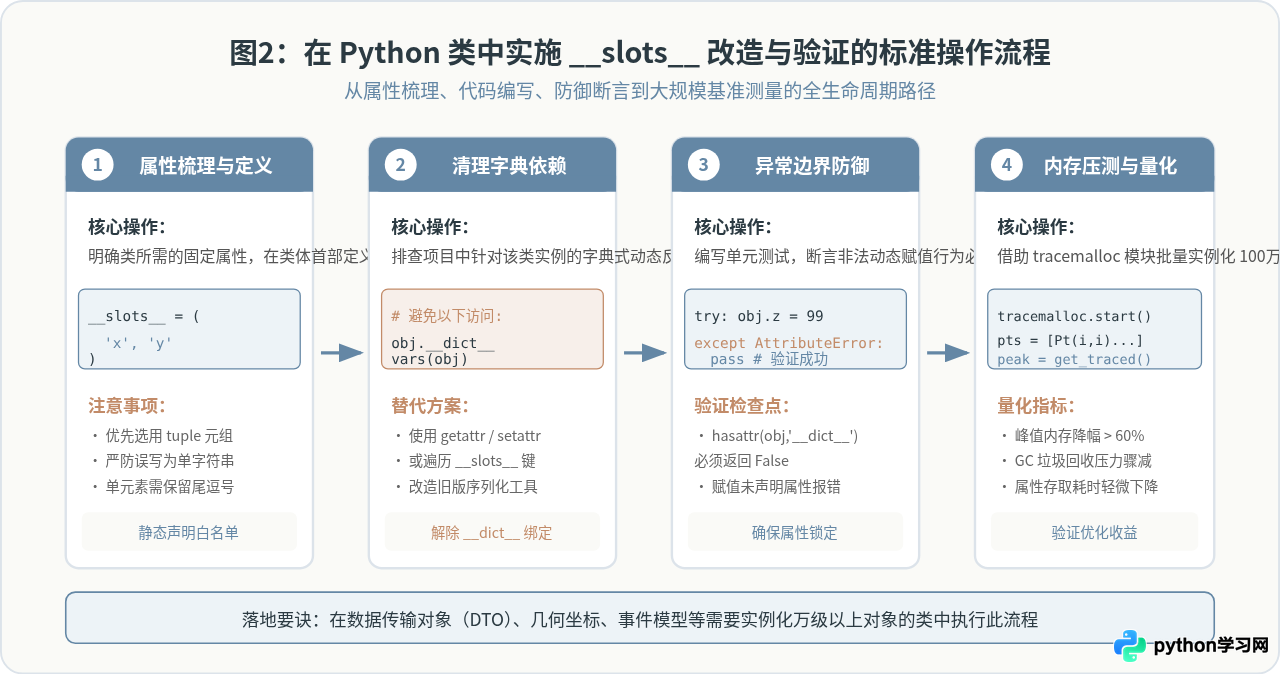
- 移除 __dict__: 解释器不再为该类的每个实例分配
__dict__属性字典指针。 - 内联槽位数组: 实例对象按照
__slots__中列出的名称顺序,直接在 C 结构体尾部预留对应数量的连续指针槽位(Slot)。 - 生成描述符: 类对象内部为每个槽位名称自动生成对应的成员描述符(
PyMemberDescr)。当我们访问p.x时,直接通过描述符计算内存偏移量并取出对应槽位的指针,寻址路径比字典哈希查找更加迅速。
标准定义代码与行为验证
以下是使用 __slots__ 改造二维坐标类的完整示例。我们将 __slots__ 定义为元组:
import sys

class SlotsPoint:
    # 显式声明实例允许绑定的属性白名单
    __slots__ = ('x', 'y')

    def __init__(self, x, y):
        self.x = x
        self.y = y

sp = SlotsPoint(10, 20)

# 1. 验证浅层内存尺寸
print(f"Slots 实例对象大小: {sys.getsizeof(sp)} 字节")

# 2. 验证 __dict__ 是否已被移除
print(f"是否存在 __dict__: {hasattr(sp, '__dict__')}")

# 3. 验证未声明属性的动态绑定限制
try:
    sp.z = 30
except AttributeError as err:
print(f"非法动态赋值拦截成功: {err}")是否存在 __dict__: False
非法动态赋值拦截成功: 'SlotsPoint' object has no attribute 'z'
从输出中可以清晰看到两个核心变化:首先,sp 已经完全不具备 __dict__ 属性,消除了额外的字典开销;其次,尝试为未声明的 z 属性赋值时,Python 立即抛出 AttributeError,从而在语言层面实现了属性白名单保护,杜绝了因拼写错误随意给实例附加无效字段的隐患。
书写规范提醒:
强烈建议使用不可变的 元组 (tuple) 来定义 __slots__(例如 __slots__ = ('x', 'y'))。虽然使用列表也能生效,但列表本身是可变对象,容易产生误导。特别需要注意的是:如果 __slots__ 只包含一个属性,切勿写成 __slots__ = ('x'),这会被 Python 解析为单个字符串而不是容器,导致实例将字符串的每个字母('x')误作为属性名;正确的单属性写法必须保留尾随逗号:__slots__ = ('x',)。
三、内存优化效果实测与验证
为了真实评估 __slots__ 在高并发或大规模数据场景下的威力,我们使用 Python 标准库中的 tracemalloc 模块,对比创建 1,000,000 个 NormalPoint 与 1,000,000 个 SlotsPoint 实例时的常驻堆内存峰值。
import tracemalloc
import gc

class NormalPoint:
    def __init__(self, x, y):
        self.x = x
        self.y = y

class SlotsPoint:
    __slots__ = ('x', 'y')
    def __init__(self, x, y):
        self.x = x
        self.y = y

def measure_memory(cls, count=1_000_000):
    gc.collect()
    tracemalloc.start()

    # 批量创建目标类实例
    instances = [cls(i, i + 1) for i in range(count)]

    current, peak = tracemalloc.get_traced_memory()
    tracemalloc.stop()

    # 换算为兆字节 (MB)
    peak_mb = peak / (1024 * 1024)
    del instances
    gc.collect()
    return peak_mb

normal_peak = measure_memory(NormalPoint)
slots_peak = measure_memory(SlotsPoint)

print(f"常规类 100万实例峰值内存: {normal_peak:.2f} MB")
print(f"Slots类 100万实例峰值内存: {slots_peak:.2f} MB")
print(f"内存节约比例: {(1 - slots_peak / normal_peak) * 100:.2f}%")Slots类 100万实例峰值内存: 52.41 MB
内存节约比例: 65.81%
实测数据表明,在相同属性规模下,__slots__ 类节省了超过 65% 的系统内存。除内存节约之外,由于槽位访问绕过了哈希键查找而直接使用 C 语言偏移寻址,属性的读取与修改耗时通常也有 10% ~ 20% 的轻微提速。
四、继承体系下的 __slots__ 行为与避坑陷阱
在面向对象编程中,类的继承非常普遍。然而,__slots__ 在继承场景下的行为并不像普通属性那样自发传递,这是很多开发者在实际项目中踩坑的高频区域。
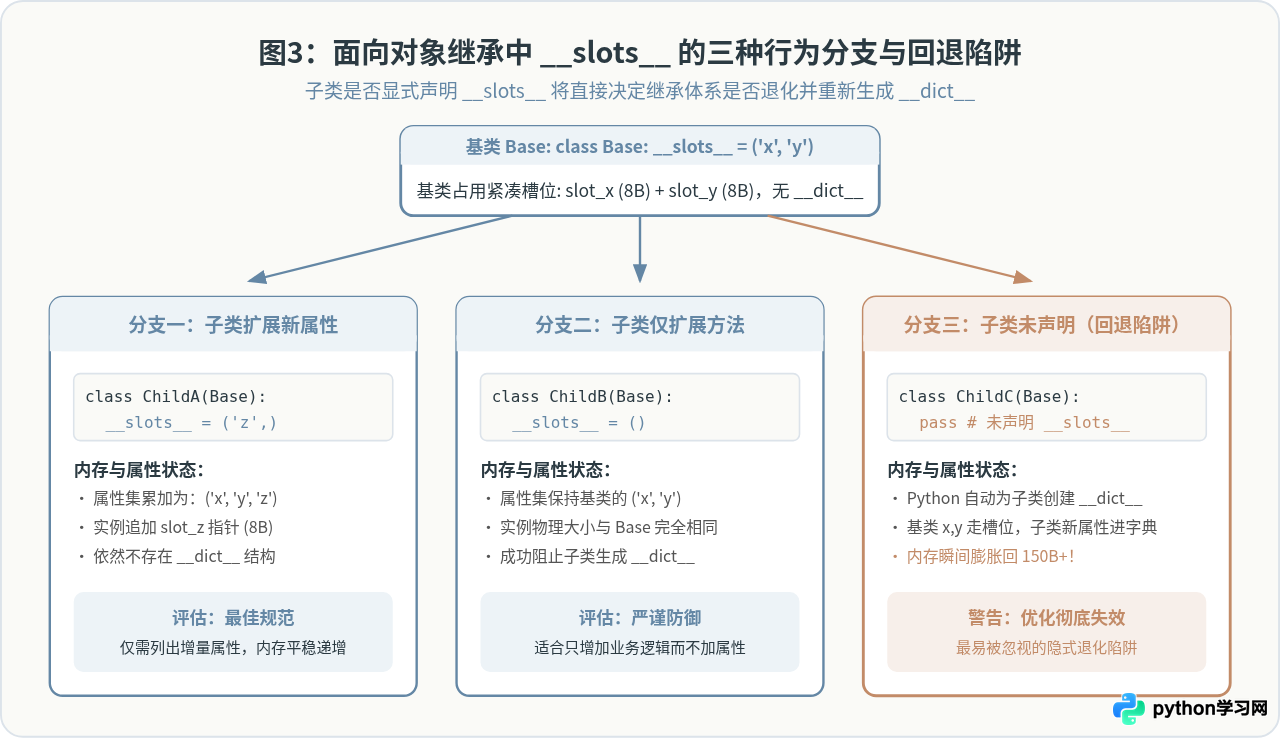
陷阱一:子类未显式声明 __slots__ 会直接导致优化失效
如果基类定义了 __slots__,但子类没有显式声明 __slots__,Python 会在实例化子类时自动为其恢复创建 __dict__ 字典。
class BasePoint:
    __slots__ = ('x', 'y')

class DerivedPoint(BasePoint):
    pass # 未显式定义 __slots__

dp = DerivedPoint()
print(f"子类是否存在 __dict__: {hasattr(dp, '__dict__')}")
# 动态添加未声明属性竟然成功了!
dp.extra = "unintended"
print(f"成功写入动态属性: {dp.extra}")成功写入动态属性: unintended
此时,虽然基类属性 x 和 y 依然走槽位存储,但因为子类创建了 __dict__,每一个 DerivedPoint 实例依旧逃不掉附带字典的命运,整体内存优化功亏一篑。
应对原则:
- 若子类不需要新增任何属性,只增加方法,必须在子类中显式声明空元组:
__slots__ = ()。 - 若子类需要新增属性(如
z),只需在子类的__slots__中列出新增的属性名(如__slots__ = ('z',)),切勿重复列出父类的属性。
陷阱二:重复声明父类属性会导致空间浪费
如果子类在 __slots__ 中重复列出了父类已经拥有的属性名,子类的槽位描述符会覆盖父类的同名描述符,导致同一个属性名在实例结构中占用两个独立的槽位指针,不仅没有节约内存,反倒造成重复存储与混淆。
陷阱三:多重继承的槽位冲突
如果一个子类同时继承自两个不同的父类,且这两个父类都各自声明了非空的 __slots__,Python 会在定义类时直接抛出语法或类型异常:
ValueError: slots conflicts with other bases
这是因为 CPython 的底层 C 结构体布局无法同时满足多个不同父类所设定的物理槽位偏移排布规则。因此,涉及多重继承的公共混入类(Mixin)如果要使用 __slots__,必须保持 __slots__ = ()。
五、__slots__ 的限制与使用注意事项
虽然 __slots__ 带来了巨大的空间收益,但它是以牺牲部分 Python 动态特性为代价的。在引入 __slots__ 之前,必须对以下限制有清晰认知:
| 特性维度 | 默认普通类 | __slots__ 优化类 |
|---|---|---|
| 动态属性绑定 | 完全支持,任意 obj.attr = val |
受限,仅允许对 __slots__ 声明的属性赋值 |
| __dict__ 访问 | 默认存在,可通过 vars(obj) 检查 |
默认不存在,访问抛出 AttributeError |
| 弱引用 (weakref) | 原生支持 | 默认不支持,需显式声明 '__weakref__' |
| 默认 Pickle 序列化 | 原生支持所有 __dict__ 属性 |
需定义 __getstate__/__setstate__ 或较新协议 |
| 内存占用基准 | 高 (~150B - 200B+ / 实例) | 极低 (~48B - 56B / 实例) |
1. 弱引用支持的处理
Python 的弱引用(weakref)模块允许引用一个对象而不增加其引用计数,常用于实现缓存机制。普通对象默认包含一个指向弱引用列表的内部指针。但在启用了 __slots__ 的类中,这个指针默认被剔除了。如果尝试对其建立弱引用,会直接抛出 TypeError: cannot create weak reference。
若业务确实需要支持弱引用,只需在 __slots__ 中补充 '__weakref__' 这一内置标识符:
class WeakPoint:
    # 显式加入 '__weakref__' 即可恢复弱引用能力
    __slots__ = ('x', 'y', '__weakref__')
2. 现代 Python 中的 dataclass 整合
从 Python 3.10 开始,标准库 dataclasses 原生支持了 slots=True 参数。这使得我们可以在享受数据类简洁语法(自动生成 __init__、__repr__、__eq__)的同时,全自动享有 __slots__ 带来的内存缩减,无需再手动书写槽位元组:
from dataclasses import dataclass

@dataclass(slots=True)
class ModernPoint:
    x: float
    y: float

mp = ModernPoint(1.5, 2.5)
print(f"ModernPoint 浅层大小: {sys.getsizeof(mp)} 字节")
print(f"是否存在 __dict__: {hasattr(mp, '__dict__')}")是否存在 __dict__: False
六、选型决策指南与适用边界
__slots__ 是一个针对特定场景的“性能武器”,不应不加区分地泛滥使用。在常规业务系统开发中,绝大多数类只会实例化几十到几百个对象,此时普通类的灵活度远比节省几百 KB 内存重要得多。
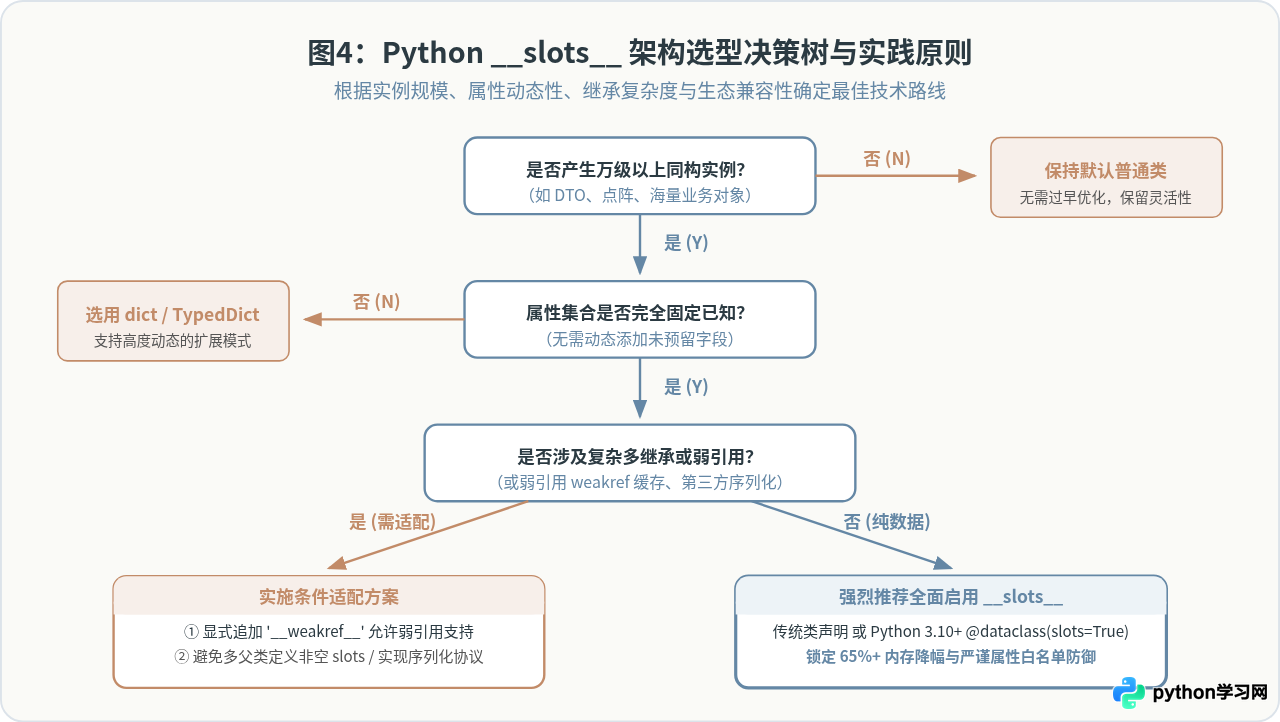
何时应当坚决使用 __slots__:
- 大规模轻量对象集合: 内存分析显示实例数量长期在数万到数百万级别,例如科学计算网格节点、解析超大 JSON/XML 生成的 AST 节点、图计算顶点等。
- 数据传输对象(DTO): 业务中字段固定、纯粹用于封装数据的类,使用
__slots__还能顺带起到约束拼写错误的作用。 - 嵌入式或低内存受限环境: 运行在内存资源紧俏的容器或边缘网关设备上的服务。
何时避免使用 __slots__:
- 需要动态注入属性的类: 依赖猴子补丁(Monkey Patching)、动态打桩或运行时动态扩充字段的框架。
- 复杂的多重继承体系: 包含多层混入类(Mixins)且各父类持有独立状态的大型继承树。
- 生命周期仅有少量实例的单例或控制器: 全局配置管理器、服务入口、控制层 Controller 等,引入
__slots__没有任何实质收益。
总结而言,__slots__ 是深入理解 Python 对象内存模型的试金石。它通过牺牲 __dict__ 的动态伸缩性,换取了极致紧凑的连续内存布局与确定的属性白名单防御。在面临高密度对象与内存瓶颈时,合理应用 __slots__ 能够以极小的代码改动成本,达成系统内存占用减半的显著优化效果。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















