


Python替代全局变量的方案:使用类属性或参数传递

在Python开发中,随着项目规模扩大,使用 global 关键字维护的全局变量往往会引发隐式依赖、数据竞态以及难以隔离单元测试等严峻问题。替代全局变量的核心解决路径主要有两条:一是通过函数显式传递参数以确立严密的数据流契约;二是将状态与操作封装到类中,利用类属性或实例属性来规范生命周期。本文将深入解析这两种方案的具体实现方式、适用边界与迁移重构步骤,帮助开发者编写出清晰、易测且高内聚的代码。
一、为什么全局变量在大型项目中需要被替代
在简短的脚本中,直接声明变量并在多个函数内部通过 global 修改确实简单直接。但当代码行数增多或引入并发操作后,全局变量的缺陷就会成倍放大:
- 隐式依赖与黑盒风险: 函数签名无法体现该函数究竟依赖外部哪些状态,阅读者必须通读函数每一行代码才能知道它读取或篡改了哪个外部变量。
- 难以实施单元测试: 多个测试用例并发或先后执行时,共享的全局状态会互相残留与污染,导致测试必须频繁编写重置逻辑。
- 多线程安全隐患: Python全局解释器锁(GIL)并不能保证复合操作的原子性,多个线程读写同一全局变量极易产生不可预期的脏数据。
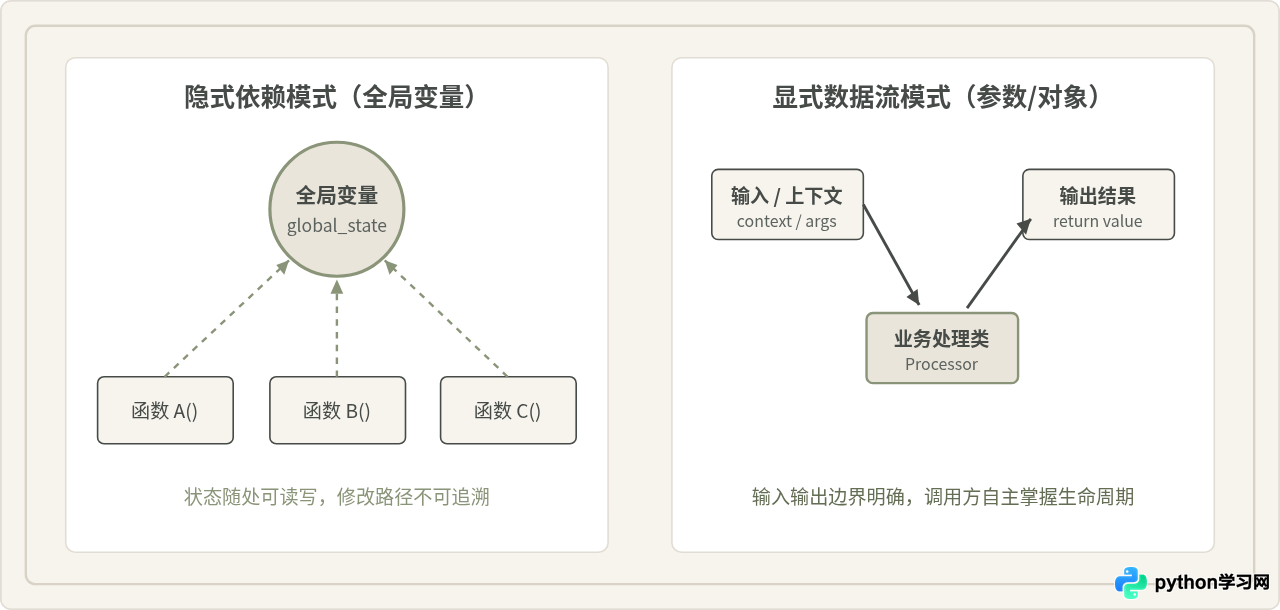
二、方案一:通过函数参数传递(显式契约)
函数式设计倡导“纯函数”或尽量无副作用的设计。将原来存储在全局变量中的状态,改为调用时传入实参,计算结果通过返回值返回给调用者,这是最彻底、最清爽的解耦方式。
1. 基础实参传递与返回值承接
在原有脚本中,如果一个函数依赖累加器或外部配置,不要在函数内部用 global counter,而是将 counter 作为参数传入,并返回更新后的值。
# 改造前(依赖全局变量)
counter = 0

def increment():
    global counter
    counter += 1

# 改造后(显式参数传递)
def increment(count: int, step: int = 1) -> int:
    return count + step

current_count = 0
current_count = increment(current_count)
2. 参数膨胀时的聚合模式:使用上下文或数据类
当一个模块需要共享数十项配置或环境参数时,如果逐一在函数参数列表中声明,会导致参数列表冗长(所谓的“参数钻斗”)。此时不应退回到全局变量,而应使用 Python 标准库的 dataclass 或字典封装为一个上下文对象:
from dataclasses import dataclass

@dataclass
class AppContext:
    db_url: str
    timeout: int
    debug_mode: bool
    retry_limit: int = 3

def fetch_data(context: AppContext, query_id: str):
    # 显式依赖 context,函数所需配置一目了然
    if context.debug_mode:
        print(f"Executing query {query_id} on {context.db_url}")
    # 模拟网络处理逻辑
    return {"status": "ok", "query": query_id}
这种做法既保持了参数传递的显式与纯净,又解决了参数过多带来的维护成本,各函数的签名依然保持紧凑清晰。
三、方案二:使用类属性与实例属性(面向对象封装)
当多个函数共享的状态具有高度内聚性,且在运行过程中需要持续维护自身生命周期时,将这些状态和函数组织进一个类中是更合理的架构方案。
1. 必须澄清的关键概念:类属性 vs 实例属性
很多初学者会把全局变量直接搬进类中,写成“类属性”,并误以为这就是面向对象。事实上,类属性属于类对象本身,由所有实例共同共享;而实例属性通过 self 绑定,每个实例独享独立副本。
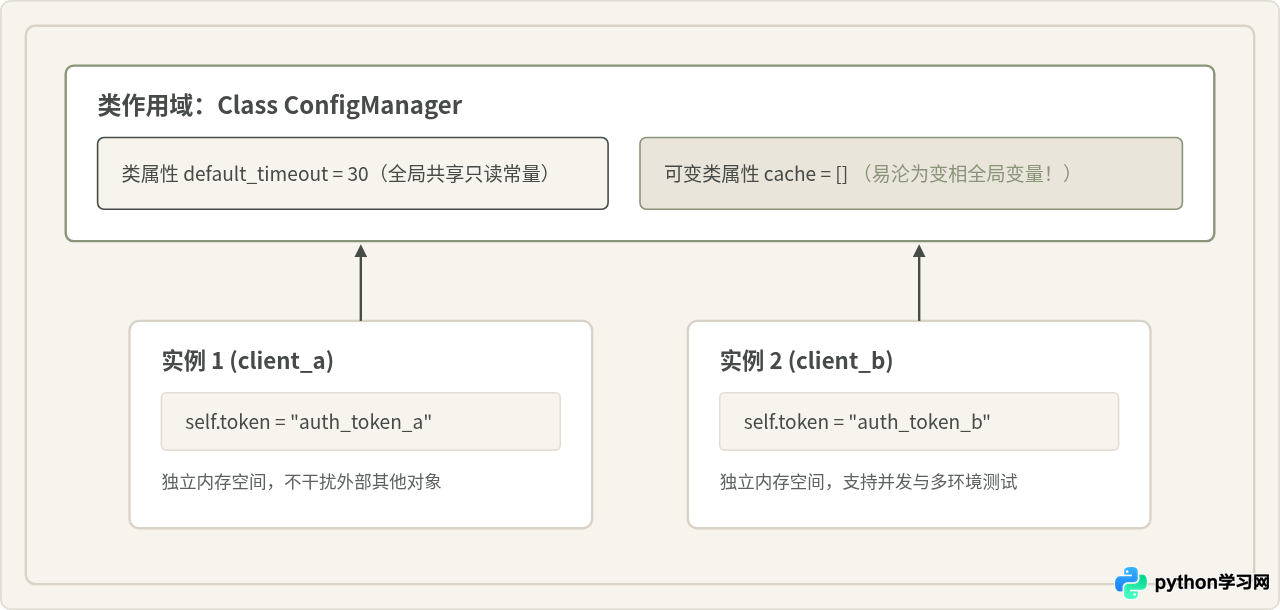
2. 类属性的合理使用:命名空间化的常量与默认值
类属性非常适合作为不随实例状态改变的配置常量或默认策略。使用类属性管理常量,可以提供明确的命名空间,避免全局命名污染:
class HttpHandler:
    # 类属性:常量与不可变配置
    DEFAULT_TIMEOUT: int = 15
    ALLOWED_SCHEMES: tuple = ("http", "https")

    def __init__(self, endpoint: str):
        # 实例属性:私有独立状态
        self.endpoint = endpoint
        self.request_count = 0

    def send(self, data: dict):
        self.request_count += 1
        # 访问类属性获得标准默认行为
        timeout = self.DEFAULT_TIMEOUT
        return f"Posting to {self.endpoint} (timeout={timeout})"
append 或 update)。这与模块级全局变量在本质上没有任何区别,仍然会导致所有实例与多线程之间的互相污染。可变状态务必绑定在 __init__ 中的 self 上。
四、常见认知误区与辨析
在替代全局变量的重构过程中,开发者经常陷入两个极端认识,需要明确其成立条件与修正方案:
误区一:“只要包进一个类的类属性里,代码就符合面向对象且没有副作用了”
为什么看似合理:代码看起来有了 class 关键字,全局命名也收拢到了类似 State.items 的前缀下,命名空间确实更清晰了。
哪里需要修正:类在 Python 中是全局单例对象。如果直接通过 State.items.append(x) 操作,其作用域和生命周期与普通的全局变量一模一样。在单元测试和并发环境下,依然会出现“前一个测试污染后一个测试”的问题。正确的做法是将状态放进实例属性中,通过实例化对象分发;或者将类属性严格限定为不可变的只读值。
误区二:“把所有变量作为参数传递是代码洁癖,会产生极度繁琐的参数链路”
为什么看似合理:当调用栈深达五六层时,从顶层把配置传递到底层子函数,每一层都要声明相同的入参,看似产生了大量的样板代码。
哪里需要修正:深层透传往往说明系统设计违反了单一职责原则,或者是缺少了合理的上下文聚合对象。当遇到深层传递时,通常有两种规范解法:一是将深层函数与其所依赖的局部状态共同组合成一个独立的类服务;二是将散落的零碎参数整合为一个单一的上下文配置对象,进行单点注入。
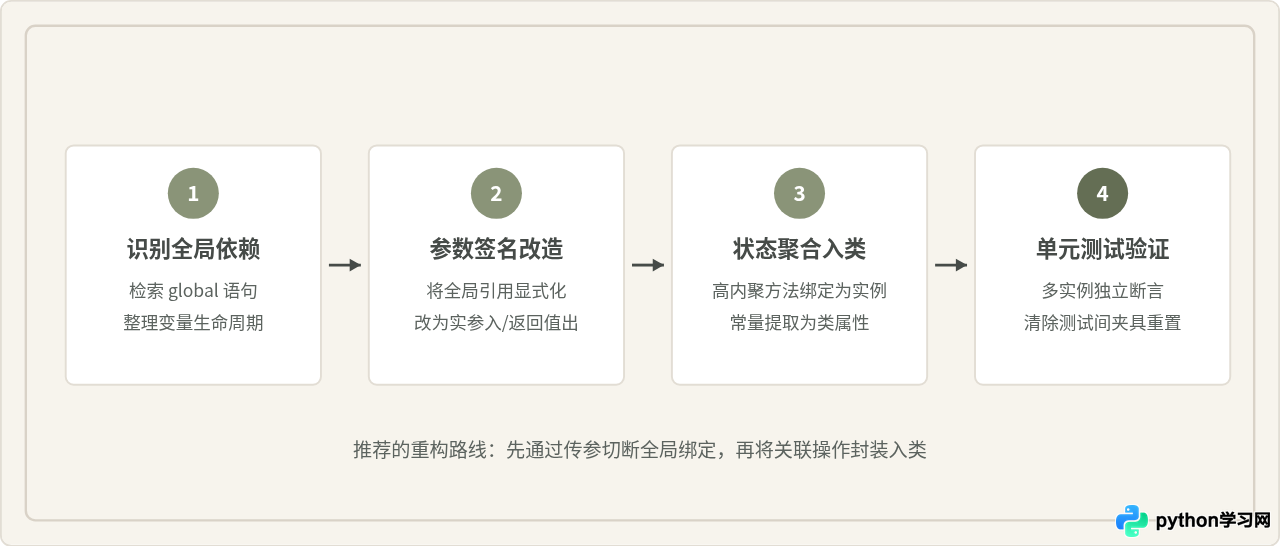
五、从全局变量平滑迁移的实战步骤
为了保证业务平稳过渡,替换现有项目中的全局变量应当遵循循序渐进的步骤,避免一次性大范围重构引发未知回归。
代码重构完整示例
下面是一个典型的计算与日志记录模块重构前后的对比展示:
# ===================== 重构前:全局变量混杂 =====================
total_processed = 0
system_config = {"log_level": "INFO", "multiplier": 2}

def process_item(val):
    global total_processed
    result = val * system_config["multiplier"]
    total_processed += 1
    if system_config["log_level"] == "INFO":
        print(f"Processed: {val} -> {result}, Total: {total_processed}")
    return result

# ===================== 重构后:结构化类与对象 =====================
class ItemProcessor:
    # 类属性:默认静态规则(不可变)
    DEFAULT_MULTIPLIER = 2

    def __init__(self, log_level: str = "INFO", multiplier: int = None):
        # 实例属性:独立可控的运行时状态
        self.log_level = log_level
        self.multiplier = multiplier or self.DEFAULT_MULTIPLIER
        self.total_processed = 0

    def process(self, val: int) -> int:
        result = val * self.multiplier
        self.total_processed += 1
        if self.log_level == "INFO":
            print(f"Processed {val} -> {result} | Total: {self.total_processed}")
        return result

# 客户端调用:根据需要创建多个完全隔离的实例
processor_a = ItemProcessor(multiplier=3)
processor_b = ItemProcessor(log_level="DEBUG")

res_a = processor_a.process(10)
res_b = processor_b.process(10)
重构完成后,processor_a 与 processor_b 的计数器完全独立互不影响,编写自动化测试时无需任何 tearDown 清理全局变量的代码,模块的健壮性得到质的提升。
六、选型指南与决策总结
在实际工程中,并非所有变量都必须套用复杂的面向对象模式。根据变量的具体性质与使用场景,可参照如下决策原则进行选型:
| 场景特征 | 推荐方案 | 实现载体 | 核心收益 |
|---|---|---|---|
| 只读全局常量(如协议名、固定错误码) | 命名空间常量 | 类属性(不可变类型)或 模块级大写变量 | 提供命名空间,防止魔法值分散 |
| 短期流水线计算、无状态逻辑 | 参数传递 | 函数实参与返回值 | 纯函数契约,零副作用,极易做单元测试 |
| 参数较多、横跨多层函数的配置集 | 上下文参数传递 | @dataclass 或 TypedDict |
解决参数钻斗,保持显式依赖与类型提示 |
| 需要维护内部状态与操作的有状态服务 | 面向对象封装 | 实例化类,使用实例属性(self) |
状态生命周期内聚,支持多实例并发共存 |
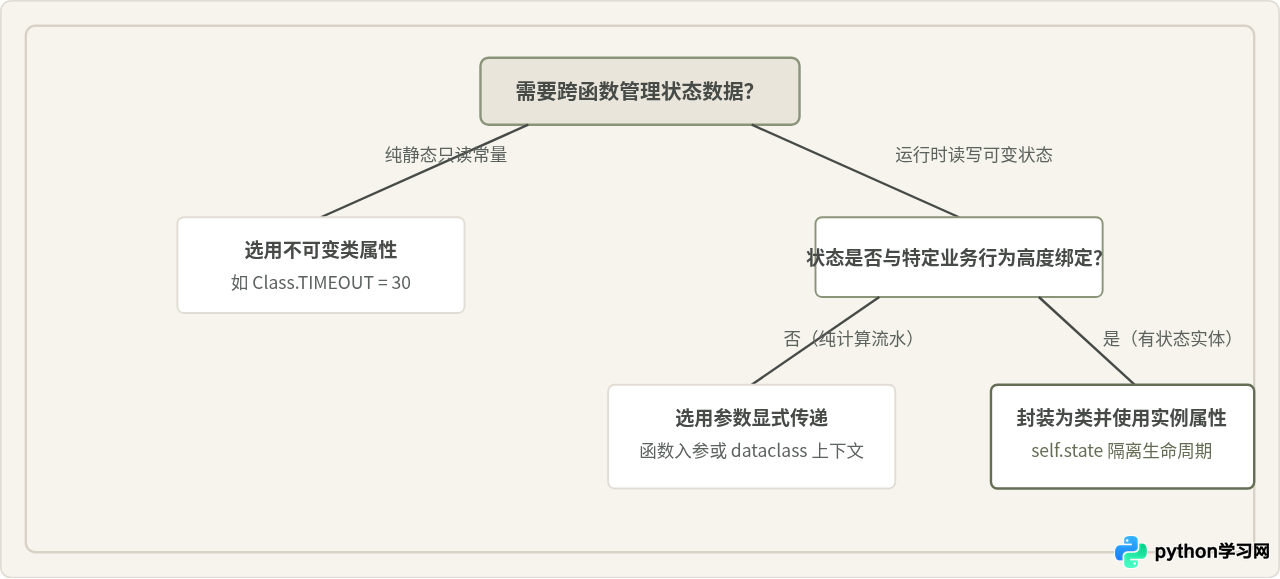
综上所述,彻底摆脱 global 的关键,并不在于用某种炫酷的语法糖代替赋值,而在于重新梳理数据在代码中的流动路径。如果是无状态数据流动,优先选用函数参数显式传递;如果是有生命周期的状态聚合,封装为携带实例属性的类服务;对于固定的配置常数,则采用只读类属性作为命名空间。建立起这种显式、可控的数据流规范,是编写出高质量 Python 项目的坚实基石。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















