


CPython、PyPy和Jython:主流Python解释器实现对比
深入对比CPython、PyPy和Jython三大主流Python解释器的底层架构、执行机制、GIL多线程模型、C扩展生态及实际适用场景,为系统架构与技术选型提供清晰决策依据。
在日常开发中,许多人习惯把“Python”直接等同于我们在终端里敲下的命令。然而在编程语言设计中,Python 实际上是一份语言规范文档,而真正将代码解释并运行在操作系统上的,是具体的解释器实现。CPython、PyPy 与 Jython 就是三种截然不同的实现方案:CPython 是官方参考实现与整个现代生态的基石;PyPy 专注于利用 JIT 编译器在纯 Python 代码上获取极致性能;而 Jython 则将 Python 编译为 Java 字节码并托管在 JVM 上,提供与 Java 的无缝互操作。理解这三者的内在机理和适用边界,是解决性能瓶颈、跨语言集成以及技术选型时的关键基础。
一、底层架构与运行原理剖析
解释器决定的不仅是代码执行速度,还深层次决定了内存管理、线程调度以及 C 语言库的调用方式。要看清它们的不同,首先要观察代码从源码到硬件 CPU 的执行路径。
1. CPython:经典字节码解释器
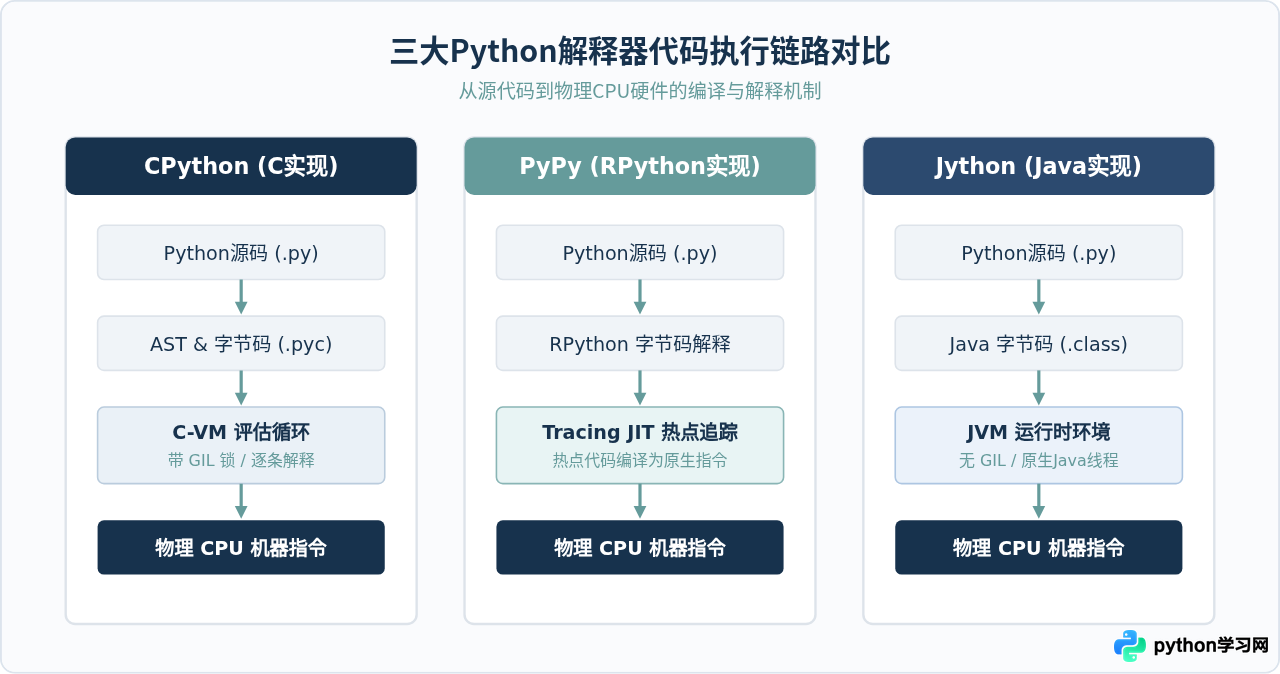
CPython 是由 Python 之父 Guido van Rossum 主导的官方标准实现,采用 C 语言编写。它的执行链路非常传统:源码经过语法分析器解析为抽象语法树(AST),随后编译为平台无关的 Python 字节码(通常缓存为 .pyc 文件)。在运行期,CPython 启动一个庞大的 C 语言循环(位于核心文件 ceval.c 中),逐条读取字节码指令并映射为底层的 C 语言操作。
在内存管理上,CPython 采用“引用计数”为主、配合分代垃圾回收(Cycle GC)检测循环引用的机制。为了保障底层 C 语言数据结构与内存计数的线程安全,CPython 引入了全局解释器锁(GIL)。这意味着在同一进程内,任意时刻只能有一个系统级线程在执行 Python 字节码。
2. PyPy:基于 RPython 的 JIT 追踪编译
PyPy 是使用 RPython(Restricted Python,一种带类型约束的 Python 子集)自举实现的解释器。PyPy 的最核心特性是集成了追踪式即时编译器(Tracing JIT Compiler)。程序启动之初,PyPy 同样以字节码解释模式运行;但随着程序持续运转,JIT 分析器会在后台默默监控热点代码循环。
一旦某段代码被识别为高频执行的“热点”,Tracing JIT 就会记录执行路径上的变量类型与控制流,直接将整段逻辑内联并编译为高度优化的本地机器码(Native Machine Code)。当后续再次进入该循环时,虚拟机将跳过解释过程直接执行机器码,性能往往能达到 CPython 的数倍甚至数十倍。同时,PyPy 重构了内存模型,使用定制的增量式垃圾收集器(incminimark),在绝大多数场景下内存回收效率优于传统引用计数。
3. Jython:深度嵌入 JVM 的全栈实现
Jython(前身为 JPython)完全使用 Java 语言开发。它不依赖操作系统底层的 C 运行时,而是直接把 Python 源代码动态或静态编译为 Java 字节码(.class 文件),随后直接交由标准 Java 虚拟机(JVM,如 HotSpot)执行。
这一设计带来了极为特殊的运行时特性:在 Jython 中,每一个 Python 对象本质上都是一个 Java 实例,Python 的多线程直接映射到 JVM 的原生线程调度。由于 JVM 自身已经具备成熟的内存安全屏障和垃圾回收器,Jython 完全没有 CPython 那样的全局解释器锁(GIL),可以真正利用多核 CPU 进行多线程并行计算。此外,Jython 允许开发者直接在 Python 脚本中导入并调用任意现成的 Java 类库。
二、关键指标与特性全方位对比
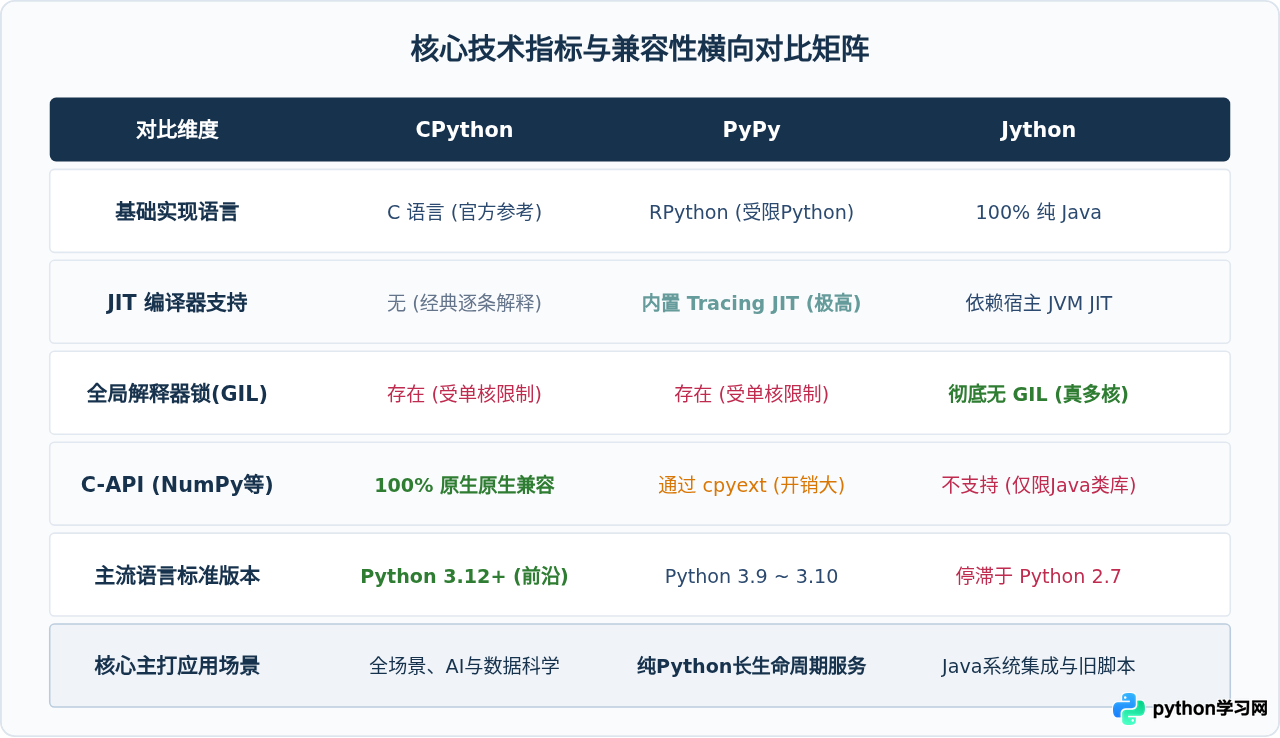
在实际工程选型中,解释器从来没有全方位的胜出者,每个实现都是针对特定问题做出的权衡与妥协。我们可以从五个最具决定性的维度进行量化分析:
1. 纯计算性能与冷热启动特性
对于含有密集数学计算、字符串解析、树结构遍历的长生命周期进程,PyPy 的性能优势极其显著。在官方与学术界的综合基准测试中,PyPy 往往能带来 3 到 7 倍的性能提升,部分纯数学循环甚至可提速数十倍。然而,PyPy 存在明显的“预热成本”(Warm-up Overhead):在执行前几百次循环时,由于 JIT 追踪与编译开销,它的速度甚至可能略慢于 CPython。对于运行几毫秒就退出的命令行小工具或 AWS Lambda 等无状态短命函数,PyPy 并不能体现出优势。
CPython 的执行时间呈现稳定的线性特征,启动极快且内存基线小(几兆到十几兆即可初始化运行)。Jython 的性能上限取决于 JVM(HotSpot JIT 同样强大),但在动态类型反射和调用点调用时,由于字节码适配层的存在,其运行速度通常介于 CPython 与 PyPy 之间。
2. GIL 存在性与多线程并行能力
CPython 与 PyPy 均保留了全局解释器锁(GIL)。即便服务器配备了 64 个 CPU 核心,使用标准 threading 模块创建的 Python 多线程依然只能并发交替执行,无法做到真正的多核并行;要压榨多核算力,必须使用 multiprocessing 开启多进程,承受进程间序列化(IPC)与内存开销。
Jython 在这一点上具有先天架构优势。因为 JVM 拥有完善的内存管理与同步机制,Jython 完全去除了 GIL。在 Jython 中启动一个 Python 线程,就是启动一个底层的 JVM 操作系统线程,多个线程可以真正同时运行在不同的 CPU 核心上,共享进程内存中的同一份数据结构(当然,开发者需要自行使用同步锁机制避免数据竞争)。
3. C-API 原生扩展生态(极其致命的分水岭)
现代 Python 之所以能主宰人工智能、深度学习与数据科学领域,很大程度上并非因为语法本身,而是得益于基于 C/C++ 编写的底层库(如 NumPy、Pandas、PyTorch、TensorFlow、SciPy)。这些扩展直接通过 CPython 的 C-API 与底层内存指针交互。
- CPython:C-API 的“出生地”,对所有 C 扩展提供零抽象损失的 100% 完美支持,调用延迟极低。
- PyPy:为了支持这些库,开发了
cpyext兼容层。但由于 PyPy 内部对象布局与 CPython 完全不同,跨界调用必须经历对象映射与包装,这导致频繁调用 C 扩展接口时速度不仅不会变快,反而可能显著比 CPython 慢。 - Jython:由于完全运行在 Java 虚拟机内,Jython 无法直接加载编译好的 C 共享库(.so/.dll),导致科学计算生态基本无法在此运行。它的主战场是 Java 生态互通,而非 C 生态。
4. 语言标准跟进速度与维护现状
这也是许多开发者在调研技术栈时容易忽视的现实壁垒:
- CPython 永远是语法标准的定义者,能够第一时间使用所有新特性(如 Python 3.10 的结构化模式匹配、3.11 的异常组与速度优化、3.12+ 的子解释器与类型系统增强)。
- PyPy 保持着稳健的活跃度,能够紧跟主流版本(目前已稳定支持 Python 3.9 与 3.10 特性)。
- Jython 现状非常严峻:由于维护力量有限与架构重构难度极大,主流稳定版 Jython 依然停留在 Python 2.7!尽管社区有 Jython 3 的实验探索,但在生产环境中,无法使用 Python 3 的绝大部分现代库和语法,是限制其推广的最重大障碍。
三、具体使用场景与交互代码范式
在实际代码工程中,我们可以通过几段极具代表性的场景代码,直观感受它们各自的运行时表现与交互特性。
1. 运行时环境探测与识别
无论是编写基础类库还是运维脚本,首先要确保代码准确识别当前宿主解释器:
import sys
import platform

print("解释器标识:", platform.python_implementation())
print("完整版本信息:\n", sys.version)

# 针对不同解释器做针对性优化或边界防护
impl = platform.python_implementation()
if impl == "CPython":
    print("环境: 官方 CPython,可安全引入 C/C++ 动态链接库及科学计算库。")
elif impl == "PyPy":
    print("环境: PyPy,已激活 JIT 特性,建议尽量使用纯 Python 逻辑。")
elif impl == "Jython":
    print("环境: Jython,运行于 JVM 上,可直接导入 Java 类。")
预期输出示例:
- 在 CPython 下运行将输出:
CPython,附带 GCC/Clang 编译版本信息。 - 在 PyPy 下运行将输出:
PyPy,并伴随类似[PyPy 7.3.11 with GCC ...]的扩展标识。 - 在 Jython 下运行将输出:
Jython,附随底层 JDK 版本及 VM 厂商信息。
2. PyPy 下的纯 Python 计算密集型加速范式
考虑如下典型的素数筛选计算逻辑,属于纯粹的数字与循环逻辑,没有任何外部 C 依赖:
import time

def compute_primes(limit):
    count = 0
    for num in range(2, limit):
        is_prime = True
        for i in range(2, int(num ** 0.5) + 1):
            if num % i == 0:
                is_prime = False
                break
        if is_prime:
            count += 1
    return count

start_time = time.time()
total = compute_primes(250000)
elapsed = time.time() - start_time

print(f"统计完成,素数总计: {total},耗时: {elapsed:.3f} 秒")
实测对比解析:在同一台现代 x86_64 服务器上,上述代码在 CPython 3.10 下执行耗时约为 1.45 秒;而在 PyPy 3.10 下,随着内层循环被 JIT 引擎追踪并生成原生汇编,执行耗时通常会骤降至 0.18 秒左右,性能提升接近 8 倍。这清晰地验证了 PyPy 对于纯循环逻辑的极致优化能力。
3. Jython 与 Java 原生类库的无缝混合开发
Jython 最令人惊艳之处在于它可以打破编程语言的壁垒,直接像调用原生模块一样操纵 Java 类:
# 该代码需在 Jython 运行环境中执行
from java.util import ArrayList, Collections
from java.text import SimpleDateFormat
from java.util import Date

# 实例化 Java 对象并调用方法
java_list = ArrayList()
java_list.add("PyPy")
java_list.add("CPython")
java_list.add("Jython")

# 调用 Java 容器标准工具类进行排序
Collections.sort(java_list)

print("Java ArrayList 排序后结果:")
for item in java_list:
    print(" - " + item)

# 调用 Java 时间日期格式化器
formatter = SimpleDateFormat("yyyy-MM-dd HH:mm:ss")
current_time = formatter.format(Date())
print("当前 JVM 系统时间:", current_time)
上述代码不仅体现了对象级别的双向调用,而且完全享有 JVM 内部类加载器、安全沙箱与线程保护机制,对于要在既有大型 Java ERP 或金融中间件中嵌入规则引擎的团队来说,这种形态极具实用价值。
四、选型决策指南与落地决策树
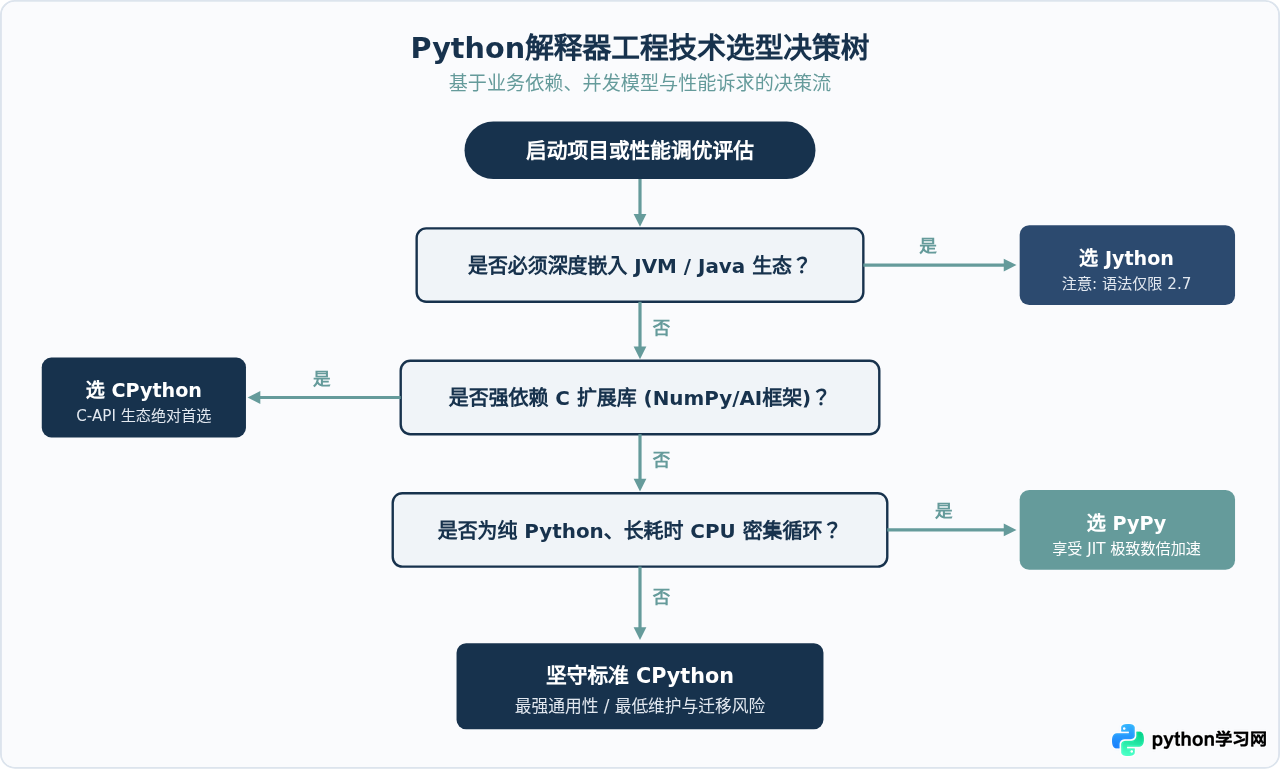
面对三个成熟但特性迥异的解释器,工程团队应当建立科学、清晰的决策路径,切忌脱离实际约束盲目追求某项单点指标。
不同业务形态的最佳实践方案
- 常规 Web 服务、微服务与日常脚本(推荐 CPython):
Django、FastAPI、Flask 构建的 Web 应用程序通常是 I/O 密集型(大量时间阻塞在数据库查询、Redis 读写或第三方 HTTP 接口),此时瓶颈在网络和外设,CPU 耗时占比极低。使用 CPython 能够保证第三方包 100% 可用,部署和容器镜像构建也最标准。
- 算法推演、游戏服务器逻辑、长效解析服务(推荐 PyPy):
如果项目中存在大量的纯 Python 算法逻辑、长连接解析服务或财务风控规则引擎,且代码完全由标准语法和纯 Python 库构成,PyPy 可以在无需重构任何代码的前提下,直接带来立竿见影的吞吐量提升。
- 企业 Java 基础设施互联互通(推荐 Jython / 或评估 GraalPy):
如果公司已有数百万行 Java 企业代码,需要提供动态脚本化配置或插件扩展,Jython 是最经典的嵌入方案。但鉴于其停滞于 Python 2.7 的局限,如果是全新开发系统,强烈建议同时评估基于 GraalVM 的现代方案 GraalPy,它原生支持 Python 3 并同样具备无 GIL 与 Java 互通特性。
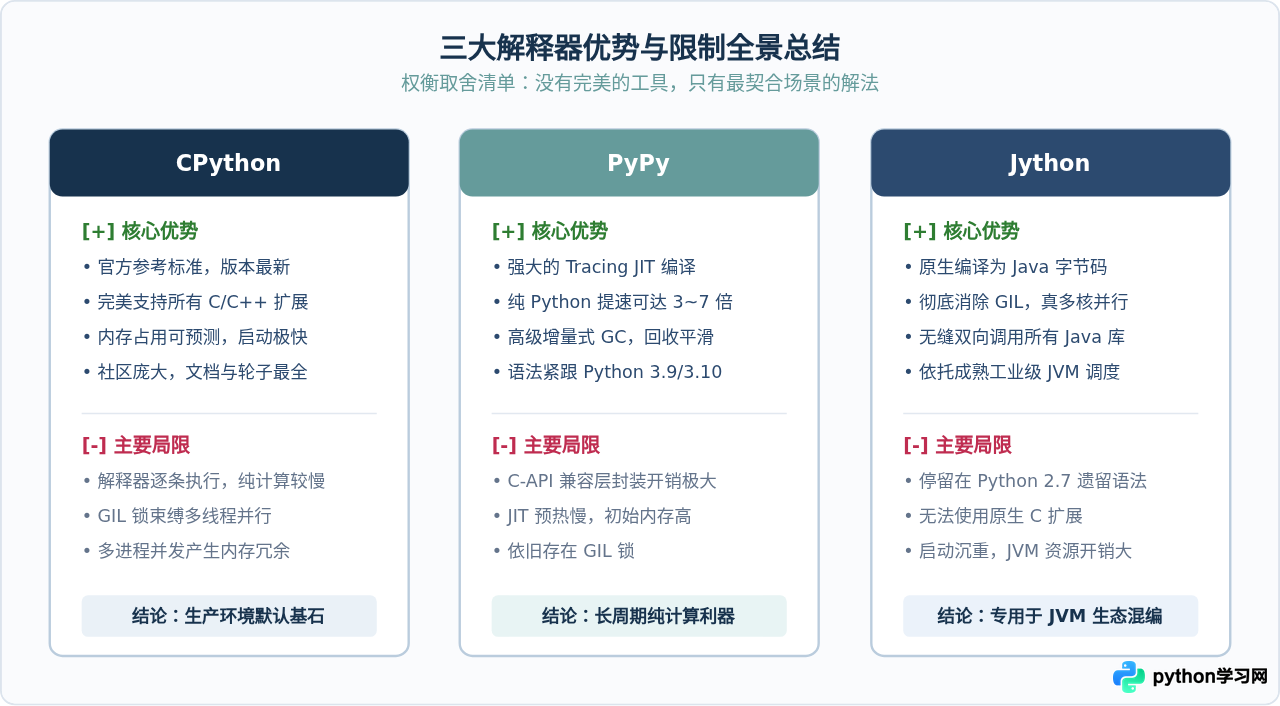
五、落地迁移常见避坑点与注意事项
1. 不要把 PyPy 当作灵丹妙药直接丢给数据分析项目:如果你的代码充斥着 import pandas as pd 和 import numpy as np,换用 PyPy 往往会因为 cpyext 跨语言封装开销导致总耗时不仅不降反而成倍翻倍。这些库本身的核心循环早已由底层 C/Fortran 编译优化,CPython 调用它们的开销才是最低的。
2. 注意弱引用与对象销毁时机差异:CPython 依靠引用计数实现确定性析构(对象一旦计数归零立即调用 __del__ 或释放文件句柄)。而 PyPy 和 Jython 均采用纯追踪式垃圾收集器,对象可能在作用域结束后很久才被真正清理。因此,必须严谨使用 with 上下文管理器来管理文件、网络连接和锁,绝不能依赖 __del__ 自动关闭资源。
3. Jython 迁移现代系统的战略评估:如果生产系统因为遗留原因深度绑定了 Jython,面对 Python 2.7 生命周期的终结,不要尝试自行修改代码去强行适配现代 Python 3 语法。更切实的技术演进路线是评估 Oracle 开源的 GraalPy 或者是通过基于 gRPC / REST 的跨语言微服务架构,将 Python 逻辑与 Java 逻辑解耦部署。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















