


Java和Python的运行性能差异及底层机制解析

在同等硬件环境下执行纯计算密集型任务时,Java 程序的运行速度通常可达到标准 Python(CPython)的 10 倍至 50 倍。这种性能鸿沟不仅体现在最终的执行耗时上,更植根于两者在代码转换机制、即时编译优化、内存对象布局以及多线程并发调度等底层架构设计上的本质差异。本文直接聚焦这些核心底层机制,系统阐明决定两门语言性能边界的技术细节。
执行范式对比:JIT 即时编译与字节码逐条解释
代码从源文本转化为底层 CPU 指令的路径,直接决定了语言的理论性能天花板。Java 与 Python 都采用了中间字节码设计,但在字节码加载之后的运行机制上走向了完全不同的方向。
Java 遵循“静态编译预处理 + 虚拟机混合执行”策略。开发者编写的 .java 源码由 javac 静态编译器先行校验并转换为结构严谨的 .class 字节码。此时变量类型与方法签名已完全固化。在运行时,JVM(如主流的 HotSpot)首先通过轻量解释器启动以减少首次冷启动延迟,随后内建的性能分析器(Profiler)持续监控运行热点。当一段代码(方法或循环体)执行达到热度阈值后,分层编译系统(Tiered Compilation)会唤醒 JIT(Just-In-Time)编译器:
- C1 编译器(Client Compiler):执行快速的本地优化,进行局部内联与基础优化,生成初步的高性能机器码。
- C2 编译器(Server Compiler):开展深度全局分析,实施激进的方法内联(Inlining)、逃逸分析(Escape Analysis)、循环展开与冗余消除,最终将字节码彻底替换为高度定制的原生 CPU 指令直接驻留于代码缓存(Code Cache)中。
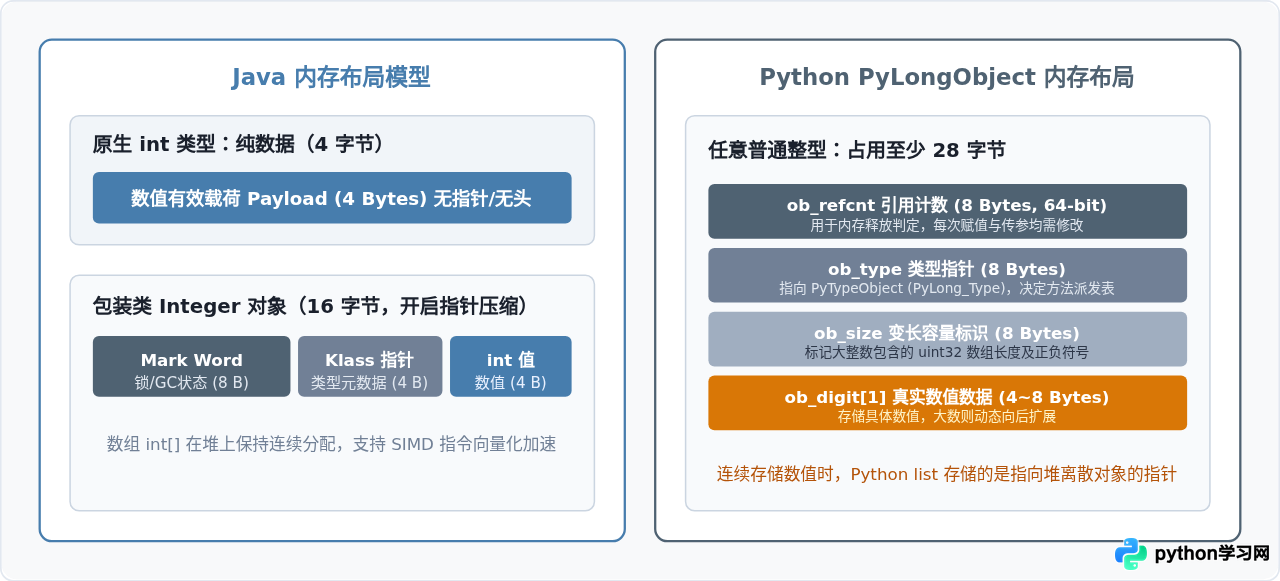
反观标准 Python 解释器(CPython),则采用纯粹的虚拟机解释循环。.py 脚本被解析为 AST 抽象语法树后生成 .pyc 字节码,但该字节码不会被直接编译为机器码。CPython 核心是一个名为 ceval.c 的巨大主循环(_PyEval_EvalFrameDefault),内部维护着一个包含数百个分支的 switch-case 结构。CPU 执行 Python 程序时,每读入一条字节码指令,就需要经历一次查表判断、解包参数、调用内部 C 函数、打包返回值、最后递增程序计数器的繁重流程。这种逐条分发的间接跳转开销(Branch Misprediction 与额外调用栈开销)始终伴随着整个运行周期。
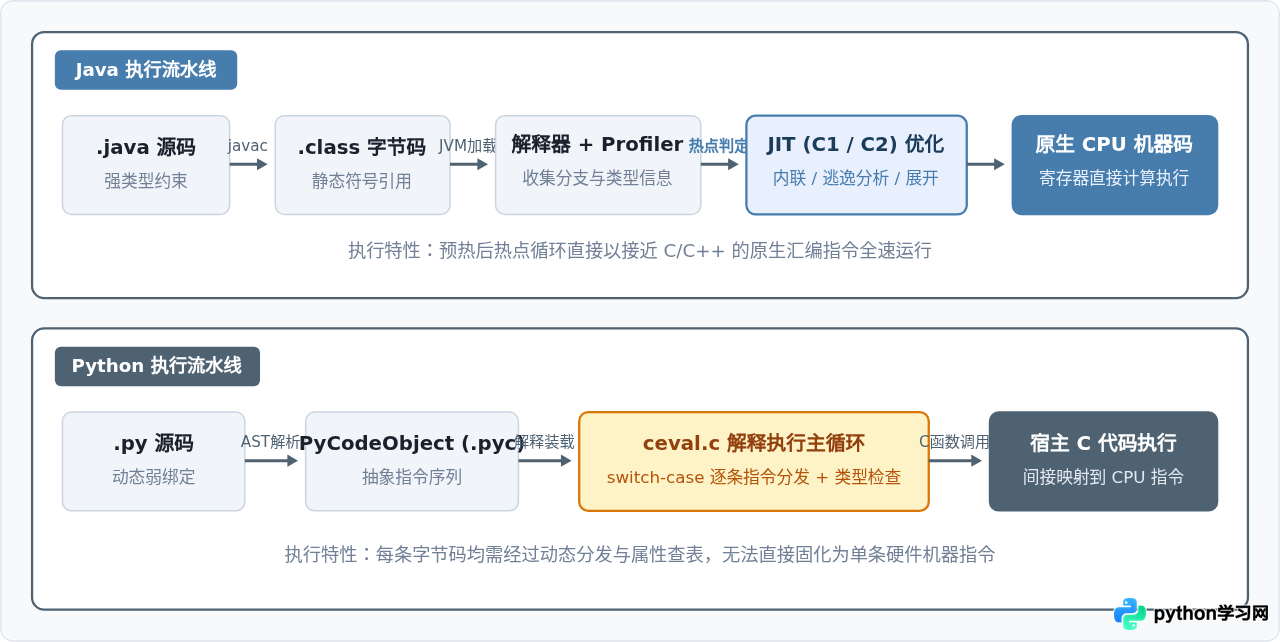
运行时机制:HotSpot JIT 深度优化与 CPython 的执行开销
为了直观说明 JIT 为何能产生数十倍的性能差距,可以通过一个极其常见的累加循环来进行代码层面的量化对比:
// Java 代码片段
long sum = 0;
for (long i = 0; i < 100_000_000L; i++) {
    sum += i;
}
在 Java 中,当 HotSpot 的 C2 编译器介入后,会进行方法内联与循环向量化/消除。C2 能够直接将循环变量 i 和累加值 sum 映射到 CPU 的物理通用寄存器(如 RAX 和 RCX)中,整个循环体在机器码级别被精简为纯粹的寄存器加法与条件跳转指令:
;; C2 生成的原生汇编片段示意 (x86-64)
.LOOP:
    add    %rcx, %rax       ; sum += i
    inc    %rcx             ; i++
    cmp    $0x5f5e100, %rcx ; 比较 100,000,000
    jl     .LOOP            ; 小于则跳回循环开头
上述循环耗时通常在几十毫秒级别。而在 Python 中书写等效代码:
# Python 代码片段
total = 0
for i in range(100_000_000):
    total += i
在 CPython 解释器中,这个看似平平无奇的 total += i 实际上触发了以下一系列繁重的底层动作:
- 在每一次迭代中,从
range迭代器获取下一个对象,该操作涉及 C 语言级别的虚函数式指针调用。 - 获取到
i与total的引用,二者均为堆上的PyLongObject结构体指针。 - 进入
binary_op1处理函数,执行类型检查,确认两个操作数是否支持加法协议。 - 从旧的
PyLongObject中读取数字有效载荷,执行底层加法,并分配一个新的PyLongObject内存空间容纳计算结果。 - 递减原
total对象的引用计数,若为 0 则触发垃圾回收释放流程;递增新分配对象的引用计数并绑定回局部变量表。
这导致 Python 在每次循环中不仅要承受解释器分发指令的固定开销,还伴随着连续的内存堆分配与引用计数维护。因此在纯 CPU 数值循环中,Python 的耗时往往是 Java 的数十倍。
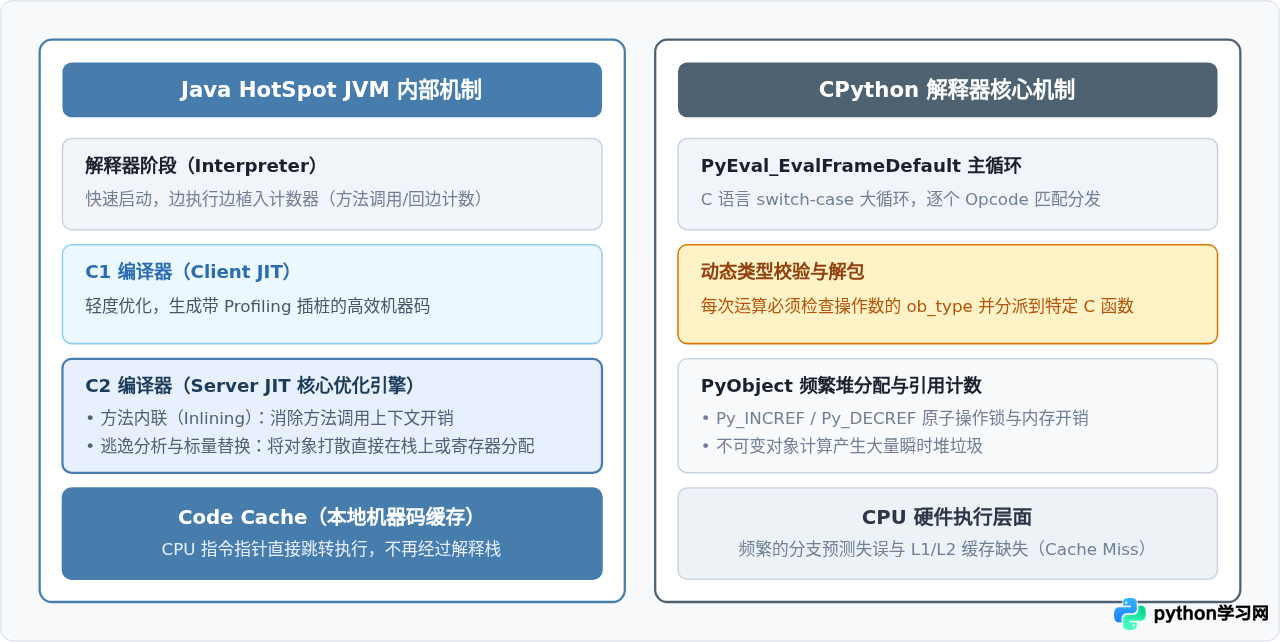
对象模型与内存布局:连续内存 vs 堆指针间接寻址
内存结构对现代硬件的吞吐性能有着决定性影响。CPU 读取连续内存时的吞吐量远高于沿着指针链漫游。在内存模型设计上,Java 与 Python 存在显著差异:
1. 原生数值与对象包装开销
Java 区分了基本数据类型(Primitive Types)与引用数据类型(Objects)。一个基础的 int 变量直接占用 4 个字节,存放在栈帧或连续数组中,没有任何附加头部信息。即使包装为 Integer 对象,在 64 位 JVM(启用指针压缩)下,对象头包含 8 字节的 Mark Word 与 4 字节的 Klass 引用,加上 4 字节的整型数据,正好是紧凑的 16 字节对齐内存。
在 Python 中,遵循“万物皆对象”原则,没有基本类型。哪怕是最简单的整数 1,在 64 位 CPython 下也是一个完整的 PyLongObject 结构体:
ob_refcnt(引用计数):占用 8 字节。ob_type(指向类型对象int的指针):占用 8 字节。ob_size(记录数据有效数字段长度):占用 8 字节。ob_digit[1](用于支持任意精度的动态数组元素):占用 4 字节。
经过内存对齐后,一个普通的 Python 整数占用 28 个字节。而在存储大量数值时(如数组),Java 的 int[] 是一段连续密集的物理内存,而 Python 的 list 存储的则是指向离散 PyLongObject 的指针数组。这不仅带来了 7 倍以上的内存消耗,更导致 CPU 预取指令无法生效,引发严重的 L1/L2 CPU 缓存未命中(Cache Miss)。
类型系统与方法分发:静态确定性 vs 动态哈希查找
在方法调用与属性访问机制上,静态类型与动态类型的底层差异构成了第二道性能分水岭:
Java 的编译期布局与虚方法表(vtable)
Java 是静态类型强类型语言。每个类在编译期就明确了成员变量的精确字节偏移量(Offset)。在访问对象的成员变量时,底层机器码只需执行基址加偏移指令(如 MOV RAX, [RDI + 16]),几乎是瞬时完成的。对于多态虚方法调用(invokevirtual),JVM 通过预先构建的虚方法表(vtable)实现常数时间 \(O(1)\) 的函数指针间接寻址;当 JIT 发现该方法在运行时几乎没有多态派生(单态内联缓存 Monomorphic Inline Cache)时,更会直接消除调用跳转,将方法体直接内联展开。
Python 的动态属性字典与方法解析顺序(MRO)
Python 是极具灵活性的动态语言,对象可以在运行时任意挂载或删除属性。这种动态性背后的机制是:Python 对象的实例属性默认保存在一个底层的哈希表字典(__dict__)中。每次访问 obj.attr 时,解释器都需要执行以下流程:
- 在当前实例的
__dict__中根据字符串计算哈希并进行键值查找。 - 若未命中,则顺着对象的类继承层次结构,沿 MRO(Method Resolution Order)链条在类字典及父类字典中层层遍历查找。
- 若找到的是函数对象,还需将其绑定为
Bound Method临时对象,再将self作为第一个参数传入调用。
尽管现代 Python 引入了全局方法缓存、快速字典查找与属性槽(__slots__)优化,但相比于静态编译确定的硬件偏移指令,动态字典哈希碰撞探测与类型动态判定仍然要慢上一到两个数量级。
多线程并发模型:OS 原生线程 vs 全局解释器锁(GIL)
现代服务器普遍具备数十个物理 CPU 核心。程序能否有效释放多核并行计算能力,直接决定了宏观处理吞吐量。
Java 的并发模型:在主流操作系统(Linux、Windows、macOS)中,Java 线程(java.lang.Thread)与操作系统的内核线程以 1:1 形式直接映射。JVM 完全依赖操作系统内核的抢占式调度器来分配物理 CPU 核心。当启动 8 个计算线程在 8 核机器上并发运算时,每个线程均能跑满一个独立核心,总体算力可以实现接近 8 倍的线性缩放。配合 JMM(Java Memory Model)的 volatile 内存屏障与底层硬件原语(如 CMPXCHG 无锁 CAS 操作),Java 能够在微秒级实现多线程高并发数据同步。
Python 的 GIL 限制:标准 CPython 解释器在内部实现了一把大粗粒度的互斥锁——GIL(Global Interpreter Lock,全局解释器锁)。为了保证 CPython 内部复杂的 C 扩展内存管理与 ob_refcnt 引用计数的线程安全,GIL 要求:在任意给定的时刻,同一解释器进程内只允许单个线程持有 GIL 并执行 Python 字节码。即使在一台拥有 64 核心的顶级服务器上启动 64 个 Python 线程进行数值密集运算,这些线程也只能交替抢占该锁,甚至会因为频繁的线程上下文切换与锁争夺,导致多线程性能低于单线程!
1. I/O 密集型任务:如网络请求、数据库查询、磁盘读写。Python 线程在触发系统底层 I/O 调用时会主动释放 GIL,等待系统中断,因此利用
asyncio 或线程池可高效承载高并发网络连接。
2. C/C++ 原生扩展算子:如 NumPy、PyTorch、OpenCV。这类计算库在进入底层矩阵乘法或张量计算等繁重算子前,会通过 C 接口显式释放 GIL,直接调用 OpenMP 或 MKL 多线程库在原生多核上全速运行。
关键性能指标与架构设计总结
为了让不同场景下的选型判断更为直观清晰,下表归纳了两者的核心运行参数与机制对比:
| 对比维度 | Java (HotSpot JVM) | Python (CPython) | 性能影响结论 |
|---|---|---|---|
| 代码执行形态 | 字节码 + JIT 编译生成原生硬件机器码 | 虚拟机逐条解释执行字节码(ceval.c 循环) | 热点纯计算性能 Java 领先 10~50x |
| 类型确定时机 | 静态编译期确定,支持内联与直接寻址 | 动态运行时判定,依赖哈希字典查找 | Java 变量读写及调用直接映射为寄存器/偏移指令 |
| 基础数据内存开销 | 基本类型 4/8 字节紧凑分配,连续数组布局 | 万物皆对象,整数 28 字节起步,指针间接寻址 | Java 内存占用小,CPU 缓存命中率极高 |
| 垃圾回收机制 | 高级分代垃圾回收器(ZGC / Shenandoah / G1) | 引用计数为主,分代标记清除兜底循环引用 | Java 高吞吐、低停顿,Python 频繁维护计数值 |
| 多核并发能力 | 1:1 内核线程映射,真多核并行计算 | 受制于 GIL,单进程内同一时刻仅单核执行字节码 | CPU 密集型多线程任务 Java 具备线性算力扩展 |
| 冷启动与环境开销 | JVM 类加载器与 JIT 预热较慢,常驻内存较大 | 毫秒级瞬时启动,脚本轻量快捷 | 命令行工具、Serverless 函数 Python 体验更优 |
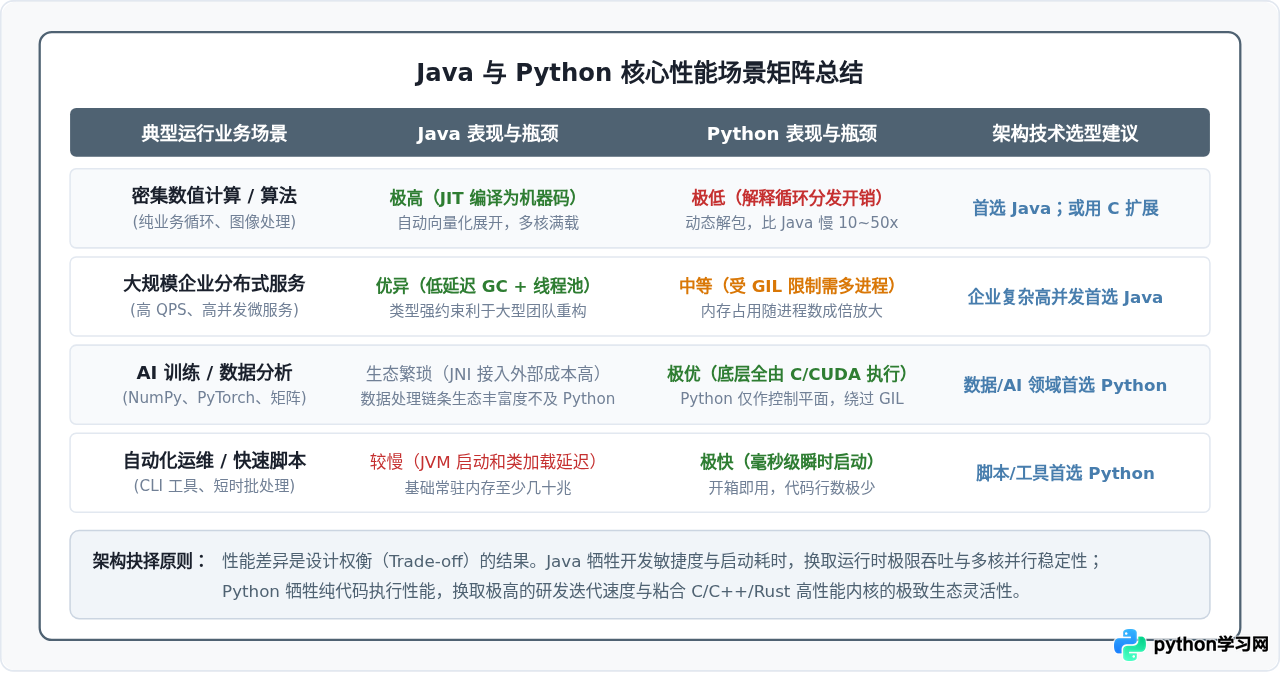
结论与工程启示
理解 Java 与 Python 的性能差异,关键在于看到性能背后的系统级工程权衡:
- Java 的高性能源自“严谨约束”:强类型系统允许编译器在生成机器码时做出激进的内联与寄存器分配,连续内存布局消除了 CPU 缓存缺页,原生多线程模型提供了真正的硬件并行能力。
- Python 的高效率源自“极度自由”:万物皆对象与动态字典查找赋予了开发者极其简洁表达复杂逻辑的能力。当性能遇到瓶颈时,现代 Python 的标准工程解法并非死守原生纯循环,而是利用其强大的胶水特性,将计算密集型内核下沉到 C/C++ 或 Rust(如 NumPy、Polars、PyTorch),让 Python 专心充当高层调度器。
在实际系统架构中,两者的优势往往能够互补协作:使用 Java 构建高并发、重计算、长周期的核心业务服务与网关链路,使用 Python 承接算法探索、数据分析管道与快速原型验证,从而在工程效率与硬件性能之间取得最佳平衡。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















