


Python怎么实现模糊字符串匹配:difflib与fuzzywuzzy应用
详细解析Python中实现模糊字符串匹配的两种核心工具:标准库difflib与第三方库fuzzywuzzy。深入剖析其计算原理、核心函数用法、典型场景对比以及中文文本与大数据量处理时的工程优化建议。
==)与包含匹配(in)失效。Python解决模糊字符串匹配主要有两条成熟路径:无需安装任何依赖的内置标准库 difflib,以及基于编辑距离并提供高级分词重组策略的第三方库 fuzzywuzzy。本文将通过具体算法原理拆解、函数调用步骤、实测对比与工程实践,系统解答如何选择与使用这两种工具。
一、认识模糊字符串匹配与核心痛点
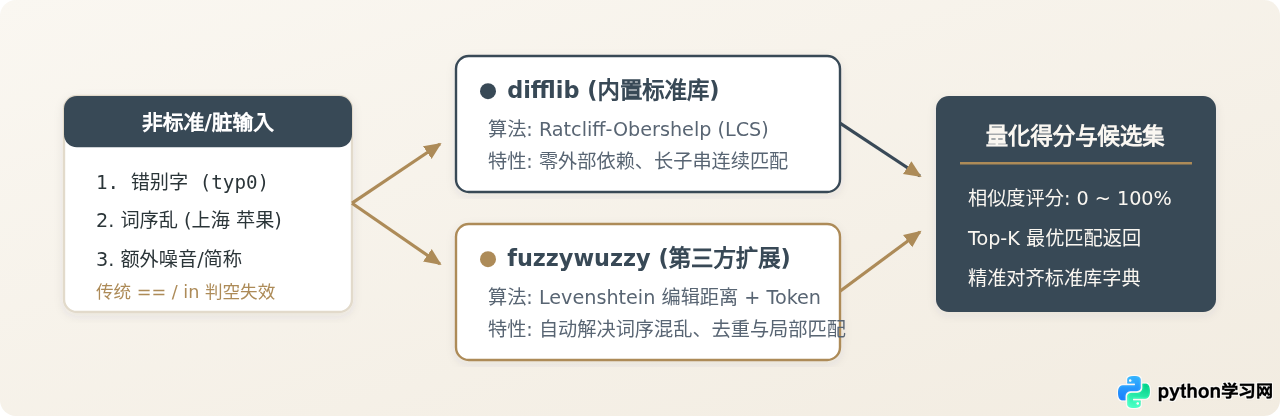
在数据清洗、用户检索推荐、商品名称去重或地址规范化等任务中,原始文本很少是完全规整的。两串文本可能指代同一个实体,却因为微小的拼写差异或格式不同,导致程序无法直接匹配:
- 字符拼写失误:如将
python误输入为pyhton,或输入中夹杂了空格与下划线。 - 词序发生倒置:例如
北京市朝阳区与朝阳区北京市,人类一眼能识别为同个地点,但在计算机逐字逐字符比对时,相等判定直接返回False。 - 包含多余噪声或子串包含:例如目标库记录为
苹果公司,用户输入为美国苹果公司电子产品专营。
模糊匹配(Fuzzy String Matching)的本质,就是借助距离算法或序列重合度分析,度量两串字符之间的“距离”或“相似系数”(通常归一化为 0 到 1 或 0 到 100 的数值),并根据设定的置信度阈值挑选出最接近的目标。
二、Python内置库:difflib 的原理与实践
Python标准库内置了 difflib 模块,它是系统级自带的文本差异比对工具,完全无需通过 pip 安装第三方包。对于严苛限制网络安装、追求轻量级无依赖部署的项目,difflib 是天然的首选。
1. SequenceMatcher 算法原理与相似度计算
difflib.SequenceMatcher 基于 Ratcliff 和 Obershelp 提出的“格式塔模式匹配”(Gestalt Pattern Matching)算法。该算法的核心思想是:首先找出两个序列中最长的一段连续完全匹配子串,以此为锚点将前后剩余的序列递归拆分,继续寻找次长公共子串,最终统计所有匹配子序列的字符总长度。
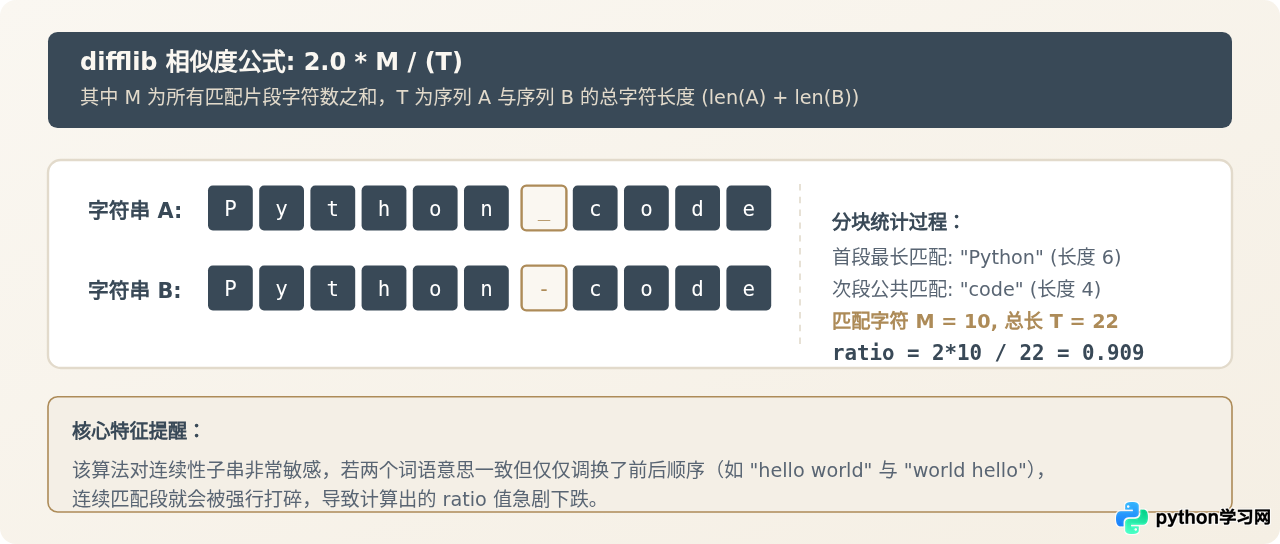
编写Python脚本使用 SequenceMatcher 测量两段文本的相似度:
from difflib import SequenceMatcher

def calculate_similarity(str1: str, str2: str) -> float:
    # 第一个参数 isjunk 用于指定忽略特定字符(如空格),通常传 None
    matcher = SequenceMatcher(None, str1, str2)
    return matcher.ratio()

score1 = calculate_similarity("Python 3.12 基础教程", "Python 3.12 实战教程")
score2 = calculate_similarity("apple banana", "banana apple")

print(f"教程相似度: {score1:.4f}")
print(f"词序颠倒相似度: {score2:.4f}")词序颠倒相似度: 0.5000
从输出可以印证:两份教程名称虽然主体一致,获得了 0.8235 的高分;而 apple banana 和 banana apple 仅仅倒换位置,由于打断了最长公共子串,分数直接腰斩至 0.5000。
2. 快速检索候选集:get_close_matches
如果需求是从一个预设的目标候选列表(如命令名、商品标签库、城市列表)中快速提取与用户输入最像的几项,difflib.get_close_matches 提供了开箱即用的高阶封装:
from difflib import get_close_matches

# 标准库列表
commands = ["install", "uninstall", "update", "upgrade", "search", "list", "freeze"]

user_input = "upgarade"  # 用户输错了字母

# 参数解释:
# word: 用户输入的查询词
# possibilities: 待匹配的候选列表
# n: 返回匹配项的最大数量,默认为 3
# cutoff: 相似度门限(0 到 1),低于此分数的候选直接剔除,默认为 0.6
matches = get_close_matches(user_input, commands, n=2, cutoff=0.5)

print("推荐匹配项:", matches)三、第三方利器:fuzzywuzzy 的原理与进阶匹配
当业务面对真实的自然语言、乱序文本或包含冗余前后缀的搜索词时,单纯依靠连续子序列比对的 difflib 就会捉襟见肘。这时通常引入更强大的第三方库 fuzzywuzzy。
fuzzywuzzy 底层利用 Levenshtein 距离(编辑距离),即把字符串 A 转换成字符串 B 所需的最少单字符编辑操作数(插入、删除、替换)。推荐在安装时附带 C 语言加速库:pip install fuzzywuzzy python-Levenshtein若未安装
python-Levenshtein,库会打印一条性能警告并降级回纯 Python 实现,计算吞吐量会下降数倍。
1. 四大核心比对函数对比
fuzzywuzzy 的核心模块是 fuzz。许多人初学时往往分不清其内置的 4 种计算函数有何区别。下表直接汇总其差异:
| 函数名 | 内部处理机制 | 适用场景 | 典型表现 |
|---|---|---|---|
fuzz.ratio |
全串标准化编辑距离计算,类似标准相似度 | 两串长度相当、字数一致的微小打字错误 | 对词序极度敏感,乱序得分低 |
fuzz.partial_ratio |
在较长串中寻找与较短串最匹配的局部切片 | 短语包含在长句中、前缀或后缀噪音多 | "apple" 与 "big sweet apple" 为 100 分 |
fuzz.token_sort_ratio |
小写化、剔除标点、按单词拆分、排序后拼接再比对 | 单词完全一致,但因语言习惯导致语序调换 | "New York Giants" 与 "Giants New York" 为 100 分 |
fuzz.token_set_ratio |
分词后求交集(Intersection)与差异集,加权比对 | 既有语序混乱,又有大量重复多余修饰词 | "apple banana" 与 "apple banana apple" 仍为满分 |
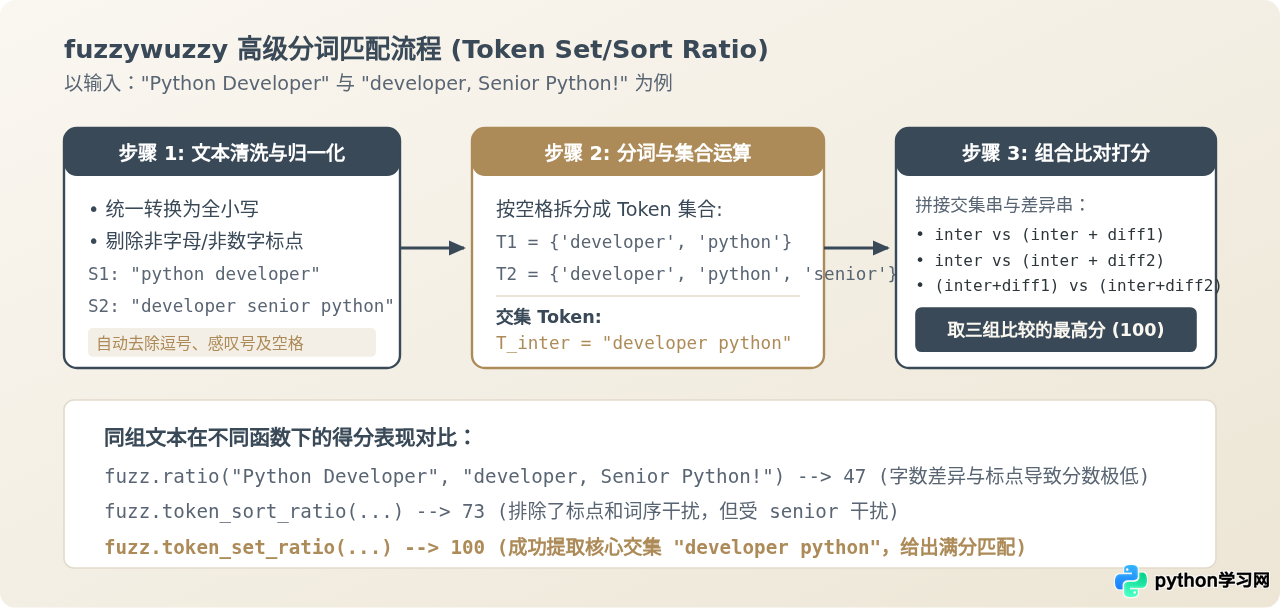
以下代码直观验证上述四种方法的输出差异:
from fuzzywuzzy import fuzz

s1 = "Python Developer"
s2 = "developer, Senior Python!"

print("1. fuzz.ratio:", fuzz.ratio(s1, s2))
print("2. fuzz.partial_ratio:", fuzz.partial_ratio(s1, s2))
print("3. fuzz.token_sort_ratio:", fuzz.token_sort_ratio(s1, s2))
print("4. fuzz.token_set_ratio:", fuzz.token_set_ratio(s1, s2))2. fuzz.partial_ratio: 56
3. fuzz.token_sort_ratio: 73
4. fuzz.token_set_ratio: 100
2. 候选列表高效检索:process 模块
除了单对单计算,fuzzywuzzy.process 提供了类似 difflib.get_close_matches 但更为智能的批量搜索工具:
from fuzzywuzzy import process

cities = [
    "北京市海淀区中关村",
    "上海市浦东新区张江",
    "广东省深圳市南山区粤海街道",
    "浙江省杭州市西湖区"
]

query = "深圳南山粤海"

# extract 会返回匹配度最高的前 n 项,结构为 (匹配文本, 相似度得分)
top_matches = process.extract(query, cities, limit=2)
print("Top-2 匹配结果:", top_matches)

# extractOne 直接提取最匹配的那一项
best_match, score = process.extractOne(query, cities)
print(f"最佳匹配项: '{best_match}', 得分: {score}")最佳匹配项: '广东省深圳市南山区粤海街道', 得分: 90
四、difflib 与 fuzzywuzzy 的关键差异与选型依据
在实际项目落地时,应该选用 difflib 还是 fuzzywuzzy?我们需要从算法机制、依赖开销、性能指标三个维度进行技术权衡。
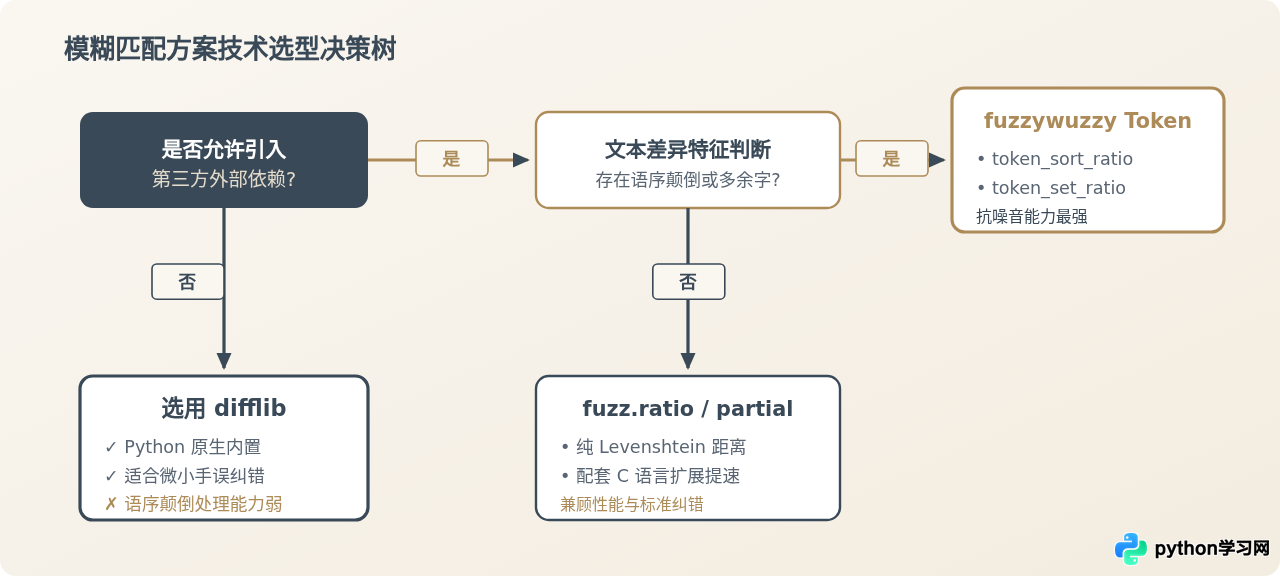
- 选择 difflib 的场景:
- 受限环境:如不允许安装任何外部 pip 依赖的基础系统脚本、无网环境。
- 版本对比与补丁生成:
difflib本身还提供了unified_diff和HtmlDiff,适合生成代码行级别的逐行比对报告。 - 候选集相对简单规整,只是防止用户拼错单字。
- 选择 fuzzywuzzy 的场景:
- 复杂现实数据清洗:如人名、公司名称、商品标题、快递地址等自由文本比对。
- 存在倒装、缩写、夹杂符号等非结构化文本场景。
- 需要高鲁棒性的语义对齐,允许安装
python-Levenshtein支撑高并发。
五、工程实战:脏数据清洗与避坑指南
在批量生产环境中应用模糊匹配时,往往会面临中文分词缺陷、大字典性能瓶颈与置信度门限设定不当等问题。以下给出一套标准的数据清洗落地架构与应对方案。
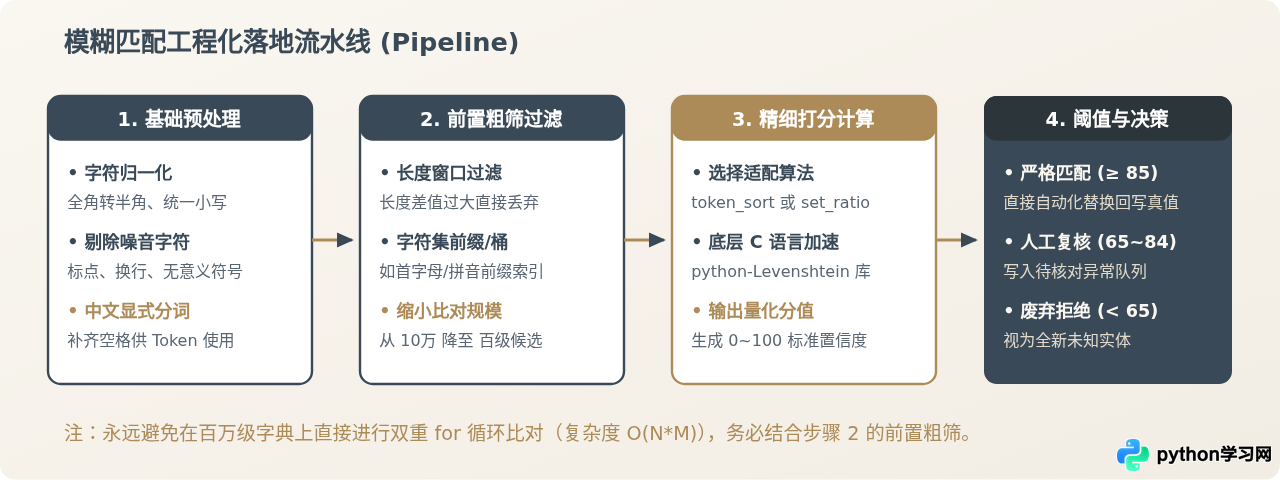
1. 注意中文文本的处理差异
fuzzywuzzy 最初面向英文设计,其 token_sort_ratio 和 token_set_ratio 默认依赖空格进行分词。在英文中单词天然由空格隔开,而中文汉字是连贯书写的。如果直接比对 "北京朝阳" 和 "朝阳北京",由于中间没有空格,整个中文词会被当作单一 Token 处理,退化为普通 ratio,导致词序重组失效。
解决方法:对中文句子使用分词工具(如 jieba)或简单的单字切分,在词与字之间插入显式空格,然后再喂给 fuzzywuzzy:
from fuzzywuzzy import fuzz

# 未拆分词空格时(退化)
print("未分词 token_sort:", fuzz.token_sort_ratio("北京朝阳", "朝阳北京"))

# 显式加入空格预处理
str1_segmented = "北京 朝阳"
str2_segmented = "朝阳 北京"
print("显式分词后 token_sort:", fuzz.token_sort_ratio(str1_segmented, str2_segmented))显式分词后 token_sort: 100
2. 百万级数据量下的性能防范
模糊匹配计算的时间复杂度通常随两串长度呈平方级($O(N \times M)$)。如果在有 5 万条待清洗记录的数据表中,直接与 1 万条标准词库做全量笛卡尔积交叉比对,计算量将达到 5 亿次,可能耗时数小时。
优化策略:
- 长度窗口粗筛:如果两个文本的长度相差数倍,它们的编辑距离必然很大。在打分前直接过滤掉
abs(len(a) - len(b)) > threshold的记录。 - 分桶(Blocking):先根据首字拼音、省份地域标签、所属品类进行强规则分组,仅在同组内执行模糊匹配。
- 现代化替代:如果性能要求极其苛刻,可以考虑使用与 fuzzywuzzy API 兼容但基于纯 C++ 深度重写的第三方库
rapidfuzz,其运行速度通常能再提升数十倍。
总结
在Python中实现模糊字符串匹配:
- 如果你只需要在无外部依赖的轻量脚本中容忍几个简单字母错拼,或者需要展示格式化文本差异,直接使用标准库 difflib(尤其是
SequenceMatcher与get_close_matches)。 - 如果你面对的是用户随意输入、存在颠倒词序、简称或多余修饰词的自然文本清洗,引入 fuzzywuzzy,配合
token_set_ratio和process.extract,同时务必安装python-Levenshtein确保计算效率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















