


Python元组和集合有什么区别?适用场景对比
详细对比Python中元组(tuple)与集合(set)在有序性、可变性、元素唯一性、底层存储结构及查询性能上的核心区别,并结合实际开发场景给出选型指南。
假设你正在编写一个物流仓储系统的核心派单模块:一方面,你需要精准记录每个运送货车在三维空间中的初始经纬度与海拔坐标 (116.4074, 39.9042, 45),这些数值必须严格按空间顺序对齐,且进入系统后绝对不允许被意外修改;另一方面,你需要实时统计今天派单覆盖的所有独立客户ID,每当新订单涌入时,要以最快速度剔除重复客户,并立即判断某特定客户是否已在派单列表中。面对这两种截然不同的数据管理要求,Python 开发者通常会分别选取引导语义的两种内置容器:元组(tuple)与集合(set)。本文将从核心定义、底层内存机制、关键操作特性以及业务选型等维度展开全面剖析,帮助读者在日常编码中做出准确的技术选型。
一、定义与基础语法区别
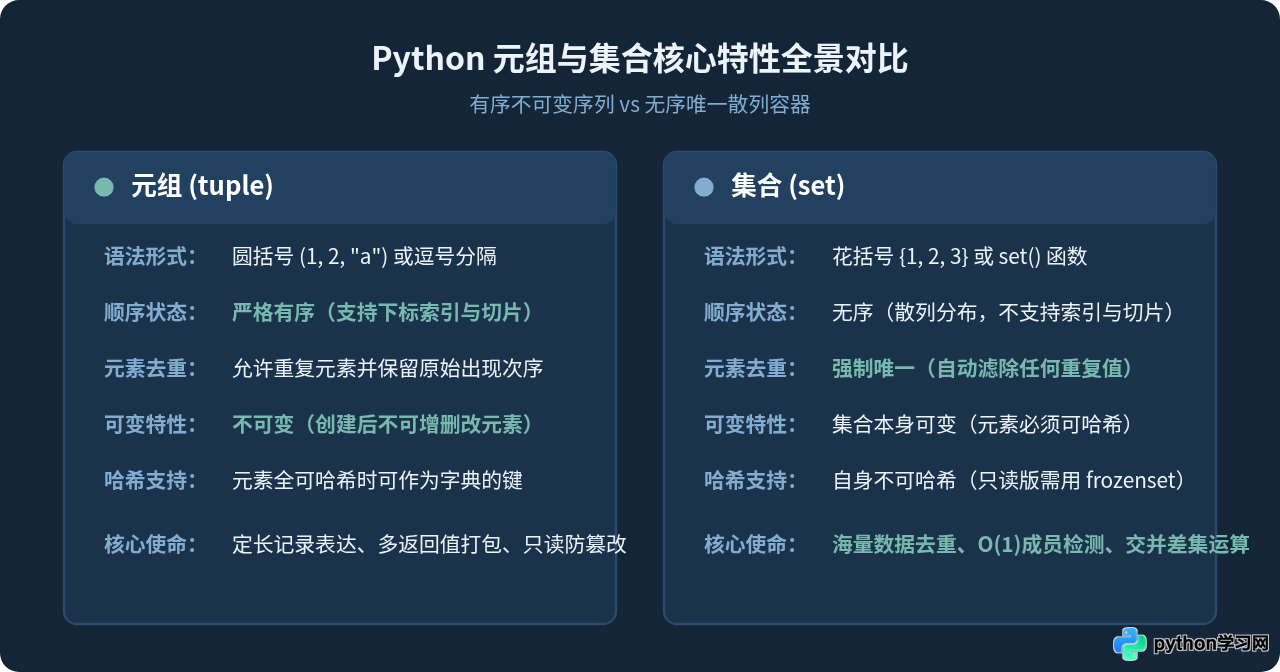
在 Python 语法层面,元组使用圆括号 () 定义,而集合使用花括号 {} 定义。但初学者容易在这里遇到两个语法陷阱:
- 单元素元组的逗号约束: 如果写
x = (42),Python 解释器只会将其视作带括号的整数表达式,其类型依然是int;必须追加逗号写成x = (42,)才能被正确识别为单元素元组。 - 空集合的初始化: 表达式
empty_val = {}创建的是一个空字典(dict),而非空集合。创建空集合必须显式调用构造函数empty_set = set()。
# 元组的创建方式
coordinates = (116.4074, 39.9042, 45)
single_tuple = (100,)        # 必须带尾随逗号,类型为 tuple
not_a_tuple = (100)          # 缺少逗号,类型为 int

# 集合的创建方式
category_tags = {"express", "cold-chain", "fragile"}
empty_set = set()            # 创建空集合的标准写法
empty_dict = {}              # 这是空字典,非集合
二、核心特性差异:顺序性、唯一性与可变性
理解元组与集合的分工,关键在于掌握以下三个维度的根本区别:
1. 有序性与索引访问
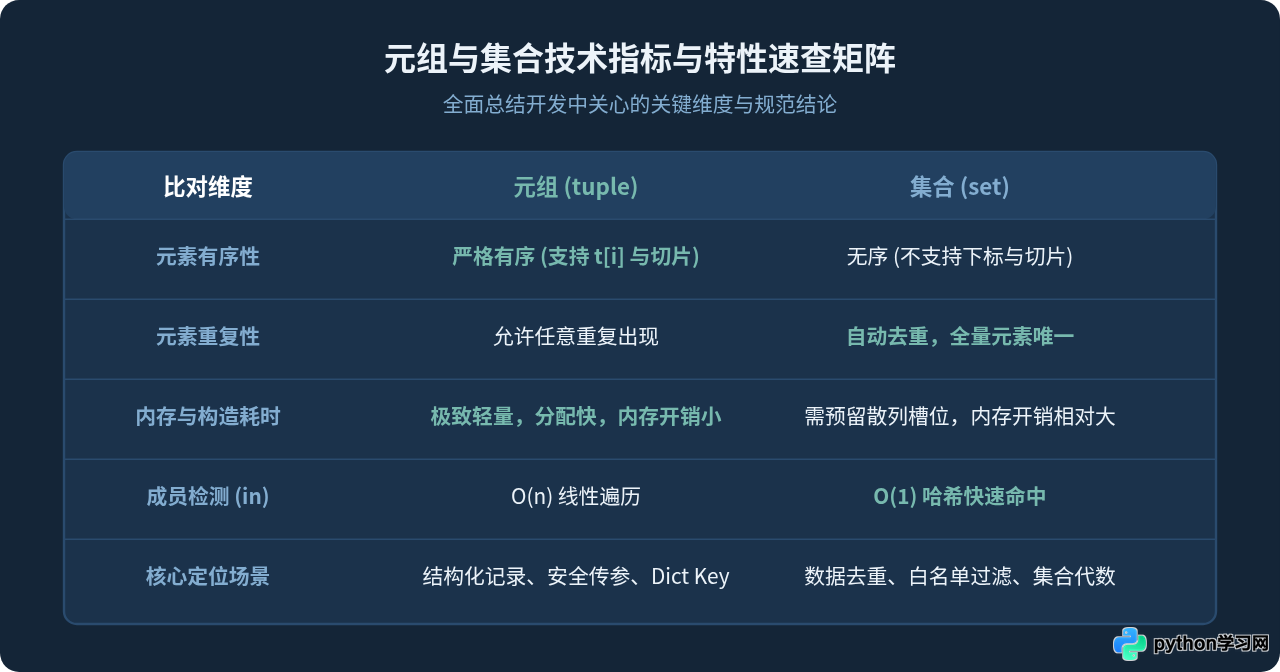
元组是有序序列(Sequence)。这意味着元素被添加到元组中的物理位置是固定的,每个元素都有明确的数字索引。开发者可以通过下标访问 t[0],也可以通过切片语法 t[1:3] 截取子序列。
集合是无序散列容器。集合内部不按插入顺序保证遍历顺序,也不为元素分配位置下标。如果尝试对集合执行索引访问,如 category_tags[0],Python 会直接抛出 TypeError: 'set' object is not subscriptable 错误。
2. 元素的唯一性与重复处理
元组忠实保留所有传入的元素,允许重复数据并记录其出现的频次;集合则天然具备去重约束,任何重复进入集合的值都会被自动合流为一个唯一项:
# 元组保留重复值
scores = (95, 88, 95, 100)
print(scores)           # 输出示例: (95, 88, 95, 100)
print(len(scores))      # 输出示例: 4

# 集合自动剔除重复值
unique_scores = {95, 88, 95, 100}
print(unique_scores)    # 输出示例: {88, 95, 100}
print(len(unique_scores)) # 输出示例: 3
3. 可变性与哈希约束(Hashable)
元组是不可变对象(Immutable),一旦初始化完成,其长度和每个位置所指向的引用就无法再增减或替换;试图执行 t[0] = 99 会抛出 TypeError: 'tuple' object does not support item assignment。正因为不可变,只要元组内部的每一个元素也是不可变的,整个元组就具备确定性的哈希值,可以安全地用作字典的 Key 或者存入集合中。
集合本身是可变对象(Mutable),可以随意调用 add() 或 remove() 添加或移除元素。由于集合可变,其哈希值随内容变化而不稳定,因此常规 set 自身是不可哈希的,不能直接作为字典的键;放入集合中的每个元素,则必须是可哈希(即不可变)对象。
三、底层存储机制与性能差异
为什么集合判断一个元素是否存在(item in container)快如闪电,而元组却在数据规模庞大时显著变慢?根源在于二者底层的 C 语言实现结构不同。
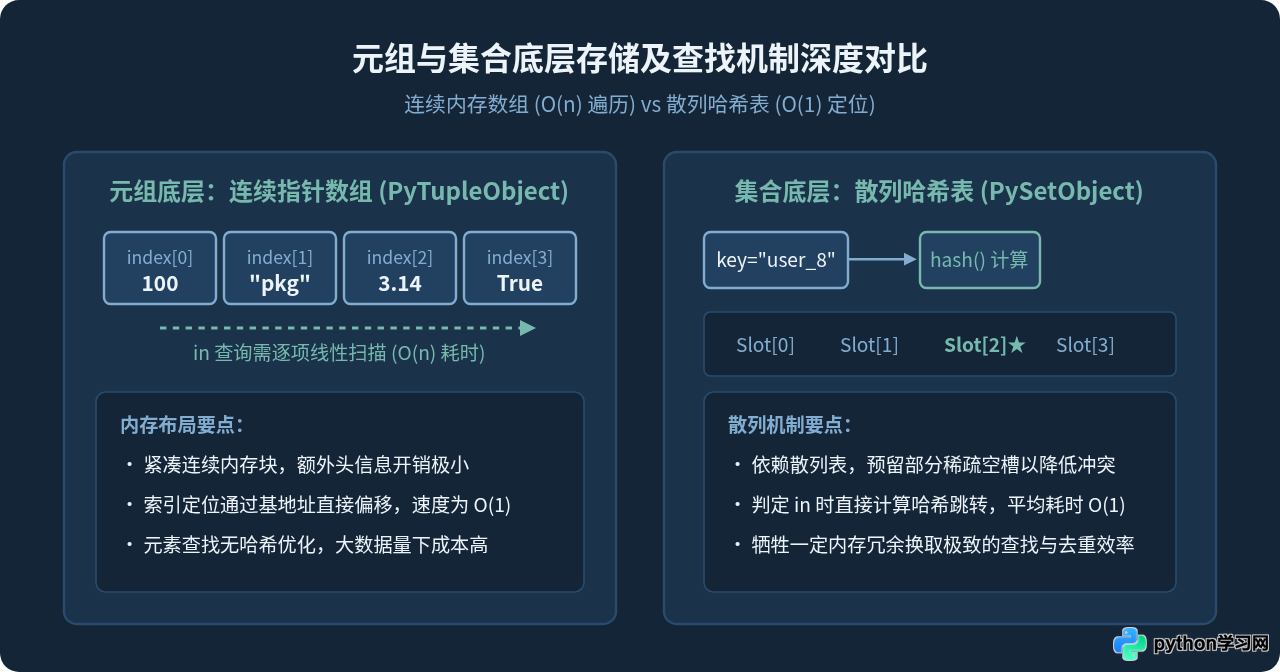
在底层实现中,元组是一个极度轻量的封装结构。由于其大小在分配时就已经固定,CPython 虚拟机可以直接在内存中开辟一段紧凑的连续指针区域。没有扩容机制,也没有多余的预留槽位,因此元组占用的内存远小于列表和集合,非常适合在内存受限或高并发场景下缓存数以百万计的只读数据。
相比之下,集合本质上是一个“只有键、没有值”的哈希表。为了保证插入和查找时近乎常数级的性能,集合必须维护一个有稀疏度的哈希槽位表。当集合元素增多、装载因子(Load Factor)达到阈值时,解释器会自动触发动态扩容并重新计算哈希映射。这种设计换来了极其卓越的高频检索效率:无论集合中存储了 10 个还是 1,000,000 个元素,执行 x in s 的平均时间复杂度均为 O(1);而元组执行 x in t 则必须从头到尾进行线性对比,时间复杂度为 O(n)。
四、集合独有的数学代数运算
集合不仅用于去重与判存,还内置了一套强大的数学集合代数运算能力。在处理权限交集、标签并集、差量补丁对比时,使用集合运算符比手动编写循环判断简洁且高效得多:
role_permissions = {"read", "write", "upload"}
admin_required = {"write", "audit", "delete"}

# 1. 交集运算 (& 或 intersection):找出两边都有的共有权限
common_perms = role_permissions & admin_required
# 运算结果: {'write'}

# 2. 并集运算 (| 或 union):合并去重后的全部权限
all_perms = role_permissions | admin_required
# 运算结果: {'read', 'write', 'upload', 'audit', 'delete'}

# 3. 差集运算 (- 或 difference):属于前者但不属于后者的专属项
exclusive_perms = role_permissions - admin_required
# 运算结果: {'read', 'upload'}

# 4. 对称差集 (^ 或 symmetric_difference):非共有的互斥项
diff_perms = role_permissions ^ admin_required
# 运算结果: {'read', 'upload', 'audit', 'delete'}
五、实际开发选型决策流程
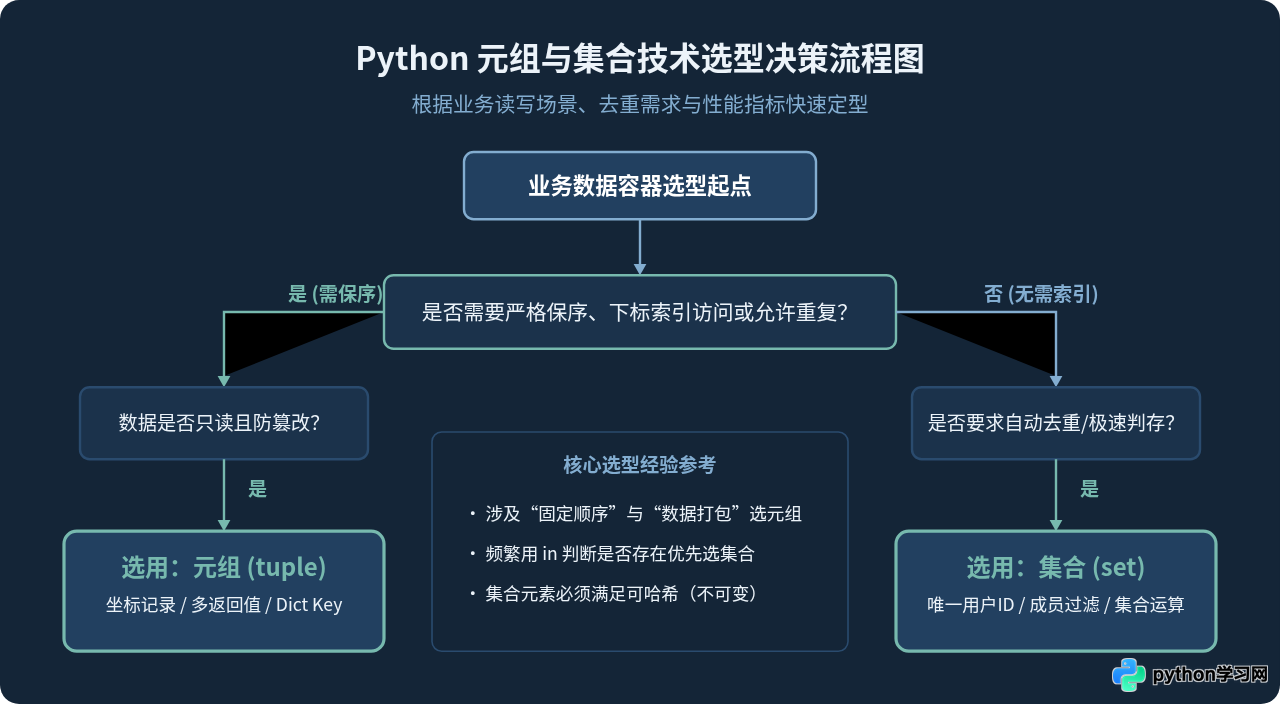
面对具体的数据存储需求,应当选用元组还是集合?我们可以依据以下技术选型逻辑进行判断:
六、典型应用场景与代码实战
1. 元组的标准适用场景
- 函数的多值返回与解构: 当一个函数需要同时返回多个计算结果时,使用元组既能保持轻量,又能通过模式解构清晰接收。
- 作为字典的复合键: 字典要求 Key 必须是可哈希对象。列表或集合无法作为键,而只包含不可变对象的元组是天然的复合键选择。
- 固定结构的只读配置项: 例如系统支持的协议端口映射
("HTTP", 80),防止在业务流转中被意外append或更改。
# 场景 1:函数多返回值解包
def parse_network_packet(raw_bytes):
    # 解析协议、源IP、目的端口,以元组形式打包输出
    protocol = "TCP"
    src_ip = "192.168.1.10"
    dst_port = 8080
    return protocol, src_ip, dst_port  # 隐式创建元组

proto, ip, port = parse_network_packet(b"...")

# 场景 2:元组作为字典的复合键
geo_database = {
    (39.9042, 116.4074): "北京市中心",
    (31.2304, 121.4737): "上海市中心"
}
target_city = geo_database.get((39.9042, 116.4074))
2. 集合的标准适用场景
- 海量数据流去重: 快速剔除批量输入或数据库抽取中的重复主键、手机号或邮箱。
- 超大规模高频成员检测(
in操作): 例如黑名单拦截、权限审查,在数以万计的记录中以常数级时间完成匹配。 - 数据状态与权限的差量对比: 对比新老两批标签的增量与删减。
# 场景 1:极速去重
raw_event_ids = [1002, 1005, 1002, 1008, 1005, 1009]
unique_ids = set(raw_event_ids)
# 快速转换回列表输出: [1002, 1005, 1008, 1009](注意:顺序可能改变)

# 场景 2:高频黑名单拦截(O(1) 效率优势)
blocked_users = {"user_99", "user_102", "bot_tester"}
def is_request_allowed(current_user: str) -> bool:
    # 相比列表或元组的遍历扫描,集合的 in 操作耗时极短且稳定
    return current_user not in blocked_users
七、常见误区与避坑指南
元组的不可变性仅指其持有的对象引用地址不可变。若元组内嵌套了列表
t = (1, [2, 3]),虽然无法对元组执行赋值替换,但可以通过 t[1].append(4) 修改列表内容。此时该元组变得不可哈希,无法再充当字典的键或放入集合中。
虽然 Python 3.7+ 保证了字典(dict)按插入顺序排序,但常规集合
set 依然是无序散列。在依赖特定遍历顺序输出的业务中,切忌直接使用集合存储有序流水,若需有序去重,可借助 dict.fromkeys(data)。
如果既需要集合的唯一性与集合运算能力,又需要将其作为字典的 Key 或者放入另一个集合中,可以使用 Python 提供的只读版本
frozenset。
八、总结
元组与集合虽然都是 Python 的核心内置容器,但各自承担着明确的技术使命:
- 当你关注数据的排列次序、需要下标索引或切片、希望防止数据被意外篡改,或者需要将多字段组合作为字典的复合键时,元组(tuple)是无可替代的选择。
- 当你关注数据的唯一性、需要剔除冗余重复值、需要应对百万级高频存在性查询(
in),或者执行交集、并集、差集等代数运算时,集合(set)则是最高效的利器。
在实际工程中,认清二者在有序性、哈希性与底层内存结构上的差异,能帮助我们写出兼具可读性、健壮性与高性能的 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















