


Python中sort()与sorted()的区别及选择指南
深入解析Python中sort()方法与sorted()内置函数的核心区别、底层原理、内存开销与选择指南,帮助开发者在不同场景下做出正确且高效的排序决策。
list.sort() 是列表独有的就地(in-place)排序方法,直接改变原列表内容,返回值为 None;而 sorted() 是 Python 的通用内置函数,可接收任意可迭代对象(如列表、元组、字典、集合等),不会修改原始数据,而是构建并返回一个排序后的全新列表。
在 Python 日常开发与数据处理任务中,排序是最基础也是使用频次最高的操作之一。很多初学者甚至有一定经验的开发者,常在“要不要保留原数据”以及“排序方法的返回值是什么”两个细节上出现疏漏。本文将围绕两者的底层机制、操作差异、参数用法、性能特点及选型场景逐一展开讲解。
一、核心机制对比:就地修改 vs 副本生成
理解 sort() 与 sorted() 的本质区别,关键在于观察排序操作执行前后,内存中对象引用的变化情况。
调用 list.sort() 时,Python 解释器在原列表分配的内存空间中重新组织元素指针,不创建新的列表对象。由于操作直接作用于原对象,为了防止开发者误认为产生了新数据,Python 设计该方法返回 None。
而调用 sorted() 时,解释器遍历输入的可迭代对象,读取其元素并放入一块新开辟的内存区域中完成排序,最终返回新列表的引用。原始对象的内容与内存地址均不受任何影响。
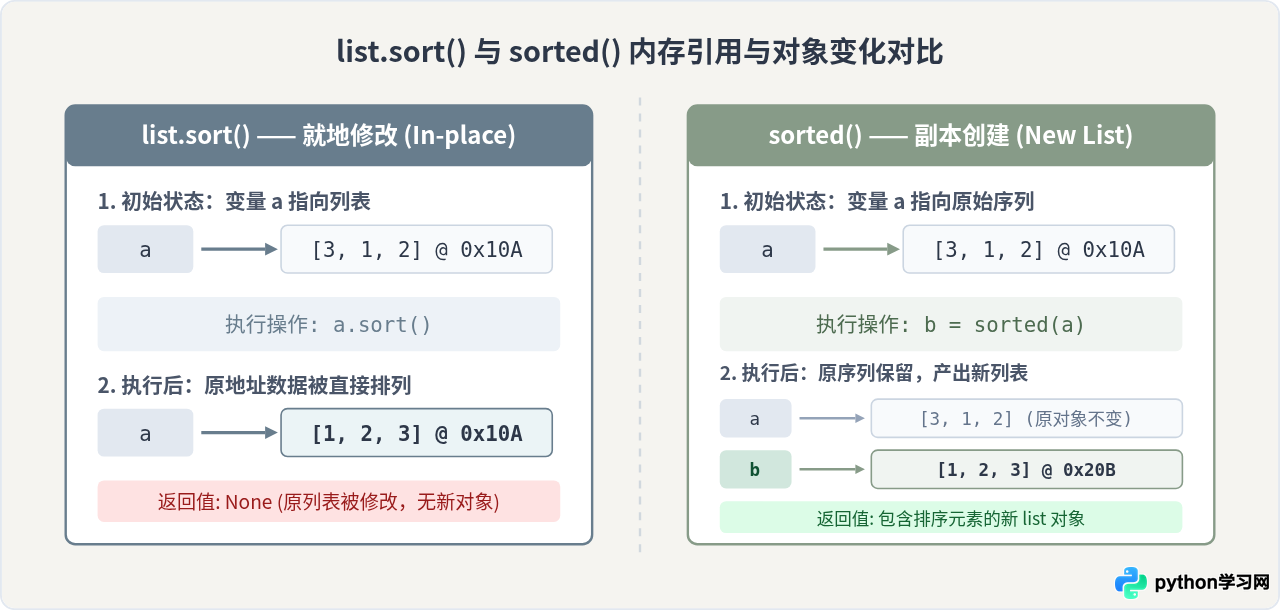
为了直观对比两者的属性和行为,下表列出了核心维度的对照:
| 比较维度 | list.sort() | sorted() |
|---|---|---|
| 类型归属 | 列表专属的实例方法 (Method) | Python 内置全局函数 (Built-in Function) |
| 支持的数据类型 | 仅限 list 类型 |
所有可迭代对象(list, tuple, dict, set, str, 生成器等) |
| 是否改变原对象 | 是(就地修改原有列表) | 否(原对象完全保持不变) |
| 返回值 | 严格返回 None |
返回排序后的新 list 实例 |
| 额外内存开销 | \(O(1)\) 辅助空间(不复制列表) | \(O(N)\) 辅助空间(存储新列表) |
| 排序参数 | key, reverse |
iterable, key, reverse |
二、list.sort() 详解:操作步骤与初学者常见陷阱
list.sort() 的设计哲学在于追求空间效率。当你的数据规模较大,且不需要保留历史顺序时,使用该方法能够避免复制列表带来的额外内存损耗。
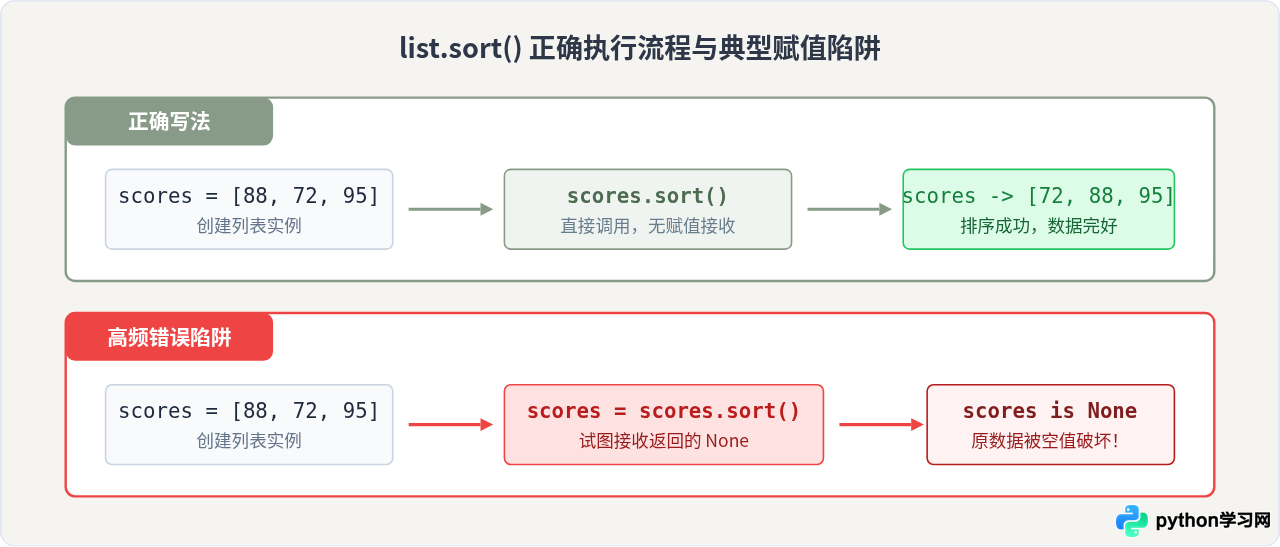
1. 正确的使用步骤
调用 sort() 仅需两步:第一步准备列表变量,第二步调用该方法更新列表自身。
# 步骤 1:定义待排序的列表
scores = [88, 72, 95, 60, 84]

# 步骤 2:直接就地排序,不要将返回值赋给变量
scores.sort()

# 验证结果:原列表已经被改变
print(scores)  # 输出: [60, 72, 84, 88, 95]
2. 最容易出现的错误:赋给原变量导致数据变为 None
许多习惯了函数式编程或字符串操作的开发者,常常下意识写出 scores = scores.sort()。由于 sort() 返回 None,这行代码会直接将 scores 覆盖为 None,导致原始数据丢失,后续操作均会抛出 AttributeError。
(1, 3, 2).sort() 或字符串 "cba".sort() 调用该方法,Python 会直接抛出 AttributeError: 'tuple'/'str' object has no attribute 'sort'。
三、sorted() 详解:多类型支持与统一输出
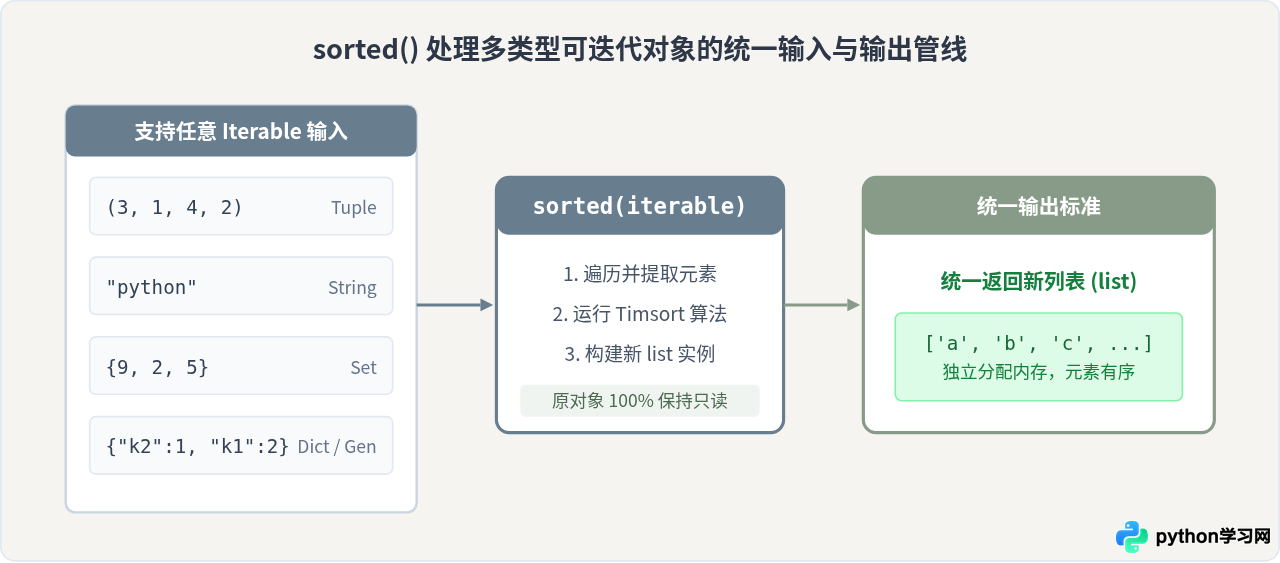
与 list.sort() 专属于列表不同,sorted() 是一个全局内置函数。任何实现了迭代协议(即支持 __iter__)的对象均可作为其输入。
无论输入是元组、字典、集合还是生成器,sorted() 内部都会依次提取元素,并在排序完成后统一封装为一个全新的列表(list)返回。
# 1. 对不可变的元组进行排序,返回新列表
nums_tuple = (10, 2, 8, 5)
sorted_from_tuple = sorted(nums_tuple)
print(sorted_from_tuple)  # [2, 5, 8, 10] —— 类型转为 list

# 2. 对字典进行排序(默认提取并排序其 key)
user_dict = {"banana": 3, "apple": 5, "orange": 2}
sorted_keys = sorted(user_dict)
print(sorted_keys)  # ['apple', 'banana', 'orange']

# 3. 对无序的集合进行排序
num_set = {40, 10, 30, 20}
print(sorted(num_set))  # [10, 20, 30, 40]
四、关键参数 key 与 reverse 的高级技巧
无论是 list.sort() 还是 sorted(),两者在自定义排序行为方面遵循完全一致的接口标准,均接收 key 和 reverse 两个关键字参数。
1. reverse 参数:控制升序与降序
默认为 reverse=False(从小到大升序)。设置为 reverse=True 时进行倒序排序:
data = [5, 1, 8, 3]
# 就地倒序
data.sort(reverse=True)  # data 变为 [8, 5, 3, 1]

# 返回全新倒序列表
rev_new = sorted(data, reverse=True)
2. key 参数:指定比较权重的投影函数
key 必须是一个接收单参数的可调用对象(函数、lambda 或方法引用)。排序算法在比较元素前,会先对每个元素调用 key 函数,并以返回的计算值作为排序依据。原元素本身不会被修改。
# 场景 A:按字符串长度排序
words = ["python", "go", "javascript", "c"]
words.sort(key=len)
print(words)  # ['c', 'go', 'python', 'javascript']

# 场景 B:处理复杂的字典列表
students = [
    {"name": "Alice", "age": 20, "grade": 88},
    {"name": "Bob", "age": 19, "grade": 95},
    {"name": "Charlie", "age": 21, "grade": 88}
]

# 依据成绩降序排序,若成绩相同则依据年龄升序排序
sorted_students = sorted(
    students,
    key=lambda s: (-s["grade"], s["age"])
)
Python 底层使用的排序算法是 Timsort(一种结合了归并排序与插入排序的高性能混合算法)。Timsort 具备稳定排序的特性:当两个元素的比较键值相等时,它们在排序后的相对前后顺序必然与排序前保持完全一致。
五、性能开销分析与工程选型指南
在工程实践中,选用 sort() 还是 sorted() 并不存在绝对的优劣,而是取决于约束条件:是需要节省内存,还是需要保护数据不变性?
1. 内存与时间开销的差异
- 内存消耗:对于一个包含 1000 万个整数的列表,
sorted()需要额外开辟大约 80MB 的内存空间来构建新列表并存放对象指针;而list.sort()几乎只需要 \(O(1)\) 的附加辅助空间。如果运行在内存资源紧缺的容器或微服务器中,且原数据不再需要,sort()能显著降低 OOM(Out Of Memory)的风险。 - 运行耗时:在纯排序计算阶段,两者的底层算法完全一致。但
sorted()多了一步“遍历迭代器构造初始列表”的动作,因此在相同数据下,list.sort()的执行速度通常略快 10%~15%。
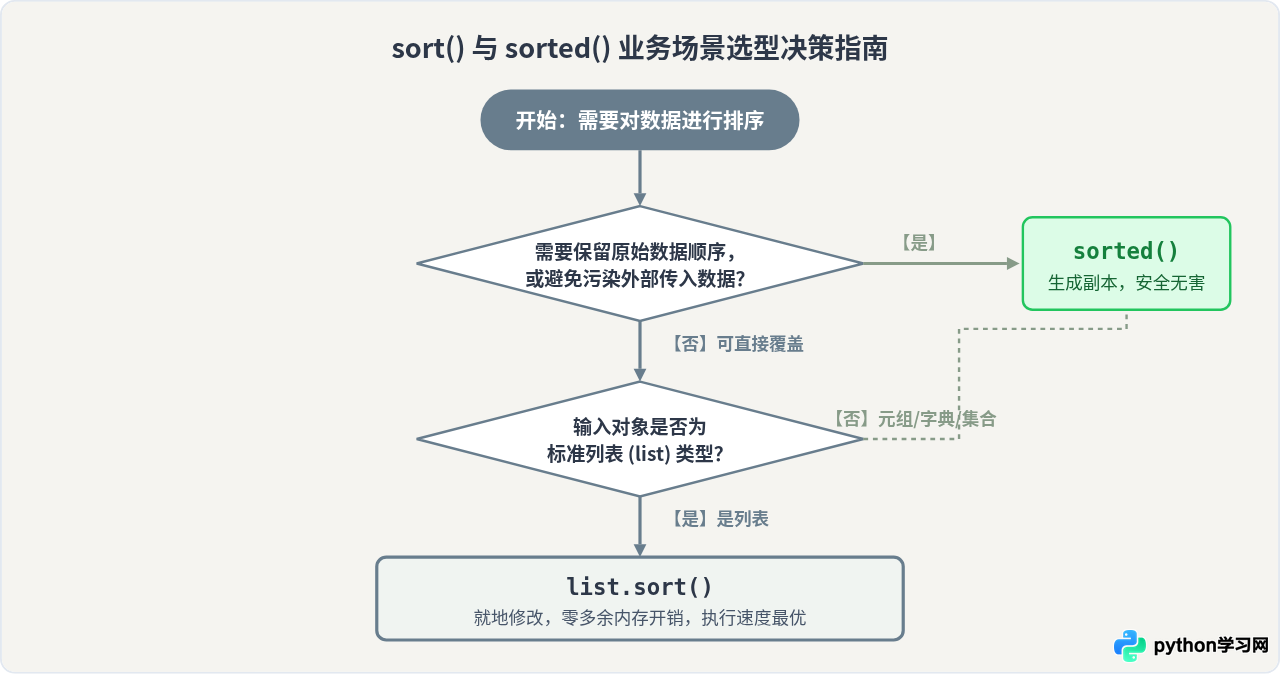
2. 选型判断依据与决策流程
为了帮助你在开发中快速抉择,可以遵循以下三个决策层级:
- 必须使用 sorted() 的硬性条件:输入对象不是
list(例如元组、集合、生成器),或者原始序列不可被篡改(如函数参数需保持只读,避免对外部调用方产生隐式副作用)。 - 优先使用 list.sort() 的条件:原始数据本来就是列表,数据量极大(数十万至数千万级),且原列表的先后顺序在业务上毫无留存价值。
- 优先考虑函数式与链式调用时:如果排序完成后需要立即结合切片或链式调用,例如
top3 = sorted(scores, reverse=True)[:3],使用sorted()代码更精炼优雅。
六、常见误区总结与避坑清单
为了在实际编码中写出更加健壮、无 bug 的排序逻辑,请牢记以下四点实践法则:
- 绝不要对
list.sort()执行赋值:切记x = x.sort()是最经典的 Python 错误写法,如果需要赋值请使用x = sorted(x)。 - 混合类型不可比异常:在 Python 3 中,严格禁止不同类型且未定义大小关系的值混合排序(例如
[1, "a", 2].sort()会抛出TypeError: '<' not supported between instances of 'str' and 'int')。如果数据中包含混合类型,必须通过key参数将其转化为统一可比较的形式。 - 避免在循环内部重复对大序列使用 sorted():如果每次循环都产生一个全新的列表副本,会频繁触发垃圾回收(GC),造成不必要的性能抖动。对于循环中的稳定列表就地更新,优先考虑
sort()。 - 注意字典排序的默认行为:对字典直接调用
sorted(dict)只会排序键(keys)。若需按值排序,应当使用sorted(dict.items(), key=lambda x: x[1])。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















