


Python字典取值的5种常用方法:[]、get与setdefault详解
深入详解Python字典取值的5种常用方法:下标操作符[]、get()方法、setdefault()方法、collections.defaultdict以及try-except异常捕获,从语法规范、底层机制到典型应用场景全面对比解析。
[]、安全兜底的 get() 方法、兼具初始化特性的 setdefault() 方法、集合模块提供的 collections.defaultdict,以及依托 EAFP 哲学的 try...except KeyError 异常捕获机制。本文将逐一拆解这 5 种方法的语法规范、执行过程与适用边界,帮助开发者在编码时做出清晰高效的选择。
一、方括号下标访问(d[key]):直接高效的强约束方式
方括号语法 d[key] 是 Python 中最基础也是最直观的字典取值方式。它通过 Python 虚拟机底层的 BINARY_SUBSCR 字节码直接触发字典内部的哈希检索逻辑,执行速度极快。
1. 基础用法与代码示例
当目标键确定存在于字典中时,方括号访问是最推荐的书写方式。代码语义直接,没有任何多余的函数调用开销:
# 运行环境:Python 3.8+
user_info = {
    "username": "alex_99",
    "role": "admin",
    "login_count": 42
}

# 通过中括号直接提取已有键的值
current_role = user_info["role"]
print("角色名称:", current_role)2. 局限性与风险:KeyError 异常
方括号访问是一种“强假定”机制——它预设待查询的键一定存在。如果字典中不存在该键,Python 将立即中断执行并抛出 KeyError 异常:
# 访问不存在的键
try:
    email = user_info["email"]
except KeyError as e:
print("捕获到异常:", repr(e))二、dict.get() 方法:防御式只读取值的标准方案
为了规避 KeyError 导致的程序中断,Python 字典原生提供了 get() 方法。它是编写防御式只读代码时使用频次最高的方案。
1. 语法结构与默认值处理
d.get(key, default=None) 接收两个参数:第一个参数为待查询的键;第二个参数为当键不存在时返回的替补默认值。如果省略第二个参数,则默认返回 None:
profile = {
    "name": "Elena",
    "city": "Shanghai"
}

# 场景 A:键存在,返回真实值
city_val = profile.get("city", "Unknown")

# 场景 B:键不存在,未指定默认值,返回 None
age_val = profile.get("age")

# 场景 C:键不存在,显式指定默认值
country_val = profile.get("country", "China")

print("city:", city_val)
print("age:", age_val)
print("country:", country_val)
print("原字典状态:", profile)age: None
country: China
原字典状态: {'name': 'Elena', 'city': 'Shanghai'}
2. 核心特征:纯只读操作
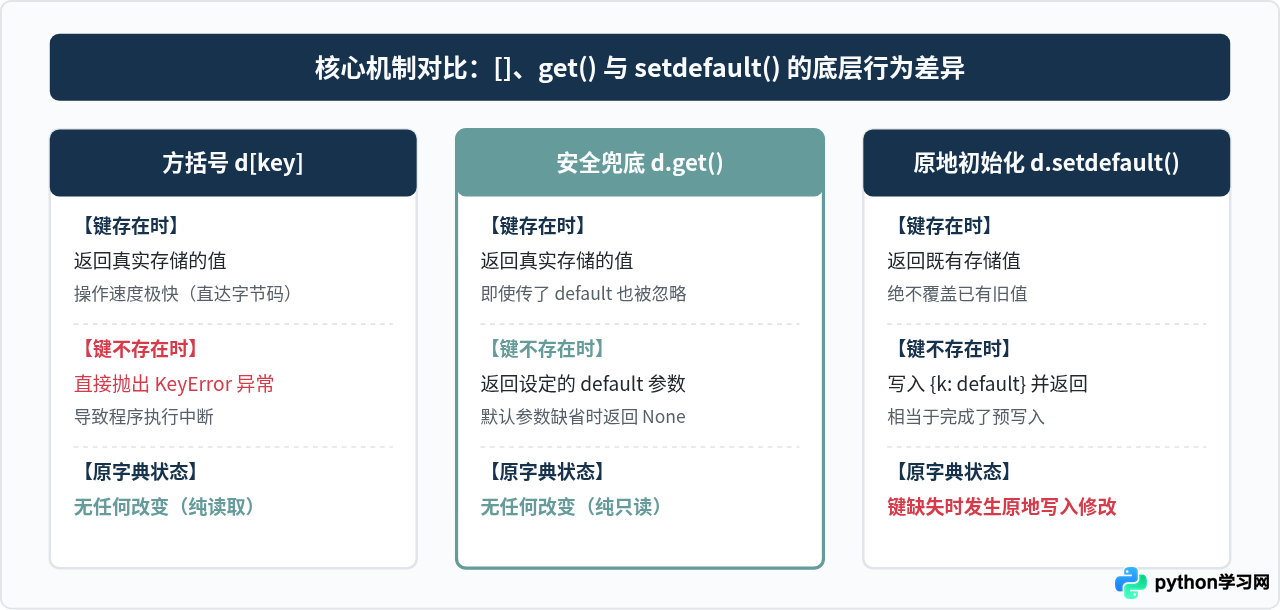
get() 方法无论触发何种默认值返回,都不会在原字典中新增该键值对。如上例所示,查询 profile.get("country", "China") 之后,原字典 profile 中依然只包含 name 和 city 两个键,完全保持原貌。
3. 常见易错点:默认值与真实空值的混淆
需要特别注意:当字典中某个键的值本身恰好就是 None、0 或空字符串 "" 时,不能仅仅依靠 get(key) is None 来断定键是否存在:
status_data = {"retry_count": 0, "extra_info": None}

# 此时键存在,但对应值为 None
res = status_data.get("extra_info", "default_val")
print("返回结果:", res)  # 返回的是真实值 None,而不是 default_val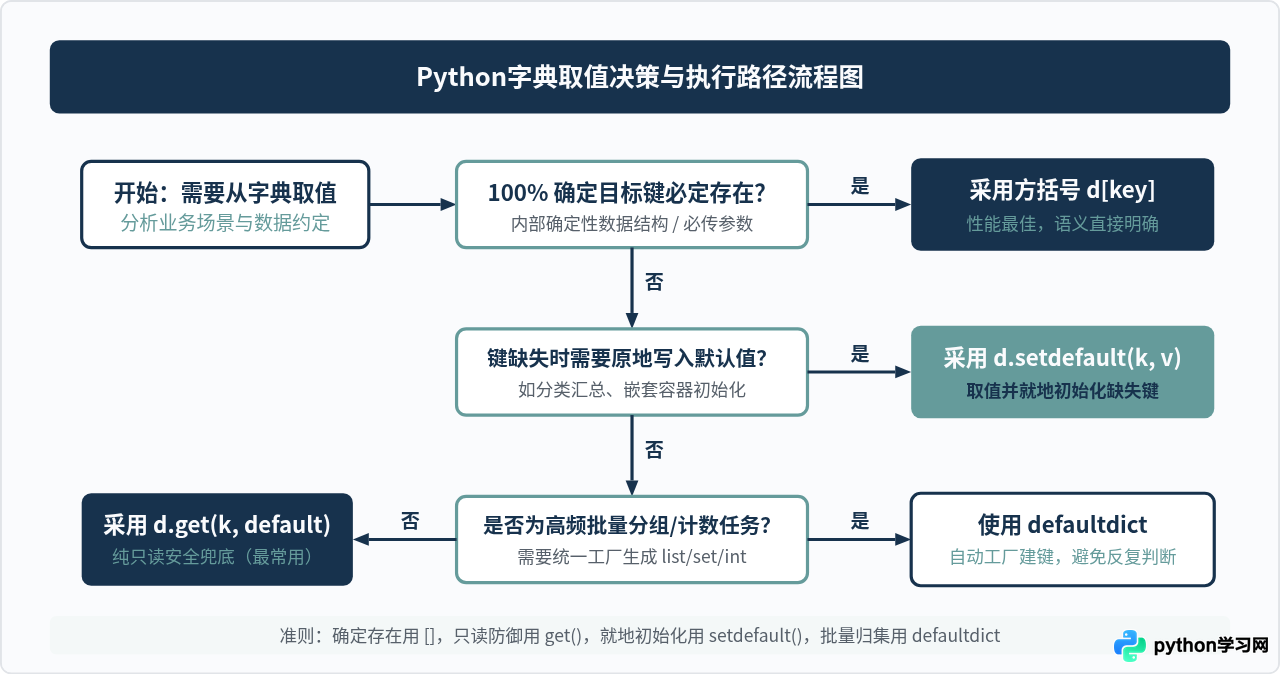
三、dict.setdefault() 方法:兼具“读”与“写”的初始化神器
很多开发者初学时容易混淆 get() 和 setdefault()。虽然两者的调用形式都包含 key 和 default 参数,但它们的底层行为和副作用完全不同。
1. 核心运行机制
d.setdefault(key, default=None) 的行为逻辑由两部分组成:
- 若 key 存在:直接返回字典中该 key 原本对应的 value,不作任何修改(即使 default 参数传了新值,也不会覆盖旧值)。
- 若 key 不存在:立即将
{key: default}插入到原字典中,并返回这个default。
2. 实战代码:分类归集应用
在需要对列表数据按类别进行分桶(分组)时,setdefault() 能大幅简化“判断键是否存在、不存在则初始化空列表、最后执行追加”的冗长步骤:
orders = [
    {"category": "Fruit", "item": "Apple"},
    {"category": "Meat", "item": "Beef"},
    {"category": "Fruit", "item": "Banana"}
]

catalog = {}
for order in orders:
    cat = order["category"]
    product = order["item"]
    # 如果 cat 不存在,则自动存入 [] 并返回该引用;若存在,则直接返回已有引用
    catalog.setdefault(cat, []).append(product)

print("分类归集结果:", catalog)3. 注意陷阱:默认值参数的预求值开销
需要特别警惕的是,Python 在执行函数调用时,会先计算传入的实参表达式。这意味着如果你书写形如 d.setdefault(key, expensive_computation()),无论该 key 是否已经存在,expensive_computation() 都会被执行一次,可能带来不必要的计算开销。
四、collections.defaultdict:容器级别的工厂初始化方案
当字典被用于复杂数据聚合、嵌套列表组装或高频词频统计时,即使使用 setdefault() 也会显得冗长,而且存在参数预求值的开销。标准库提供的 collections.defaultdict 则是更高阶的解决方案。
1. 运作原理与构造方式
defaultdict 继承自原生 dict,并在构造时接收一个无参的可调用对象(工厂函数,如 list、int、set 或自定义 lambda)。当使用下标 d[key] 访问一个不存在的键时,它会自动调用该工厂函数生成默认值,将键值对存入字典,并返回该值:
from collections import defaultdict

# 指定工厂函数为 int,键不存在时自动调用 int() 生成 0
counter = defaultdict(int)

words = ["python", "dict", "python", "defaultdict", "dict", "python"]
for w in words:
    # 首次访问 w 时自动初始化为 0,然后直接 +1
    counter[w] += 1

print("统计结果:", dict(counter))2. 使用注意事项
defaultdict 的便利性是一把双刃剑:任何只读的查询都会变成插入。例如,单纯执行 val = counter["unknown_word"] 就会导致 "unknown_word": 0 被持久化到字典中。若后续需要将其序列化为 JSON,建议先通过 dict(counter) 转回普通字典。
五、try...except KeyError:面向异常的高性能分支处理
在 Python 核心设计理念中,有一条广为人知的原则:EAFP(Easier to Ask for Forgiveness than Permission,请求原谅比请求许可更容易)。基于 try...except KeyError 的模式正是该思想在字典取值上的典型体现。
1. 模式实现与适用场景
如果业务逻辑中预估 95% 以上的情况下目标键都是存在的,先通过 try 执行方括号下标访问,在极其罕见的键缺失时捕获 KeyError 进行补偿,是性能最高、最地道的写法:
config_cache = {"timeout": 30, "max_connections": 100}

def get_setting(key_name, fallback_value):
    try:
        # 正常执行路径:绝大多数情况直接命中,没有任何多余判断与函数调用
        return config_cache[key_name]
    except KeyError:
        # 异常分支:仅在偶发键缺失时触发
        return fallback_value

print("读取已有配置:", get_setting("timeout", 10))
print("读取缺省配置:", get_setting("debug_mode", False))读取缺省配置: False
2. 性能分水岭说明
在命中正常路径时,try...except 的开销与直接使用 [] 几乎无异,明显快于 get() 的方法查找开销;但一旦键缺失频率升高,Python 创建和回溯异常对象的开销将呈指数级增加。因此:高频命中选 try-except,高频缺失选 get()。
六、进阶场景:多层嵌套字典的安全取值实战
在解析复杂的网络 JSON 数据、微服务配置或日志载荷时,经常会遇到形如 data["user"]["profile"]["address"]["zipcode"] 的多层嵌套字典结构。
1. 连续 get() 的空指针陷阱
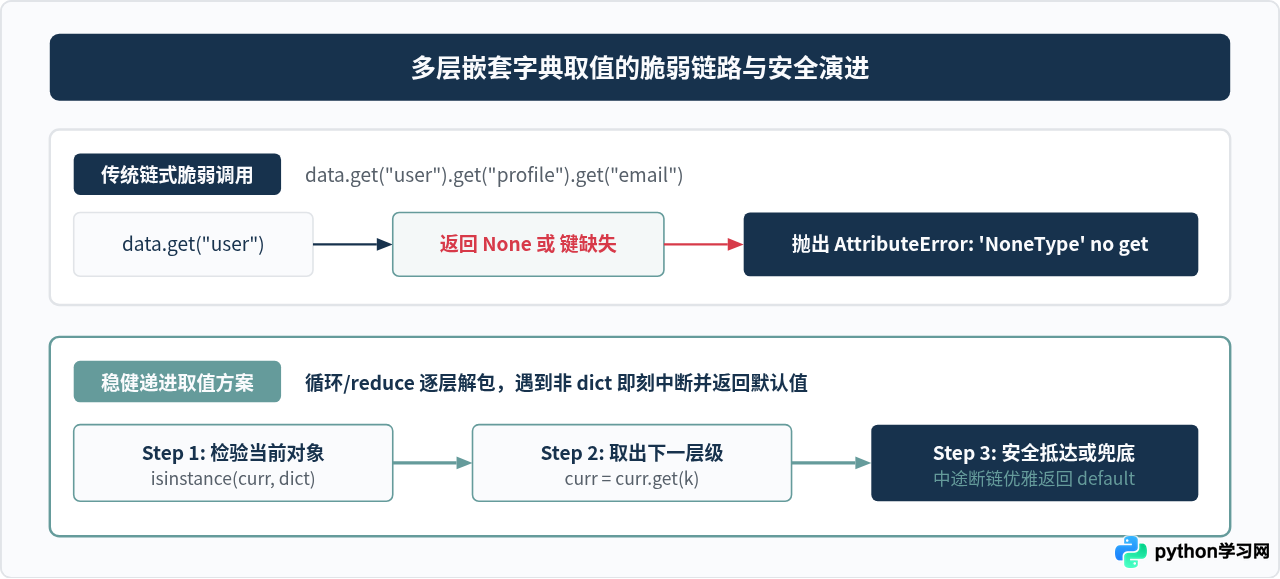
很多开发者习惯写链式调用:data.get("user").get("profile").get("address")。这种写法极其脆弱:一旦中间某一层(例如 user)不存在或者其值本身显式为 None,后续继续对 None 调用 .get() 就会立即引发 AttributeError: 'NoneType' object has no attribute 'get'。
2. 安全的通用深层取值函数
推荐编写一个纯 Python 的轻量安全辅助函数,通过循环解包规避长串异常风险:
def safe_get_nested(source_dict, *keys, default=None):
    """安全获取多层嵌套字典中指定路径的值"""
    current = source_dict
    for key in keys:
        if not isinstance(current, dict):
            return default
        current = current.get(key)
        if current is None:
            return default
    return current

# 测试数据
payload = {
    "api_version": "2.1",
    "data": {
        "user": {
            "name": "David",
            "contact": {"email": "david@example.com"}
        }
    }
}

val_email = safe_get_nested(payload, "data", "user", "contact", "email")
val_phone = safe_get_nested(payload, "data", "user", "contact", "phone", default="未登记")

print("读取邮箱:", val_email)
print("读取电话:", val_phone)读取电话: 未登记
七、5种取值方法综合选型总结
为了在实际工程中迅速选出最恰当的取值策略,下面从键缺失表现、是否修改原对象、执行性能以及推荐适用场景四个维度进行横向对比:
| 取值方式 | 语法范例 | 键缺失时的表现 | 是否改动原字典 | 执行开销 | 典型适用场景 |
|---|---|---|---|---|---|
| 下标访问 | d[key] |
抛出 KeyError |
否 | 极低(纯字节码) | 结构严格固定的内部数据、契约字段校验 |
| get 方法 | d.get(k, default) |
返回 default(默认 None) |
否 | 低(单次方法查找) | 外部入参读取、可选配置项、只读安全兜底 |
| setdefault | d.setdefault(k, v) |
写入并返回 v |
是(就地写入) | 中(含插入开销) | 动态分类聚合、分组初始化、初次访问建键 |
| defaultdict | dd[key] |
执行工厂函数并写入 | 是(访问即写入) | 极低(C底层工厂调用) | 批量计数(int)、分组分桶(list/set) |
| try-except | try...d[k] |
进入 except 分支 |
否 | 正常极低 / 异常高 | 95%以上均命中的高吞吐业务、EAFP风格代码 |
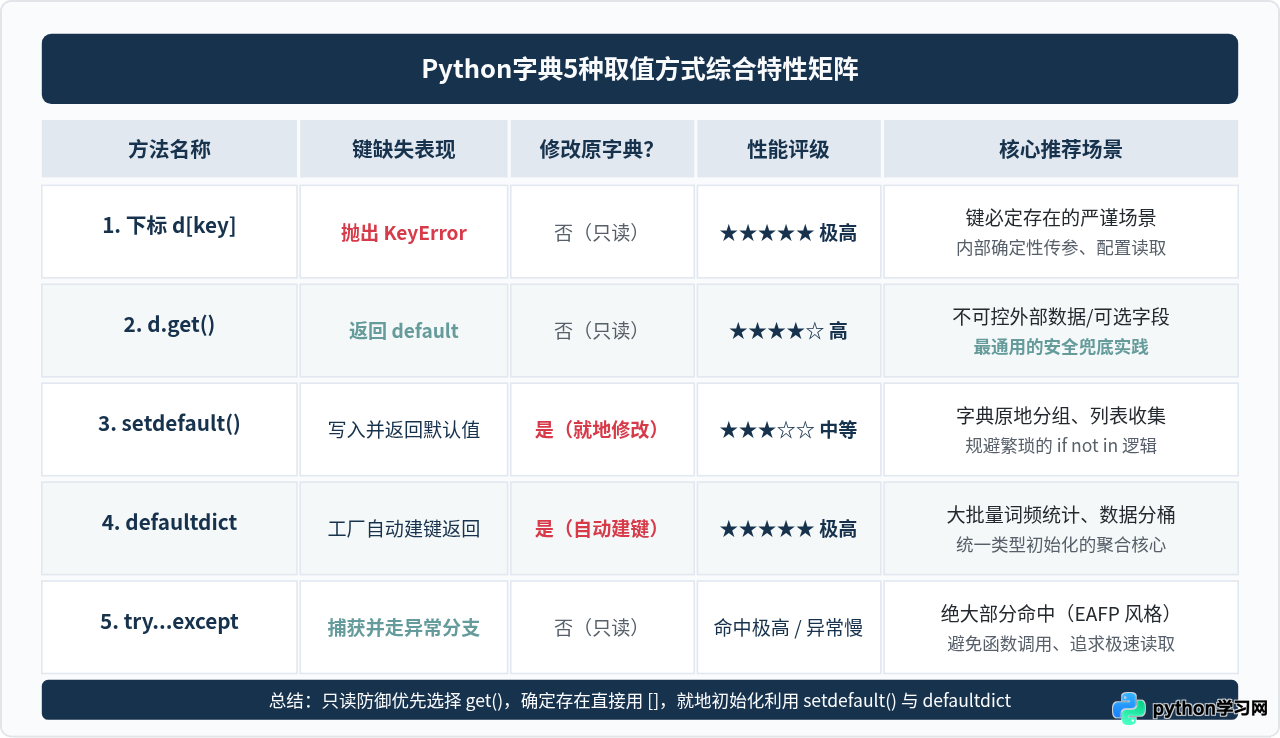
d.get(key, default) 进行安全兜底;在性能关键路径且键必存时使用 d[key];涉及就地初始化多值列表时采用 d.setdefault() 或 defaultdict;面对多层嵌套则借助递归辅助函数进行安全解包。掌握这 5 种方法的本质区别,能够让你的 Python 代码兼具可读性、健壮性与运行效率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















