


Python计算指定数据时报错TypeError非数值类型怎么处理
针对Python计算指定数据时提示TypeError非数值类型报错,提供根因排查、类型识别、安全清洗转换与防御性校验的完整解决方案与可执行代码示例。
在Python中对指定数据执行加减乘除、求和或聚合统计时,如果变量实际装载的不是整型(int)、浮点型(float)等数值对象,解释器会立即中断并抛出 TypeError。解决这一报错的核心路径非常明确:首先根据报错堆栈定位引发异常的操作符与具体字段,其次通过类型检测确认该字段的真实数据形态(如带引号的字符串、None空值或嵌套容器),最后在计算前完成清洗转换与异常兜底保护。
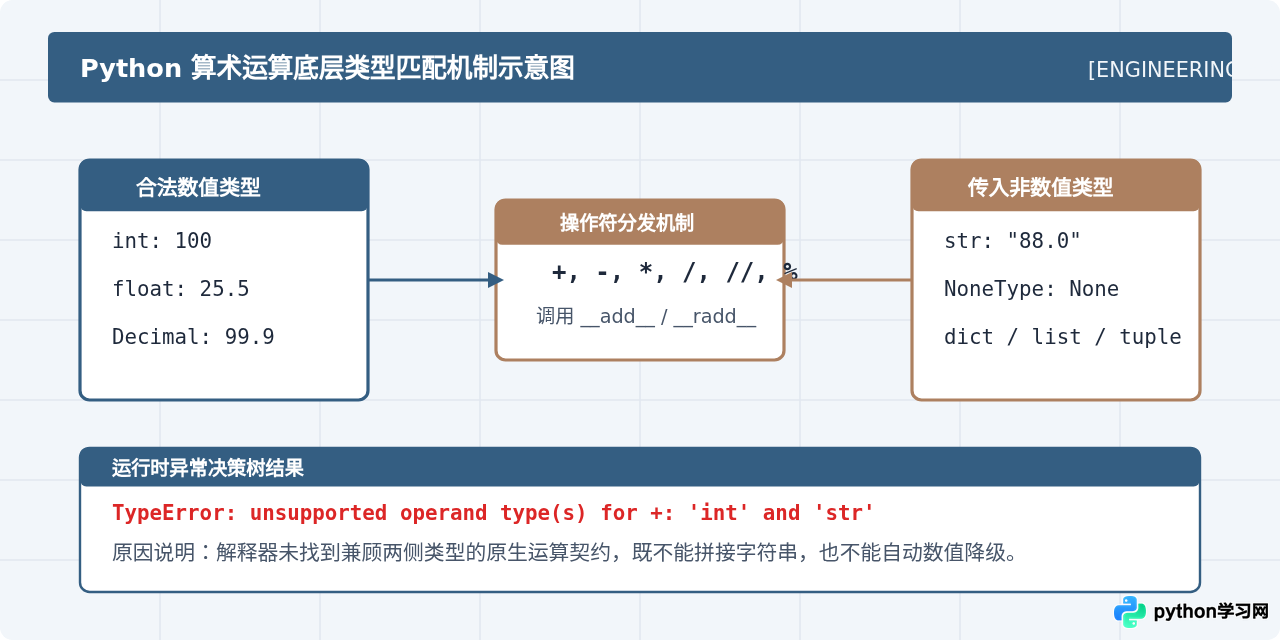
一、报错表现与触发机理分析
Python属于强类型动态语言,不会在算术运算中隐式将字符串、字典或空对象转为数值。当操作符两端的数据类型不支持该运算规则时,解释器就会抛出类型错误。最常见的表现形式分为以下几类:
TypeError: unsupported operand type(s) for +: 'int' and 'str':尝试将整数与字符串直接相加。TypeError: can't multiply sequence by non-int of type 'float':尝试将文本序列与浮点数相乘。TypeError: unsupported operand type(s) for -: 'float' and 'NoneType':从外部接口或数据库读取数据时,部分字段为None,与数值相减触发报错。TypeError: 'dict' and 'int':未能通过键提取字典内层数值,直接将字典实例送入算术表达式。
二、标准排查四步法
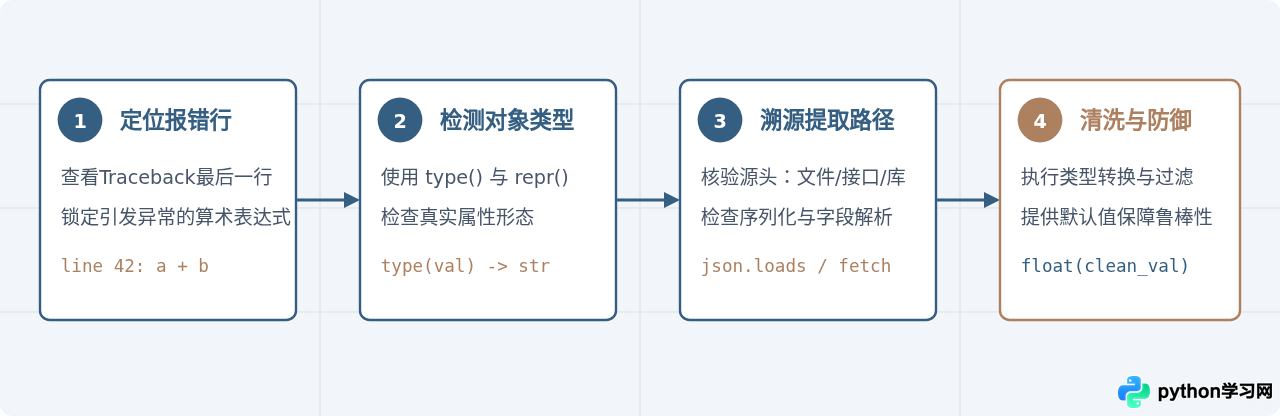
遇到报错后,切忌盲目添加转换函数,应按照规范顺序快速缩小范围并定位根本原因:
- 查看Traceback堆栈底端:确认具体报错的文件名、代码行数以及执行的具体语句。
- 输出变量运行时类型与值:在报错行前使用
type()和repr()查看涉事变量的真实形态。 - 回溯数据输入源:排查该数据是来自文本读取(如 CSV、JSON)、数据库查询,还是前端表单提交。
- 辨析脏数据形态:检查字符串中是否混杂千分位逗号(如
"1,250.00")、前导空格、货币符号或空字符串。
三、核心场景与代码修复方案
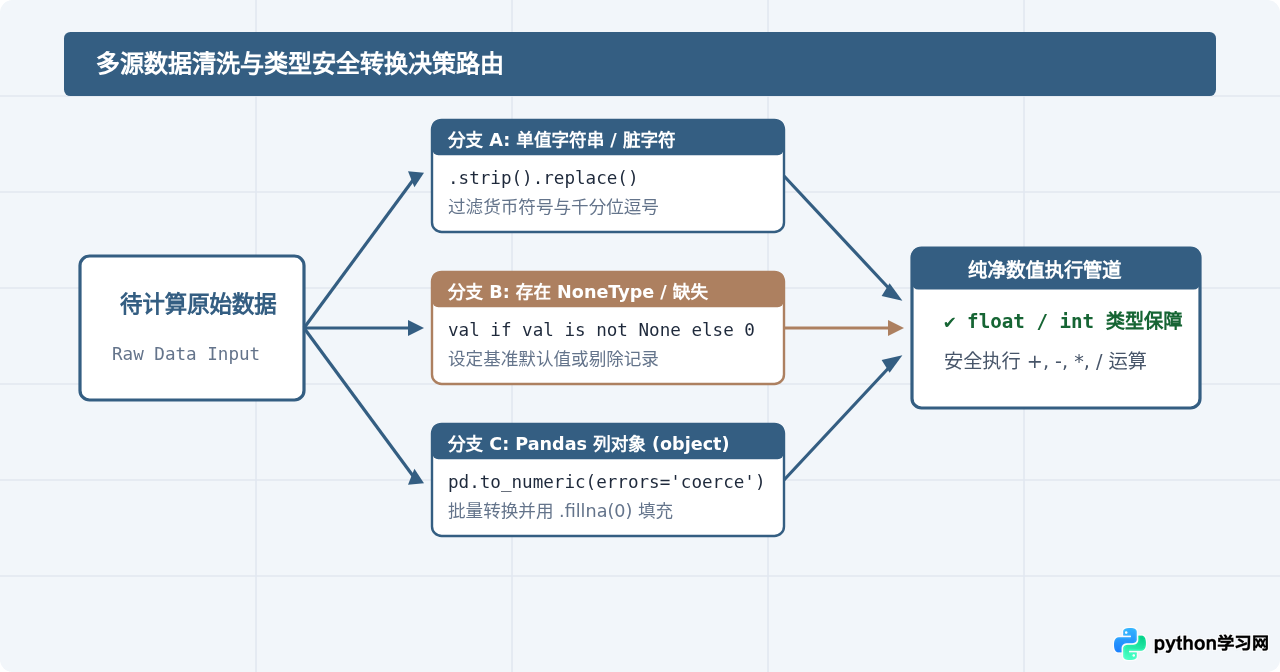
针对不同数据载体,具体处理方式有所区别。以下列出开发中最常见的四个实际场景及对应的健壮代码实现。
场景 1:原生字符串数据转换与脏符号剔除
从外部文件读取的数值往往带有前导后导空格、千分位逗号或货币标识符。直接调用 float() 会抛出 ValueError,而直接相加又会导致 TypeError。
def safe_to_float(raw_val, default=0.0):
    """
    安全转换为浮点数,自动过滤空格与常见货币/千分位符号
    """
    if raw_val is None:
        return default
    if isinstance(raw_val, (int, float)):
        return float(raw_val)
    if isinstance(raw_val, str):
        # 清除首尾空白与常见格式化符号
        cleaned = raw_val.strip().replace(",", "").replace("¥", "").replace("$", "")
        if not cleaned:
            return default
        try:
            return float(cleaned)
        except ValueError:
            return default
    return default

# 示例运算
price_str = " ¥1,299.50 "
discount = 0.85
final_price = safe_to_float(price_str) * discount
print(f"计算结果: {final_price:.2f}")  # 示例输出: 1104.58
场景 2:存在 None 值的缺失数据计算
从数据库查询返回的整条记录中,部分数值列可能为 SQL NULL,在 Python 中表现为 None。如果直接参与汇总运算将引发报错:
records = [120, 85, None, 40, None, 95]

# 错误写法: sum(records) -> TypeError: unsupported operand type(s) for +: 'int' and 'NoneType'

# 正确做法 1: 列表推导式过滤或赋默认值 0
valid_sum = sum(x for x in records if x is not None)
print("过滤None后的求和:", valid_sum)  # 示例输出: 340

# 正确做法 2: 将None替换为基准值
normalized_records = [x if x is not None else 0 for x in records]
print("替换后列表:", normalized_records)
场景 3:字典嵌套结构中的字段提取不当
处理 JSON 响应时,很多开发者直接把包含指标的字典当成标量数值使用:
item = {"sku": "A101", "price": 45.0, "quantity": 3}

# 错误操作: total = item * 2  -> TypeError: can't multiply sequence by non-int

# 正确操作: 明确通过键提取,并使用 get 提供默认值
unit_price = item.get("price", 0.0)
qty = item.get("quantity", 0)

if isinstance(unit_price, (int, float)) and isinstance(qty, int):
    total = unit_price * qty
    print("总计金额:", total)
else:
    raise TypeError("指定字段不是合法数值类型,无法进行总价核算")
场景 4:Pandas 数据分析中的批量类型清洗
在 Pandas 中,一列数据若混有非数字字符串或特殊占位符(如 "-"、"N/A"),该整列的 dtype 将被自动推断为 object。对此类列执行 df['col'].sum() 会发生字符串串联而非算术相加,调用均值 mean() 则直接报 TypeError。
import pandas as pd

df = pd.DataFrame({
    "product": ["Item_A", "Item_B", "Item_C", "Item_D"],
    "sales": ["1200", "850", "N/A", "430.5"]
})

# 1. 强制转为数值类型,遇到无法解析的值强制变为 NaN
df["sales_numeric"] = pd.to_numeric(df["sales"], errors="coerce")

# 2. 对缺失值填充默认值 0.0,或按业务剔除
df["sales_numeric"] = df["sales_numeric"].fillna(0.0)

# 3. 正常执行数值聚合计算
total_sales = df["sales_numeric"].sum()
average_sales = df["sales_numeric"].mean()
print(f"总销量: {total_sales}, 平均销量: {average_sales}")
四、工程级防御性编程与验证建议
在生产系统或批量数据管道中,不能仅依赖“报错后再修复”的被动逻辑,而应引入前置验证机制,确保参与计算的数据在到达算术模块之前就符合类型契约。
ValueError("单价必须为正数")),也不要让不可预期的类型混入运算过程触发底层的 TypeError。
| 防护维度 | 推荐技术方案 | 适用范围与说明 |
|---|---|---|
| 类型提示与静态检查 | typing.Union[int, float] + mypy |
在开发阶段提前发现类型传递错误,规范函数输入输出。 |
| 运行时数据建模 | pydantic.BaseModel |
在 Web 接口与配置加载时自动完成类型强转与非法数据阻断。 |
| 防御性断言 | assert isinstance(val, (int, float)) |
在核心算法模块前置验证,便于在测试环境快速拦截异常输入。 |
| 批量异常收集 | try...except TypeError, ValueError |
记录出错行的原始索引与上下文日志,避免单个脏数据中断整批任务。 |
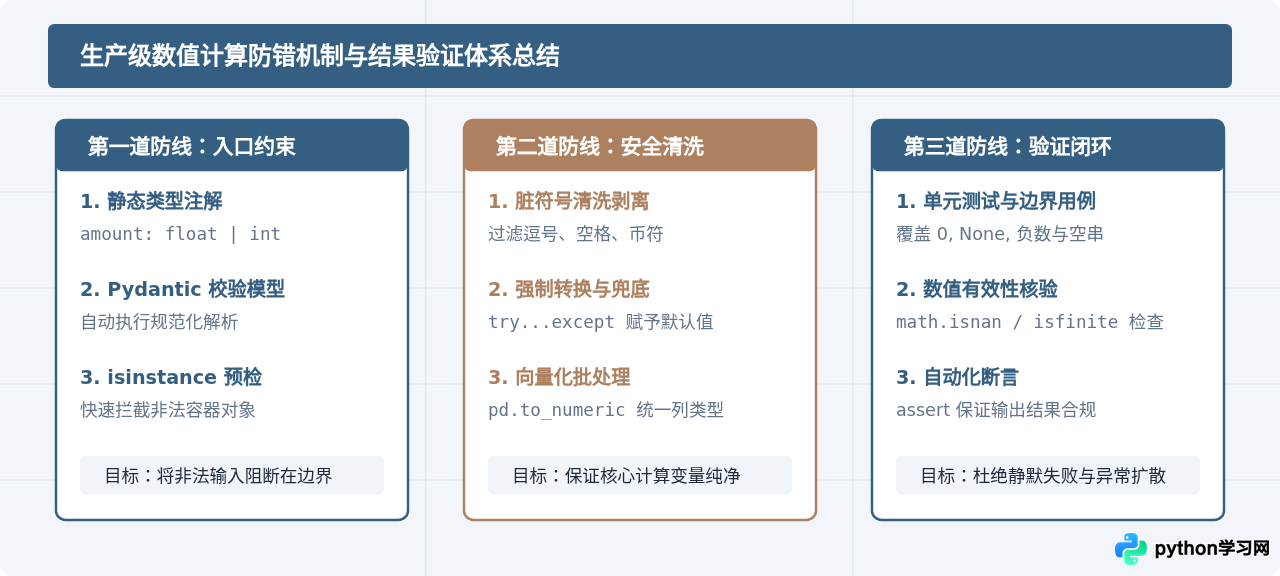
五、总结
处理 Python 计算时的 TypeError 非数值类型报错,本质上是建立严密的数据契约。不要依赖 Python 做出隐式类型推导,而是在数据进入计算核心前完成三件事:
- 明确类型:确认数据是来自外部源的字符串、数据库的
None,还是容器对象。 - 显式清洗:对字符串剔除符号并调用
float()或int();对缺失值提供合理的业务默认值。 - 隔离容错:使用
try-except或 Pandas 的errors='coerce'收集脏数据,保障核心批处理任务不被单点异常中断。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















