


怎么将毫秒级时间戳转换为Python datetime对象
本文详细讲解如何将13位毫秒级时间戳转换为Python的datetime对象,分析常见溢出报错原因,提供带时区处理的标准实现代码与批量处理方案。
datetime.fromtimestamp() 默认只接收以秒为单位的时间戳。将 13 位毫秒级时间戳转换为 datetime 对象的直接解法是:将毫秒数值除以 1000.0 得到带小数秒的浮点数,再传给 datetime.fromtimestamp()。同时,在生产环境中务必显式传入时区参数(如 tz=timezone.utc),以避免产生歧义的原生时间对象。
一、为什么直接传入毫秒时间戳会报错?
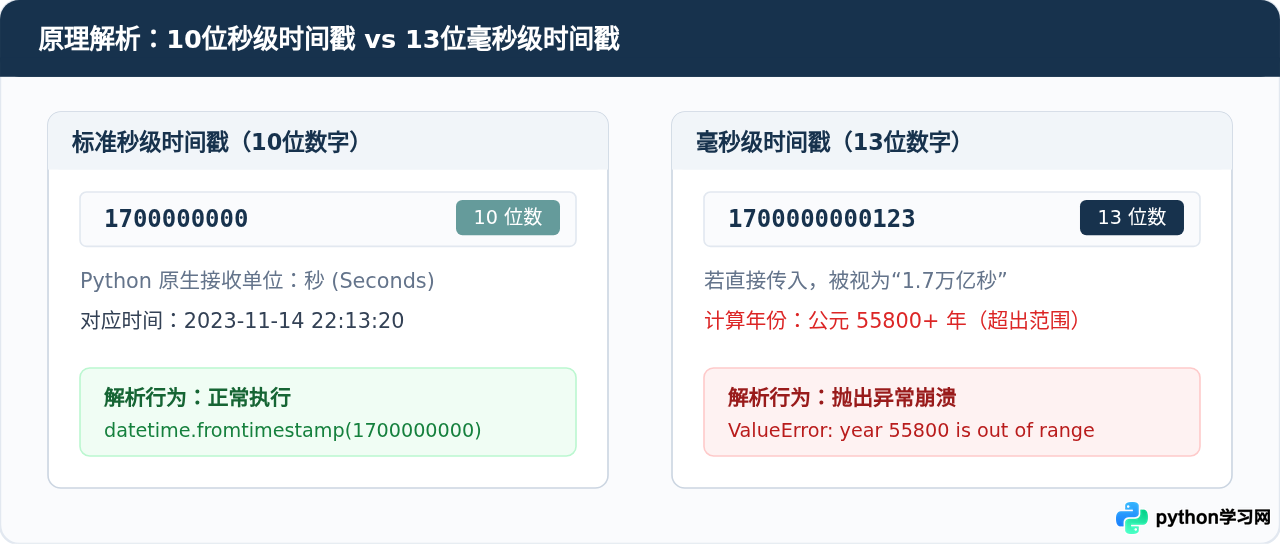
很多初学者在调用 datetime.fromtimestamp() 时,会直接将后端接口或前端 JavaScript 传递过来的 13 位毫秒数值直接传入,随后程序立即崩溃并抛出异常:
# 错误示范:直接传入 13 位毫秒戳
from datetime import datetime

ms_timestamp = 1700000000000
dt = datetime.fromtimestamp(ms_timestamp)这个报错的原因在于单位不一致。UNIX 时间戳是以 1970 年 1 月 1 日 00:00:00 UTC(Unix 纪元)为基准经过的流逝量。秒级时间戳通常是 10 位整数(例如 1700000000 对应 2023 年);而毫秒级时间戳是 13 位整数(例如 1700000000000)。如果 Python 把 13 位数字当作秒来解析,相当于计算大约 5 万年后的时间,自然超出了平台日期的有效范围。
二、标准实现:除以 1000 转换为秒级浮点数
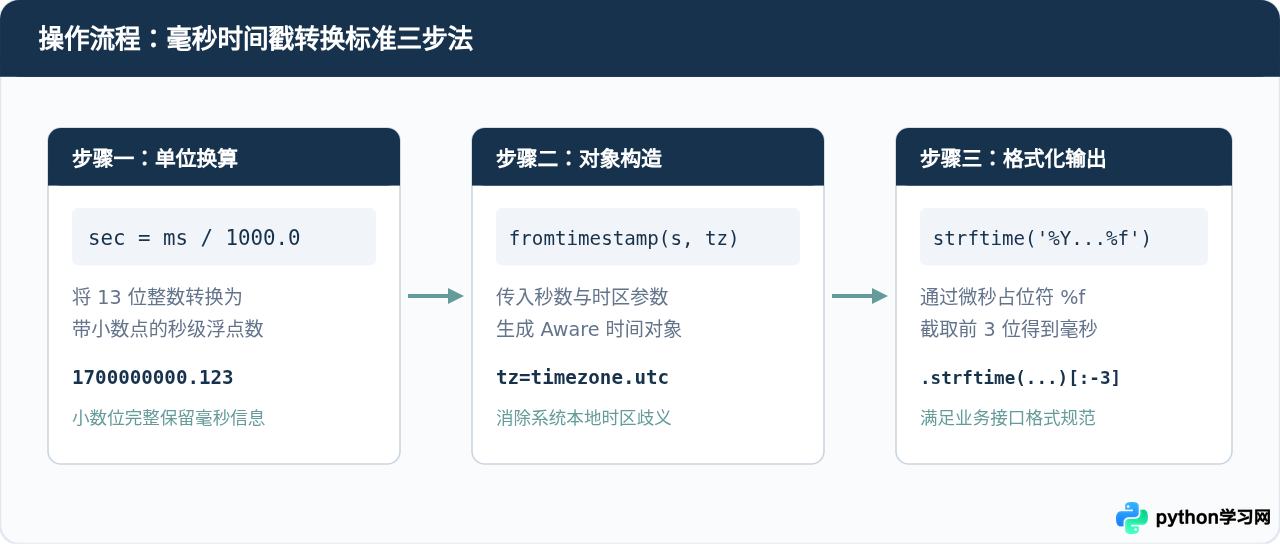
解决这个问题的最标准、最直接的办法,是在调用 fromtimestamp() 之前将数值除以 1000.0。由于 Python 的浮点除法支持保留小数部分,除以 1000 后的数值既保留了整数秒,又将毫秒部分转换为了小数秒,正好与 datetime 支持的微秒精度契合。
from datetime import datetime, timezone

# 准备一个 13 位的毫秒级时间戳(例如 2023-11-14 22:13:20.123 UTC)
ms_timestamp = 1700000000123

# 第一步:除以 1000 得到秒级浮点数
seconds = ms_timestamp / 1000.0

# 第二步:指定 UTC 时区进行安全转换
dt_utc = datetime.fromtimestamp(seconds, tz=timezone.utc)

# 输出结果验证
print("转换结果:", dt_utc)
print("年份:", dt_utc.year)
print("微秒部分:", dt_utc.microsecond)年份: 2023
微秒部分: 123000
可以看到,原本的 123 毫秒在 dt_utc.microsecond 中被精确保留为 123000 微秒(1毫秒 = 1000微秒),没有任何精度丢失。
三、关键细节:时区感知与废弃 API 避坑
很多开发者在完成转换后发现输出的时间“莫名其妙对不上”,或者差了 8 个小时。这通常是因为忽略了时区感知(Timezone Aware)与原生无时区(Naive)的差异。
1. 为什么必须显式指定时区?
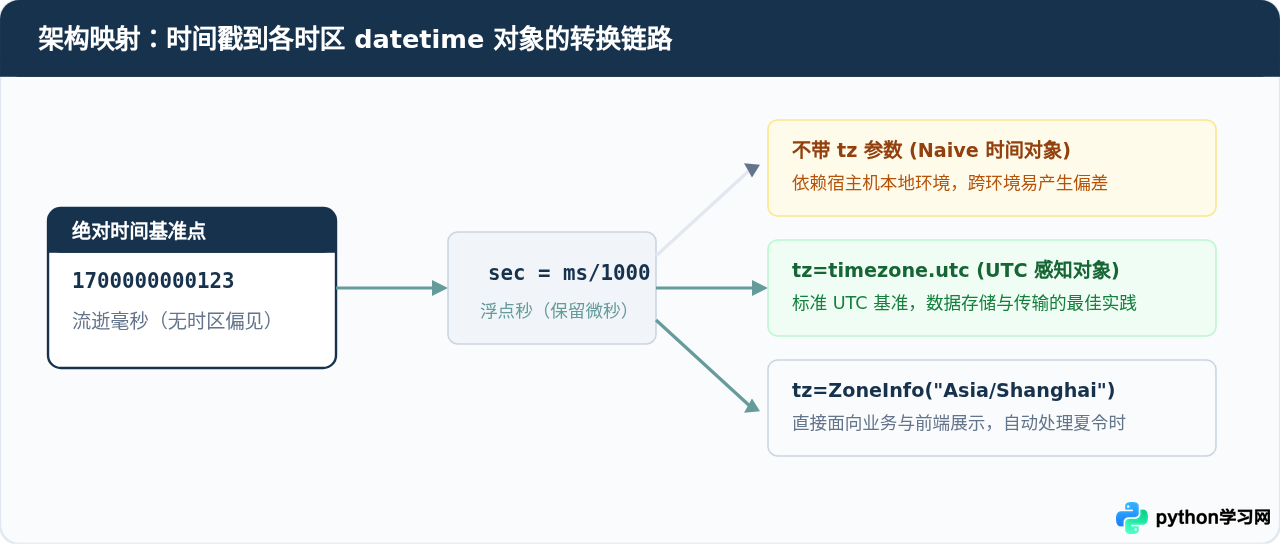
如果不传递 tz 参数,datetime.fromtimestamp(seconds) 会默认获取运行机器当前操作系统设置的本地时间,并且生成的对象不包含任何时区信息(tzinfo is None)。如果这行代码在服务器(通常设置为 UTC 时区)和开发者的笔记本电脑(如北京时间 UTC+8)上运行,同一个时间戳会输出完全不同的文本表达,极易引发难以排查的业务 Bug。
datetime.utcfromtimestamp():旧版教程中常推荐使用
datetime.utcfromtimestamp(seconds),但在 Python 3.12 及更高版本中,该方法已经被官方明确标记为废弃(Deprecated)。官方推荐统一使用 datetime.fromtimestamp(seconds, tz=timezone.utc)。
2. 转换为指定时区(如北京时间 UTC+8)
在 Python 3.9+ 中,标准库提供了 zoneinfo 模块,可以非常方便地转换到特定时区;如果是更通用的固定偏移时区,也可以使用 timezone(timedelta(hours=8)):
from datetime import datetime, timezone, timedelta
from zoneinfo import ZoneInfo

ms_val = 1700000000123
sec_val = ms_val / 1000.0

# 方式 A:使用固定偏移时区(UTC+8)
cst_tz = timezone(timedelta(hours=8))
dt_beijing_1 = datetime.fromtimestamp(sec_val, tz=cst_tz)

# 方式 B:使用 IANA 区域名称(Python 3.9+ 推荐)
dt_beijing_2 = datetime.fromtimestamp(sec_val, tz=ZoneInfo("Asia/Shanghai"))

print("北京时间:", dt_beijing_2)
print("带毫秒格式化:", dt_beijing_2.strftime("%Y-%m-%d %H:%M:%S.%f")[:-3])带毫秒格式化: 2023-11-15 06:13:20.123
四、其他可行转换方式与多场景选型
除了直接通过 fromtimestamp() 除以 1000 之外,在特定业务或数据分析场景下,还有另外两种常见的转换方式:
1. 方式二:利用 timedelta 与纪元基准相加
如果希望代码逻辑非常明确地表达“从 Unix 纪元开始累加毫秒”,可以使用 timedelta 方式:
from datetime import datetime, timezone, timedelta

ms = 1700000000123
epoch_utc = datetime(1970, 1, 1, tzinfo=timezone.utc)
dt_from_delta = epoch_utc + timedelta(milliseconds=ms)

print(dt_from_delta)  # 2023-11-14 22:13:20.123000+00:00
这种方式的优点是无需手动进行浮点数除法运算,语义非常明确;不过由于需要额外构造纪元起点与 timedelta 对象,在单个时间戳转换时代码量略多于 fromtimestamp。
2. 方式三:Pandas 批量数据处理
在数据分析、大数据处理或处理 CSV/DataFrame 数据表时,如果整列都是 13 位毫秒级时间戳,逐行调用 Python 函数性能较低。此时推荐使用 Pandas 的矢量化转换:
import pandas as pd

# 模拟包含毫秒级时间戳的序列
ts_series = pd.Series([1700000000123, 1700000005456])

# 通过 unit='ms' 直接指定单位为毫秒
dt_series = pd.to_datetime(ts_series, unit='ms', utc=True)
print(dt_series)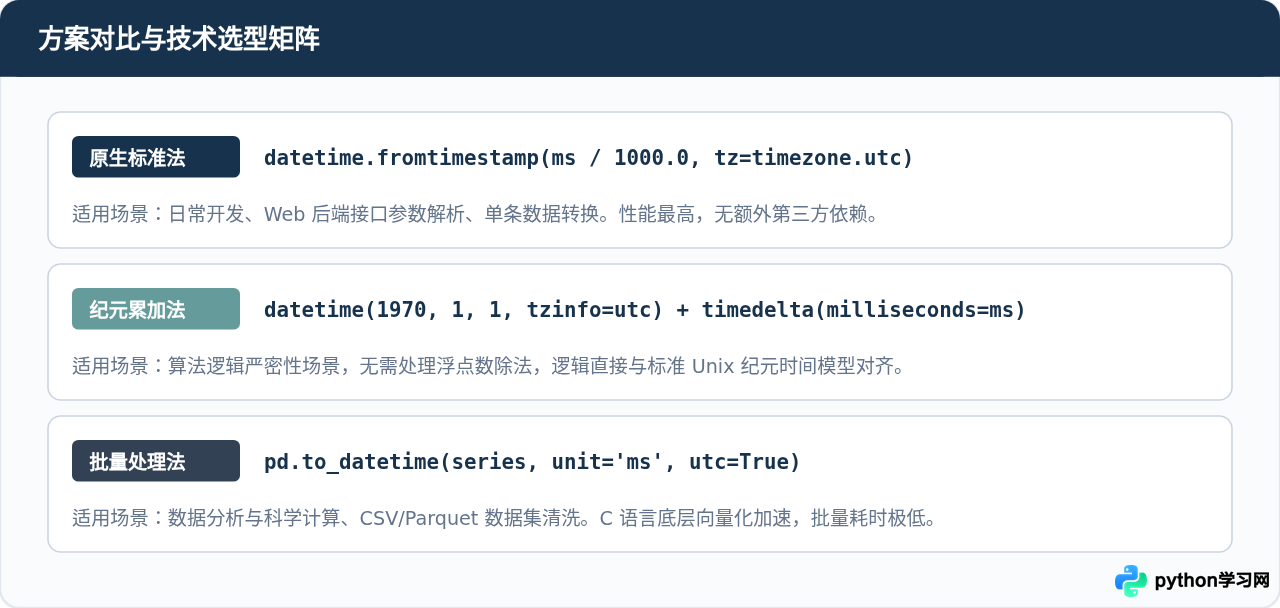
五、常见问题与注意事项
- 字符串格式的毫秒戳:如果是从 JSON 字符串中获取的字符串形式时间戳(如
"1700000000123"),必须先使用int()转换为数值,再进行/ 1000.0运算,否则会触发TypeError: unsupported operand type(s) for /: 'str' and 'float'。 - 浮点数除法精度问题:Python 的内置
float为双精度浮点数(IEEE 754 标准,拥有 53 位有效二进制精度),在当前时间戳所表示的数值范围内,除以 1000 不会丢失微秒精度,可以放心使用。 - 截取 3 位毫秒展示:Python 的
%f占位符默认输出 6 位微秒(Microseconds)。如果业务上需要 3 位毫秒(Milliseconds),常用的做法是使用切片dt.strftime("%Y-%m-%d %H:%M:%S.%f")[:-3],或者使用f"{dt:%Y-%m-%d %H:%M:%S}.{dt.microsecond // 1000:03d}"进行格式化。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















