


Python字符串格式化指南:f-string、format与%操作符对比
全面对比Python中f-string、str.format与%操作符的语法差异、对齐补零、数值格式化、性能表现与边界陷阱,提供实用的技术选型指南。
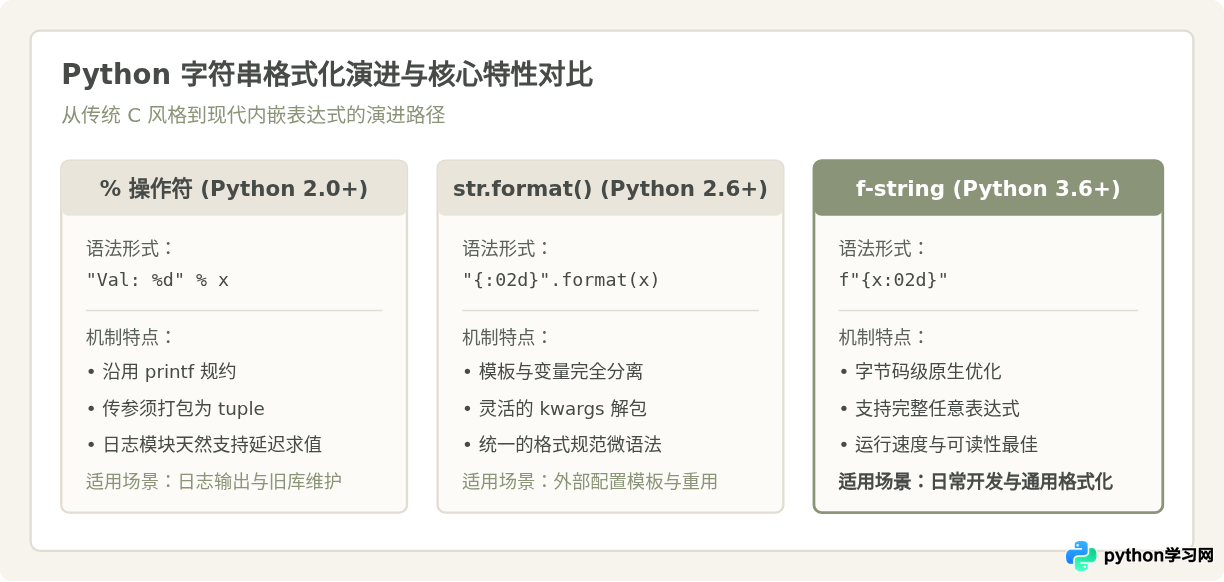
% 操作符、在Python 2.6引入的面向对象式 str.format() 方法,以及Python 3.6登场的 f-string(格式化字符串字面量)。在当前的日常开发中,f-string凭借紧凑的语法和出色的性能成为首选方案,但在外部动态模板配置和延迟求值日志场景中,其他两者依然扮演着不可替代的角色。
一、三种格式化机制的基本语法与特征
要掌握Python中的字符串格式化,首先需要理解不同语法的结构设计与传参机制。它们在语法紧凑度、动态绑定灵活性以及底层行为上各有侧重。
1. % 操作符(printf 风格)
% 操作符是Python最早支持的格式化方式。它沿袭了C语言中 printf 系列函数的格式化占位符规范,使用 %s、%d、%f 等指定变量类型。
name = "Alice"
score = 95.5
# 多个参数必须包装为元组
message = "考生: %s, 分数: %.1f" % (name, score)
# 示例输出: '考生: Alice, 分数: 95.5'
% 语法虽然直观,但在变量数量较多时,模板字符串与末尾的元组距离较远,容易出现占位符与变量位置错位的问题。
2. str.format() 方法
Python 2.6和3.0引入了 str.format(),将格式化由操作符升级为字符串对象的内建方法。它使用大括号 {} 作为占位符,支持按位置索引、参数名称以及属性路径访问。
name = "Bob"
role = "工程师"
# 支持命名参数与位置传参
info = "员工: {0}, 职位: {role}".format(name, role=role)
# 示例输出: '员工: Bob, 职位: 工程师'
str.format() 最大的优势在于模板字符串与变量数据的完全解耦。模板可以被持久化保存在配置文件或数据库中,并在需要渲染时作为普通字符串传入参数。
3. f-string(格式化字符串字面量)
Python 3.6正式引入的PEP 498定义了 f-string。在字符串前缀添加 f 或 F 后,大括号内不仅可以直接书写变量名,还能嵌入任意合法的Python表达式。
user = "Charlie"
items = ["Python", "Rust"]
summary = f"用户 {user} 共有 {len(items)} 项技能,首选为 {items[0].lower()}"
# 示例输出: '用户 Charlie 共有 2 项技能,首选为 python'
f-string直接消除了占位符与变量名之间的映射开销,代码在阅读时变量与位置一一对应,是现代Python中最符合人体工程学的写法。
二、常用格式化需求对照与实现
在实际编码中,对数字精度、对齐补零、进制表示及千分位分隔符的处理是最常见的需求。f-string 和 str.format() 共享一套“格式规范微语法”(Format Specification Mini-Language),而 % 则沿用 C 风格修饰符。
1. 浮点数精度与百分比
保留小数位时,现代语法通过 :.Nf 控制,百分比转换通过 :.N% 直接完成,避免了手动乘以 100 并拼接 % 字符。
ratio = 0.85624

# f-string:
f"{ratio:.2f}"   # 结果: '0.86'(自动四舍五入)
f"{ratio:.1%}"   # 结果: '85.6%'

# str.format():
"{:.2f}".format(ratio)
"{:.1%}".format(ratio)

# % 操作符(不支持内置百分比转换,需手动换算):
"%.2f" % ratio
"%.1f%%" % (ratio * 100)
2. 宽度、对齐与补零
在生成报表或编号时,经常需要对齐内容或补零。f-string 和 str.format() 使用 <(左对齐)、>(右对齐)、^(居中对齐),后跟总宽度;补零则简写为 :0Nd。
num = 42
text = "py"

# f-string 示例
f"{num:05d}"      # 结果: '00042'
f"{text:>8}"      # 结果: '      py' (右对齐,总宽8)
f"{text:*^9}"     # 结果: '***py****' (星号填充居中对齐)

# % 操作符对比(仅支持空格或零填充的简单对齐)
"%05d" % num      # 结果: '00042'
"%8s" % text      # 结果: '      py'
"%-8s" % text     # 结果: 'py      ' (左对齐)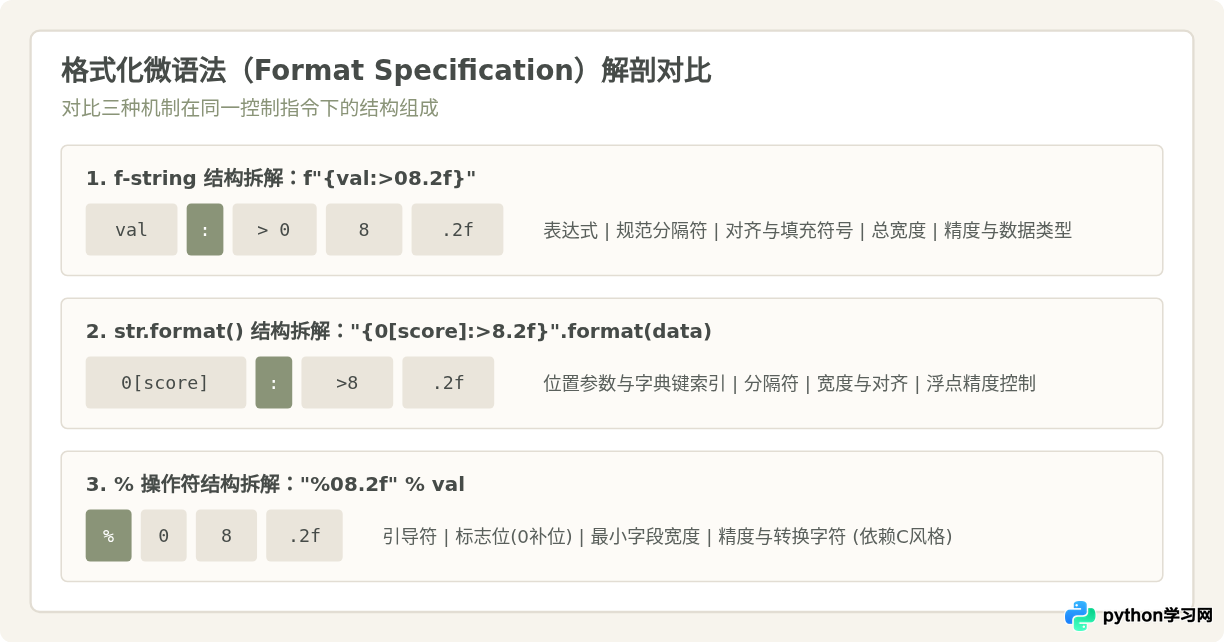
3. 千分位与日期格式化
千分位分隔符在财务与统计报表中是标配。现代微语法支持直接在修饰符中加入逗号 , 或下划线 _,而 % 操作符原生并不支持该功能,需要借助 locale 模块设置系统区域后使用 %n。
amount = 12500000.75
# f-string:
f"{amount:,.2f}"   # 结果: '12,500,000.75'
f"{amount:_.2f}"   # 结果: '12_500_000.75'

# str.format():
"{:,.2f}".format(amount)
对于 datetime 对象,f-string和format可以直接在冒号后使用 strftime 规范,省去了手动调用方法的步骤:
from datetime import datetime
now = datetime(2026, 10, 28, 15, 30)
f"{now:%Y-%m-%d %H:%M}"   # 结果: '2026-10-28 15:30'
三、常见认知偏差与边界陷阱辨析
在讨论字符串格式化时,存在若干流传较广但并不全面的说法。澄清这些边界情况,能够帮助开发者在复杂环境中规避隐蔽的缺陷。
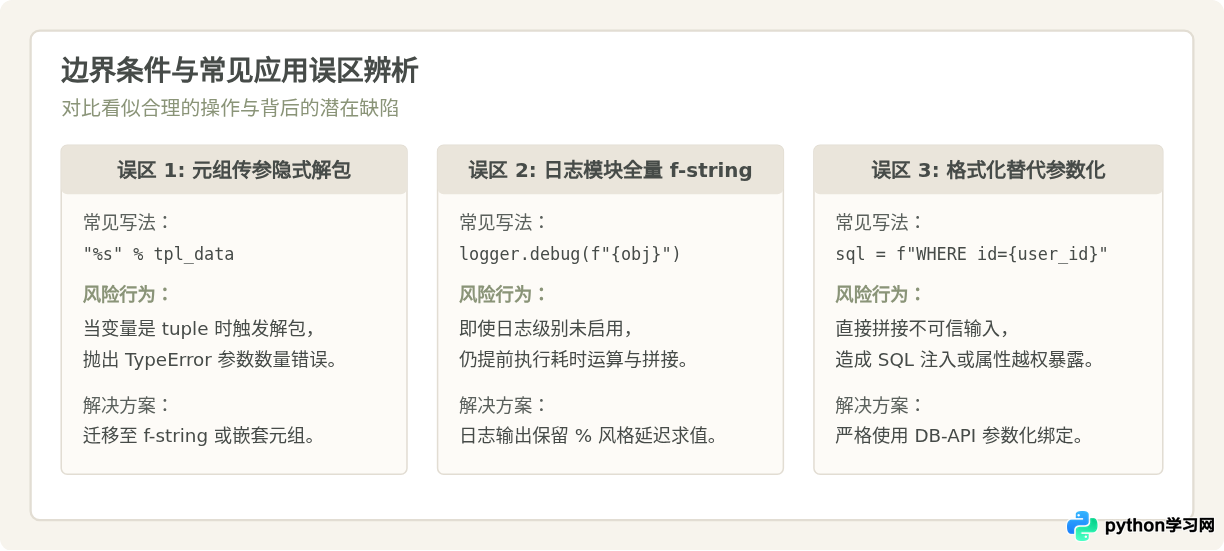
1. 陷阱一:% 操作符的“元组歧义”
有些开发者认为“% 只是写起来不够现代,功能上与其他机制没区别”。这一认知忽略了 % 在处理单个复合数据类型时的歧义行为。
def print_record(data):
    # 期望将传入的整个对象作为字符串打印
    return "记录数据: %s" % (data,)

# 如果不小心写成:
# "记录数据: %s" % data
# 当 data = "hello" 时正常;
# 当 data = (1, 2) 时会抛出: TypeError: not all arguments converted during string formatting原因分析:当 % 的右侧是一个元组时,Python会将其解包为多个独立的格式化参数;如果右侧不是元组,则视为单个参数。如果被格式化的变量本身就是一个动态生成的元组,传入时就会触发解包,导致占位符数量与参数数量不匹配。要避免这个陷阱,必须在右侧额外嵌套一层单元素元组 (data,),而 str.format() 和 f-string 不存在这种隐式解包行为。
2. 陷阱二:在 Logging 日志中盲目替换为 f-string
“有了 f-string 就应该在所有地方消灭 %” 是另一个常见的误区。在标准库 logging 模块中,过早使用 f-string 往往会导致不必要的性能浪费和监控失效。
import logging
logger = logging.getLogger(__name__)

# 推荐写法(延迟格式化):
logger.debug("处理请求ID: %s, 耗时: %.4f 秒", req_id, elapsed)

# 不推荐写法(即时格式化):
logger.debug(f"处理请求ID: {req_id}, 耗时: {elapsed:.4f} 秒")原因分析:在上面的代码中,如果当前的日志记录级别设置为 INFO,DEBUG 级别的日志不会被真正输出。但如果使用 f-string,表达式会在传递给 logger.debug() 之前立即求值并完成字符串拼接;而使用 % 占位风格时,参数只是作为普通元组传递给日志方法,只有在该日志级别满足输出条件时才会触发格式化。
3. 陷阱三:SQL 语句或不可信模板的安全风险
任何字符串格式化机制都绝对不能用于拼接 SQL 查询语句。将用户输入的变量通过 f-string 或 format 直接拼入 SQL 语句,会导致致命的 SQL 注入隐患。
# 严重错误:
# cursor.execute(f"SELECT * FROM users WHERE name = '{user_input}'")

# 正确做法: 使用数据库驱动提供的参数化查询
cursor.execute("SELECT * FROM users WHERE name = %s", (user_input,))此外,如果模板字符串本身来自用户输入,str.format() 可能会暴露内部属性(例如 "{0.__class__.__init__.__globals__}".format(obj)),导致安全沙箱逃逸。在此类场景中,应使用标准库的 string.Template。
四、底层运行机制与性能差异
除了语法便利性外,三者在运行时的性能表现也存在明显梯度。在基准测试中,f-string 的执行速度通常是 % 操作符的 1.5 到 2 倍,是 str.format() 的 2 到 3 倍。
核心原因在于解析时机不同:% 和 str.format() 在每次执行时,Python 解释器都需要在运行时解析模板字符串中的格式化标记(扫描大括号或百分号)。而 f-string 是在编译期由解释器直接解析为专门的字节码指令(如 FORMAT_VALUE 和 BUILD_STRING),免去了运行时的字符串扫描和方法调用开销。
通过 Python 内置的 dis 模块可以清晰观察到底层字节码的差异:
import dis

# 查看 f-string 编译产物
dis.dis('f"Hello {name}"')
# 输出核心指令包含:
#   LOAD_NAME                0 (name)
#   FORMAT_VALUE             0 (None)
#   LOAD_CONST               1 ('Hello ')
#   BUILD_STRING             2

# 查看 str.format() 编译产物
dis.dis('"Hello {}".format(name)')
# 输出核心指令包含:
#   LOAD_CONST               0 ('Hello {}')
#   LOAD_METHOD              0 (format)  <-- 额外的函数查找与调用开销
#   LOAD_NAME                1 (name)
#   CALL_METHOD              1
五、技术选型原则与实操建议
为了在实际项目中规范团队代码风格,可以按照以下决策路径选择最适合的格式化方式:
| 格式化方式 | 最低支持版本 | 执行性能 | 核心优势 | 核心局限 |
|---|---|---|---|---|
| f-string | Python 3.6 | 最快 (字节码级) | 代码直观,支持复杂表达式与 = 调试 | 模板无法动态存储在外部文件中 |
| str.format() | Python 2.6 / 3.0 | 中等 | 模板与参数解耦,支持字典/属性解包 | 语法相对冗长,运行时解析有开销 |
| % 操作符 | Python 2.0 | 较快 | logging 模块支持良好,C 开发者熟悉 | 元组解包易错,缺少高级格式化支持 |
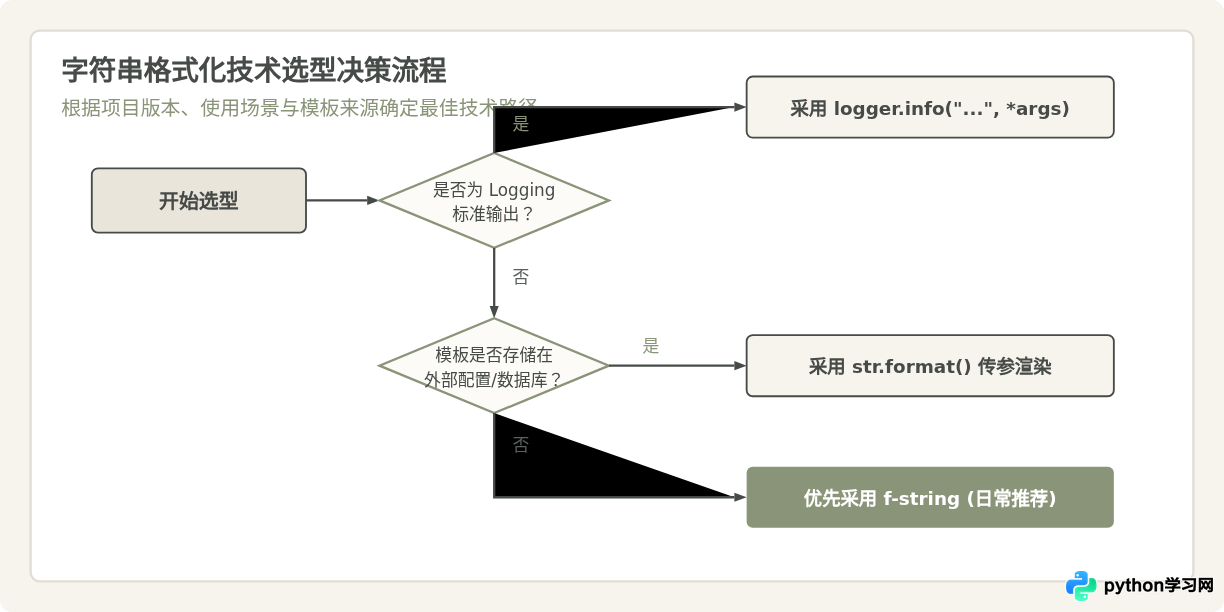
总结来说,对于 Python 3.6+ 项目的绝大多数日常代码,直接使用 f-string 是最兼顾可读性与执行效率的做法;当模板需要外置或动态复用时,选用 str.format();而在配合标准库 logging 记录日志时,保留 % 风格传参,以享受延迟求值带来的性能收益。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















