


Python是解释型语言吗?为什么没有传统编译器
深入解析Python的语言本质:它既不是纯粹的解释型,也不是传统的编译型。详细拆解CPython工作流程、字节码原理,以及为什么Python没有生成机器码的传统编译器。
一、核心结论:打破“非黑即白”的二元分类
很多初学者在刚接触编程时,往往习惯于将编程语言划分为非此即彼的两大阵营:以C、C++为代表的“编译型”,以及以Shell、Python为代表的“解释型”。在这种分类下,人们往往认为解释型语言就是“读一行代码、执行一行代码”。
这种二元认知在现代工程中已经脱节。实际上,“编译”与“解释”描述的是代码的执行机制与实现方式,而非编程语言规范本身的固有属性。Python官方规范并没有规定代码必须如何运行,而Python的官方参考实现 CPython 所采用的模型正是“前段编译、后段虚拟机解释”的混合模式。
当你运行一个脚本时,Python从来不会直接逐字解析 .py 文件中的纯文本字符去驱动硬件,而是必须经历完整的词法分析、语法分析、抽象语法树构建,最终输出线性的字节码序列。
二、深入底层:CPython的完整执行过程
为了直观掌握Python的工作链路,我们需要审视一段代码从文本到CPU执行的全部生命周期。整个过程通常分为两个核心阶段:
- 编译阶段(Compile Time):由内建编译器执行,负责将
.py文本文件解析为AST,并进一步生成对应的代码对象(Code Object),其中包含了可以在虚拟机内流转的字节码指令集。 - 解释执行阶段(Runtime):由Python虚拟机(PVM, Python Virtual Machine)载入代码对象,借助一个庞大的求值循环(Evaluation Loop)依次提取字节码并映射为底层操作系统的系统调用或C库函数。
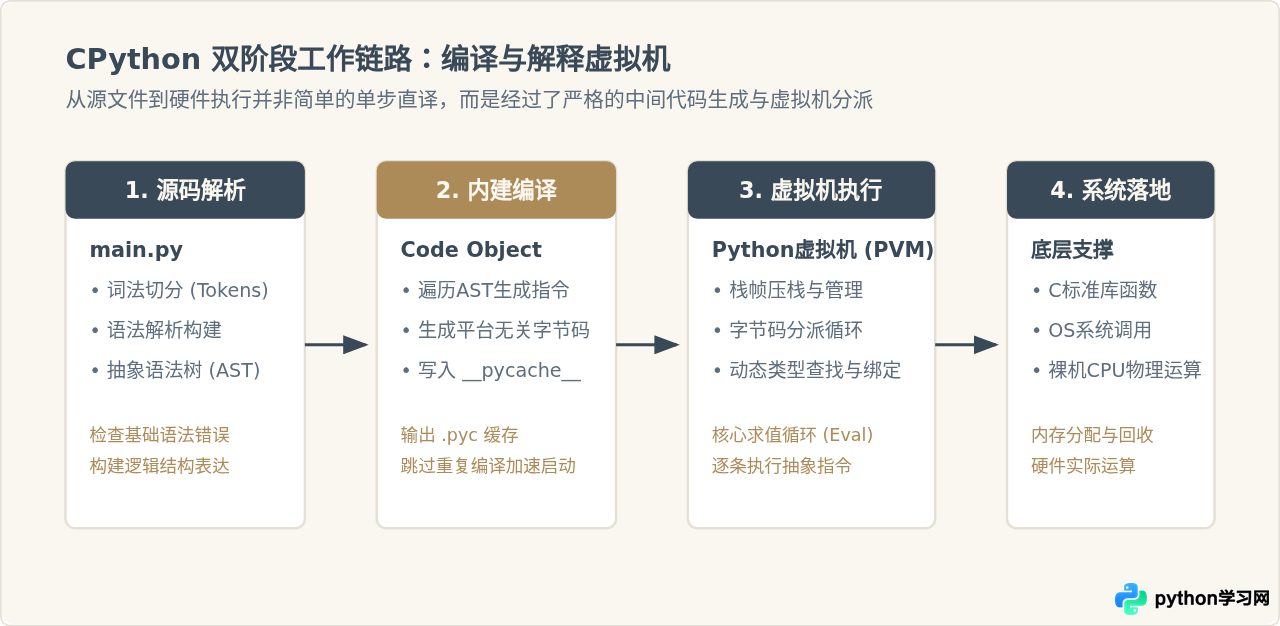
这个流程清晰地展现出:Python在执行前确实进行了编译。工程项目中常见的 __pycache__ 目录与 .pyc 文件就是最好的实物证据。当 Python 导入一个模块时,会将编译好的字节码写入 .pyc 文件中;下次运行时只要源文件修改时间未变,就会直接跳过第一阶段的源码解析与语法树编译,直接把字节码灌入 PVM 运行。
三、代码实证:用 dis 模块透视 Python 的编译产物
为了让这个过程更具实体感,我们可以通过标准库自带的 dis(Disassembler)模块,直接查看编译器输出的抽象字节码:
import dis

def calculate(a, b):
    result = a + b
    return result

# 打印编译后函数对应的虚拟机指令序列
dis.dis(calculate)
运行上述脚本后,将获得以下输出结构:
  4           0 LOAD_FAST                0 (a)
              2 LOAD_FAST                1 (b)
              4 BINARY_OP                0 (+)
              8 STORE_FAST               2 (result)

  5          10 LOAD_FAST                2 (result)
12 RETURN_VALUE在上面的反汇编结果中,LOAD_FAST、BINARY_OP、STORE_FAST 和 RETURN_VALUE 就是 Python 编译器输出的标准字节码。PVM 本质上是一个基于栈的虚拟机(Stack-based VM),这些操作码(Opcodes)正是它所能识别的“机器语言”。由此可见,Python 绝非在运行时直接扫描分析字符串 "result = a + b",它在真正运行前已经经过了严格的语义编译。
四、机制剖析:为什么 Python 没有像 C/C++ 那样的传统编译器?
既然 Python 已经拥有了能够将源码转换为字节码的编译器,为什么官方团队没有顺理成章地开发一个传统 Ahead-of-Time(AOT)编译器,直接把 Python 代码一步到位编译成特定平台的 .exe、.so 或 ELF 机器码呢?
这并非技术实现上的疏忽,而是 Python 的核心语言特质从根本上制约并否定了传统静态编译器的适用性。
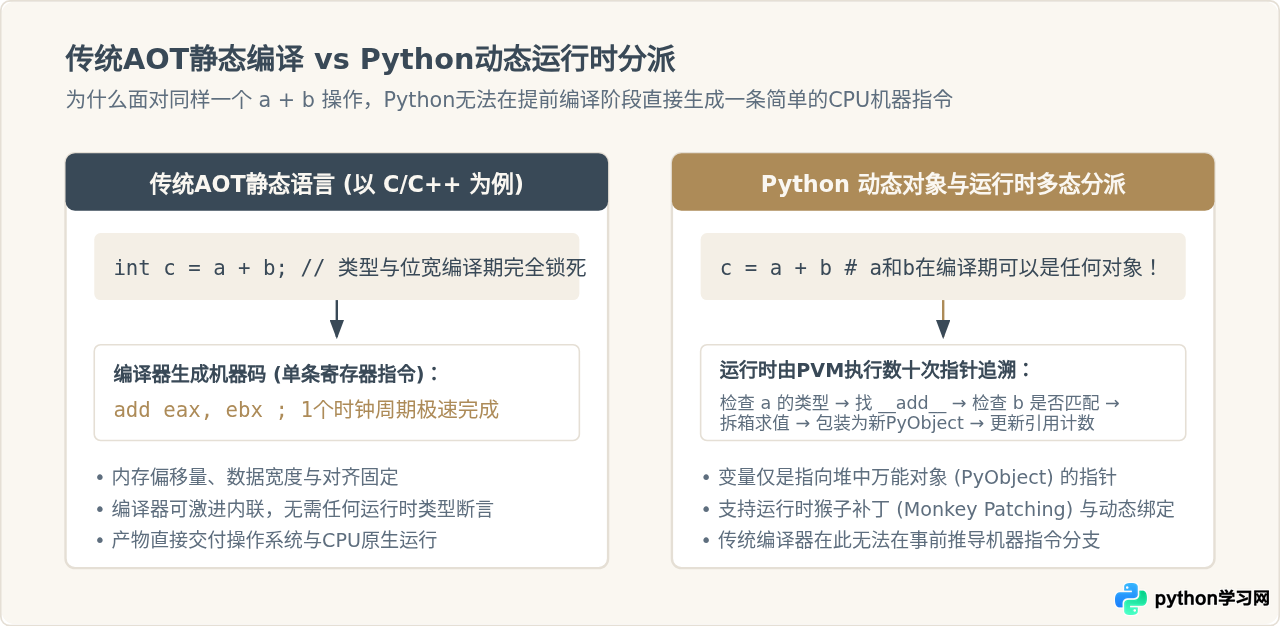
具体而言,传统编译器无法直接服务于原生 Python 的主要原因包括:
- 极端的动态类型(Dynamic Typing):在 C 语言中,声明
int a意味着编译器确切知晓变量占用 4 个字节,可以直接在栈上预留空间并生成特定寄存器指令。而在 Python 中,a只是一个指向堆内存中PyObject的动态引用。在运行到特定行之前,编译器根本无法预测a究竟是整数、浮点数、字符串还是自定义对象。 - 运行时修改一切(Runtime Mutability):Python 允许在运行时动态给类绑定新方法、重写已有函数(Monkey Patching),甚至是直接通过
eval()执行动态代码。如果传统编译器在静态阶段将方法调用写死为特定的硬件内存地址跳变,整个动态生态将被直接摧毁。 - 一切皆对象与装箱开销:在 Python 中,哪怕是一个简单的整数
1也是一个包含引用计数、类型指针、对象大小及数值数据的复合结构体。传统编译器擅长的矢量化(SIMD)、循环展开、寄存器分配等优化手段,在面对充满间接指针寻址的对象模型时效能极为低下。 - 平台便携性与分发成本:如果像传统编译器那样直接编译为原生二进制,开发者就必须为 Windows、Linux、macOS 以及各类 CPU 架构(x86、ARM、RISC-V)分别交叉编译。而采用“源码 → 平台无关字节码 → 各平台PVM解释”的策略,使 Python 真正实现了“一份代码,处处运行”。
五、区分语言与实现:打破“Python只能解释”的迷思
必须厘清的一个关键边界是:Python 是一门编程语言的语法规范,而 CPython 只是这门语言的标准参考实现。除了官方的 CPython,开源社区为了解决纯虚拟机解释带来的性能损耗,衍生出了多种截然不同的编译器和执行后端。
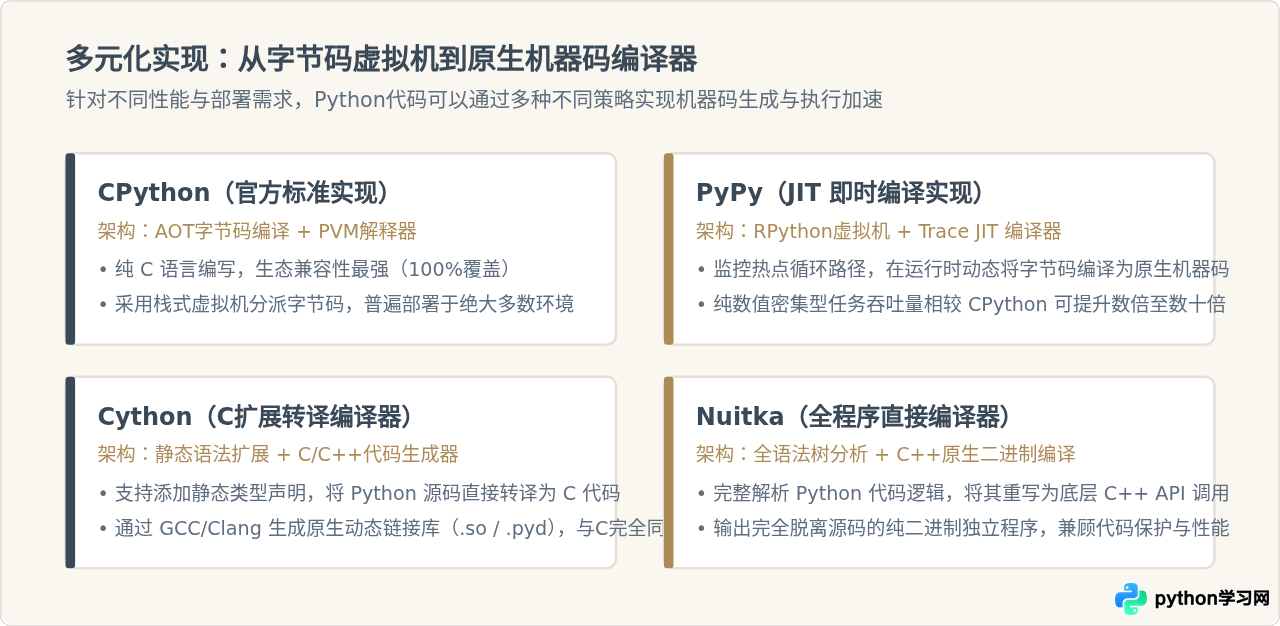
从图中可以看出,如果你的业务场景确实需要“传统编译器”带来的性能提升或二进制打包能力,Python 生态中早已有成熟方案:
- 通过 PyPy,利用 JIT 运行时即时编译,无需改变任何代码即可生成机器码运行;
- 通过 Cython,为关键热点代码赋予静态类型声明,直接编译为原生 C 共享库供主程序调用(这也是 NumPy、SciPy 底层极其高效的关键基石);
- 通过 Nuitka,将整个 Python 项目整体静态编译为单一的二进制可执行文件。
六、概念归纳:重新理解现代编程语言的边界
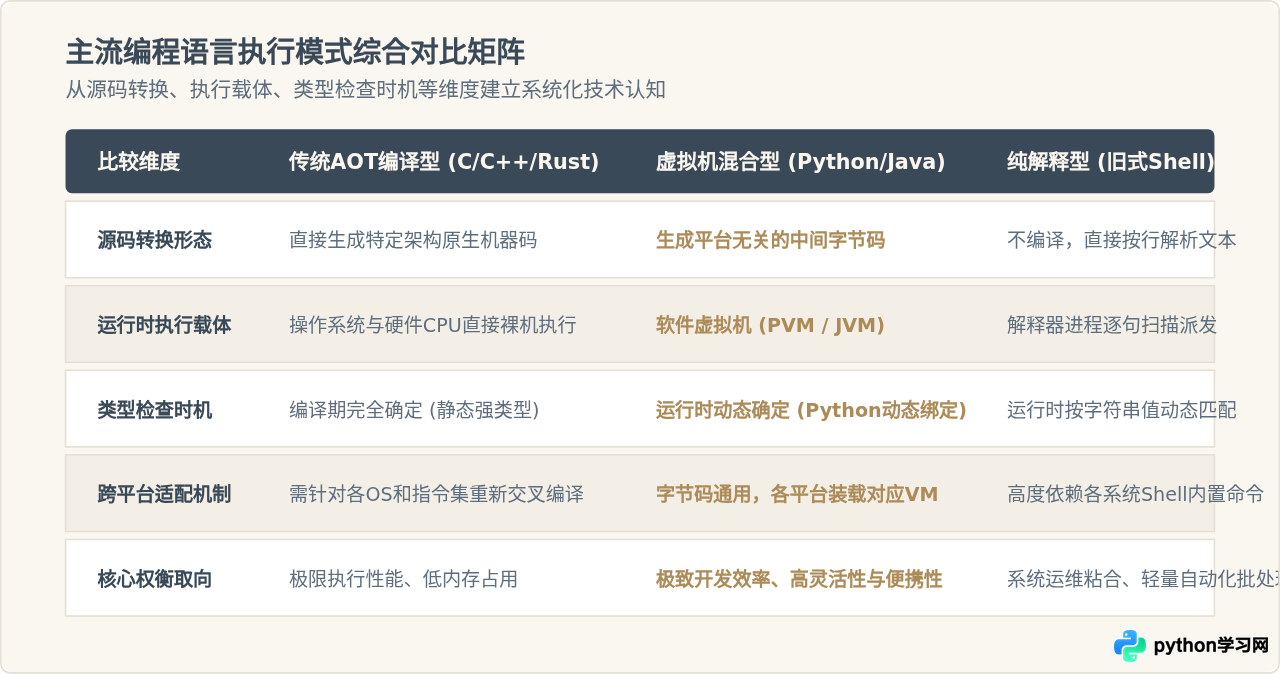
为了让知识结构形成闭环,我们将传统编译型、虚拟机混合型以及纯脚本解释型语言的关键技术维度整理如下:
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















