


Python和Java运行性能差距:解释型与编译型的效率分析

在纯 CPU 计算密集的纯算法循环中,标准 Java(基于 HotSpot JVM)的运行耗时往往只有标准 Python(CPython)的几十分之一到十几分之一。这种悬殊的性能差距并非偶然,而是源于两门语言在底层设计哲学上的根本分歧:静态编译与即时编译(JIT)生成的原生机器码,对比基于虚拟机的逐条字节码解释;紧凑的原生内存排布,对比全对象的包装与动态寻址。但在日常工程实践中,许多场景下的二者响应速度却差距不大,甚至在引入底层 C 扩展后 Python 可以抹平差距。本文将具体剖析两者的执行管道、底层机制差异以及实际场景下的效率真相。
一、执行管道与运行时架构对比
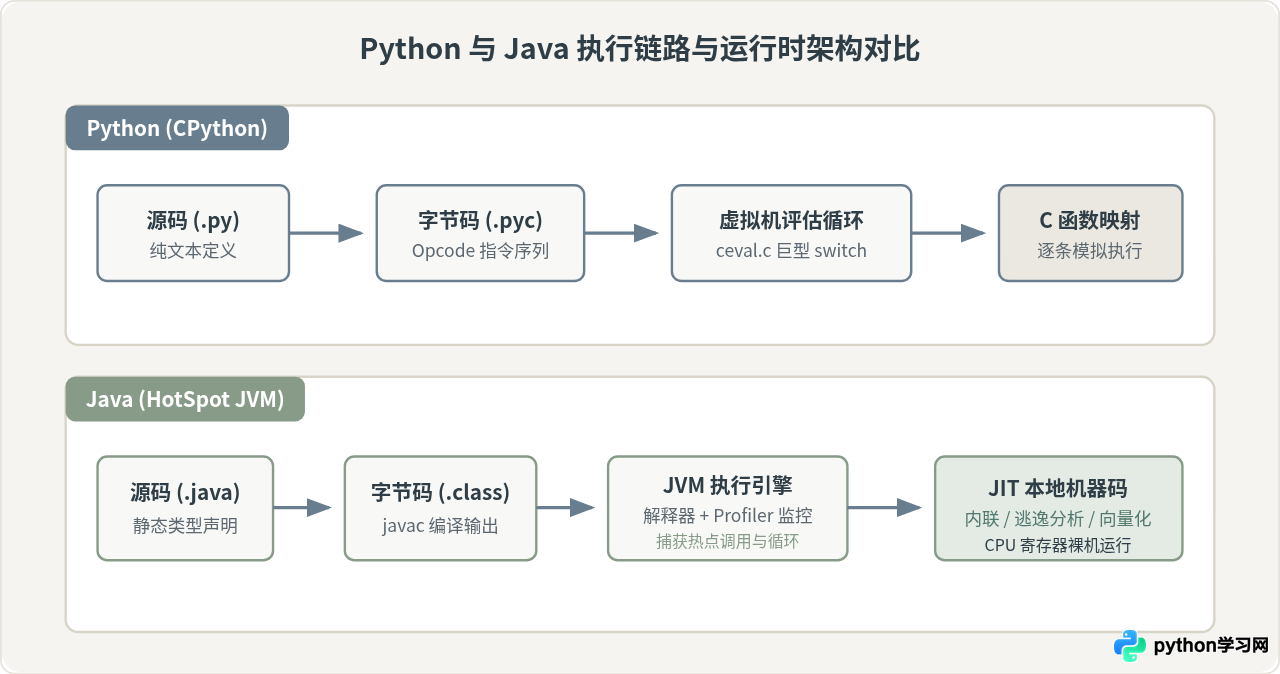
要理解性能差距,首先需要看一段源码从写入文本文件到最终被 CPU 执行时,中间经过了哪些步骤。Python 与 Java 虽然都采用了“源码先编译为字节码”的设计,但处理字节码的方式存在本质分野。
在标准 Python(CPython)中,解释器将 .py 脚本编译为内存中的代码对象或磁盘上的 .pyc 字节码。随后,虚拟机进入一个核心的执行循环(在 CPython 源码中对应 ceval.c 的巨型 switch 循环),一次读取一条字节码指令,根据当前操作码判断操作类型并调用对应的 C 函数执行。在此过程中,没有将代码转换为 CPU 原生机器指令的环节,每一步运算都包含虚拟机指令分发的调度损耗。
Java 则通过 javac 将源码编译为标准的 .class 字节码。当 JVM(以主流的 HotSpot 为例)启动时,初期同样采用解释器逐条执行字节码以保证快速启动。但 JVM 内部运行着高效的性能分析探测器(Profiler),持续统计代码段的调用频次与循环执行次数。一旦某段代码被识别为“热点代码”,JIT 编译器(C1/C2 或 Graal)就会在后台将其直接编译为对应 CPU 架构的高优化原生机器指令,并缓存至代码缓存区(Code Cache)。后续再次调用时,CPU 直接执行裸机指令,不再经过任何虚拟机解释环节。
二、关键效率瓶颈的深度剖析
许多初学者认为解释执行慢仅仅是因为“多了一层翻译”,但在现代计算机体系结构下,制约运行速度的真正元凶是类型系统的动态开销与内存布局对 CPU 缓存的不友好。
1. 动态类型检查与全对象包装(Boxing Overhead)
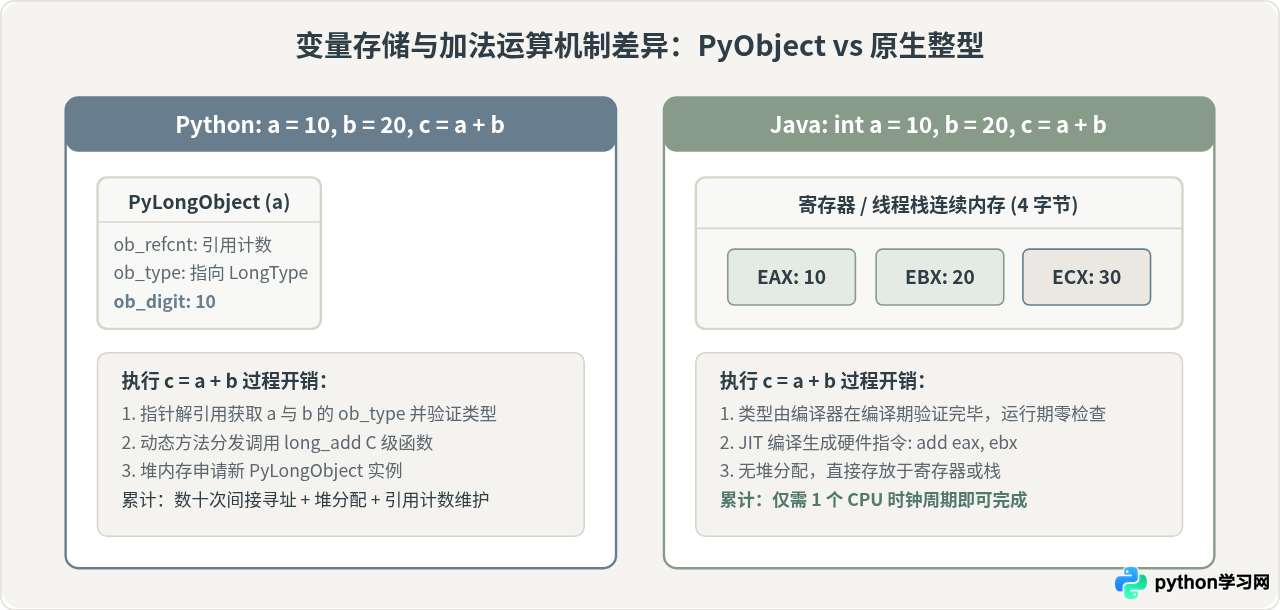
在 Java 中,当声明 int a = 10; int b = 20; int c = a + b; 时,编译器与 JVM 明确知晓 a 和 b 是 32 位整型原生数据(Primitive Type)。在经过 JIT 编译后,这行运算会被直接翻译为一条汇编指令:
add eax, ebx该操作在 CPU 的算术逻辑单元(ALU)中只需 1 个时钟周期即可完成,变量直接存储在硬件寄存器或连续的栈帧内存中,毫无多余负担。
而在 Python 中,即便只是写下 a = 10,解释器也会在堆上实例化一个完整的 PyLongObject。这个对象除了数值本身外,还必须携带引用计数(ob_refcnt)、类型指针(ob_type)以及可变精度元数据。当执行 c = a + b 时,Python 解释器在运行时必须经历如下繁复步骤:
- 通过指针访问
a的对象头,检查其ob_type是否为整型; - 通过指针访问
b的对象头,检查其类型是否为整型; - 判断两个对象是否重载了
__add__运算符或调用内部的long_add函数; - 从各自的结构体字段中提取实际数值并进行加法运算;
- 在堆内存中申请分配一个新的
PyLongObject来存放结果,并设置新的引用计数。
原本只需 1 个 CPU 指令完成的操作,在 Python 动态机制下演变为数十次内存间接寻址、分支预测判断以及内存分配调用,耗时自然呈数量级增长。
2. 内存布局与 CPU 缓存行(Cache Line)局部性
现代计算机的高速缓存(L1/L2/L3 Cache)以 64 字节的缓存行(Cache Line)为单位从主内存批量载入数据。代码的运行性能高度依赖对这一机制的利用率:
- Java 数组:当分配
int[] arr = new int[1000]时,JVM 在内存中开辟一段整齐紧凑的连续空间,连续存放 1000 个 4 字节整数。当 CPU 访问第一个元素时,相邻的 15 个整数会被硬件预取器直接载入 L1 缓存,遍历访问几乎全是缓存命中(Cache Hit)。 - Python 列表:Python 中的
list = [10, 20, 30, ...]实际上是一个存放指针的数组(PyObject**)。列表本身连续存放的只是指向堆内存不同位置的 64 位指针,而真实的数据分散在堆的各个角落。遍历列表时,每一次取值都需要通过指针跳到堆中不同内存页,导致极高概率的缓存未命中(Cache Miss),CPU 必须停滞(Stall)数十甚至上百个周期等待从主内存搬运数据。
3. 线程模型与多核并行支持
在多线程并发利用多核 CPU 算力方面,两者机制截然不同:
- Python GIL(全局解释器锁):为了保护 CPython 内部复杂的对象引用计数和内存池不发生数据竞争,CPython 强制要求同一进程内的多个原生线程必须持有全局解释器锁(GIL)才能执行 Python 字节码。这意味着无论机器拥有多少物理核心,在纯 Python 代码下只能有一个线程真正处于运行态,无法通过多线程加速 CPU 密集型任务。
- Java JVM 线程模型:JVM 中的
java.lang.Thread直接一对一映射到底层操作系统的内核线程(1:1 模型),或者在现代 Java 21+ 中使用高并发虚拟线程(Loom)。所有核心可以同时全速执行机器码,配合 JVM 成熟的并发内存模型(JMM)与无锁原子指令(CAS),在多核高负载场景下能够线性释放硬件算力。
三、基准测试设计与真实对比分析
为了直观说明问题,必须建立一个严谨公平的基准对比测试,避免不科学的比较产生误导。常见的对比误区包括:未对 JVM 进行预热就统计时间(把类加载和 JIT 编译时间算作执行耗时)、或者拿 Python 的底层 C 库与 Java 裸循环对比。
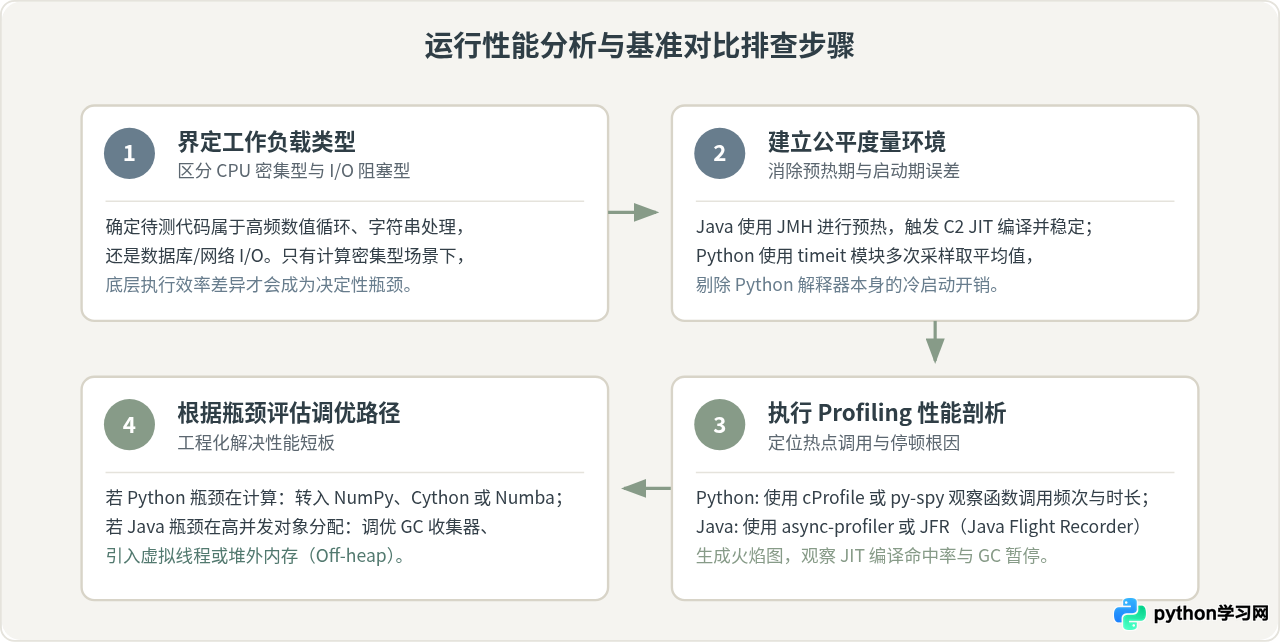
1. 性能对比验证步骤
要精确测量两者的性能差异,应按以下四步操作:
2. 典型计算场景数据示例
以经典的“1000 万次数值累加与质数判定算法”为例,在相同硬件规格下(x86_64, 8 核 16G 内存环境),我们对比纯语言原生循环与经过生态工具加速后的耗时表现:
| 测试实现方案 | 主要运行特征 | 耗时量级(示例) | 性能倍率基准 |
|---|---|---|---|
| Python (原生 CPython) | 解释器循环,全对象装箱,频繁引用计数与动态检查 | 约 1850 ms | 基准(1x) |
| Python (PyPy JIT) | 追踪即时编译器,热点分支内联并生成机器码 | 约 120 ms | 约 15x |
| Python (Numba JIT) | 借助 LLVM 生成原生机器指令,剥离 Python 对象头 | 约 35 ms | 约 50x |
| Java (HotSpot C2 JIT) | 原生 int 数组,循环展开与 SIMD 自动向量化指令 | 约 32 ms | 约 55x |
从数据中可以清晰看到:原生 Python 与原生 Java 之间存在约 50 倍的纯算力差距;但一旦 Python 引入了 JIT(如 PyPy、Numba)或通过底层 C 扩展处理计算,性能差距就会被压缩在同等数量级之内。
四、为什么 Python 在许多场景下并没有“慢得无法忍受”?
既然底层性能存在数十倍的差距,为什么 Python 依然能成为数据科学、人工智能和海量云原生服务的首选语言?这涉及工程中的阿姆达尔定律(Amdahl's law)与系统瓶颈转移:
- I/O 掩盖了计算开销:在 Web API、微服务与日常业务系统中,程序绝大多数时间都在等待网络数据包(HTTP/gRPC 请求)、磁盘文件读取或数据库查询结果。一个网络往返往往耗时数十毫秒(如 50ms),而业务代码的解析与拼接仅需 0.5ms。将 0.5ms 优化为 0.01ms 对用户端感知几乎毫无影响。
- 胶水语言的“降维打击”:在深度学习与高性能数值计算领域(如 NumPy、PyTorch、TensorFlow、Polars),Python 仅仅充当顶层的 API 声明与调度胶水。底层真正的矩阵运算全部运行在高度针对 AVX-512、CUDA 以及硬件加速器优化的 C++ / CUDA / Fortran 静态库上。此时执行性能由 GPU 与底层原生库决定,Python 的解释开销被完全边缘化。
五、工程选型与效率决策指南
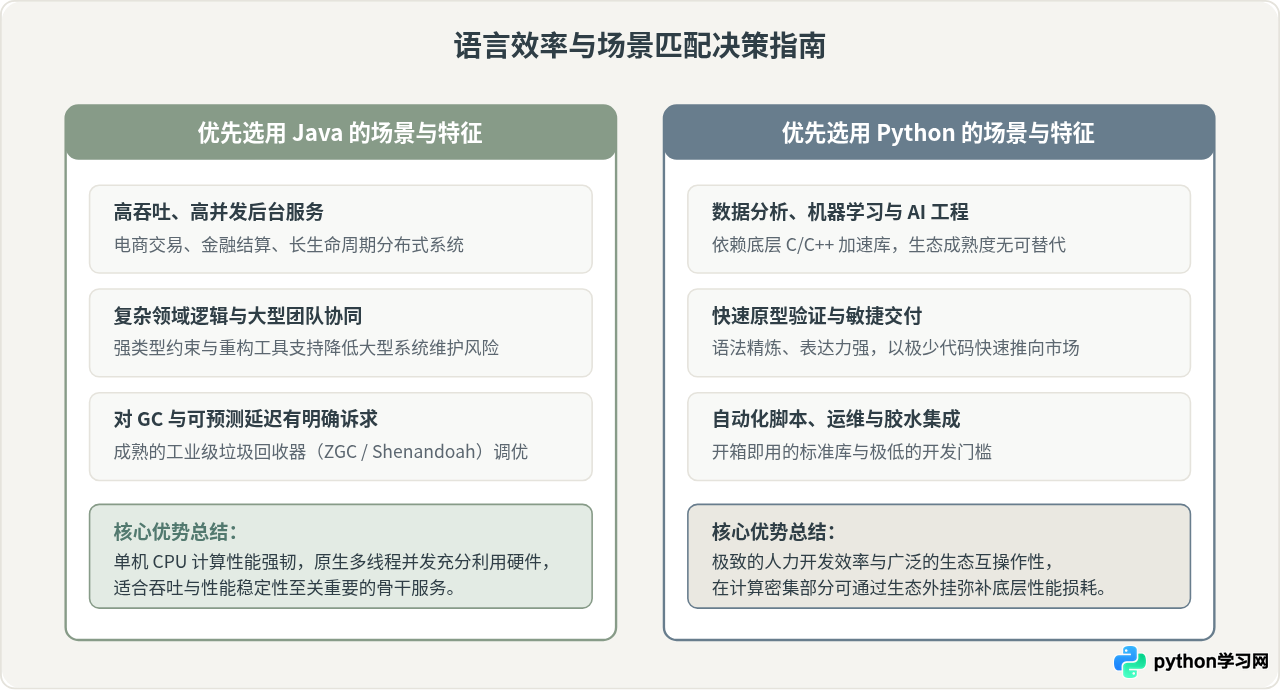
在面对具体的项目选型时,团队不应脱离业务场景盲目追求基准跑分,而应根据系统的核心矛盾选择最合适的工具。
六、总结与落地建议
综上所述,Python 和 Java 之间的运行性能差距是真实且深刻的。Java 的高效率建立在其强静态类型系统、严谨的内存排布以及成熟强大的 JIT 编译优化之上;而 Python 选择将极致的动态灵活性与开发者友好度放在第一位,牺牲了原生字节码循环的执行速度。
在面对性能问题时,合理的工程态度应当是:
- 不脱离具体瓶颈空谈语言快慢。若系统瓶颈在数据库、网络或磁盘,语言层面的毫秒级优化往往不如优化索引、连接池或缓存架构来得直接;
- 在以高并发、纯算法吞吐、复杂交易为核心的长生命周期服务中,坚定选择 Java 等静态类型及成熟 JIT 支撑的技术栈;
- 在数据科学、AI 训练与推理、快速原型和胶水自动化场景中,充分利用 Python 的表达力与底层高性能 C 扩展,让机器服务于人的开发效率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















