


Python difflib实现基础模糊搜索的方法
本文详细介绍如何使用Python内置的标准库difflib实现基础模糊搜索,深入解析get_close_matches与SequenceMatcher的工作原理、参数调优、结构化数据映射实践及适用性能边界。
difflib 模块提供了无外部依赖的序列比对与相似度计算机制,通过其封装的 get_close_matches 函数与底层的 SequenceMatcher 类,可以非常轻量地实现基础模糊搜索与纠错推荐。本文将完整介绍该方案的工作流程、核心接口调用、参数配置要点、复杂对象检索封装以及工程适用的性能边界。
一、difflib 模糊搜索的整体工作流程
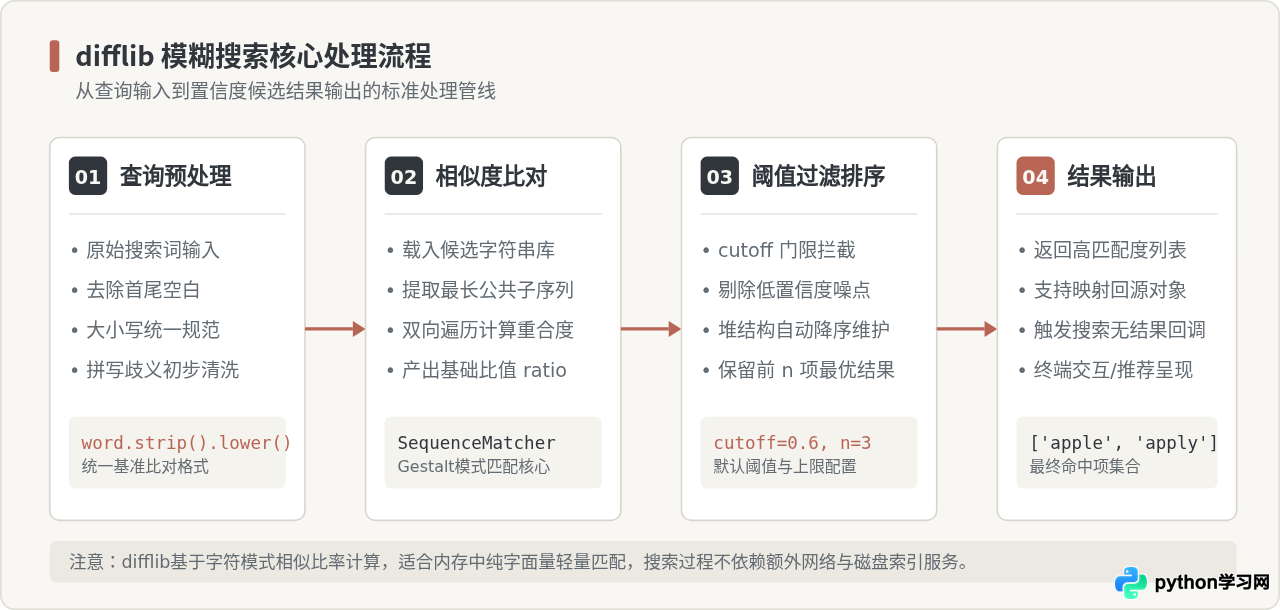
difflib 属于 Python 标准库的基础内置工具,主要用于比较序列之间的差异,其底层依赖于 Gestalt Pattern Matching 算法(一种基于最长公共子序列的启发式匹配算法)。使用 difflib 实施基础模糊搜索时,系统通常遵循四步执行流程:首先对用户输入的原始字符串进行清洗与归一化;随后将查询词与预先准备的候选词库进行逐一比对并计算相似比值;再通过预设的相似度门限(cutoff)过滤掉偏差过大的噪点;最后按相似度降序截取前 N 项高匹配度结果返回给调用端。
二、核心函数与相似度计算机制
在实际编写代码时,开发者通常接触两个层级的接口:便捷函数 difflib.get_close_matches 和基础比对引擎 difflib.SequenceMatcher。理解二者的对应关系是合理配置参数的前提。
1. 便捷函数 get_close_matches 的签名与行为
get_close_matches 是标准库中最常用的模糊搜索入口,函数定义如下:
difflib.get_close_matches(word, possibilities, n=3, cutoff=0.6)各参数的具体作用如下:
- word:待查询的目标字符串(用户输入的可能包含拼写偏差的词)。
- possibilities:用于比对的候选字符串列表。
- n:最大返回匹配项的数量,默认为 3,必须大于 0。
- cutoff:相似度截断阈值,取值范围在
[0.0, 1.0]之间,默认为 0.6。相似度低于该阈值的候选词将被直接忽略。
2. 底层 SequenceMatcher 的相似度数学原理
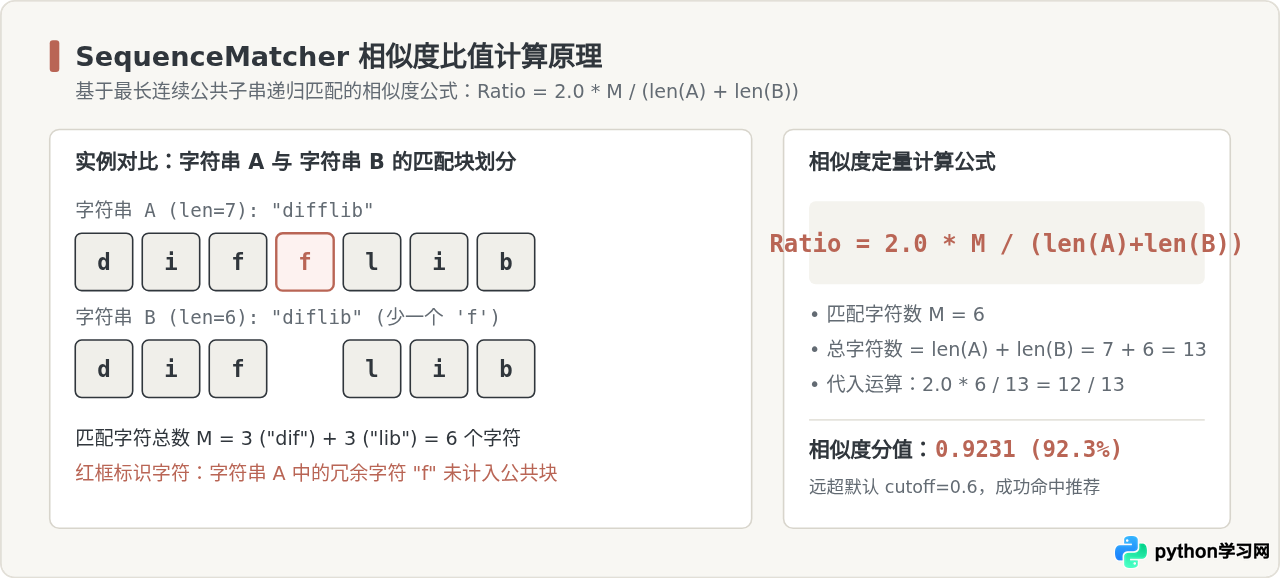
get_close_matches 内部通过创建 SequenceMatcher(None, word, candidate) 计算比值。该类寻找两个序列中最长的无间断连续匹配子序列,随后在未匹配部分递归寻找次长子序列。最终相似度比值(ratio)由以下公式决定:
Ratio = 2.0 × M / (len(A) + len(B))
其中 M 为所有匹配块包含的字符总数,len(A) 与 len(B) 分别为两个字符串的字符总长度。比值结果严格在 0.0(完全不匹配)到 1.0(完全相同)之间。
三、基础字符串列表模糊搜索实践
在最简使用场景下,我们只需要纠正控制台输入的单条命令或用户参数。下面的完整脚本演示了基础调用、截断阈值的作用以及未命中时的处理方式:
import difflib

# 1. 预先定义的有效系统命令集
valid_commands = [
    "install", "uninstall", "update", "upgrade",
    "config", "checkout", "commit", "status"
]

def suggest_command(user_input: str) -> None:
    # 基础预处理:去除前后空格
    cleaned_input = user_input.strip()

    # 完全匹配直接放行
    if cleaned_input in valid_commands:
        print(f"执行命令: {cleaned_input}")
        return

    # 进行模糊匹配,默认返回最多 2 个相似度不低于 0.5 的建议
    matches = difflib.get_close_matches(cleaned_input, valid_commands, n=2, cutoff=0.5)

    if matches:
        print(f"未找到命令 '{cleaned_input}'。您是否是指: {', '.join(matches)}?")
    else:
        print(f"未找到命令 '{cleaned_input}',未检索到相似有效命令。")

# 示例验证调用
if __name__ == "__main__":
    suggest_command("instal")   # 拼写遗漏: 您是否是指: install?
    suggest_command("upgrde")   # 字母倒序/缺漏: 您是否是指: upgrade, update?
suggest_command("xyz123") # 无关字符: 未检索到相似有效命令cutoff 值的选择直接决定了搜索的宽松程度。在单词长度较短(小于 5 个字符)时,0.6 的阈值可能过于严格,导致漏掉单字符缺失的候选词。如果业务要求尽可能宽松召回,可将 cutoff 降低至 0.45 ~ 0.5;若要求高度精准,避免误判,可提升至 0.75 ~ 0.8。
四、结构化数据(字典与实体列表)的模糊检索实践
在实际项目中,业务数据通常不是单一的字符串列表,而是由字典组成的列表(例如包含 ID、标题、价格、标签的商品或文档)。然而 get_close_matches 仅接受纯字符串列表。为了对结构化数据进行模糊搜索,标准做法是建立“归一化检索键到源对象的映射字典”,比对完成后再反查原始实体。
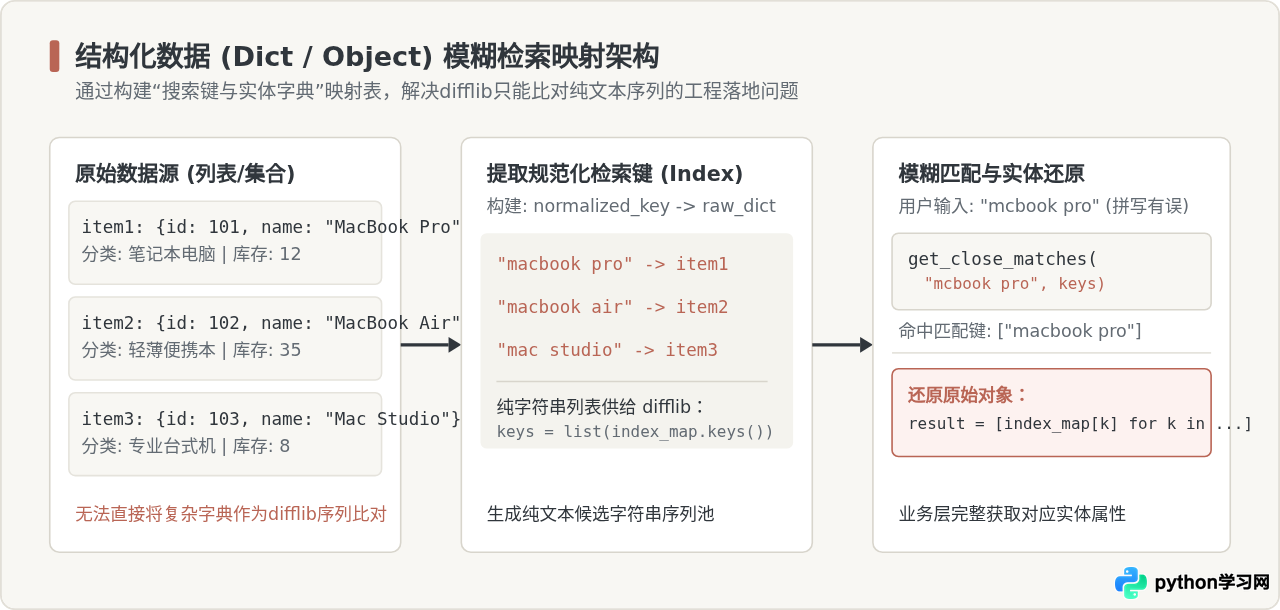
下面是实现结构化字典列表模糊搜索的可复用封装类:
import difflib
from typing import List, Dict, Any, Optional

class FuzzyDictSearcher:
    """基于 difflib 实现的轻量级字典列表模糊检索器"""

    def __init__(self, data: List[Dict[str, Any]], search_field: str):
        self.raw_data = data
        self.search_field = search_field
        self._index: Dict[str, Dict[str, Any]] = {}
        self._build_index()

    def _build_index(self) -> None:
        """构建归一化检索索引字典"""
        for item in self.raw_data:
            field_val = item.get(self.search_field)
            if isinstance(field_val, str) and field_val.strip():
                # 统一转为小写并去除两端空格作为检索索引键
                norm_key = field_val.strip().lower()
                self._index[norm_key] = item

    def search(self, query: str, limit: int = 3, threshold: float = 0.5) -> List[Dict[str, Any]]:
        """执行模糊查询并返回匹配的原始字典列表"""
        cleaned_query = query.strip().lower()
        if not cleaned_query:
            return []

        # 获取匹配的键列表
        matched_keys = difflib.get_close_matches(
            cleaned_query,
            self._index.keys(),
            n=limit,
            cutoff=threshold
        )

        # 映射回原始数据实体
        return [self._index[key] for key in matched_keys]

# 测试代码
if __name__ == "__main__":
    products = [
        {"id": 101, "name": "Logitech MX Master 3", "category": "鼠标", "price": 599},
        {"id": 102, "name": "Apple Magic Keyboard", "category": "键盘", "price": 799},
        {"id": 103, "name": "Keychron Q1 Pro", "category": "键盘", "price": 1099},
        {"id": 104, "name": "Dell UltraSharp 27 Monitor", "category": "显示器", "price": 2899}
    ]

    searcher = FuzzyDictSearcher(products, search_field="name")

    # 模糊查询存在大小写与漏打的查询词
    query = "keychron q1"
    results = searcher.search(query, threshold=0.55)

    print(f"搜索 '{query}' 命中结果数量: {len(results)}")
    for res in results:
        print(f" - [{res['id']}] {res['name']} (分类: {res['category']}, 价格: {res['price']}元)")
五、参数调优与典型工程细节
在使用 difflib 落地具体功能时,有两个容易导致非预期行为的细节需要特别注意:
1. 大小写敏感与空白规范
difflib 是逐字符的 ASCII/Unicode 码位比对,因此 "Python" 与 "python" 之间的首字母被视为完全不同的字符。如果不在检索前显式统一执行 .lower() 或 .casefold(),字符串相似度将出现严重损失。
2. SequenceMatcher 的 autojunk 参数陷阱
在直接使用底层 difflib.SequenceMatcher 时,构造方法默认设置了 autojunk=True。如果候选文本序列中某些字符出现的频次过高(例如特定字符出现次数超过总字符数的 1% 且长度达到设定条件),算法会自动将其标记为“垃圾字符”并不参与匹配。在处理短文本、配置文件路径或高频特定词时,这可能导致部分有效字符被无端忽略,造成相似度计算偏差。若需保持严格的逐字符匹配,可显式传递 autojunk=False:
# 显式关闭 autojunk 保证短文本与特定符号的严格比对
matcher = difflib.SequenceMatcher(None, str_a, str_b, autojunk=False)
exact_ratio = matcher.ratio()
六、方案适用边界与选型决策总结
difflib 的最大价值在于开箱即用、零第三方依赖交付。但这并不意味着它可以代替所有模糊搜索需求。在技术选型时,必须根据数据量规模与语言特征建立清晰的边界认知:
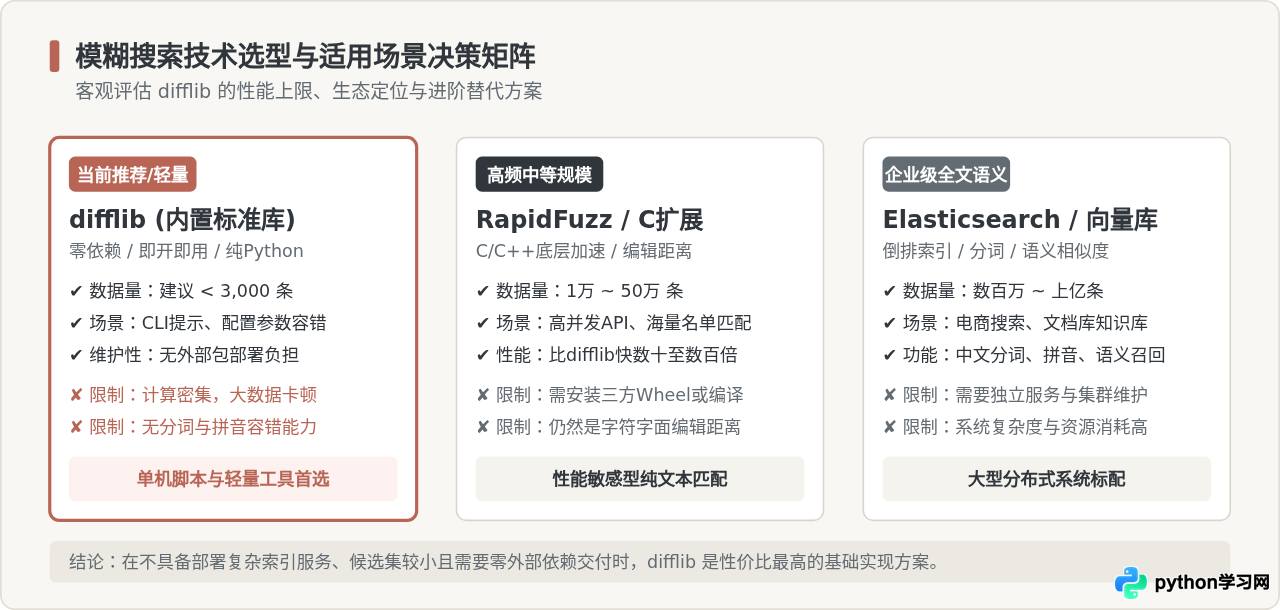
选型建议与总结
- 推荐使用场景:数据量在几百至三千项以内、单机 CLI 工具、自动化配置管理脚本、无需安装外部 C 扩展的受限容器环境。使用
difflib.get_close_matches可以用不到 5 行代码快速提升用户体验。 - 不推荐使用场景:候选集达到数万级以上(纯 Python 循环计算比值会导致明显的毫秒级甚至秒级卡顿);需要拼音纠错(如“pycharm”匹配“皮卡丘”这类中文拼音声母映射);长篇文档的全文关键词检索。对于此类需求,应果断引入 C 扩展的
RapidFuzz,或使用倒排索引数据库(如 SQLite FTS5、Whoosh、Elasticsearch)。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















