


Python列表推导式:用一行代码替代简单for循环
详细讲解Python列表推导式的核心语法、从传统for循环到推导式的三步转换方法、带条件的推导技巧以及可读性边界与最佳实践。
for 循环配合 append() 逐个追加。而列表推导式(List Comprehension)允许将这套固定的“定义容器—循环迭代—过滤变换—追加元素”逻辑收敛为单行表达式。它不仅消除冗余代码,还能借助底层 CPython 的字节码优化获得更快的执行速度。
一、为什么需要列表推导式:从繁琐循环到紧凑表达
编写数据处理逻辑时,创建新列表是极为高频的操作。例如获取一组数字的平方,初学者通常会写出如下代码:
# 传统 for 循环写法
numbers = [1, 2, 3, 4, 5]
squares = []
for n in numbers:
    squares.append(n ** 2)

# 输出示例:[1, 4, 9, 16, 25]
在这段代码中,真正承载计算意图的只有两处:数据源 numbers 和变换算式 n ** 2。然而为了完成任务,我们不得不单独开辟变量 squares = [],并反复调用方法 append()。而在 Python 中,使用列表推导式只需写成一行:
# 列表推导式写法
squares = [n ** 2 for n in numbers]

# 示例输出:[1, 4, 9, 16, 25]
这种写法直观表达了“以 n ** 2 为元素,对 numbers 中的每一个 n 构建新列表”的数学集合含义,代码行数从 4 行压缩到了 1 行,且意图更加聚焦。
二、推导式的标准语法构成
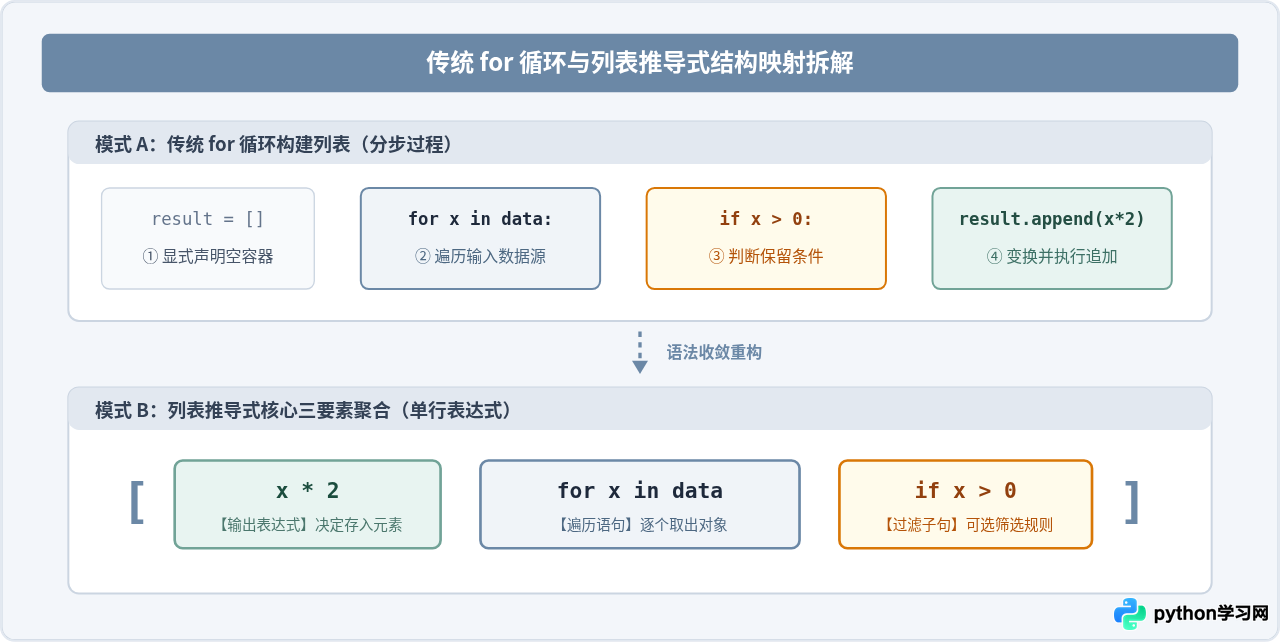
列表推导式的核心特征是外层用一对中括号 [...] 包裹。其基础语法骨架由以下两个必选部分和一个可选部分构成:
- 外层中括号
[...]:声明最终生成的结果是一个新的 Python 列表。 - 输出表达式(Expression):位于推导式的最左侧。每次循环且通过条件检验后,该表达式的求值结果将作为新列表中的一个元素。
- 循环迭代子句(for item in iterable):位于中间,指定遍历的数据来源以及当前的迭代变量名称。
- 条件过滤子句(if condition):位于末尾,属于可选部分。只有当该布尔表达式为
True时,对应元素才会被计算并收纳。
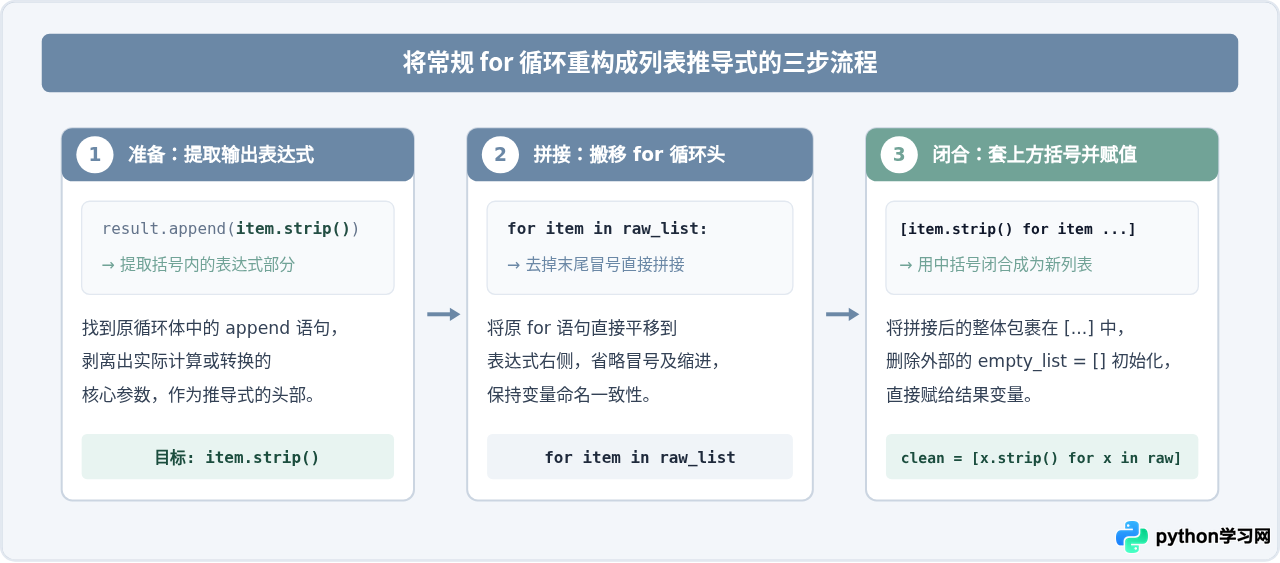
三、三步操作法:将常规循环重构为推导式
初学者在改写现有代码时,无需凭空构造,只需遵循一套机械化的三步提取流程即可保证逻辑无误:
实战演练:字符串清洗转换
假设我们有一批从用户表单或文件中读取的原始字符串,带有前后的多余空格,需要统一剔除并全部转为小写:
# 待处理原始数据
raw_users = ["  Alice ", "Bob\n", "  CHARLIE  ", " David"]

# 改写前:传统 4 行模式
clean_users = []
for user in raw_users:
    clean_users.append(user.strip().lower())

# 改写后:推导式 1 行模式
clean_users = [user.strip().lower() for user in raw_users]

# 示例输出:['alice', 'bob', 'charlie', 'david']user 只在推导式内部的作用域中生效(在 Python 3 中已被完全隔离),不会意外污染外部命名空间。
四、处理条件分支:过滤与二选一转换
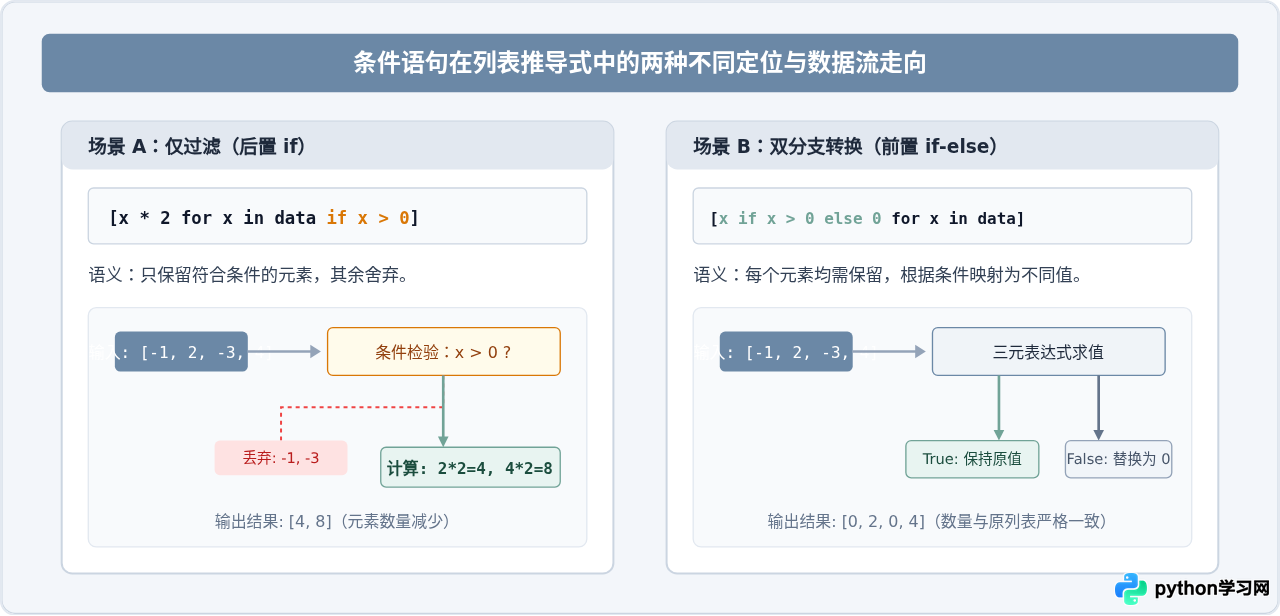
在实际循环中,我们经常遇到条件判断。在列表推导式中,if 关键字根据摆放位置的不同,承担着截然不同的语义,这是最容易让初学者混淆的地方:
- 放置在末尾(作为过滤子句):用于决定“要不要收录当前元素”。不满足条件的值直接被丢弃,生成的新列表长度往往小于原列表。
- 放置在前面(作为三元条件表达式):用于决定“元素如何转换”。每个元素都必须处理并保留,只是根据条件转换为不同的值,生成的新列表长度与原列表完全相同。
代码对比示例
scores = [85, 42, 90, 58, 76]

# 示例 1:过滤——只保留及格分数(>= 60)
passing_scores = [s for s in scores if s >= 60]
# 输出示例: [85, 90, 76]

# 示例 2:转换——及格标记为 'Pass',不及格标记为 'Fail'
score_labels = ["Pass" if s >= 60 else "Fail" for s in scores]
# 输出示例: ['Pass', 'Fail', 'Pass', 'Fail', 'Pass']if 后添加 else(例如写成 [x for x in data if x > 0 else 0] 会直接触发 SyntaxError)。若需要 else,必须将其作为三元运算整体写在 for 的左侧。
五、适用边界:何时用推导式,何时坚守普通 for 循环
列表推导式虽然简洁优雅,但它并不是普通 for 循环的无脑替代品。过度追求单行代码不仅会牺牲团队协作时的可读性,还可能造成性能隐患。遵循以下决策准则可以避免“滥用推导式”:
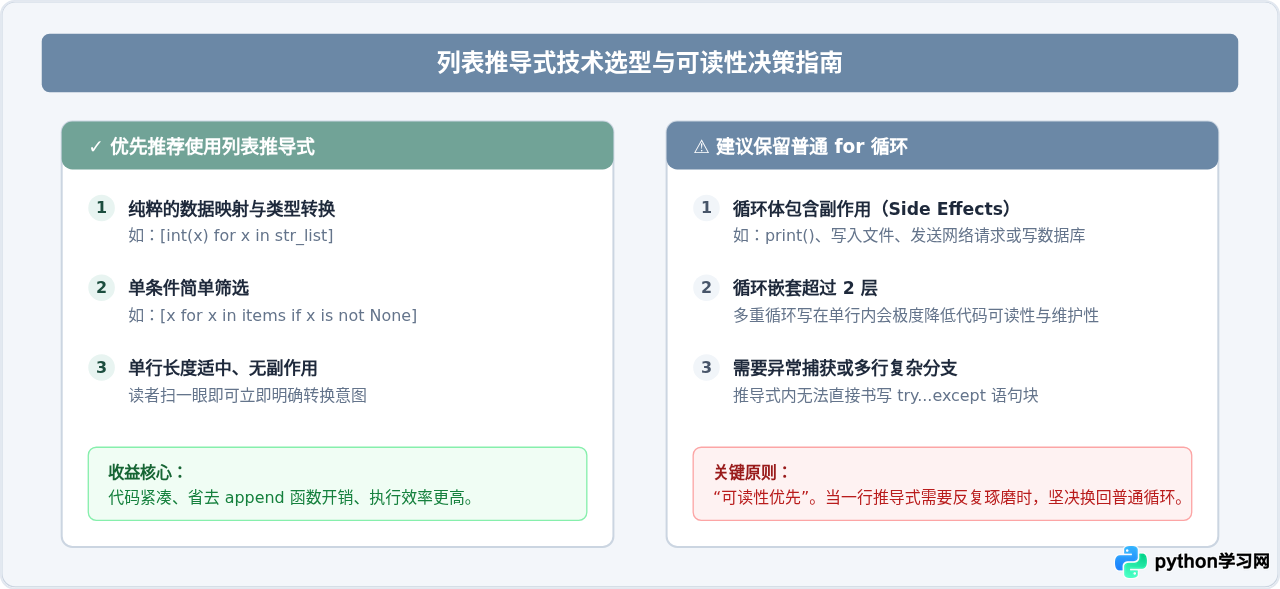
| 对比维度 | 列表推导式 | 传统 for 循环 |
|---|---|---|
| 代码行数 | 通常仅需 1 行 | 3 至 5 行以上(含初始化与追加) |
| 执行效率 | 更高(直接在 C 层面分配容量并装填,无 Python 级 append 属性查找与方法调用开销) | 略低(每次迭代均需解释执行 .append() 字节码) |
| 副作用支持 | 不推荐(违反函数式设计初衷,浪费生成列表的内存) | 原生支持(明确用于执行操作,而非单纯产出列表) |
| 复杂逻辑表达 | 弱(无法写 try/except、break 或 continue) |
极强(支持任意多行控制流与状态维护) |
六、常见误区与避坑建议
-
不要为了使用推导式而丢弃返回值:
反模式示例:[print(x) for x in data]。这种写法不仅会执行print,还会在内存中构建一个充满None的无用列表。若仅需要执行动作而不需要新列表,请直接使用普通的for x in data: print(x)。 -
注意大数据量时的内存占用:
列表推导式是一次性将所有元素计算完毕并加载到内存中。如果数据源包含数百万甚至数千万条记录,列表推导式可能会引发高内存消耗甚至内存溢出(OOM)。这种情况下,只需把外层的中括号[...]改为小括号(...),即可将其转变为惰性求值的生成器表达式(Generator Expression),实现逐个元素的按需流式消费。 -
保持格式整洁与适当换行:
如果推导式稍长,遵循 PEP 8 规范将表达式、for和if分行排版,同样能兼顾紧凑与高可读性:# 较长推导式的换行规范 processed_items = [ transform_data(item) for item in large_dataset if is_valid(item) and item.status == "active" ]
七、总结
Python 列表推导式是简化基础循环样板代码的利器。掌握它的核心在于理解它的三部分结构:最左侧定义“产生什么”,中间定义“从何而来”,末尾定义“筛选规则”。在日常编码中,对简单的映射、清洗和过滤任务勇敢使用列表推导式;遇到复杂业务分支或有副作用的逻辑时理性坚守常规循环,即可写出既高效又符合 Pythonic 风格的高质量代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















