


Python中%、divmod和math.fmod取余的区别
深入对比Python中%、divmod和math.fmod在底层机制、商取整规则、余数符号归属、浮点精度及大整数运算上的核心区别与选型策略。
在Python中计算除法余数时,开发者常用的工具主要有三种:取模运算符 %、内置函数 divmod() 以及标准库函数 math.fmod()。虽然它们在正整数相除时往往产生完全一致的结果,但在涉及负数运算、浮点数精度、大整数计算以及执行效率时,三者有着截然不同的数学定义与底层实现机制。本文将从数学定义、底层逻辑、代码表现到具体应用场景,系统剖析它们的本质差异,帮助读者在工程实践中准确选型。
一、核心机制速览:向下取整与向零取整
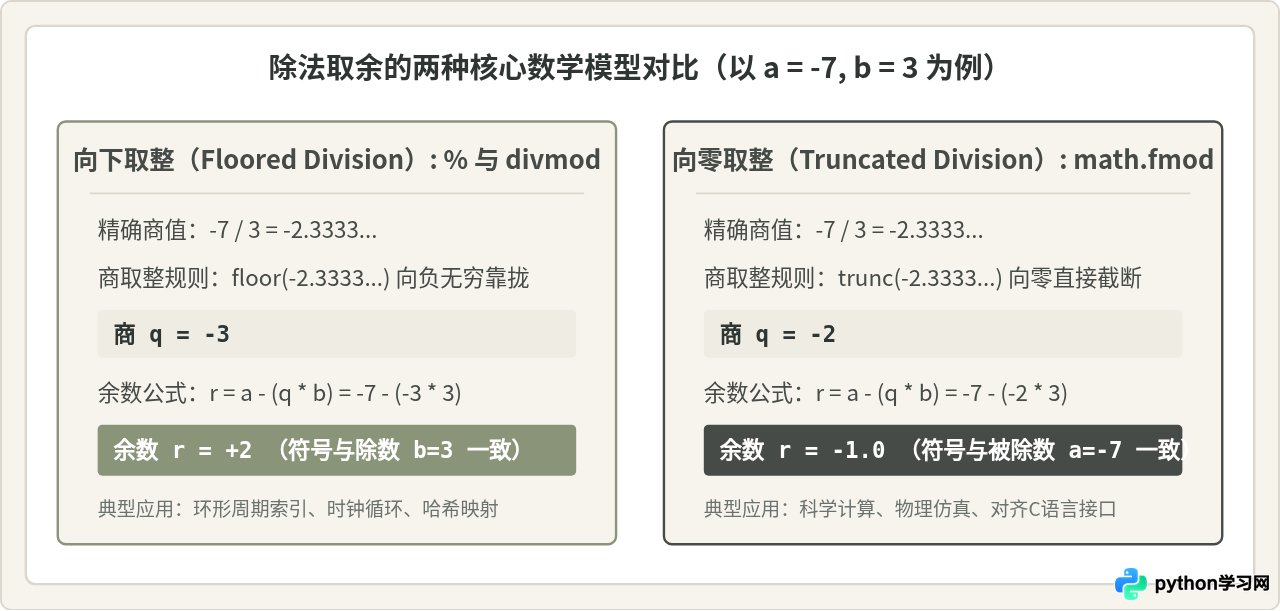
根据除法基本定理,任意两个实数 \(a\)(被除数)与 \(b\)(除数)进行带余除法时,满足恒等式:a = q * b + r,其中 \(q\) 为商,\(r\) 为余数。由此可见,余数 \(r\) 的值完全取决于商 \(q\) 的取整策略。Python中取余工具的核心分歧,正是源于对商 \(q\) 采用了不同的截断规则:
%运算符与divmod():遵循向下取整(Floored Division)原则。商向负无穷方向取整,即q = floor(a / b)。由此计算出的余数,其正负符号始终与除数 \(b\) 保持一致(或等于0)。math.fmod()函数:遵循C语言标准与IEEE 754规范的向零取整(Truncated Division)原则。商向零方向截断,即q = int(a / b)。由此计算出的余数,其正负符号始终与被除数 \(a\) 保持一致(或等于0)。
二、四组正负组合的实际计算行为
为了直观展现符号对结果的影响,我们测试被除数与除数在四种正负符号组合下的返回值:
import math

test_cases = [(7, 3), (-7, 3), (7, -3), (-7, -3)]

for a, b in test_cases:
    mod_res = a % b
    divmod_q, divmod_r = divmod(a, b)
    fmod_res = math.fmod(a, b)
    print(f"a={a:2d}, b={b:2d} -> %:{mod_res:2d} | divmod:({divmod_q:2d}, {divmod_r:2d}) | math.fmod:{fmod_res:4.1f}")
执行输出示例:
a= 7, b= 3 -> %: 1 | divmod:( 2,  1) | math.fmod: 1.0
a=-7, b= 3 -> %: 2 | divmod:(-3,  2) | math.fmod:-1.0
a= 7, b=-3 -> %:-2 | divmod:(-3, -2) | math.fmod: 1.0
a=-7, b=-3 -> %:-1 | divmod:( 2, -1) | math.fmod:-1.0
仔细观察可以发现以下关键特征:
- 在
a % b与divmod(a, b)中,当除数 \(b = 3\)(正数)时,余数一定为非负数(1 和 2);当除数 \(b = -3\)(负数)时,余数一定为非正数(-2 和 -1)。余数符号完全受除数掌控。 - 在
math.fmod(a, b)中,当被除数 \(a = 7\) 时,余数恒为正(1.0);当被除数 \(a = -7\) 时,余数恒为负(-1.0)。除数的正负符号对math.fmod的计算结果符号完全没有影响。
三、divmod() 的复合优势与性能剖析
许多初学者认为 divmod(a, b) 只是 (a // b, a % b) 的简单语法糖,但实际上它们在底层实现上存在显著差异。在CPython虚拟机中:
- 执行
a // b与a % b需要两次独立的字节码操作(BINARY_FLOOR_DIVIDE和BINARY_MODULO),这意味着CPU需要进行两次长整数除法运算。 - 调用
divmod(a, b)触发底层的PyNumber_Divmod,直接映射到C语言层面的long_divmod算法。在底层硬件与大整数算法中,除法与取余本质上是由同一个算术指令同时产出的,因此divmod只需遍历一次大整数数组,即可同时得到商和余数。
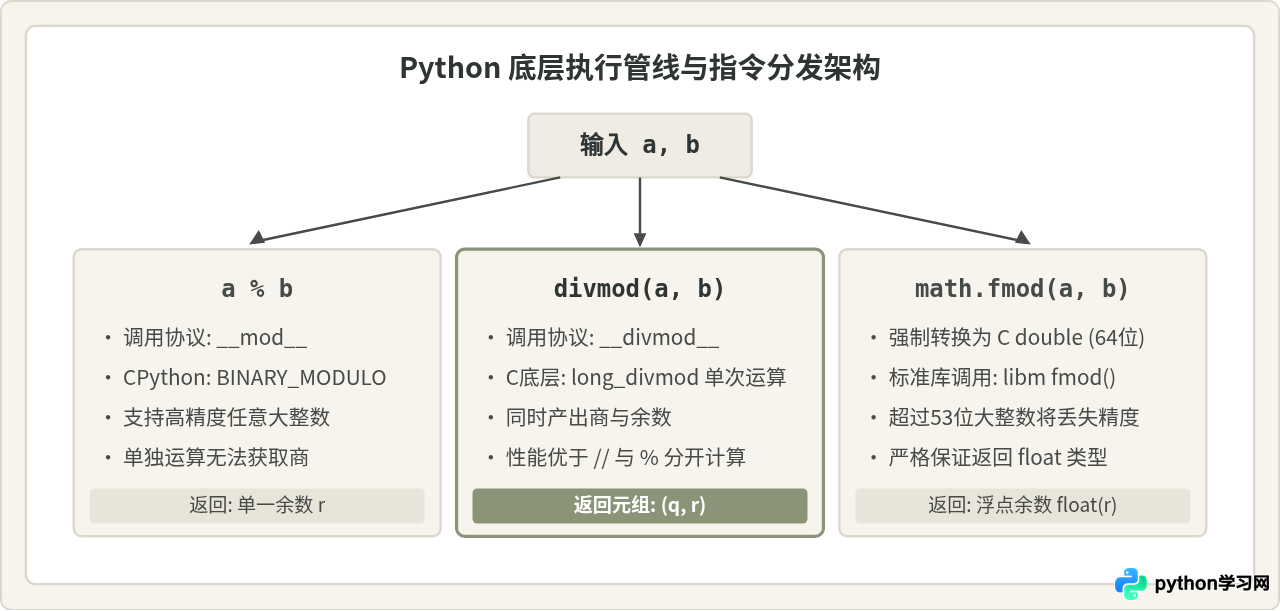
特别是在需要进行进制转换、分页计算、时间戳分解(时、分、秒换算)等场景下,同时获取商和余数是标准需求。使用 divmod() 不仅代码更简洁,在面对几千位的大整数加密运算(如RSA算法实现)时,性能提升可达30%以上。
四、浮点数取余:精度陷阱与 math.fmod 的救赎
虽然 % 语法上支持浮点数,但在涉及小数除法时,由于IEEE 754二进制浮点数无法精确表示某些十进制小数(如0.1),% 可能会带来意想不到的舍入误差:
# 浮点数取模陷阱
print(1.1 % 0.1)          # 输出: 0.09999999999999995
print(math.fmod(1.1, 0.1)) # 输出: 0.09999999999999995 (二者在此处均有精度丢失)

# 更加致命的符号反转差异
print(-1e-16 % 1.0)          # 输出: 0.9999999999999999
print(math.fmod(-1e-16, 1.0)) # 输出: -1e-16
Python官方文档在 math.fmod() 条目中明确指出:
“在使用浮点数时,通常建议优先选择 math.fmod();而在处理整数时,Python原生的 x % y 更加合适。”
这是因为在物理仿真、几何图形渲染及信号处理等领域,物理量(如距离、速度、角度)具有对称性。向零取整保持了 f(-x) == -f(x) 的奇函数对称性质,而 % 的向下取整会导致微小负数突然跳变到接近除数的巨大正数(如上述 -1e-16 % 1.0 变成 0.9999...),从而引发严重的数值不稳定。
五、大整数边界:math.fmod 的致命陷阱
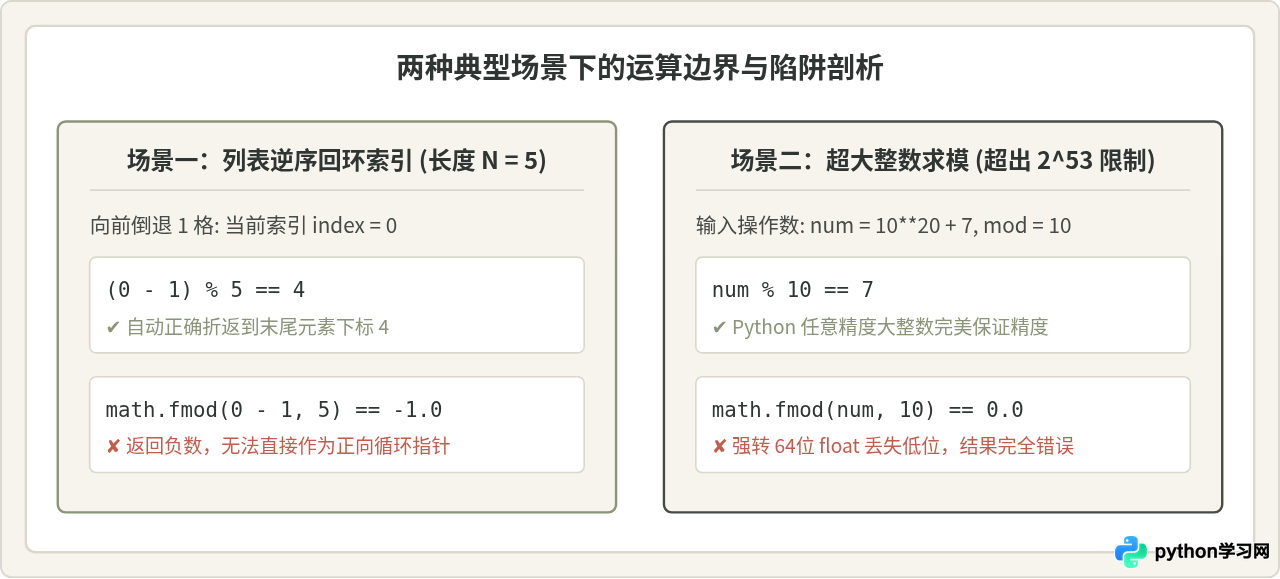
虽然 math.fmod() 在浮点科学计算中表现优异,但绝不能用它来处理任意精度的Python大整数。因为 math.fmod(x, y) 会在计算前将传入的参数强行转换为 C语言的 64 位双精度浮点数(double)。
在 IEEE 754 规范中,双精度浮点数的尾数只有 53 位,能够精确表示的整数上限是 \(2^{53} - 1 = 9007199254740991\)(约 16 位十进制数)。一旦整数超出该范围,低位信息将被直接截断舍入,产生严重计算错误:
# 超过 2^53 的大整数测试
big_num = 10**20 + 7
divisor = 10

print("原生 % 结果:     ", big_num % divisor)       # 正确输出: 7
print("math.fmod 结果: ", math.fmod(big_num, divisor)) # 错误输出: 0.0 (精度丢失引发的严重Bug!)
六、全维度技术特性综合对照
为了便于系统查阅,下表全面总结了三者在各维度的关键技术指标:
| 对比维度 | 运算符 % |
内置函数 divmod(a, b) |
标准库 math.fmod(x, y) |
|---|---|---|---|
| 底层取整方式 | 向下取整(Floor,向负无穷) | 向下取整(Floor,向负无穷) | 向零截断(Truncate,向零) |
| 余数符号归属 | 与除数 \(b\) 相同(或为0) | 与除数 \(b\) 相同(或为0) | 与被除数 \(x\) 相同(或为0) |
| 返回值类型 | 同操作数类型(int/float) | 包含商与余数的二元组 (q, r) |
始终返回 float |
| 大整数支持 | 完全支持任意位高精度整数 | 完全支持任意位高精度整数 | 不支持(超出 \(2^{53}\) 丢失精度) |
| 计算性能特点 | 单个求模运算极快 | 同时求商与余数时性能最优 | 调用系统 C 动态库,浮点运算快 |
| 典型应用领域 | 密码学、散列哈希、环形数组 | 时钟换算、分页系统、进制转换 | 物理引擎、几何计算、C模块桥接 |
七、选型决策指南与实战建议
在日常开发中,应该如何在这三者之间做出抉择?可参考以下清晰的决策逻辑:
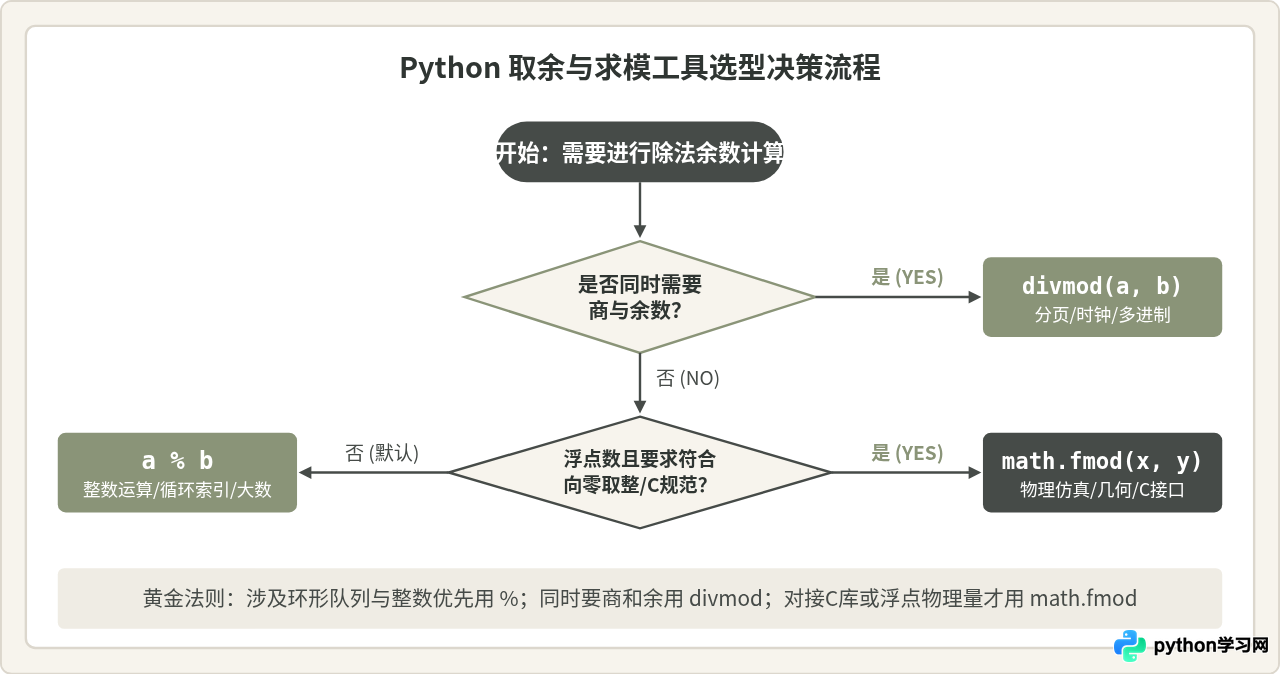
总结而言:
- 日常整数运算与环形结构:毫不犹豫选择
%。Python设计的向下取整使得负数在除以正数时能够自然“回绕”,是处理时钟、轮播图、环形缓冲区下标的最优解。 - 同时需要商和余数:强制优先使用
divmod()。无论在可读性还是在底层C执行效率上,它都优于显式地调用//和%。 - 科学计算与跨语言C生态对接:当且仅当操作数为有限大小的浮点数,且算法严格依赖向零取整(截断)的余数对称性时,才调用
math.fmod()。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















