


Python机器学习模型有哪些:Scikit-learn常用算法分类
系统介绍Python中Scikit-learn常用机器学习算法分类,详解分类、回归、聚类与降维四大模型体系的代表算法、数学机制、适用场景与选型流程。
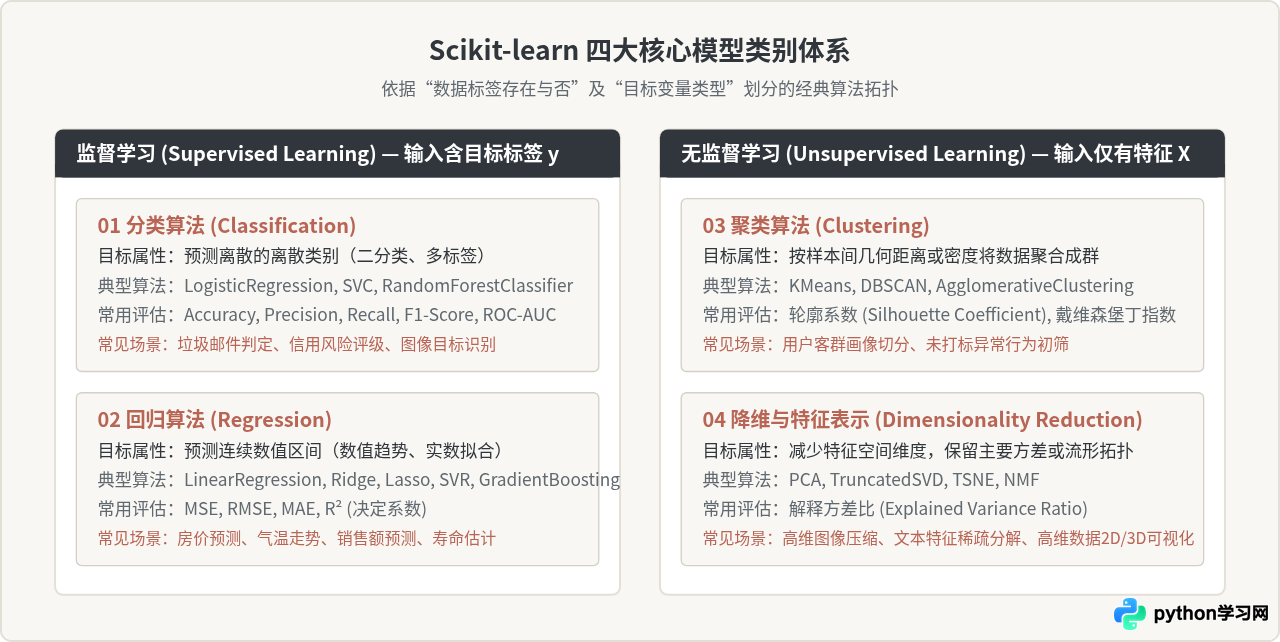
在 Python 生态中,Scikit-learn(简称 sklearn)是应用最广泛、工程接口最完备的通用机器学习库。如果向一名算法工程师提问“Python 机器学习模型究竟包含哪些”,最规范、最清晰的解答路径并非单纯罗列算法名词,而是依据任务学习目标与样本标签属性进行系统划分。Scikit-learn 将模型整齐划分为四大核心支柱:监督学习中的分类(Classification)与回归(Regression),以及无监督学习中的聚类(Clustering)与降维(Dimensionality Reduction)。本文将针对这四大类别,逐一拆解代表性算法的原理机理、代码调用形式及选型判断依据。
一、监督学习:分类算法(Classification)
分类算法的任务是在给定特征集合 $X$ 的前提下,预测离散的目标标签 $y$。无论是判断二元状态(如是否欺诈)还是多类别识别(如手写数字 0-9),Scikit-learn 都在子模块中提供了由浅入深、覆盖不同数学机理的经典模型:
1. 逻辑回归(Logistic Regression)
位于 sklearn.linear_model.LogisticRegression。虽然名称带有“回归”,但它通过 Sigmoid 或 Softmax 函数将线性加权输出映射为概率值(区间为 0 到 1),是典型的线性分类器。在特征维度规整、数据线性可分、或业务对权重系数有极高解释性要求(例如信贷审批风控评分卡)时,逻辑回归是不可替代的基准模型(Baseline)。
2. 支持向量机(Support Vector Classifier)
位于 sklearn.svm.SVC。SVC 的数学核心是最大化类间分类超平面的几何间隔。当样本在高维空间不可分时,SVC 可通过核技巧(Kernel Trick,如 RBF 径向基核、多项式核)将低维特征隐式投射到更高维空间,从而实现非线性边界划分。SVC 在小样本、高维度(例如生物基因微阵列分类、文本分类)表现卓越,但当样本量突破 10 万时,其核矩阵二次规划求解的计算开销将显著放大。
3. 决策树与集成树模型(Tree & Ensembles)
- 单决策树(
sklearn.tree.DecisionTreeClassifier):基于基尼不纯度(Gini)或信息熵递归二分特征空间。模型规则直观透明,但单一深树极易发生过拟合。 - 随机森林(
sklearn.ensemble.RandomForestClassifier):基于 Bagging(自助采样聚合)机制构建大量独立决策树,最终通过多数投票输出类别。它能有效平抑单树方差,天然抗噪且不依赖特征缩放。 - 梯度提升树(
sklearn.ensemble.HistGradientBoostingClassifier/GradientBoostingClassifier):基于 Boosting(串行残差学习)迭代纠错。针对中大规模结构化表格数据,直方图加速版本的HistGradientBoostingClassifier具有极高命中率与工业级性能。
4. 朴素贝叶斯与近邻算法
sklearn.naive_bayes.GaussianNB(高斯分布)与 MultinomialNB(多项分布)依托贝叶斯定理,假设各特征之间条件独立。由于运算仅涉及频数统计与概率乘积,训练速度极快,是垃圾邮件过滤和初始文本挖掘的高效工具。sklearn.neighbors.KNeighborsClassifier 属于惰性学习(Lazy Learning),不进行显式参数训练,预测时直接检索欧氏空间内距离最近的 K 个样本进行投票,适合流形简单且无严苛实时延迟要求的场景。
以下为一个规范的 Scikit-learn 分类模型训练与评估示例:
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import Pipeline
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report

# 1. 准备数据
X, y = load_breast_cancer(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 2. 组装工程流水线(预处理 + 估计器)
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('classifier', RandomForestClassifier(n_estimators=100, random_state=42))
])

# 3. 拟合与预测
pipeline.fit(X_train, y_train)
y_pred = pipeline.predict(X_test)

# 4. 评估输出
print("测试集分类指标报告:")
print(classification_report(y_test, y_pred))
二、监督学习:回归算法(Regression)
回归任务的目标变量 $y$ 是实数轴上的连续取值。Scikit-learn 的回归模型覆盖了从经典参数统计到现代非参数集成的大量算法:
1. 普通最小二乘与正则化线性回归
sklearn.linear_model.LinearRegression 通过最小化预测残差平方和(OLS)求解特征权重。然而,当输入特征之间存在高度多重共线性,或特征数量接近甚至超过样本数时,普通线性回归的权重方差会急剧发散。为此,Sklearn 提供了引入惩罚项的正则化模型:
- 岭回归(
sklearn.linear_model.Ridge):引入 L2 范数惩罚项 $\alpha \sum w_i^2$,收缩权重系数,提升面对共线性数据时的数值稳定性。 - Lasso 回归(
sklearn.linear_model.Lasso):引入 L1 范数惩罚项 $\alpha \sum |w_i|$,能够将不重要特征的权重直接压缩为绝对零,兼具连续预测与稀疏特征选择功能。 - 弹性网络(
sklearn.linear_model.ElasticNet):折中结合 L1 与 L2 惩罚项,适宜特征高度相关且需要变量稀疏化的场景。
2. 非线性回归与支持向量回归
当特征与目标变量呈现复杂的非线性曲面映射时,树集成回归器 sklearn.ensemble.RandomForestRegressor 和梯度提升回归器 sklearn.ensemble.GradientBoostingRegressor 是默认首选;而 sklearn.svm.SVR 则通过引入 $\epsilon$-不敏感损失带,允许边界内的微小误差不计入损失,能够有效抵御孤立异常值对回归拟合线(面)的拉扯。
三、无监督学习:聚类算法(Clustering)
当数据集完全缺失目标标签 $y$ 时,学习任务转变为发现样本数据分布本身的内在几何结构与聚集形态。Scikit-learn 的 sklearn.cluster 模块实现了数种在工业数据分析中高频使用的聚类算法:
1. K-均值聚类(K-Means)
位于 sklearn.cluster.KMeans。K-Means 是基于质心距离的划分式聚类。算法通过交替执行“将样本指派给最近质心”和“更新质心为簇内均值向量”两步快速收敛。其核心优势在于时间复杂度低、可扩展性好(对于百万级数据可直接调用 MiniBatchKMeans)。但必须注意其固有局限:需要人为预先指定簇数量 $K$;且假设数据簇呈现凸球形且各向同性,对环形、细长条状或密度不均的几何分布表现欠佳。
2. 基于密度的空间聚类(DBSCAN)
位于 sklearn.cluster.DBSCAN。DBSCAN 通过两个关键超参数控制聚类:邻域半径 eps 与邻域最小样本点数 min_samples。它将紧密连接的连续高密度区域划分为单个簇,并将位于低密度稀疏区域的样本点标记为噪声(标签返回 -1)。这使得 DBSCAN 不需要预设簇数量,且能准确识别任意凹凸几何形状的簇,常被用作无监督离群点过滤器。
3. 层次聚类与概率混合模型
sklearn.cluster.AgglomerativeClustering 采用自底向上的凝聚策略,初始阶段将每个样本视作独立孤立点,随后依据不同距离联动规则(如 Ward 最小方差法、全联动法)迭代合并距离最近的簇,输出直观的树状层级关系。对于具备概率软分配需求(某个样本以 60% 属于 A 类,40% 属于 B 类)的场景,sklearn.mixture.GaussianMixture(高斯混合模型)通过 Expectation-Maximization(EM)期望最大化算法拟合多维正态分布参数,提供了比传统硬聚类更加细腻的推断依据。
四、无监督学习:降维与特征表示(Dimensionality Reduction)
面对动辄数百甚至上万维度的特征工程输入,模型不仅会面临“维度灾难(Curse of Dimensionality)”,导致样本距离度量失效与内存激增,还会引入大量高度相关的噪声信息。Scikit-learn 提供了线性与非线性两类降维器:
1. 主成分分析(PCA)
位于 sklearn.decomposition.PCA。PCA 是工业界使用频率最高的无监督线性降维算法。它通过正交线性变换将原始特征投影至互不相关的基向量空间,使得投影后的第一主成分承载最大的方差(信息量),第二主成分正交于第一主成分并承载次大方差。在实际工程中,开发者常通过观察累积解释方差比(explained_variance_ratio_.cumsum())决定将维度压缩至原维度的 20%-30%,从而在保留 95% 以上原始信息的同时大幅降低下游树模型或神经网络的拟合负担。
2. 流形学习与非线性降维(t-SNE)
位于 sklearn.manifold.TSNE。与基于方差投影的 PCA 不同,t-SNE(t-Distributed Stochastic Neighbor Embedding)专注于保持高维空间中样本点对之间的局部邻域条件概率关系。由于其对局部非线性流形结构的极强还原能力,t-SNE 几乎是高维生物单细胞测序数据、自然语言向量嵌入(Word Embeddings)以及高维图像表示在 2D/3D 平面上进行聚类分布可视化的标准手段。
五、工程落地中的模型选择与避坑指南
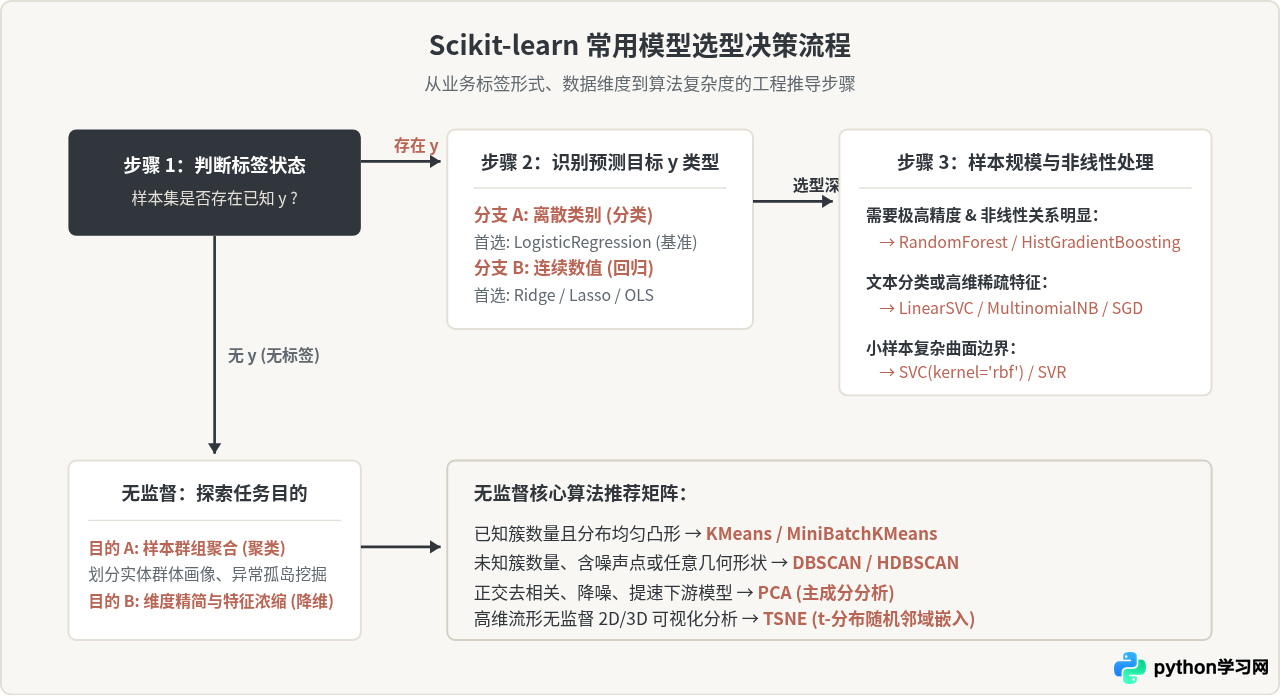
掌握了各类模型的归属后,将算法落地于真实业务场景时,以下三个工程原则尤为关键:
1. 特征缩放的决定性影响
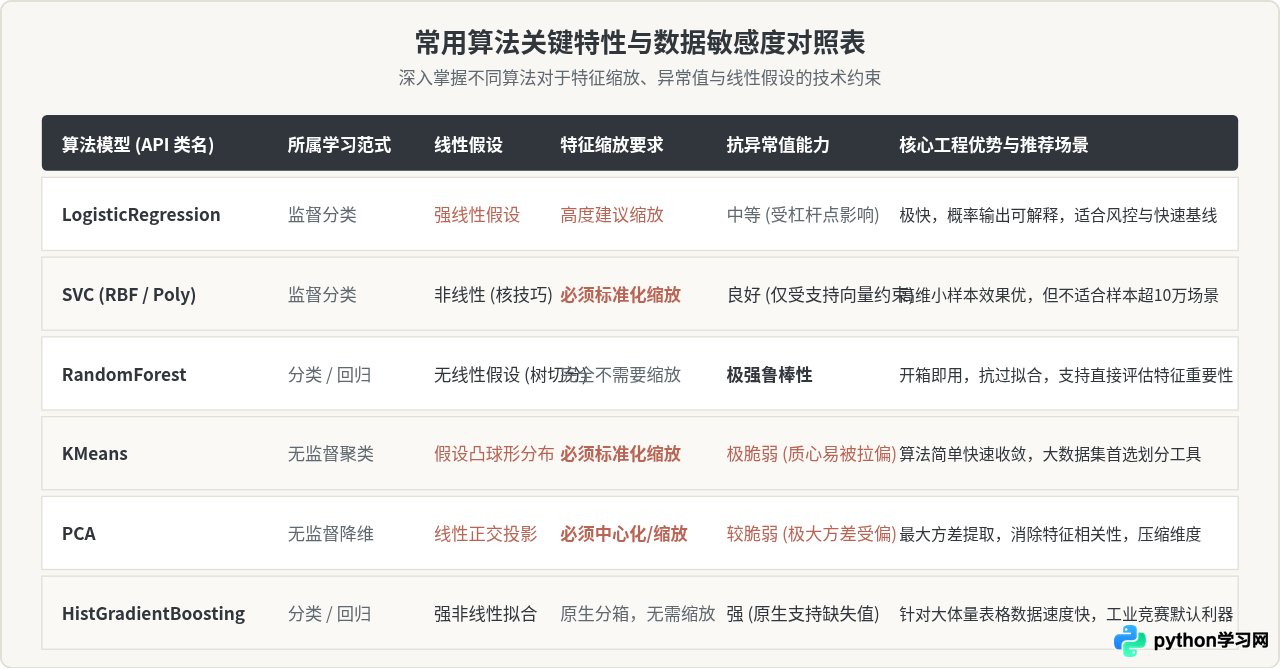
如对比表所示,基于距离或内积计算的模型(例如 SVC、KNN、K-Means、PCA、带正则化惩罚的 Ridge/Lasso)对各特征的数值绝对尺度极其敏感。如果特征 A 取值在 0 到 1 之间,而特征 B 取值在 0 到 10000 之间,未经缩放的数据会导致特征 B 完全主导欧氏距离计算或梯度下降路径。相反,基于单特征阈值分桶的树模型(DecisionTree、RandomForest)则对单调缩放完全免疫,不需要做均值方差归一化。
2. 数据穿越(Data Leakage)的严格防范
在进行模型选型与交叉验证时,切忌在整个数据集上统一进行 StandardScaler 或 PCA,然后再执行 train_test_split。这种做法会导致验证集的信息(均值、方差、主成分基)提前渗透至训练过程,产生过于乐观的虚假评估指标。正确的工业标准规范是始终使用 sklearn.pipeline.Pipeline 将特征转换器(Transformer)与预测器(Predictor)绑定成原子单元。
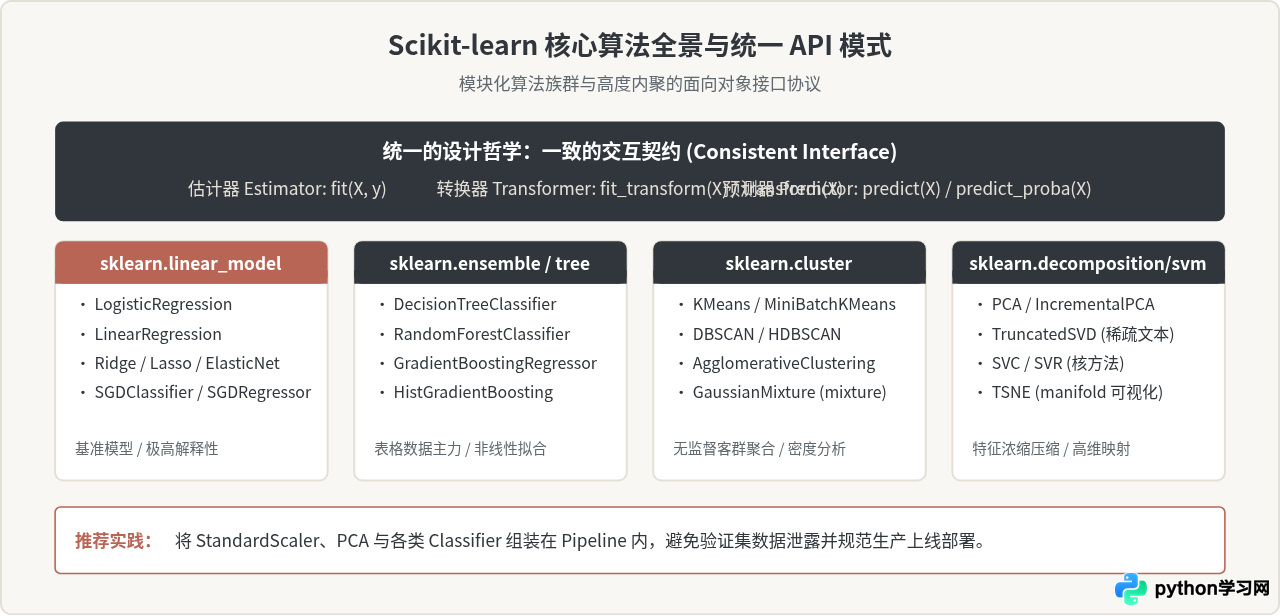
总结:面对具体的机器学习任务,建议遵循“先简单基准(LogisticRegression / Ridge),后集成强化(RandomForest / HistGradientBoosting),必要时进行特征降维(PCA)”的递进选型策略。理解分类、回归、聚类与降维的职责边界,能帮助开发者在庞大的 Scikit-learn 库中快速锁定最适模型,规避盲目调参。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















