


Python在技术领域主要代表哪些应用方向
深入解析Python在现代技术领域的核心应用方向,系统阐述人工智能、数据科学、Web服务、自动化运维及测试采集的技术栈体系、工程落地路径与选型边界。
Python 作为目前工业界应用最广泛的高级编程语言之一,其核心技术方向高度聚焦在人工智能与深度学习、数据分析与科学计算、**Web 服务与 API 后端**、自动化运维与云原生工具链以及测试工程与网络采集五大支柱领域。由于 Python 具备极高的胶水黏合能力、完善的底层编译扩展接口(C/C++ 与 CUDA 互操作)以及庞大完备的第三方库生态,使它在现代技术演进中成为众多关键工程场景的事实标准控制层。本文将具体阐述这五大方向的技术栈体系、工程职责、选型逻辑与适用边界。
一、Python 技术应用全景与运行底座
理解 Python 在各技术领域的定位,首先需要理清它的运行机制。Python 本身是一门动态解释型语言,由 CPython 虚拟机负责字节码解析与垃圾回收。在执行高密集计算时,纯 Python 语法存在解释开销与全局解释器锁(GIL)的限制,但 Python 的设计哲学在于“控制与计算分离”:由 Python 负责调度、配置管理、输入输出控制与胶水组装,真正的重型数值计算和网络调度则下沉到底层预编译的高性能 C/C++ 或 CUDA 动态库中。
这种分层架构造就了 Python 横跨多个垂直技术领域的独特优势。在工程实践中,各个技术方向并不是孤立存在的,而是共享同一套运行时支持体系与跨语言接口,形成了完整的技术拓扑。
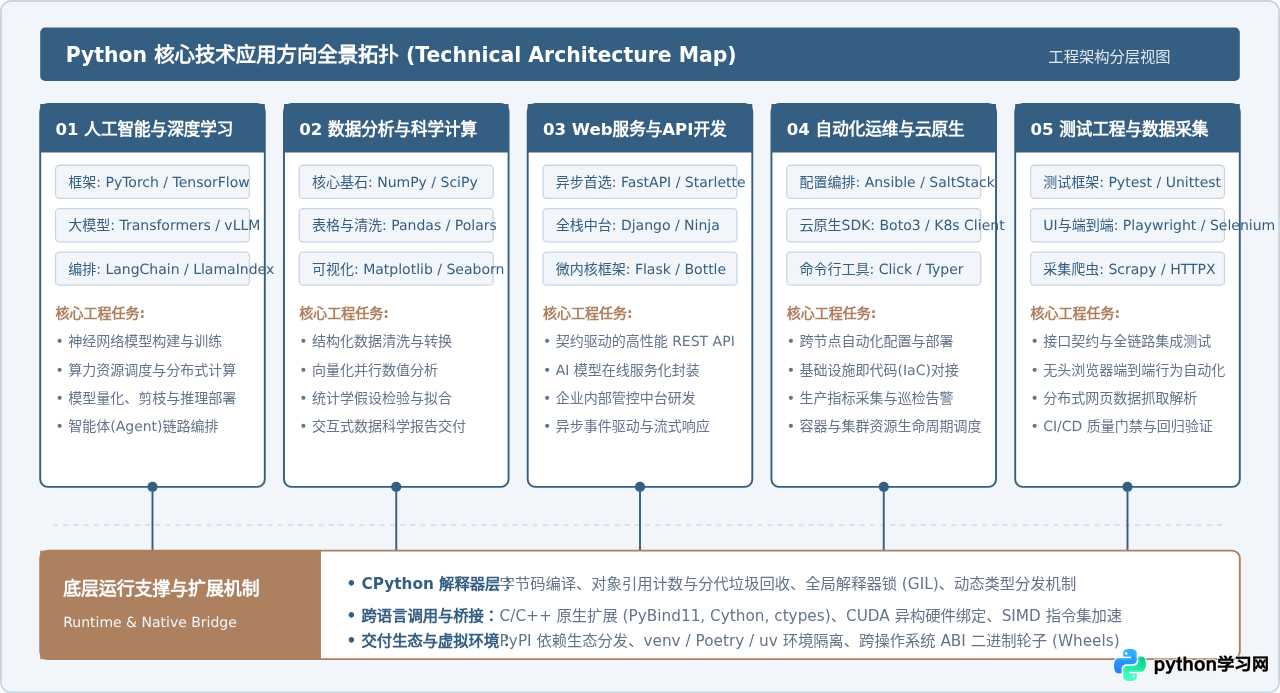
二、人工智能与机器学习/深度学习(AI & ML/DL)
人工智能是目前 Python 影响力最强、代表性最显著的领域。无论是学术界的前沿算法验证,还是产业界的超大规模模型落地,Python 几乎垄断了算法研发与交互控制的主导权。
1. 核心框架生态与分工
在传统机器学习阶段,Scikit-learn 确立了统一的 API 规范(如 fit、transform、predict),涵盖了分类、回归、聚类与特征工程的完整实现。随着深度学习崛起,计算范式从静态计算图向动态计算图迁移,PyTorch 凭借其符合 Python 原生编码习惯(Pythonic)的动态调试能力,成为了全球学术研究与工业预训练的事实标准。而在产业级生产流水线中,TensorFlow 配合 TensorRT 依然在部分移动端与嵌入式专用硬件部署中保有份额。
2. 大语言模型(LLM)与智能体系统演进
在大语言模型时代,Python 的统治地位进一步巩固。主流开源基础模型(如 Llama 系列、Qwen 系列)的核心权重加载与微调代码均首发于 Python 生态:
- 模型微调与训练调度:基于
Hugging Face Transformers、PEFT(低秩自适应 LoRA)与DeepSpeed,开发者可以用极少的胶水代码调用海量多机多卡算力。 - 高性能推理引擎:如
vLLM与TensorRT-LLM,虽然内核采用 C++ 与 CUDA 编写以实现 PagedAttention 和张量并行,但其服务编排、请求调度与分布式控制接口均通过 Python 暴露。 - 应用级智能体(Agent)开发:
LangChain与LlamaIndex构筑了连接外部数据库(向量检索 RAG)、工具调用(Function Calling)与任务规划的标准管道。
3. 工程落地规范与代码示例
在 AI 工程中,Python 绝不能直接用于编写矩阵乘法等密集运算,所有运算必须交由底层张量引擎执行。在生产服务上线时,通常将 Python 训练好的模型序列化为与 Python 解耦的中间格式(如 ONNX 或 TorchScript),以便在 C++ 推理引擎中获得确定的时延与低内存开销:
import torch
import torchvision.models as models

# 1. 采用 Pythonic 方式构建或加载预训练模型
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model = models.resnet18(weights=models.ResNet18_Weights.DEFAULT).to(device)
model.eval()

# 2. 准备虚拟输入张量(严格保证维度与批处理规范)
dummy_input = torch.randn(1, 3, 224, 224, device=device)

# 3. 将模型追踪导出为 TorchScript 静态图,剥离对 Python 运行时的强依赖
traced_model = torch.jit.trace(model, dummy_input)
traced_model.save("resnet18_traced.pt")

# 4. 示例说明:后续可直接在 C++ 生产运行时加载该 pt 文件,绕开 Python GIL 限制
print("模型静态图导出成功,已解耦 Python 运行时依赖。")
在深度学习多卡分布式训练与模型服务化时,尽量避免在数据流管道中混合大量的纯 Python 循环对象解析。应充分利用 torch.utils.data.DataLoader 的 num_workers 多进程预取机制,或者使用 WebDataset 读取打包的二进制 shard,防止 Python 垃圾回收(GC)成为 GPU 算力瓶颈。
三、数据分析与科学计算(Data Science & Computing)
数据分析与科学计算是 Python 构筑其通用技术地位的基石。在没有 Python 科学计算栈之前,该领域主要被 MATLAB、SAS、R 等专用软件割裂。Python 依靠底层同构的数组内存布局,完成了对这一领域的整合。
1. 核心工具链体系
- NumPy(基础数值底座):引入了连续物理内存存储的
ndarray对象,支持多维数组广播机制(Broadcasting),底层运算直接链接系统级的 OpenBLAS、MKL 或 LAPACK 高性能线性代数库。 - Pandas(结构化表格数据处理):构建在 NumPy 之上,提供针对时序与表格数据的
DataFrame与Series数据结构,具备极强的数据清洗、切片索引、透视合并能力。 - Polars(新一代向量化分析引擎):采用 Rust 编写并通过 Python 提供绑定,采用 Apache Arrow 内存格式与多线程并行执行引擎,在大宽表和数十 GB 级别内存分析场景下,处理吞吐量大幅超越传统 Pandas。
- SciPy 与统计绘图:提供积分、优化、傅里叶变换、信号处理等专业算法库,搭配
Matplotlib与Seaborn能够快速生成学术与工业级图表。
2. 向量化计算与代码范式
在数据科学工程中,最致命的性能反模式是使用原生 for 循环逐行遍历数据。合理做法是全流程维持“向量化计算”:
import numpy as np
import pandas as pd

# 构建模拟的交易订单数据集(100万行数据)
n_records = 1_000_000
data = {
    "price": np.random.uniform(10.0, 500.0, size=n_records),
    "volume": np.random.randint(1, 50, size=n_records),
    "tax_rate": 0.08
}
df = pd.DataFrame(data)

# 正确做法:利用底层 C 向量化广播机制计算含税总金额
# 避免使用 df.iterrows() 或自定义 Python 函数逐行迭代
df["total_amount"] = df["price"] * df["volume"] * (1 + df["tax_rate"])

# 聚合统计分析示例
summary = df["total_amount"].describe()
print(f"数据处理完成,样本均值: {summary['mean']:.2f}")
四、企业级 Web 后端与 API 服务体系
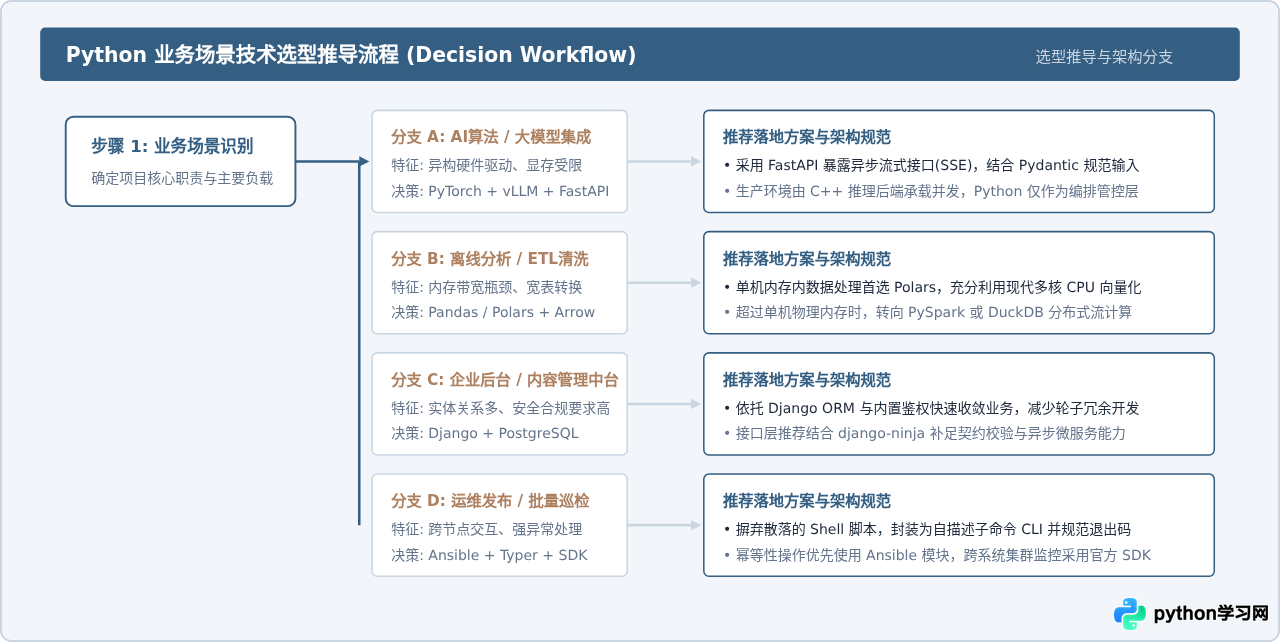
在 Web 工程领域,Python 并不盲目追求纯 CPU 计算的微秒级极限吞吐,而是聚焦于业务构建速度、代码可维护性以及针对 I/O 密集型接口的高效响应。随着微服务与 AI 落地潮,Python 在 API 网关层与算法封装层确立了不可动摇的地位。
1. 主流 Web 框架演进与分工
- FastAPI(现代化异步微服务首选):基于
Starlette(异步核心)与Pydantic(类型校验),全面支持 Python 3.6+ 的类型注解(Type Hints)。其最大优势在于:开发者编写标准 Python 函数时,框架能自动完成入参反序列化、严格格式校验、依赖注入并即时生成符合 OpenAPI(Swagger)规范的交互式文档。特别适合作为模型推理包装与高并发微服务 API。 - Django(全功能企业后台与敏捷开发标准):遵循“自带电池”(Batteries-Included)理念,内置强健的对象关系映射(ORM)、用户权限体系、CSRF/SQL 注入防护以及开箱即用的 Admin 控制台。适合人员流动频繁、需求复杂度高、需要快速构建可靠业务后台的场景。
- Flask(极简轻量微框架):核心仅保留请求路由与模板渲染,通过插件机制按需引入组件。适合轻量级内部工具、微型代理或单文件脚本的原型验证。
五、自动化运维与云原生工程(DevOps & SRE)
在 Linux 操作系统与现代云原生基础架构中,Python 是运维自动化和站点可靠性工程(SRE)的标准工具语言。虽然系统软件开发逐渐向 Go 语言(如 Docker、Kubernetes 核心)靠拢,但在云厂商 SDK 对接、复杂调度编排与日常基础设施巡检中,Python 的统治力依旧极其稳固。
1. 为什么运维工程深度依赖 Python
在编写自动化任务时,传统的 Bash 脚本在面对 JSON 解析、多层嵌套结构处理、并发控制以及精细化异常捕获时显得极其脆弱,可读性与健壮性较差。而编译型语言(如 C++/Go)每次修改均需完整构建分发流程,不适合频繁调整的运维脚本。Python 在绝大多数 Linux 发行版中均预装就绪,具备优雅的文件处理语法、健全的标准库(如 subprocess、pathlib、urllib),以及成熟的第三方云 SDK。
2. 典型核心工具链
- Ansible(声明式配置管理):完全基于 Python 开发的无代理(Agentless)自动化运维工具,通过 SSH 协议与远程主机通信,采用 YAML 编写 Playbook,实现了跨多台机器的幂等状态配置。
- 云厂商官方 SDK(如 Boto3、Alibaba Cloud SDK):所有主流公有云平台均将 Python SDK 列为一级支持,自动化运维脚本可通过简单的 Python 代码完成 VPC 网络配置、安全组管理与弹性计算节点生命周期扩缩容。
- 命令行工具开发框架(Click 与 Typer):运维工程师可以使用极简的装饰器语法,将任何 Python 脚本包装为具备选项补全、错误提示与帮助文档的企业级 CLI 工具。
六、测试工程与网络数据采集(QA & Web Scraping)
在软件质量保障与公开数据资产沉淀方向,Python 提供了端到端的完备技术闭环。
1. 现代自动化测试基础设施
在测试工程领域,Pytest 已彻底取代早期的 unittest 成为 Python 测试的首选事实标准。Pytest 拥有灵活的 fixture 机制,支持依赖注入与层级作用域(Function、Class、Module、Session),能够极其优雅地管理测试环境准备与后置数据清理。同时,配合 pytest-xdist 可以极简地实现多核并行测试用例分发,显著压缩持续集成(CI)阶段的耗时。
在 UI 与端到端测试层面,基于现代多核异步驱动的 Playwright(Python 绑定)相比老旧的 Selenium,具备原生自动等待(Auto-waiting)、网络请求拦截(Network Mocking)与无头浏览器高效调度的优势,大幅降低了 Web 自动化测试因网络抖动导致的偶发性失败率。
2. 网络爬虫与数据采集管道
在公开网络数据收敛方向,Python 的 Scrapy 是最成熟的工业级异步爬虫框架。它基于 Twisted 事件驱动引擎,内建调度器(Scheduler)、下载中间件(Downloader Middlewares)、网页提取器(Item Pipeline),并原生支持结合 Redis 的分布式抓取方案。配合 BeautifulSoup、XPath/CSS Selector 与 httpx,可以实现高效合规的数据采集作业。
七、典型技术方案的工程落地演进(实施步骤)
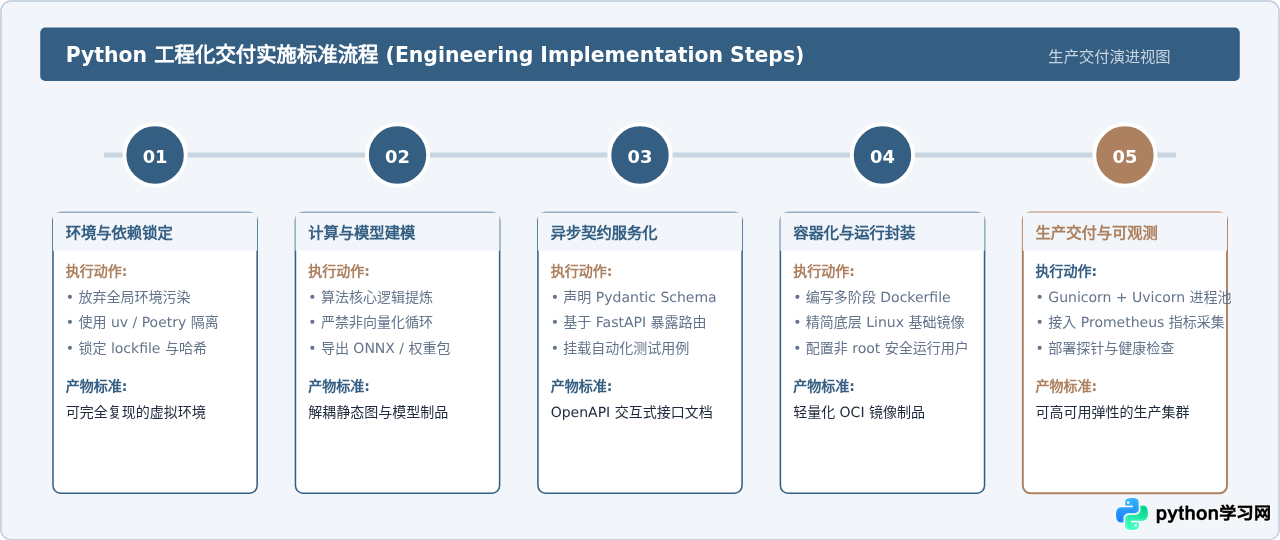
无论处于上述哪个技术方向,现代 Python 项目从技术原型(PoC)走向企业级生产交付,都遵循一套严格的工程化实施流程。以下以将数据模型转化为高可用 API 服务为例,梳理标准的 5 步实施链路:
八、Python 的技术边界与选型禁忌(何时不应选择 Python)
客观的技术选型不仅要明确 Python“能做什么”,更要清醒地认知其“不适合做什么”。如果将 Python 强行推入不适用的场景,往往会导致架构重构甚至项目灾难:
1. CPU 密集型微秒级硬实时系统
在超低时延高频量化交易(HFT)、工业总线控制、飞行控制等场景中,系统对指令响应的抖动(Jitter)容忍度通常在微秒甚至纳秒级别。Python 的分代垃圾回收(GC)机制会周期性暂停对象扫描,加上动态类型检查的指针寻址解引用开销,无法提供确定性的硬实时时间保障。此领域应坚决采用 C、C++ 或 Rust。
2. 全局解释器锁(GIL)与纯多线程计算瓶颈
在标准 CPython 解释器中,GIL 确保同一时刻只有一个操作系统线程能执行 Python 字节码。虽然 Python 3.13 已经推出了实验性的自由线程(Free-threaded / nogil)支持,但在目前的生产环境中,纯 Python 多线程无法利用多核心 CPU 提升计算密集型性能。虽然可以通过 multiprocessing(多进程)规避,但进程间数据序列化(Pickle)会带来不容忽视的内存复制开销。
3. 移动端原生 App 与低层固件驱动
在 iOS/Android 客户端原生应用开发中,Python 缺乏直接的操作系统 SDK 支持,第三方打包工具(如 Kivy、BeeWare)打包后的二进制体积庞大、启动缓慢且难以及时利用原生系统组件特性,应直接采用 Swift、Kotlin 或 Flutter。同理,在单片机与硬件固件驱动方向,除微型教育主板(MicroPython)外,工业级驱动固件开发必须基于 C/C++ 或汇编。
九、各应用方向综合对比与总结矩阵
综合上述分析,Python 在技术领域并非单一维度的全能工具,而是一门在各方向特点鲜明的工业控制语言。下表与图示全面总结了 Python 在各大应用方向的技术选型核心维度:
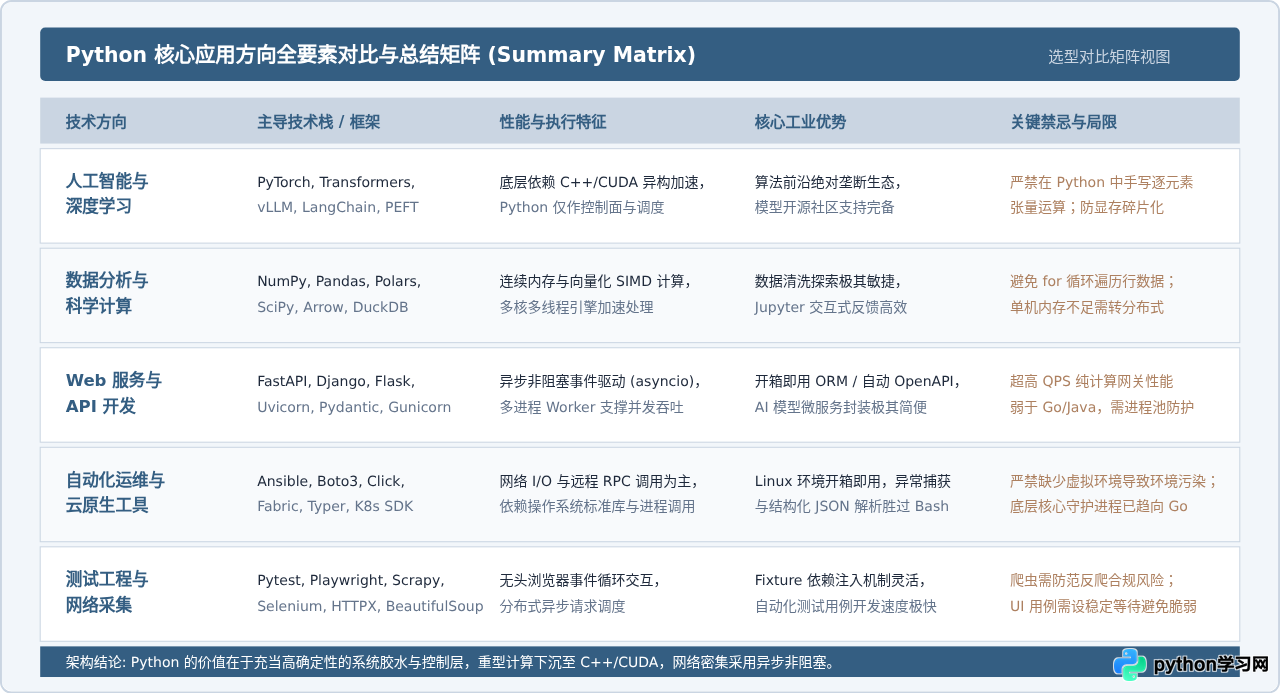
综上所述,Python 在现代技术领域并不是单纯依靠运行时性能取胜,而是凭借强大的跨语言胶水能力、成熟的数值计算与人工智能底座、高度一致的数据抽象接口以及极低的开发调试成本,稳固地占据了算法落地、数据转换与自动化控制的核心位置。在做架构规划时,技术团队应坚持“以 Python 掌控调度与编排,以下层高性能运行时消化硬件算力”的工程原则,充分发挥其生态优势,同时规避其执行边界。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















