


Python 3 爬虫遇到反爬限制怎么办?入门级应对策略详解
针对初学者编写 Python 3 爬虫时常见的 403 Forbidden、429 Too Many Requests、动态渲染拦截等反爬限制,系统讲解请求头伪装、延迟节流、会话保持与接口解析等入门级应对策略与排查规范。
一、识别反爬拦截的具体表现
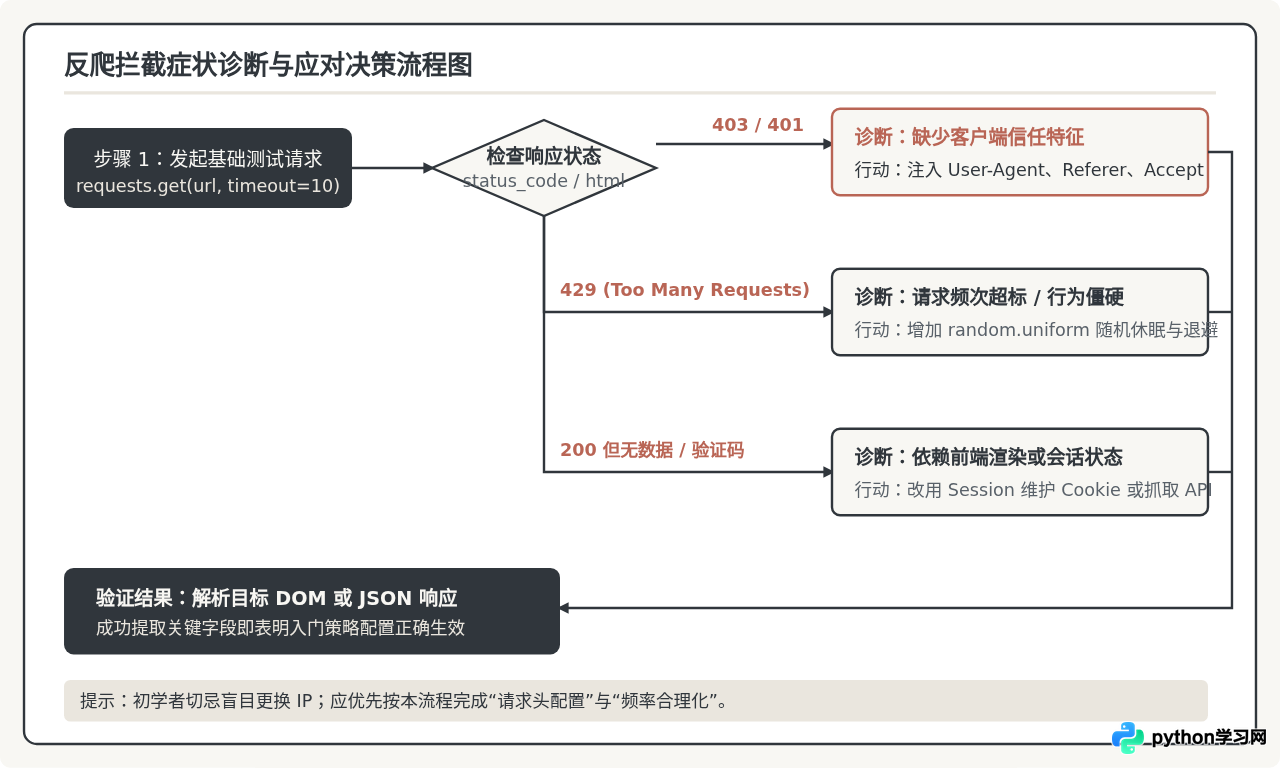
很多初学者在程序报错时习惯盲目修改代码,甚至以为是目标网站服务器宕机。应对反爬的第一步,是准确识别 HTTP 响应状态码与响应体所传递的拦截信号:
- HTTP 403 Forbidden:服务器理解了你的请求,但拒绝执行。通常由缺失必要的请求头(如 User-Agent、Referer)或 IP 被直接加入观察名单引起。
- HTTP 429 Too Many Requests:客户端在给定时间内发送了过多请求,触发了服务端的限流阀值。
- HTTP 200 但返回验证码或空白页面:状态码显示正常,但 HTML 中没有数据,仅包含“请完成人机验证”的滑块提示,或页面数据完全依赖前端 JavaScript 异步渲染生成。
- 频繁重定向(HTTP 302 / 307)至登录或拦截页:说明目标接口必须具备特定 Cookie 凭据方可访问。
二、第一步:补全与伪装 HTTP 请求头
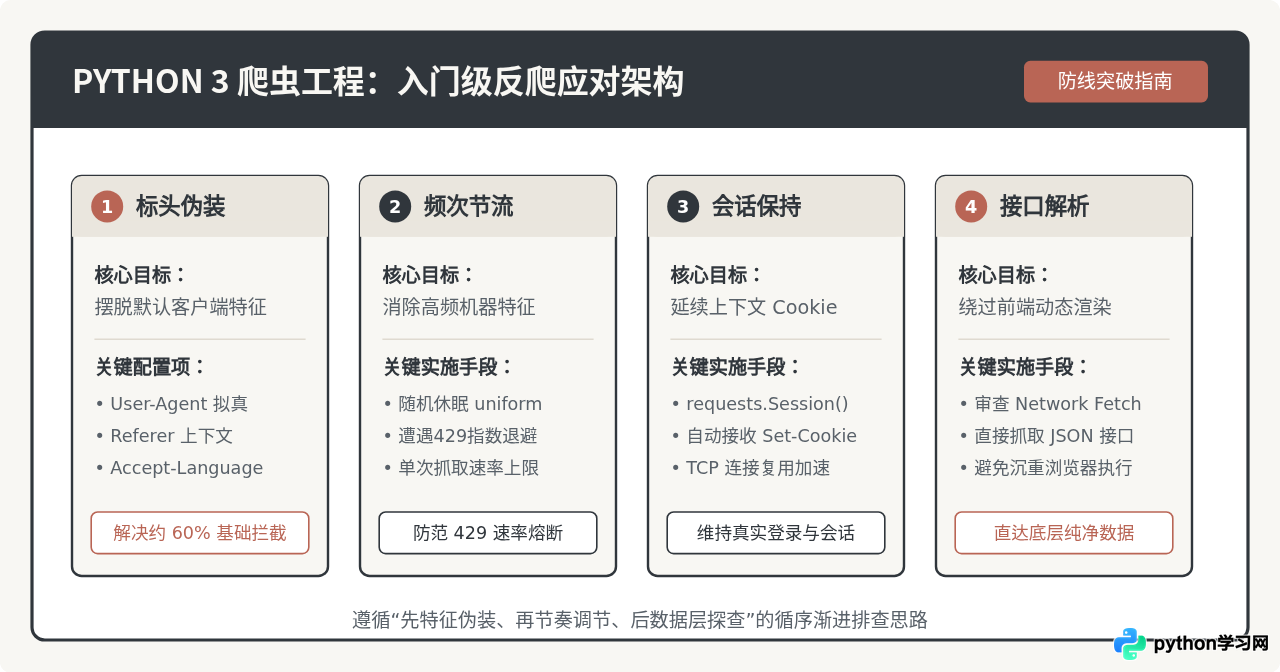
在使用 Python 的标准库或 requests 模块发起请求时,若不显式指定请求头,客户端会默认发送带有自身程序标识的 Header。例如 requests 发出的请求会携带 User-Agent: python-requests/2.x.x。对任何具备基本防护的网站而言,这无异于直接声明“我是爬虫程序”。
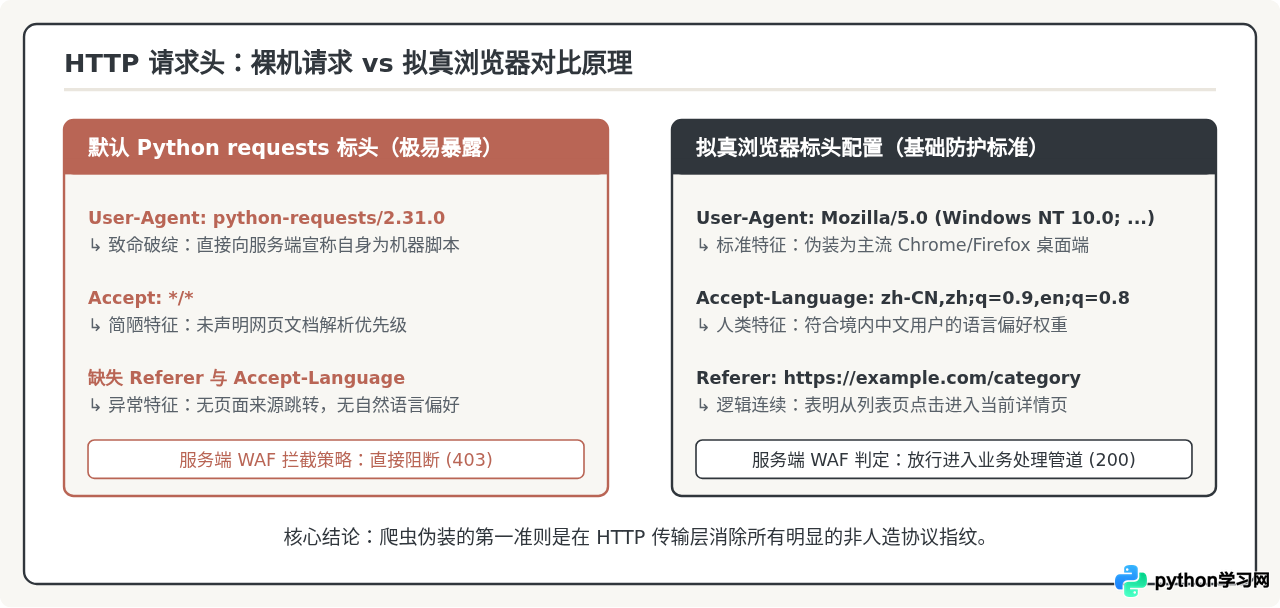
要解决基础拦截,首先要在代码中封装一套贴近真实浏览器的请求头字典。除了 User-Agent 之外,Referer(来源页面地址)和 Accept-Language(接受语言)同样至关重要:
import requests

url = "https://example.com/data-list"

# 构造模拟现代浏览器的请求头
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8",
    "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
    "Referer": "https://example.com/",
    "Connection": "keep-alive"
}

response = requests.get(url, headers=headers, timeout=10)
print("响应状态码:", response.status_code)
# 示例输出:响应状态码: 200Referer 是否来自本站主域名。如果直接单页爬取报错 403,务必打开浏览器开发者工具(F12),在 Network 面板中将请求对应请求项的 Referer 原样复制到 Python 字典中。
三、第二步:控制请求节奏与实现指数退避
即使请求头伪装得天衣无缝,如果在 1 秒钟内连续向服务端发起数十次高频请求,服务端的速率监控系统(WAF 或 Nginx limit_req)也能在毫秒级时间内判定其为机器脚本,并迅速下发 429 Too Many Requests 或直接封锁当前 IP 数十分钟。
1. 引入带随机抖动的延时(Jitter)
许多初学者知道使用 time.sleep(1),但机械式的等间隔延时同样具有极强的统计学特征。应当使用 random.uniform() 生成浮点数随机时间间隔,使采集行为更接近真实读者的翻页节奏:
import time
import random
import requests

urls = [
    "https://example.com/page/1",
    "https://example.com/page/2",
    "https://example.com/page/3"
]

headers = {
    "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36"
}

for target_url in urls:
    resp = requests.get(target_url, headers=headers)
    print(f"已抓取: {target_url}, 长度: {len(resp.text)}")

    # 随机休眠 1.5 到 3.2 秒,打破周期性脉冲特征
    sleep_duration = random.uniform(1.5, 3.2)
    time.sleep(sleep_duration)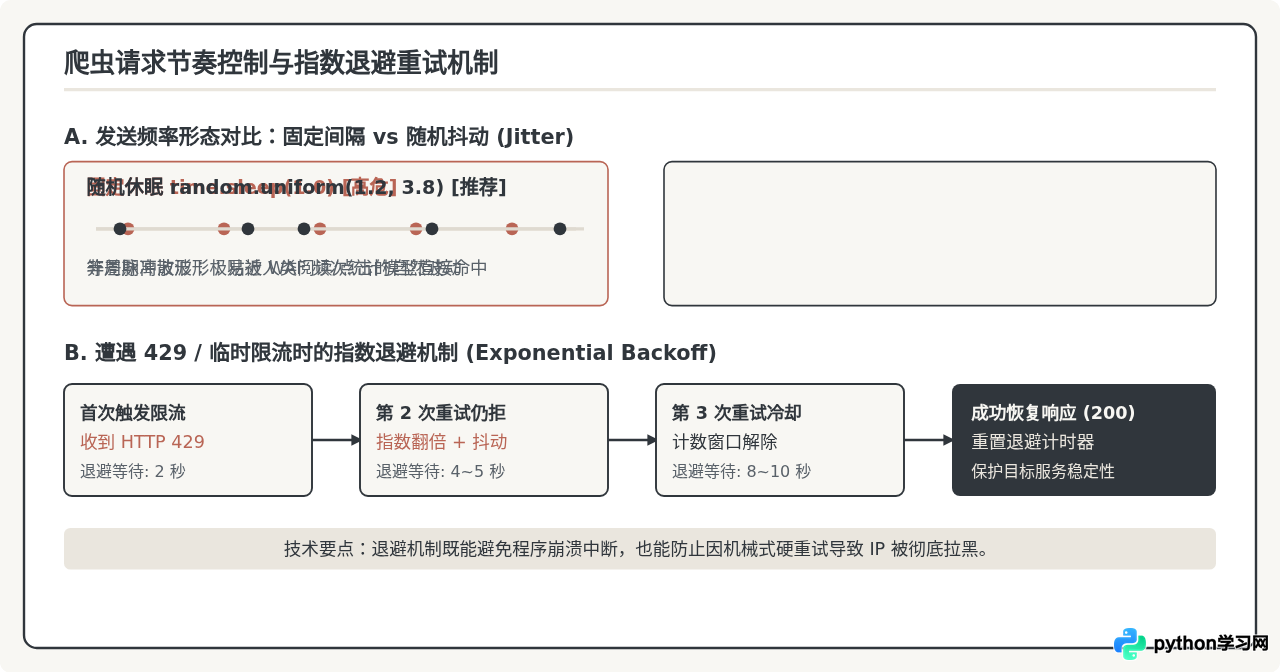
2. 构建针对 429 限制的指数退避重试
当偶发性触发 429 状态码时,立即终止程序会导致任务失败,而立即死循环重试则会加剧封禁。正确的做法是采取指数退避(Exponential Backoff):每一次失败后将等待时间成倍增加,待服务端风控窗口冷却后再次尝试。
import time
import requests

def fetch_with_backoff(url, max_retries=3, base_delay=2.0):
    headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"}

    for attempt in range(max_retries):
        response = requests.get(url, headers=headers, timeout=10)

        # 命中正常响应,直接返回
        if response.status_code == 200:
            return response

        # 命中 429 限流或 503 服务暂不可用,启动退避
        if response.status_code in [429, 503]:
            wait_time = base_delay * (2 ** attempt)
            print(f"检测到状态码 {response.status_code},第 {attempt + 1} 次退避等待 {wait_time} 秒...")
            time.sleep(wait_time)
        else:
            # 其他非限流异常(如 404)无需重试
            break

    return None
四、第三步:利用 requests.Session 维护会话状态
很多网站的内容不是孤立访问的。用户在浏览网站时,服务器首先会在首页或前序页面下发身份令牌(如 Set-Cookie: session_id=xxx)。如果每次都使用独立的 requests.get(),每个请求都是独立的 TCP 握手,且丢失了服务端此前下发的 Cookie,极易被判定为无状态的自动化攻击。
通过 requests.Session() 对象管理请求,Python 会自动在后续的所有请求中携带最新收到的 Cookie,并复用底层的 TCP 连接,不仅有效通过会话关联检查,还能大幅提升网络传输效率:
import requests

# 创建全局会话对象
session = requests.Session()

# 统一在 Session 上配置通用请求头
session.headers.update({
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36",
    "Accept-Language": "zh-CN,zh;q=0.9"
})

# 第一步:先请求一次主页,获取基础 Cookie 及 CSRF Token
home_url = "https://example.com/"
session.get(home_url, timeout=10)

# 第二步:会话自动携带上一步获取的 Cookie 访问列表数据
list_url = "https://example.com/api/articles"
response = session.get(list_url, timeout=10)

print("会话中保留的 Cookie 键值:", session.cookies.get_dict())
# 示例输出:会话中保留的 Cookie 键值: {'session_token': 'abc789xyz', 'visited': '1'}
五、第四步:识别数据来源——绕过动态渲染陷阱
初学者常将“页面无数据”误判为被网站反爬拦截。例如明明在浏览器中看到商品列表,但用 Python 爬取回来的 HTML 里只有大量 <div id="root"></div> 或成段的 JavaScript 脚本。这通常不是服务端反爬拒付,而是单页应用(SPA)采用了前后端分离技术。
面对动态渲染页面,很多初学者第一反应是立即引入 Selenium 或 Playwright。这虽然可行,但无头浏览器资源开销大、启动慢,且具备独特的 navigator.webdriver 浏览器指纹,反而容易被更高阶的脚本防线检测到。更高效规范的入门策略是直接分析原生数据接口:
- 在 Chrome 或 Edge 浏览器中打开目标网页,按
F12调出开发者工具。 - 切换到 Network(网络) 标签页,并筛选 Fetch/XHR 类型。
- 刷新页面或点击下一页,观察列表中出现的请求项,寻找返回
JSON格式数据的真实 URL。 - 直接使用
requests.get()请求该 JSON 接口地址,解析原生结构化数据。
六、应对策略对照与排查优先级总结
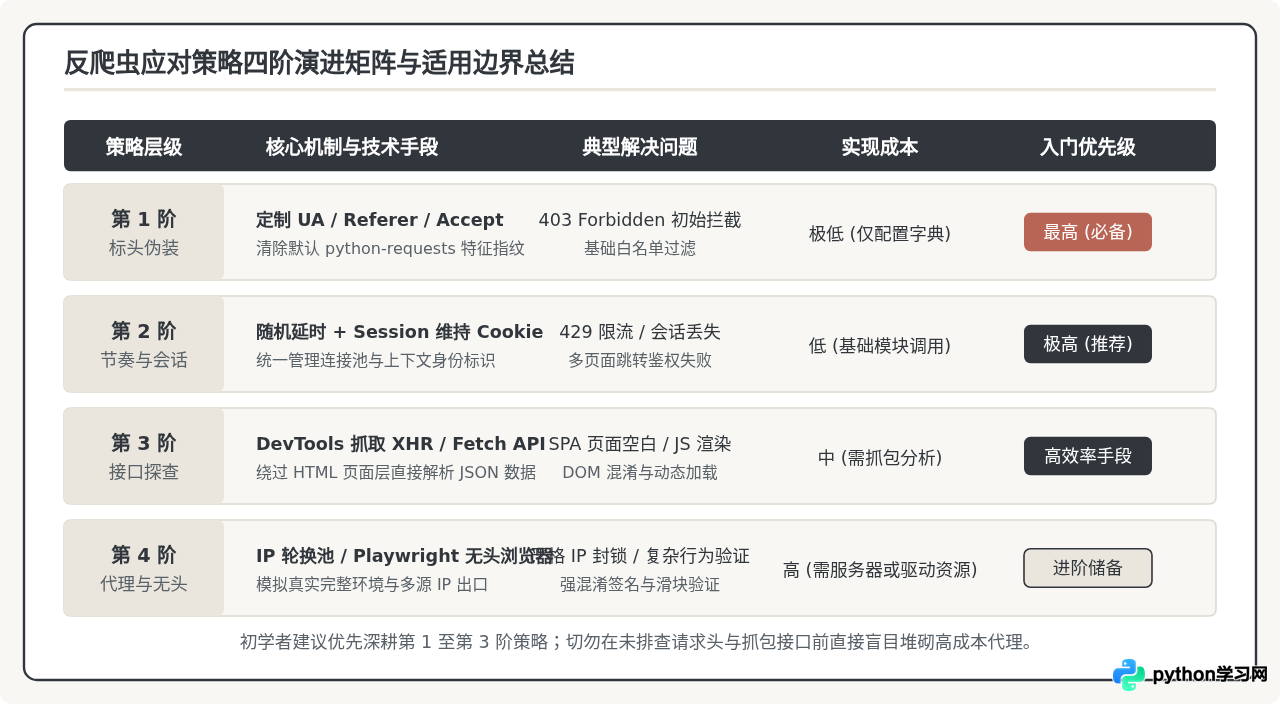
遇到数据抓取受阻时,建议根据下表从低成本向高成本依次推进排查,切忌在初始阶段跳过协议层与频率优化而盲目采购代理服务:
| 拦截表现 | 初筛原因 | 标准应对措施 | 验证方法 |
|---|---|---|---|
| 返回 403 Forbidden | 请求头包含默认 requests 标识或缺少 Referer | 在 headers 中补全桌面端 User-Agent 与 Referer |
对比浏览器 Headers 发送完整字典,确认返回 200 |
| 返回 429 Too Many Requests | 短时间内请求频次超标,触发服务端限流阈值 | 引入 random.uniform 随机延时及指数退避重试 |
观察连续 20 次请求未再触发 429 报错即为达标 |
| 返回 200 但无数据 | 内容由前端 JS 动态渲染或依赖上下文 Cookie | 优先抓取 F12 中的 XHR 数据接口;或采用 requests.Session() |
检查接口返回是否直接包含目标 JSON 数据字段 |
| 全站强行弹出验证码 | 单 IP 长期高频采集触发了风控安全策略 | 暂停采集并延长休眠;仅在必要且合法合规时配置合规代理 | 排查请求速率是否超出目标网站正常承载水平 |
七、合规底线与爬虫工程规范
编写与运行网络爬虫应当恪守合法合规与技术道德规范:
- 尊重 Robots 协议:在爬取网站前,主动访问根目录下的
/robots.txt,明确哪些路径禁止爬取,自觉遵守爬虫访问准则。 - 严守频率底线,避免拒绝服务:爬虫并发度严禁设置过高,切勿对目标服务器产生性能冲击。遇到延迟增加或偶尔超时,应主动减速降频。
- 严禁触碰敏感边界:爬虫仅限于采集公开互联网信息。严禁利用技术漏洞绕过身份验证、盗取非公开数据或侵犯个人隐私信息。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















