


Python怎么用正则表达式精确匹配只含字母的字符串
在Python中精确匹配只含英文字母的字符串,最直接且安全的方式是调用re.fullmatch(r'[a-zA-Z]+', text)。本文详细解析正则表达式的构成原理、首尾锚点的约束机制、不同匹配函数的行为差异,以及规避常见匹配漏洞的完整实践方案。
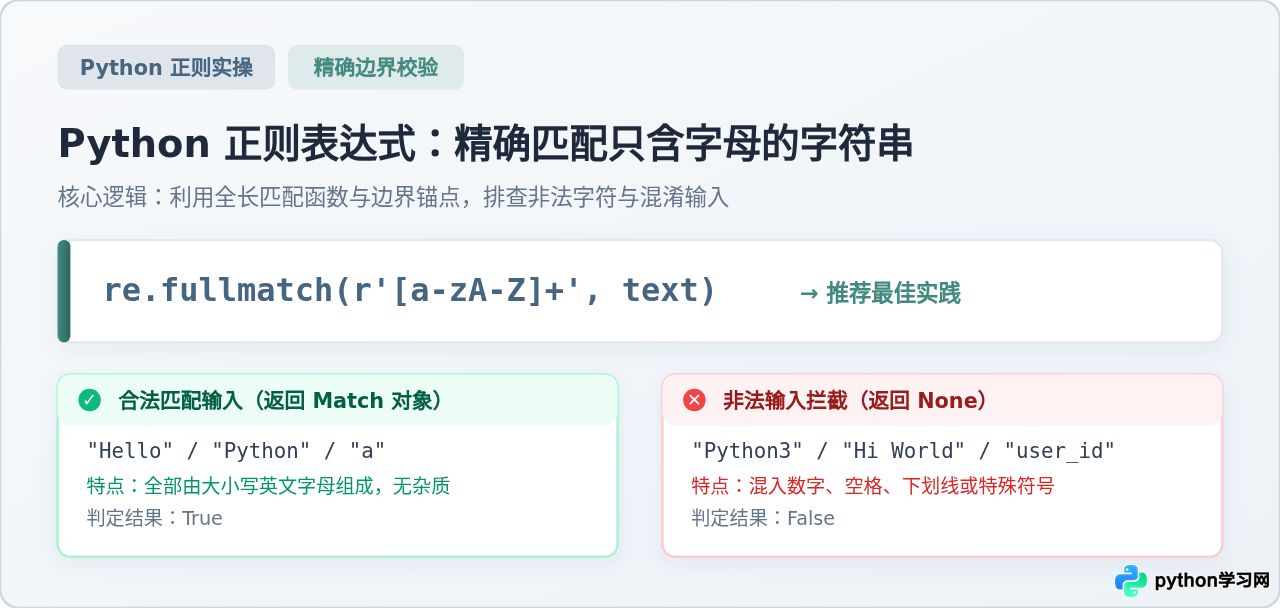
在 Python 中精确匹配只含英文字母的字符串,核心逻辑是通过正则表达式限定字符集合为大小写字母,并强制匹配整个字符串的起始与结束位置。最简洁且不容易出错的做法是使用标准库函数 re.fullmatch(r'[a-zA-Z]+', text);如果使用常规搜索方法 re.search(),则必须显式加上首尾边界锚点 r'^[a-zA-Z]+$'。本文将详细拆解该正则表达式的构成逻辑、不同匹配函数的本质差异,以及在实际开发中必须注意的边界漏洞与性能优化策略。
一、核心结论与一分钟快速用法
要判断一个目标字符串是否“全由英文字母构成,且不包含任何数字、空格、标点符号或其他字符”,可以直接调用 Python 标准库 re 模块中的 fullmatch 函数:
import re

def is_only_letters(text: str) -> bool:
    # 使用 fullmatch 确保从第 1 个字符到最后 1 个字符严格属于大小写英文字母
    return bool(re.fullmatch(r'[a-zA-Z]+', text))

# 基础测试示例
print(is_only_letters("HelloWorld"))  # 输出: True
print(is_only_letters("Hello123"))    # 输出: False (混入数字)
print(is_only_letters("Hello World")) # 输出: False (混入空格)
print(is_only_letters("")) # 输出: False (空字符串不满足至少一个字母)^ 和 $?re.fullmatch() 在底层工作时,会自动将模式隐式约束在整串范围(等价于从字符串索引 0 校验至末尾)。只有在使用 re.search() 时,才必须显式补全首尾锚点 r'^[a-zA-Z]+$'。
二、正则表达式语法拆解:如何做到“精确”与“纯粹”
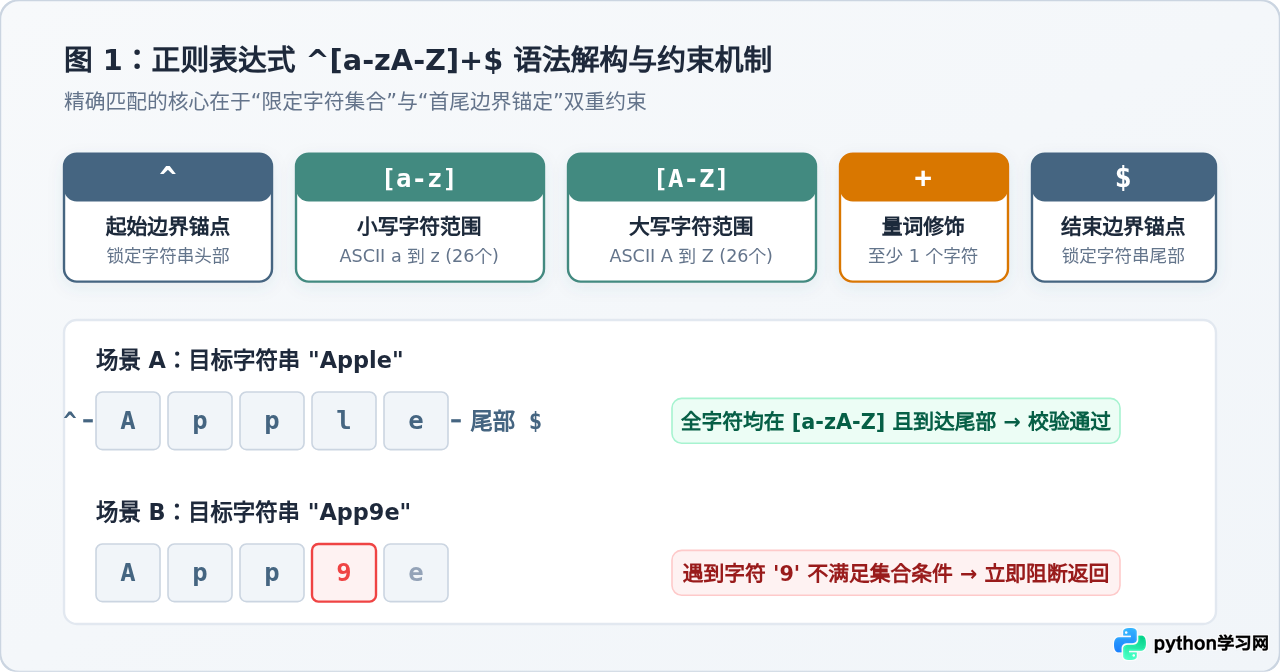
很多初学者在写正则时容易混淆“部分匹配”与“精确匹配”。要达成“只含字母”的目标,表达式 ^[a-zA-Z]+$ 中的每一个符号都有其明确的分工:
1. 字符集方括号 [a-zA-Z]
方括号表示字符类(Character Class),用来规定当前位置只允许出现的合法字符集合:
a-z:匹配从字母 'a' 到 'z' 的所有 26 个小写 ASCII 字符。A-Z:匹配从字母 'A' 到 'Z' 的所有 26 个大写 ASCII 字符。- 两者连写
[a-zA-Z]即表示“任意一个大小写英文字母”。
\w 代替纯字母在许多教程中
\w 被称为“单词字符”,但 Python 3 默认开启 Unicode 模式,\w 不仅包含了 ASCII 的大小写字母,还包含了数字 0-9、下划线 _,甚至包括全世界各语言的文字(如中文汉字“测试”在 Python 3 中完全符合 \w)。因此,要求纯英文字母时,必须显式指定 [a-zA-Z]。
2. 数量量词 + 与 * 的业务取舍
字符集右侧紧跟的量词决定了允许的字符长度:
- 使用
+(推荐):表示“1 次或多次”。即字符串中至少要有 1 个英文字母;若传入空字符串"",校验结果为False。在大多数业务场景(如姓名、代号、英文标识符)中,空字符串不属于有效字母串。 - 使用
*:表示“0 次或多次”。如果业务逻辑允许字段为空(即空字符串也算合法),则应写为r'[a-zA-Z]*'。
3. 边界锚点 ^ 与 $ 的防漏作用
^ 匹配字符串的开头(零宽断言),$ 匹配字符串的结尾。它们不消耗任何字符,只用来限定位置。缺少这两个锚点是产生逻辑漏洞最常见的根源——如果没有它们,正则表达式引擎只要在目标字符串中的任意一段子串找到字母,就会判定匹配成功,导致类似 "Python3" 或 "user@163.com" 被放行。
三、Python 中匹配函数的选择与差异(重点防坑)
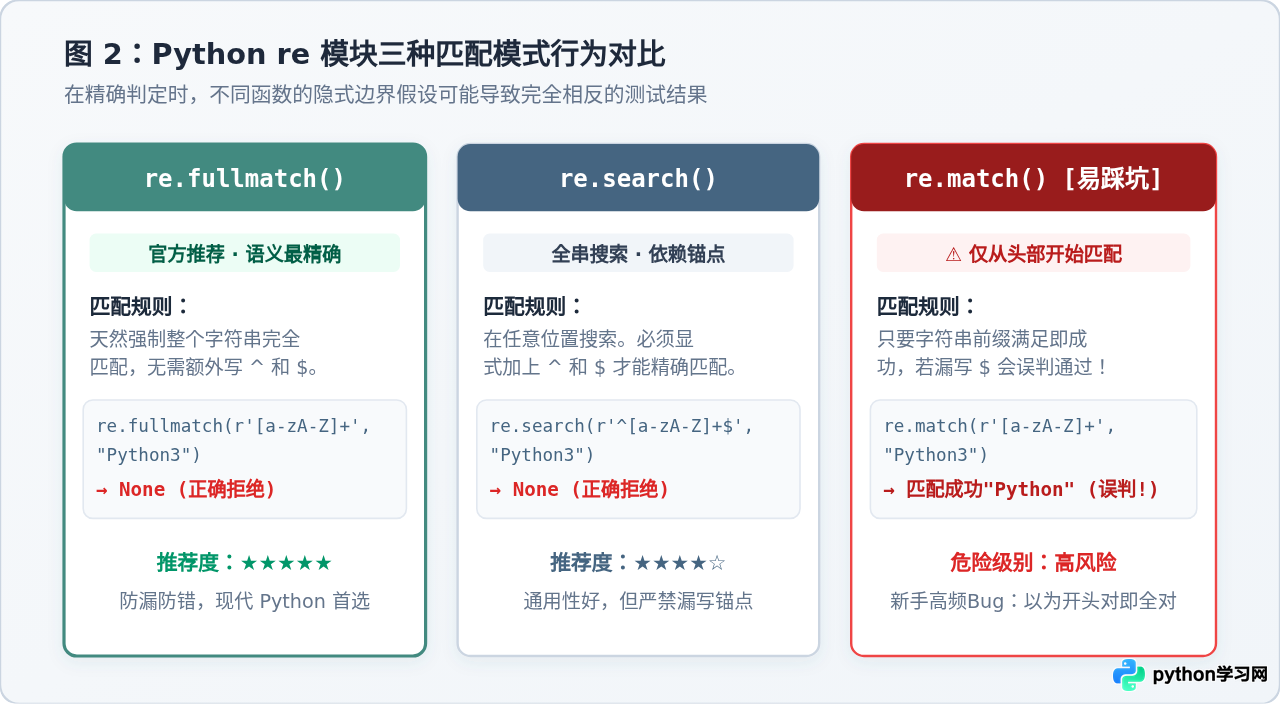
Python 标准库 re 提供了多个匹配函数。在处理“精确匹配”问题时,理解它们的行为差异至关重要。
1. re.fullmatch():最安全的首选方案
re.fullmatch(pattern, string) 在 Python 3.4 中引入,专为全长精确匹配设计。它的语义非常明确:只有当整段字符串从头到尾完整符合模式规则时,才返回 re.Match 对象;只要有任何多余字符,立即返回 None。
# 安全,且代码最为精炼
re.fullmatch(r'[a-zA-Z]+', "python")    # 返回: <re.Match object; span=(0, 6), match='python'>
re.fullmatch(r'[a-zA-Z]+', "python3")   # 返回: None (安全拦截尾部数字)
2. re.search():必须搭配 ^ 和 $
re.search() 会扫描整个字符串,寻找是否有子串满足模式。如果写成 re.search(r'[a-zA-Z]+', "123abc456"),它会在扫描到 "abc" 时立即报告成功!因此,如果使用 search,必须将首尾锚点写完整:
# 正确做法:必须严格保留首尾锚点
re.search(r'^[a-zA-Z]+$', "python3")   # 返回: None (安全拦截)
3. re.match():极易引发静默 Bug
re.match() 仅从字符串的开头位置开始匹配,但它默认不关心末尾是否有残留字符。许多开发者以为 match 相当于“全词匹配”,从而漏写了末尾的 $ 符号:
# 典型错误示例:漏写结尾锚点 $
bad_match = re.match(r'[a-zA-Z]+', "python3")
print(bool(bad_match))  # 输出: True!因为开头的 'python' 成功匹配了,'3' 被忽略!
这一隐患在实际生产中排查成本极高,因此强烈建议优先使用 re.fullmatch() 消除人为隐患。
四、纯字母字符串校验的完整执行流程
在工程实践中,严谨的校验往往不只是一行正则,还包括参数类型校验、空白字符截断策略以及结果格式化。下图清晰展示了一个健壮的校验函数所包含的流水线:
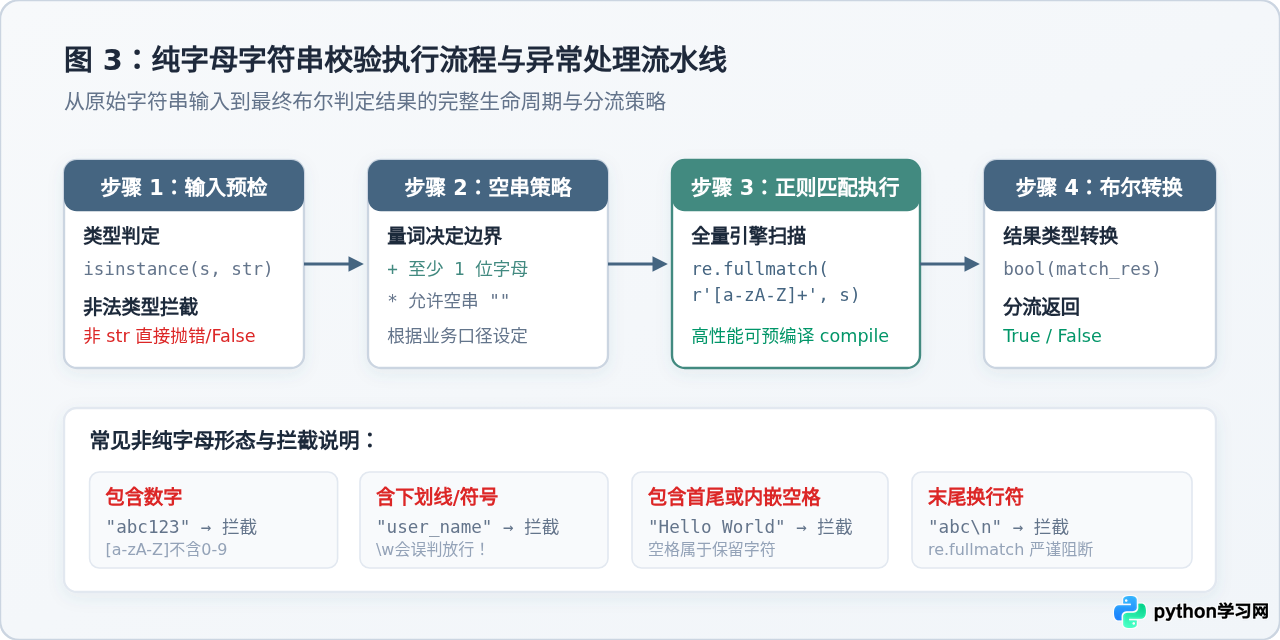
完整工程级代码实现与测试用例验证
下面是一个可直接用于生产环境的通用校验模块,内含类型守卫与常见边界测试用例集:
import re
from typing import Any

# 预编译正则对象,提升循环调用下的执行效率
ALPHA_PATTERN = re.compile(r'[a-zA-Z]+')

def validate_pure_letters(value: Any, allow_empty: bool = False) -> bool:
    """
    校验输入值是否为精确只含英文字母的字符串。

    :param value: 待校验的输入对象
    :param allow_empty: 是否允许空字符串(默认为 False,即至少需 1 个字母)
    :return: 满足条件返回 True,否则返回 False
    """
    # 步骤 1:类型前置检查,避免非字符串类型引发 AttributeError
    if not isinstance(value, str):
        return False

    # 步骤 2:空字符串策略决议
    if value == "":
        return allow_empty

    # 步骤 3 & 4:执行全长匹配并转换布尔值
    return bool(ALPHA_PATTERN.fullmatch(value))

# -------------------------------------------------------------
# 验证各类边界输入用例
# -------------------------------------------------------------
test_cases = [
    ("Python", True, "常规纯英文"),
    ("a", True, "单字母"),
    ("OpenAI", True, "大小写混合"),
    ("Python3", False, "包含数字"),
    ("user_name", False, "包含下划线"),
    ("Hello World", False, "包含空格"),
    (" Python ", False, "包含首尾空格"),
    ("Python\n", False, "末尾包含换行符"),
    ("测试Python", False, "混入汉字"),
    ("", False, "默认不允许空串"),
    (12345, False, "非字符串输入"),
    (None, False, "None 空对象")
]

if __name__ == "__main__":
    print(f"{{'输入内容':<16}} | {{'预期结果':<6}} | {{'实际输出':<6}} | {{'状态':<4}} | {{'用例说明'}}")
    print("-" * 65)
    for text, expected, note in test_cases:
        res = validate_pure_letters(text)
        status = "PASS" if res == expected else "FAIL"
        print(f"{{str(text):<16}} | {{str(expected):<8}} | {{str(res):<8}} | {{status:<6}} | {{note}}")
测试用例执行结果清单
| 测试输入 | 期望判定 | 实际结果 | 检验状态 | 测试关注点 |
|---|---|---|---|---|
"Python" |
True | True | PASS | 标准大小写英文组合 |
"a" |
True | True | PASS | 单字符最小边界 |
"Python3" |
False | False | PASS | 末尾混入数字拦截 |
"user_name" |
False | False | PASS | 下划线干扰拦截(非 \w 误判) |
"Hello World" |
False | False | PASS | 中间空格拦截 |
"Python\n" |
False | False | PASS | 换行符边界精准拦截 |
"测试Python" |
False | False | PASS | 多语言非 ASCII 字符拦截 |
"" |
False | False | PASS | 空字符串(由 + 号拦截) |
五、深度进阶:换行符细节与 Unicode 边界考量
1. $ 在末尾遇到 \n 的特殊表现
在正则表达式标准规范中,符号 $ 的定义是:匹配字符串结尾,或者结尾换行符 \n 之前的位置。这意味着:
# 注意:带有末尾换行符时,re.search 的 $ 会发生放行!
pattern = re.compile(r'^[a-zA-Z]+$')
print(bool(pattern.search("abc\n")))  # 输出: True!$ 认为结尾前是合法位置!

# 相比之下,re.fullmatch 绝不容许换行符存在:
print(bool(re.fullmatch(r'[a-zA-Z]+', "abc\n")))  # 输出: False!完全杜绝换行符!
如果业务由于历史原因必须使用 re.search,同时又必须拒绝尾部换行符,应当使用绝对边界锚点 \A 和 \Z 代替 ^ 和 $:r'\A[a-zA-Z]+\Z'。当然,直接采用 re.fullmatch() 依然是最清晰可靠的选择。
2. 忽略大小写写法的优化
如果觉得在字符集中反复声明 a-z 和 A-Z 略显繁琐,可以利用 re.IGNORECASE 标志(简写为 re.I):
# 二者在功能与匹配效率上完全等价
re.fullmatch(r'[a-z]+', text, re.IGNORECASE)
# 或者直接在表达式内嵌修饰符 (?i)
re.fullmatch(r'(?i)[a-z]+', text)
3. 正则表达式 vs 内置方法 str.isalpha()
Python 字符串原生自带了一个名为 isalpha() 的方法。许多人会问:为什么不直接用 s.isalpha(),而要用正则表达式?
str.isalpha()的本质:它是基于 Unicode 字符属性(类别为 Letter 的字符)进行判断的。不仅英文字母会返回True,德语中的变音字母ä、法语中的é,甚至所有中文字符(汉字)调用isalpha()都会返回True!例如"你好".isalpha()的结果是True。- 正则表达式
[a-zA-Z]的本质:只锁定 ASCII 编码中的 52 个标准英文字母,任何其他语言字符都会被坚决排除。
因此,如果业务需求明确要求“纯英文字符串(如验证英文名字、订单编号前缀、系统关键字)”,必须使用正则表达式 [a-zA-Z];只有当需求是“允许任意语言的文字,但不包含标点与数字”时,isalpha() 才是合适的工具。
六、总结与技术选型决策
为了在不同场景下快速选择合适的方法并规避隐患,请参考下方的选型总结图表与三大黄金准则:
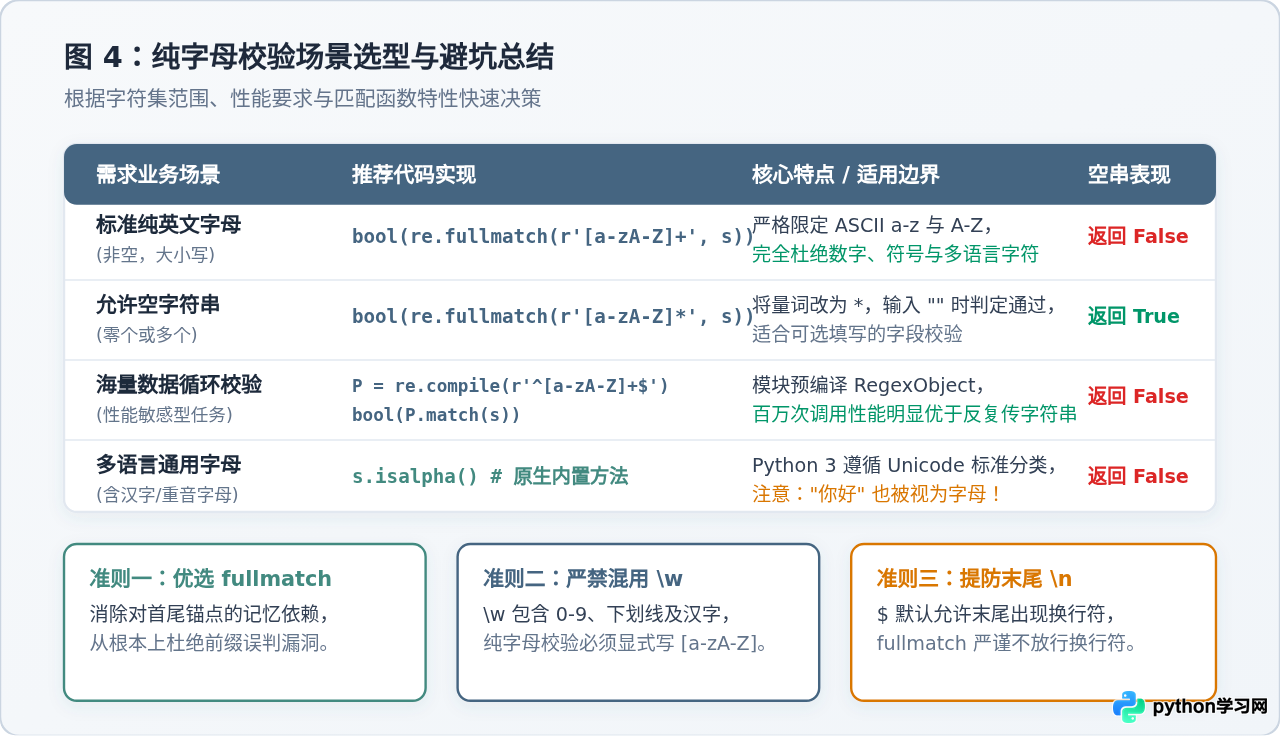
- 优先使用
re.fullmatch():它具备天然的全串精确边界,从根本上杜绝因漏写$产生的前缀误判安全隐患。 - 严格指定
[a-zA-Z]:不要为了省事而简写为\w,避免把数字、下划线和 Unicode 汉字误判为合法字母。 - 循环场景提前预编译:在批量处理几万甚至上百万条数据时,先通过
pattern = re.compile(r'[a-zA-Z]+')完成编译,再调用pattern.fullmatch(),能够显著降低正则解析开销。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















