


多个Python装饰器叠加时的执行顺序:代码验证与原理解析
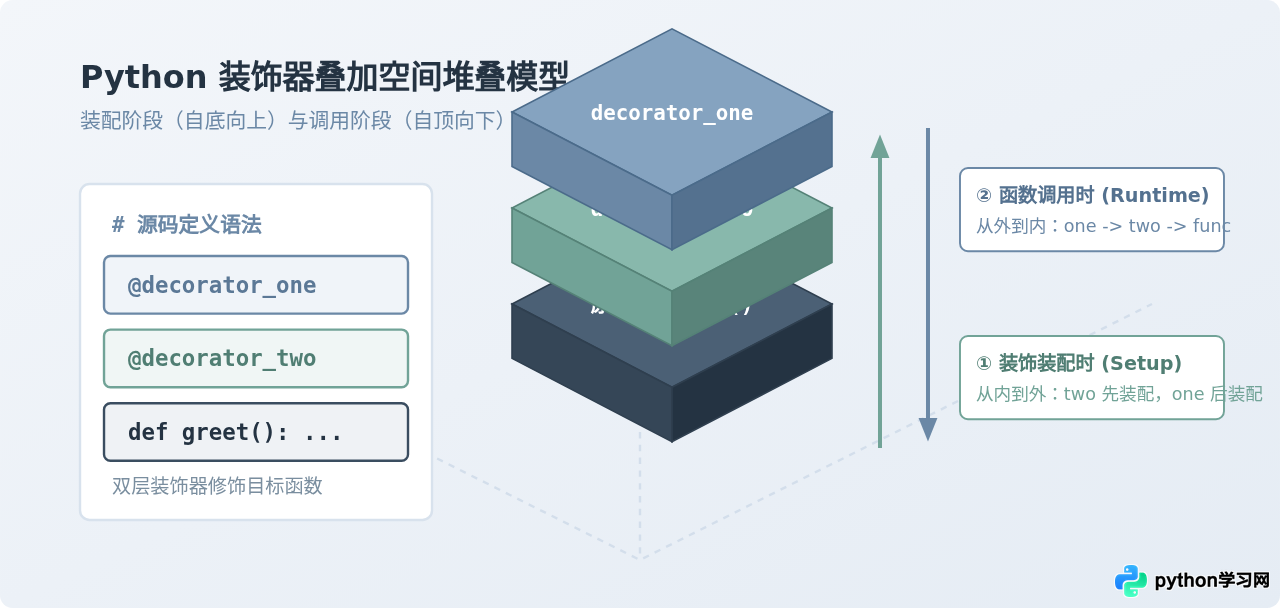
深入解析多个Python装饰器叠加时的执行逻辑。通过真实代码输出验证装饰阶段(自下而上)与调用阶段(自上而下)的双重顺序,剖析语法糖的嵌套本质与带参数装饰器的求值时序。
一、现象验证:一段可直接运行的对比代码
初学者在面对多个装饰器时,最容易产生困惑的地方在于:为什么有时候看到最底下的装饰器先输出了日志,有时候却又看到最上面的装饰器先运行?
产生这种困惑的根本原因,是没有把“装饰器本身的执行代码(定义时生效)”与“包装函数内部的代码(调用时生效)”区分开。下面我们编写一个包含明确打印语句的标准双层装饰器示例:
# test_decorators.py
# 运行环境:Python 3.8+

def decorator_one(func):
    # 此处在“装配阶段”立即执行
    print("[装配阶段] decorator_one 正在包装函数")

    def wrapper_one(*args, **kwargs):
        # 此处在“实际调用阶段”触发
        print("[调用前置] 进入 wrapper_one")
        result = func(*args, **kwargs)
        print("[调用后置] 退出 wrapper_one")
        return result

    return wrapper_one


def decorator_two(func):
    # 此处在“装配阶段”立即执行
    print("[装配阶段] decorator_two 正在包装函数")

    def wrapper_two(*args, **kwargs):
        # 此处在“实际调用阶段”触发
        print("[调用前置] 进入 wrapper_two")
        result = func(*args, **kwargs)
        print("[调用后置] 退出 wrapper_two")
        return result

    return wrapper_two


# 叠加装饰器:decorator_one 在上,decorator_two 在下
@decorator_one
@decorator_two
def greet(name):
    print(f"  >>> [目标函数执行] 你好, {name}!")
    return f"OK: {name}"

print("----- 模块加载完成,准备调用 greet() -----")
greet("Python")
运行上述代码后,终端输出的真实执行结果如下:
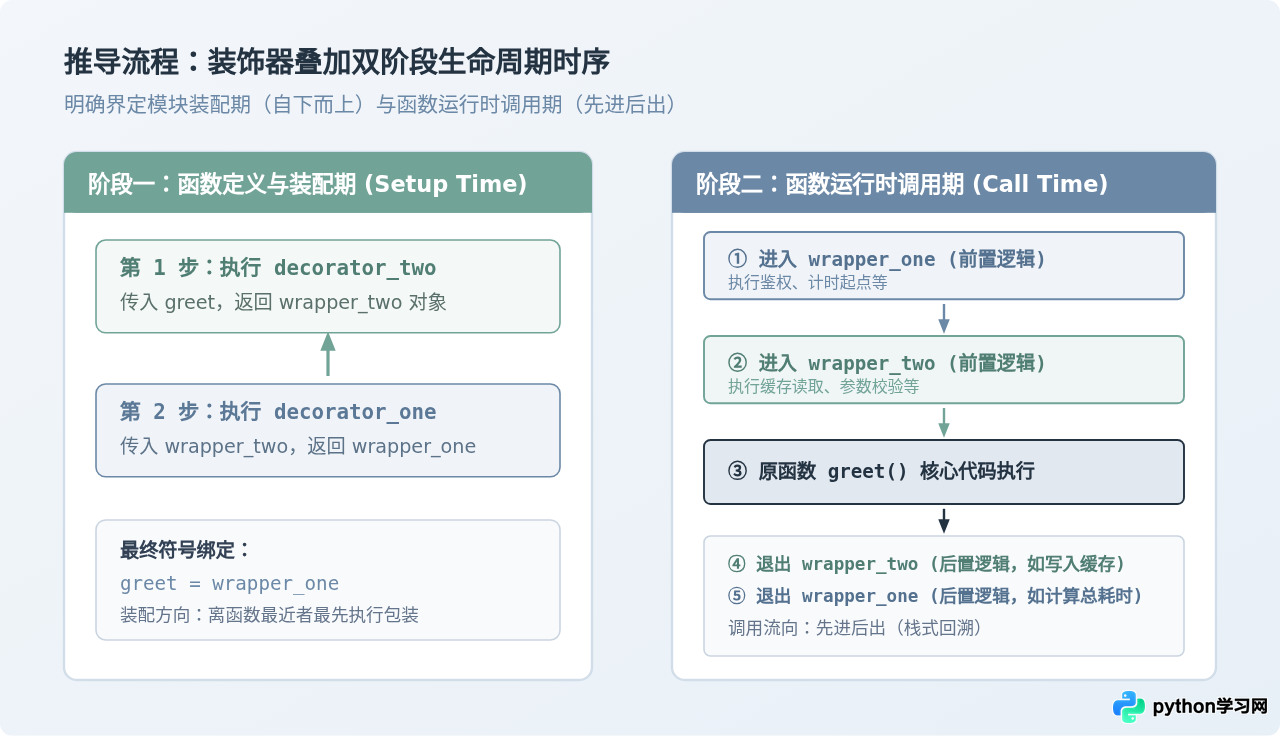
仔细观察上面的控制台输出,我们可以清晰地捕获到两条完全相反的执行轨迹:
- 装配阶段(分割线上方):在脚本加载、甚至尚未调用
greet()之前,decorator_two先执行,随后才是decorator_one。这是由下而上的。 - 调用阶段(分割线下方):当发起
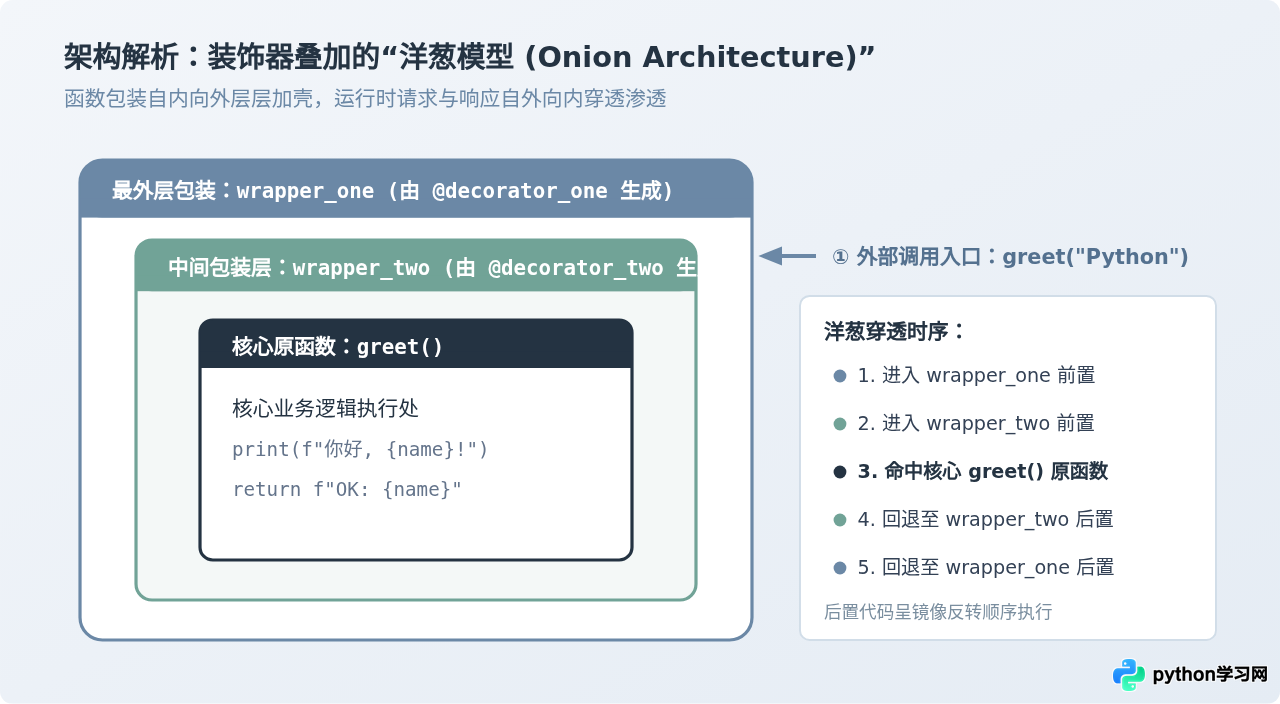
greet("Python")调用时,执行顺序变成了wrapper_one先接管,再进入wrapper_two,最后到达原函数;原函数返回后,先回到wrapper_two后半段,最终由wrapper_one收尾。这是典型的由外向内再由内向外。
二、原理解析:剥离“@”语法糖的数学嵌套本质
为什么装配阶段和调用阶段会出现这种方向上的反转?答案藏在 Python 的语法糖定义之中。
在 Python 中,语法糖 @decorator 本质上就是一次以函数为参数的高阶函数调用。当我们写下单层装饰器时:
@decorator
def greet(): pass

# 等价于显式赋值:
greet = decorator(greet)
当我们在函数上方连续叠加上两个装饰器时,Python 解释器在语法解析(Syntax Parsing)阶段按照自下而上的嵌套关系进行还原:
@decorator_one
@decorator_two
def greet(name):
    ...

# 完全等价于以下原始 Python 表达式:
greet = decorator_one(decorator_two(greet))
借助这行等价代码,一切逻辑便迎刃而解:
-
为什么装配阶段 decorator_two 先跑?
根据数学表达式及任何编程语言的函数调用求值规则,计算复合函数f(g(x))时,必须先求得内层g(x)的返回值,才能将该返回值作为参数传递给外层函数f(...)。因此,decorator_two(greet)必须首先执行。它包装了原始的greet函数,并返回了内层包装器wrapper_two。紧接着,decorator_one(wrapper_two)才能被调用,它将wrapper_two进一步包装成wrapper_one。 -
为什么调用阶段 wrapper_one 先接管?
装配完成后,全局变量名greet最终指向的是最外层的返回值——即wrapper_one!此时如果执行greet("Python"),实际上执行的是wrapper_one("Python")。
三、进阶场景:带参数的装饰器叠加时又如何执行?
在实际开发中,我们经常使用带有配置参数的装饰器(如 @app.route('/path')、@permission(role='admin') 等)。这种装饰器实际上是一个装饰器工厂函数(Decorator Factory),结构通常为三层函数嵌套。
那么当多个带参数的装饰器叠加时,其执行顺序是怎样的?我们通过代码进行实测:
# test_param_decorators.py

def factory(tag):
    print(f"[工厂求值] 正在执行 factory('{tag}') 生成装饰器")

    def real_decorator(func):
        print(f"  [装配包装] real_decorator('{tag}') 正在包装")

        def wrapper(*args, **kwargs):
            print(f"    >> [运行阶段] 进入 wrapper('{tag}')")
            res = func(*args, **kwargs)
            print(f"    << [运行阶段] 离开 wrapper('{tag}')")
            return res

        return wrapper
    return real_decorator


# 叠加两个带参数装饰器
@factory("外层 A")
@factory("内层 B")
def work():
    print("      *** 核心工作函数 work() 执行 ***")

print("--- 准备触发 work() 调用 ---")
work()
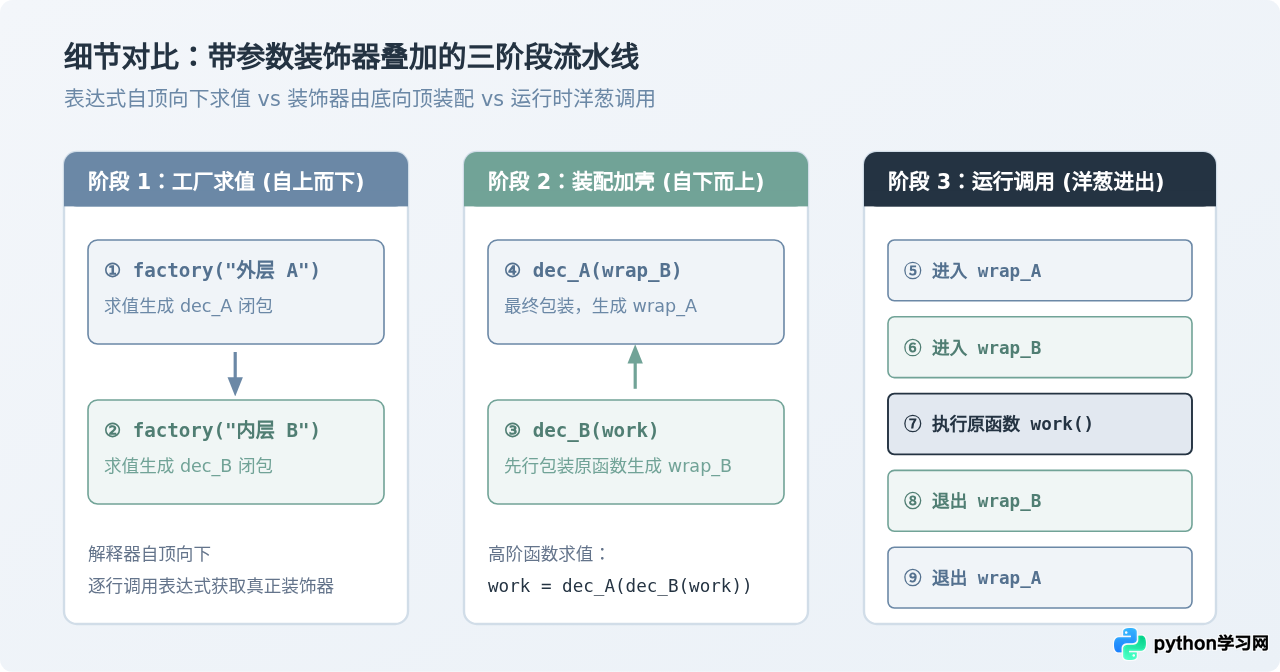
该代码在 Python 控制台输出的结果非常值得玩味:
这段输出揭示了带参装饰器叠加时的三阶段生命周期:
-
工厂求值阶段(自上而下):
Python 解析语法时,首先遇到
factory("外层 A")这个函数调用表达式,必须先执行该调用获得真正的装饰器对象;紧接着执行factory("内层 B")调用。所以工厂函数的执行是自上而下的。 -
装饰器装配阶段(自下而上):
当两个工厂都返回了真正的装饰器函数后,就退回到了普通装饰器的逻辑:底部的
real_decorator('内层 B')先行包装work,顶部的real_decorator('外层 A')随后包装前者的返回值。 -
运行时调用阶段(先进后出):
与普通装饰器完全相同,最外层的
wrapper('外层 A')先捕获调用,层层向下渗透,执行完成后再由内至外退出。
四、开发实战:叠加装饰器极易踩坑的典型场景
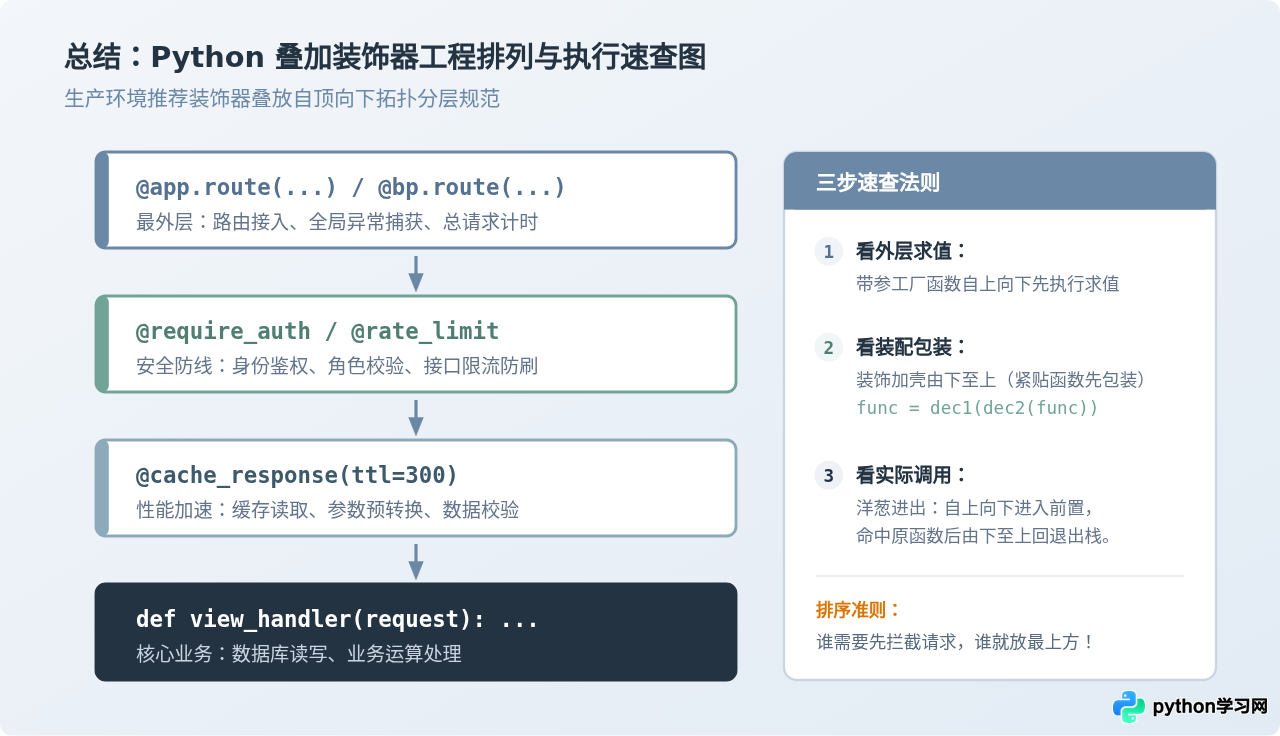
理解叠加装饰器的执行顺序绝不仅仅是应对技术面试,在实际的业务开发(如 Flask / FastAPI 接口编写、权限系统设计)中,装饰器的顺序排列直接决定了系统是否具有安全性漏洞或功能异常。
1. 鉴权与缓存的先后顺序(安全陷阱)
假设你的 Web API 同时需要做用户身份认证(@require_auth)和接口响应缓存(@cache_response)。以下两种写法有着本质区别:
| 排列方式 | 等价结构 | 执行行为与风险分析 |
|---|---|---|
方式 A(危险!):@cache_response@require_authdef get_profile(): ...
|
cache(auth(func)) |
严重安全漏洞:外层的 cache_response 先拦截请求。如果合法用户访问后生成了缓存,未经认证的恶意请求随后发起访问时,由于缓存命中直接返回数据,内层的 require_auth 根本不会被触发! |
方式 B(正确):@require_auth@cache_responsedef get_profile(): ...
|
auth(cache(func)) |
安全正常:require_auth 处于最外层,所有请求必须先完成身份合法性校验;只有通过了校验的请求,才能继续渗透到内层的缓存与核心业务。 |
2. 元数据丢失陷阱与 @wraps 的位置
当多个装饰器叠加时,内层装饰器包装了函数之后,如果不借助 functools.wraps,原函数的 __name__、__doc__ 以及类型注解就会被覆盖为 wrapper。当外层装饰器需要根据函数元数据(例如路由路径依赖 func.__name__)进行反射处理时,就会出现莫名其妙的 BUG。
规范做法:叠加链路中的每一个装饰器的包装函数内部,都应当声明 @functools.wraps(func),以确保原函数的元信息在层层包装中始终能够透传到最外层。
五、核心结论与速记口诀
最后,我们将多个 Python 装饰器叠加的本质规律整理为三句简洁明了的口诀,方便日常开发中快速推导:
- 装配自底向顶:
@A叠加在@B上,等价于A(B(func)),离函数最近的B先完成内层包装。 - 调用自顶向底:外部执行时直接调用最外壳
A的 wrapper,形成由外向内的渗透调用。 - 谁先校验谁居上:保护性拦截、鉴权、路由必须位于上层;依赖原函数返回值的处理则遵循“谁在内层谁先捕获返回值”。
@dec1
 @dec2
 def f()
默写展开为 f = dec1(dec2(f)),所有关于执行顺序的疑问都将迎刃而解。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















