


解决Python调用upper()报错:AttributeError与非字符串类型处理
详细解析Python调用.upper()时触发AttributeError报错的根因、排查流程与非字符串类型的安全转换方案,包含单值守卫、批量清洗及Pandas处理技巧。
.upper() 方法抛出 AttributeError 的根本原因,是调用对象在运行时的实际类型并非字符串(str),而是 NoneType、整数(int)、浮点数(float)、列表(list)或字典(dict)等缺少该方法的类型。解决该问题的标准路径是:先利用 Traceback 堆栈与 type() 确认目标变量在运行时的真实类型与源头,再根据业务要求采用类型守卫(isinstance)、空值特判或显式类型转换(str())进行安全包裹与清洗。
一、报错表现与底层发生机制
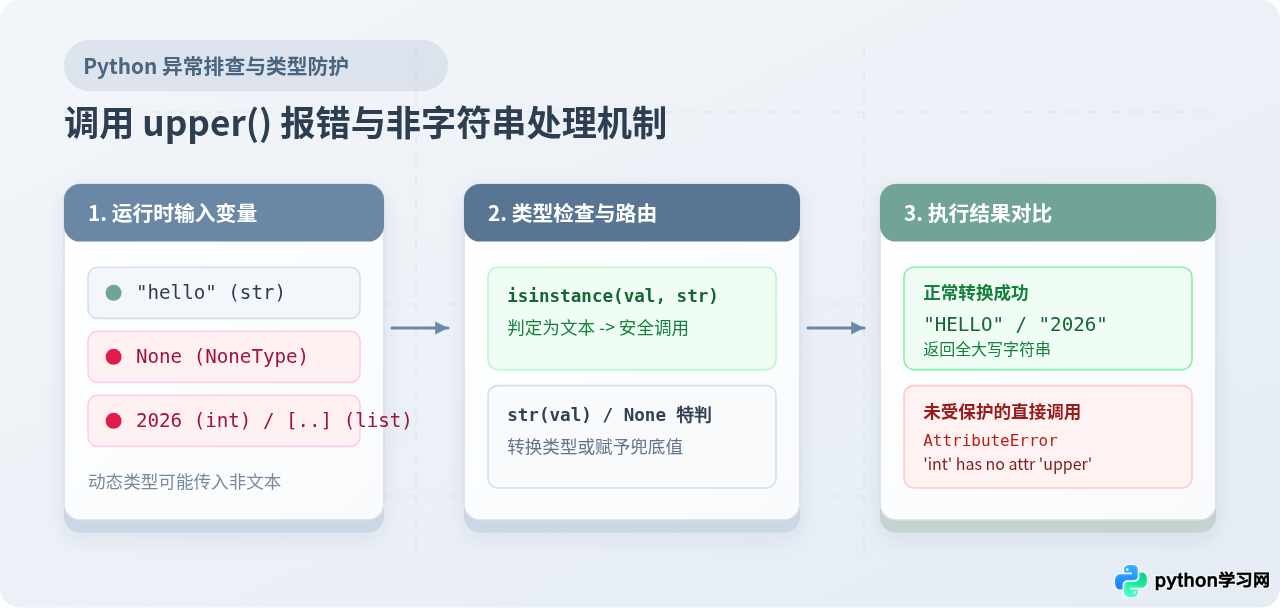
Python 是一门强类型的动态脚本语言。所谓“强类型”,意味着变量在运行时不会发生不可控的隐式类型提升;所谓“动态类型”,意味着同一个变量名在不同时间可能绑定不同类型的对象。
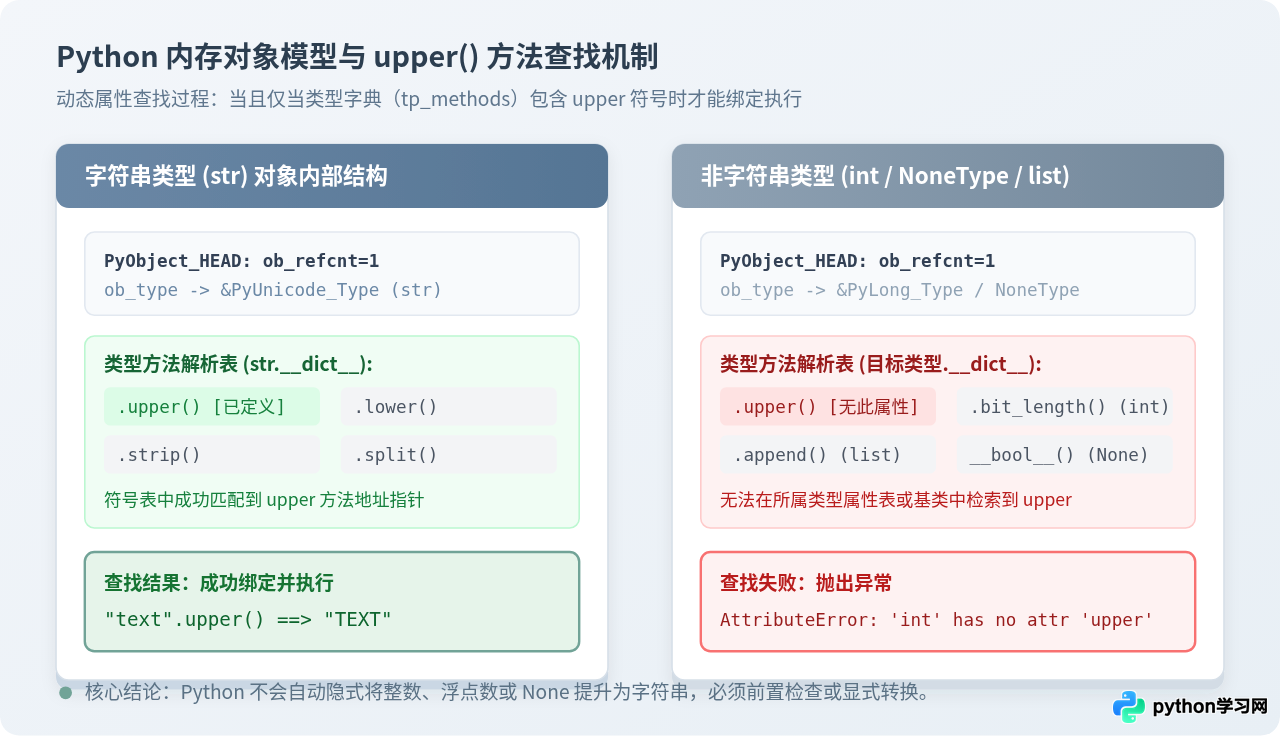
当我们在代码中执行 variable.upper() 时,Python 虚拟机会在底层检查 variable 所指向对象的类型字典(即 CPython 的 tp_methods 或类型的 __dict__)。如果该类型未实现 upper 方法,解释器便会立即中断执行并抛出 AttributeError。
典型报错场景复现
在日常开发中,该报错最常出现在解析 JSON 接口、读取 CSV 表格或从数据库拉取字段的场景中。
# 场景 1:数据库或 JSON 返回了 null,Python 中解析为 None
user_status = None
formatted_status = user_status.upper()

# 场景 2:数值类型的订单编号未加引号
order_id = 9821045
formatted_order = order_id.upper()
可以看到,错误提示非常精确地指出了类型名称:'NoneType' object has no attribute 'upper' 说明当前对象是 None;'int' object has no attribute 'upper' 说明当前对象是整数。
二、四步排查法:从回溯堆栈定位真实类型
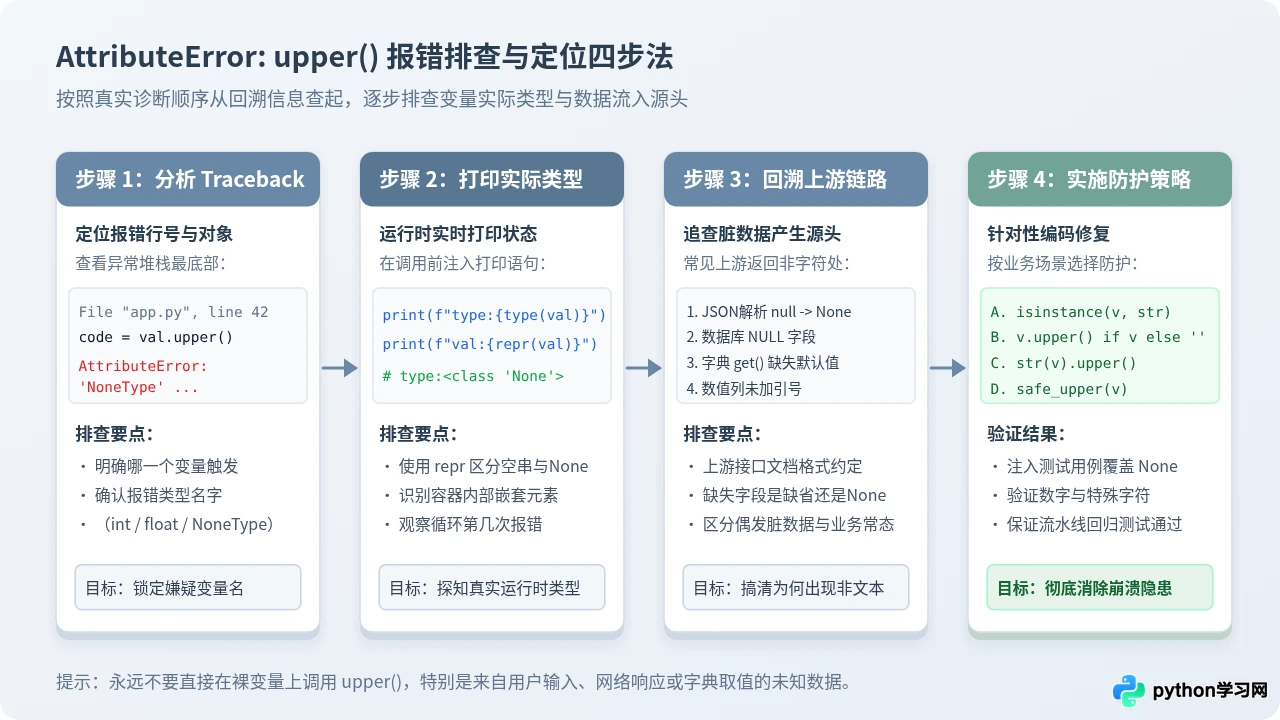
当程序在生产环境或流水线中抛出该异常时,切忌盲目地在所有地方套用 str() 强转。应当按照标准排查顺序锁定脏数据的流入路径。
步骤 1:分析 Traceback 回溯堆栈
查看异常信息的最底部两行。先确认发生错误的文件绝对路径与行号,再查看调用 .upper() 之前的变量标识符。注意区分链式调用中的主体,例如在表达式 response.get("data").get("name").upper() 中,如果是 NoneType 报错,可能是整个 get("name") 返回了 None。
步骤 2:在调用前插入运行时类型检测
在报错代码行之前,使用内置的 type() 与 repr() 打印变量的精确形态。repr() 可以清晰区分空字符串 ""、包含空格的字符串 " " 以及字面量 None。
# 在调用前进行类型探查
print(f"[DEBUG] 变量类型: {type(target_val)}")
print(f"[DEBUG] 变量表现形式: {repr(target_val)}")

# 确认类型无误后再执行
result = target_val.upper()
步骤 3:回溯上游链路的入参契约
确认了变量是 None 或数值后,需要向上排查该变量是何时被赋值的:
- 字典取值缺省:使用
data.get("code")取值,当键名不存在且未设置默认值时,默认返回None。 - 数据库字段映射:关系型数据库中的
NULL字段被 ORM(如 SQLAlchemy)或驱动读取后转换为 Python 的None。 - 纯数字编码解析:JSON 解析器将形如
"status_code": 200的字段解析为整数,而非预期的字符串。
步骤 4:选取针对性的防护策略
针对不同的业务逻辑,选择适合的防护方案,进入编码修复环节。
三、非字符串类型的防护与转换方案
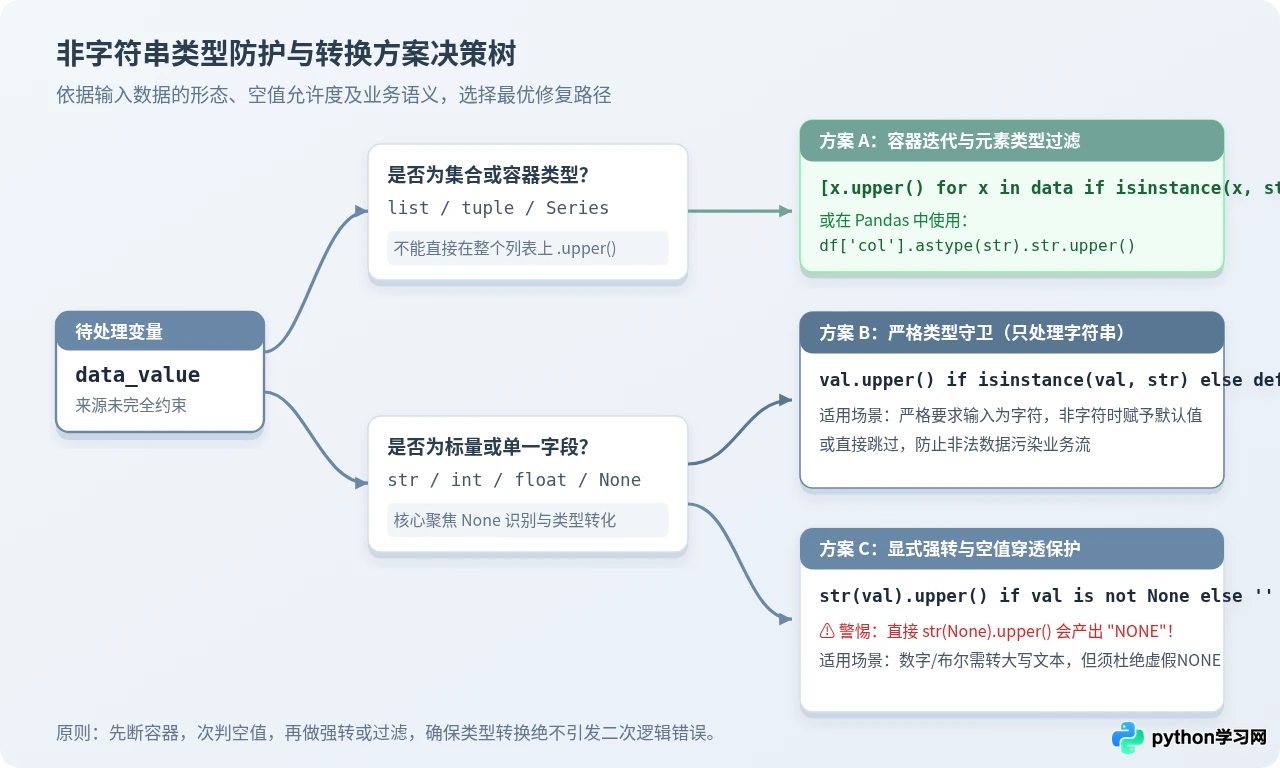
根据业务对非字符串数据的容忍度和转换需求,业界常见的修复方案主要分为以下四种:
方案 1:严格类型守卫(isinstance 校验)
当业务逻辑明确规定“只有当输入合法为字符串时才进行大写转换”,其他类型应当忽略或直接返回默认值时,使用 isinstance(val, str) 是最严谨的防御方式。
def format_code(raw_input, default=""):
    """仅对字符串执行大写转换,其他类型返回预设默认值"""
    if isinstance(raw_input, str):
        return raw_input.upper()
    return default

# 测试用例
print(format_code("beta"))       # 正常字符串
print(format_code(12345))        # 整数被守卫拦截
print(format_code(None))         # None 被守卫拦截
方案 2:显式类型转换(str() 强转与防坑)
若业务要求将数值、布尔值等内容统一转为大写文本(例如将数字状态码 404 转为文本 "404"),可以使用 str(val).upper()。
若直接执行
str(None).upper(),Python 会将 None 转为字符串字面量 "None",随后输出全大写的 "NONE"!这往往会导致空值变成有值的假象,产生严重的逻辑漏洞。因此必须结合判空三元表达式。
# 正确做法:显式排查 None
def safe_to_upper_string(val):
    if val is None:
        return ""
    return str(val).upper()

print(safe_to_upper_string("admin"))  # 输出: ADMIN
print(safe_to_upper_string(8080))     # 输出: 8080
print(safe_to_upper_string(None))     # 输出: 空字符串(避免变成 "NONE")
方案 3:容器与批量数据的过滤清洗
当数据来源于列表、集合或生成器时,直接对容器调用 items.upper() 会引发 AttributeError: 'list' object has no attribute 'upper'。处理集合数据时,应当使用列表推导式配合元素级别过滤。
raw_tags = ["python", None, 2026, "framework", ["nested"]]

# 方式 A:仅保留并转换字符串元素
clean_tags = [item.upper() for item in raw_tags if isinstance(item, str)]
print("纯字符串过滤结果:", clean_tags)

# 方式 B:对非空元素进行转文本处理
coerced_tags = [str(item).upper() for item in raw_tags if item is not None and not isinstance(item, (list, dict))]
print("非空标量强转结果:", coerced_tags)
方案 4:针对属性异常的局部异常捕获
在某些动态反射或协议兼容场景中,如果不确定输入对象是否支持类似字符串的方法协议,可以通过局部捕获 AttributeError 的方式优雅降级。
def convert_case_flexible(obj):
    try:
        return obj.upper()
    except AttributeError:
        # 对象没有 upper 方法,执行降级逻辑
        return str(obj).upper() if obj is not None else ""

print(convert_case_flexible("success"))
print(convert_case_flexible(500))
print(convert_case_flexible(None))
四、工程实践中的常见场景与对比
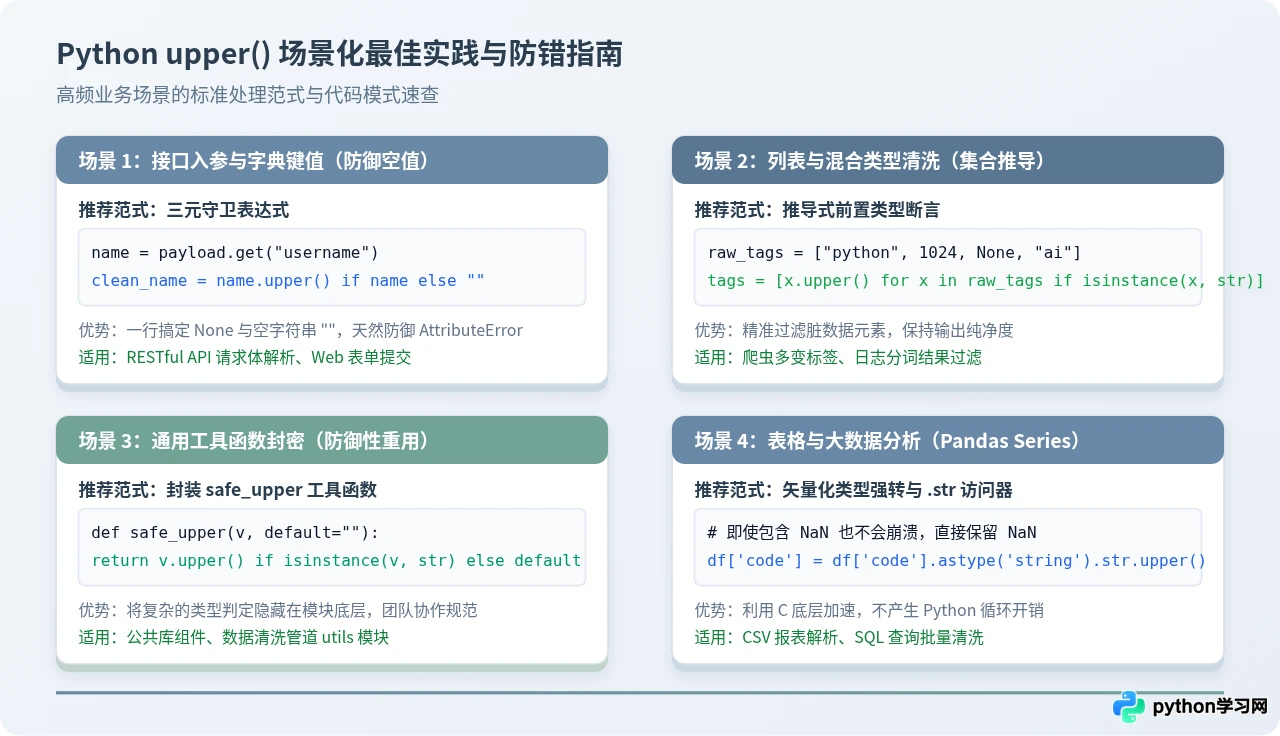
为了在实际开发中兼顾代码可读性与执行效率,以下整理了四种主流场景的处理对比:
| 业务场景 | 典型错误写法 | 推荐规范写法 | 适用考量 |
|---|---|---|---|
| Web 接口接收 JSON 字段 | req["name"].upper() |
val.upper() if (val := req.get("name")) else "" |
防止字段缺失抛 KeyError,同时防范 null 引发 AttributeError |
| Pandas 数据表清洗一列 | df['col'].apply(lambda x: x.upper()) |
df['col'].astype('string').str.upper() |
矢量化方法性能提升 10 倍以上,且原生支持保留 NaN 缺失值 |
| 日志或爬虫混合标签列表 | [x.upper() for x in tags] |
[x.upper() for x in tags if isinstance(x, str)] |
剔除非法脏数据,确保下游消费模块类型纯洁性 |
| 公共库工具模块入参 | str(arg).upper() |
封装显式守卫工具函数 safe_upper(arg) |
避免团队成员重复踩入 str(None) -> "NONE" 的陷阱 |
五、验证方法与持续防错建议
完成代码修改后,可通过以下两项步骤验证修复的有效性:
-
边界测试用例覆盖:为相关函数编写单元测试,入参必须明确包含
None、空字符串""、数值0以及空列表[],验证函数在所有非字符串入参下均能平稳返回预期的默认值,而不会使进程崩溃。 -
静态类型检查(Type Hints):在函数签名中引入 Python 静态类型注解(如
from typing import Optional),例如声明def process_name(name: Optional[str]) -> str:。配合使用mypy等静态分析工具,可以在编写代码阶段直接指出“在可能为 None 的变量上调用了 upper”的潜在隐患,从根源上杜绝此类运行时错误。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















