


Python用csv模块读取指定行数据的方法
详细讲解在Python中使用内置csv模块读取指定行数据的多种实用方法,涵盖单行定位、连续区间切片、离散行捕获与DictReader字典读取,并深度剖析流式解析原理与内存优化技巧。
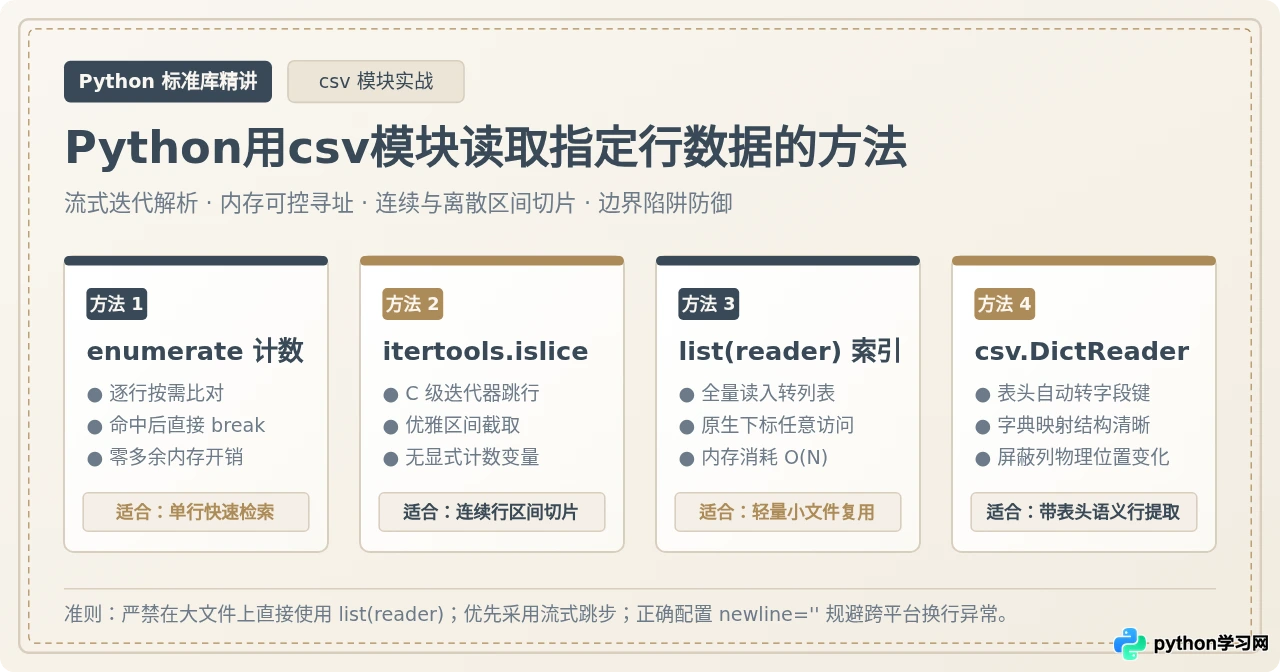
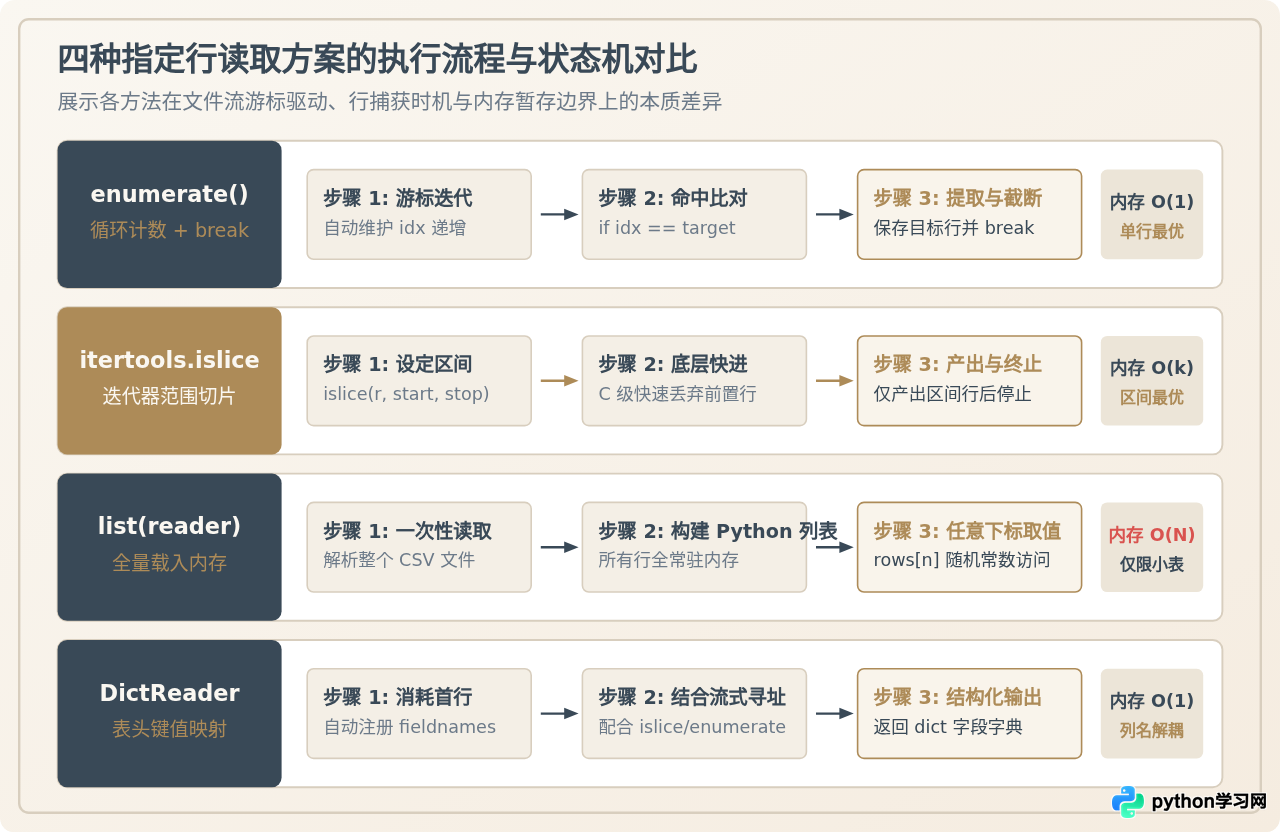
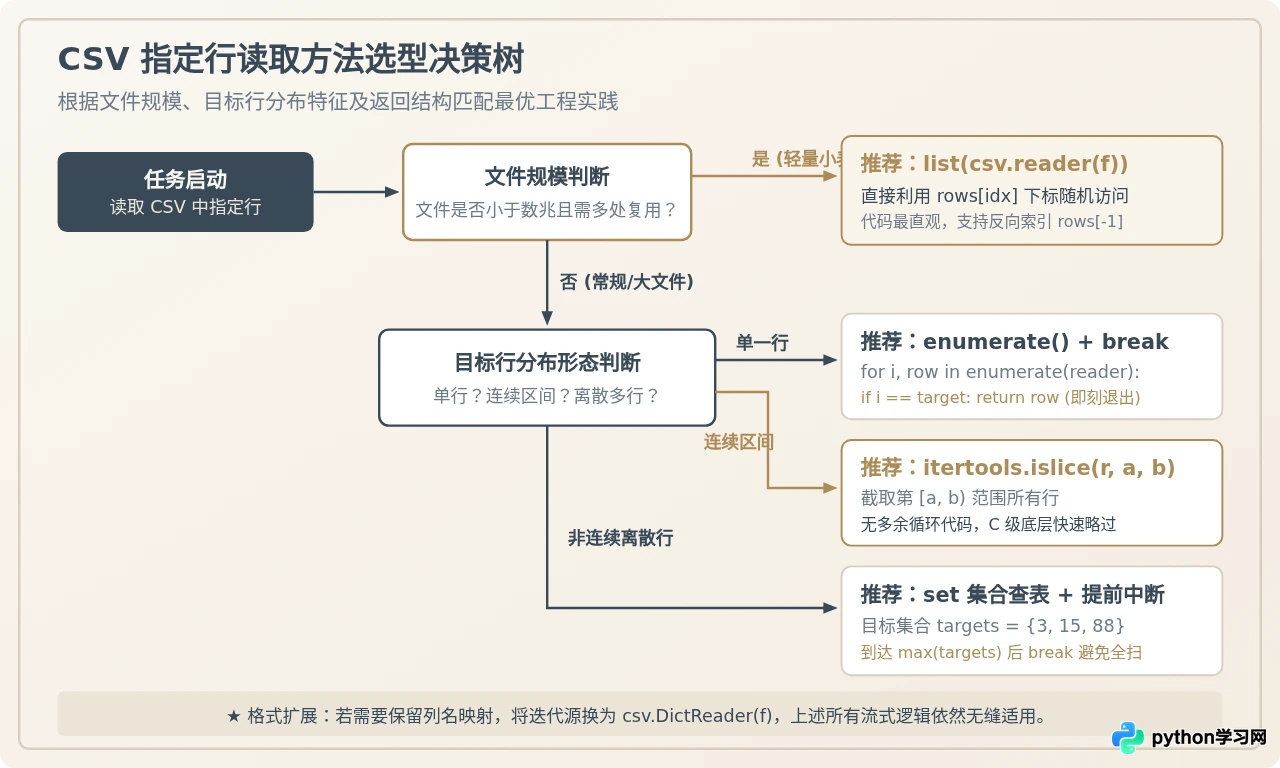
csv 模块读取指定行数据时,最稳健的做法是根据文件规模与查询形态选择合适路径:若仅需读取单行数据,使用 enumerate() 配合 break 提前跳出是最通用且内存占用为 O(1) 的方案;若需要提取连续的行区间,标准库 itertools.islice() 语法最为精炼且执行效率极高;若要按列名检索,可在 csv.DictReader 上应用同样的迭代跳步逻辑;而将整个文件转换为 list(reader) 仅适用于体积较小且需要频繁随机索引的场景。
一、为什么 CSV 文件不能直接基于索引寻址?
初学者在处理 CSV 文件时,常常试图写出形如 reader[10] 的代码,但程序会立即抛出 TypeError: '_csv.reader' object is not subscriptable 异常。这并不是 Python 语法设计上的疏漏,而是由 CSV 文本格式本身的物理结构决定的。
与固定字段长度的定长二进制数据库文件不同,CSV 文件是由纯文本构成的变长字符流。每一行的字节数取决于该行文本内容的长度,并且根据 RFC 4180 国际标准,当字段内部包含换行符(如单元格内的备注或长文本)时,内容会被双引号包裹起来。这意味着底层解析器如果不从头到尾逐个字符解析引号状态与换行标记,就根本无法确定第 N 行的精确起始字节偏移量(Byte Offset)。
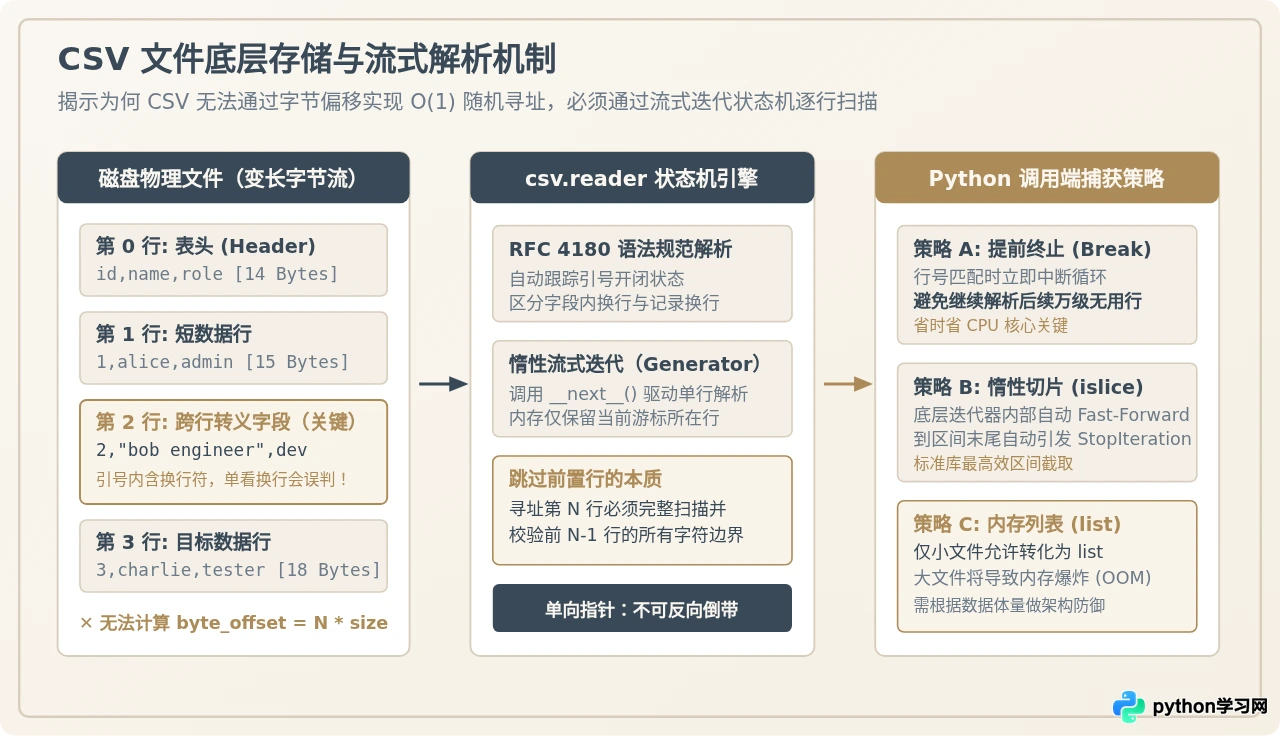
因此,Python 的 csv.reader 被设计为一个惰性单向生成器(Generator/Iterator)。它在底层维护一个状态机,每调用一次 next(),就解析并吐出一行数据,同时文件指针向前推进一步。要读取第 N 行,无论在底层还是应用层,程序都必须经过前 N-1 行的解析与跳过过程。我们追求的高性能,其核心在于“流式跳过而不存入内存”以及“命中目标后立刻截断循环”。
二、方法一:使用 enumerate() 逐行计数并提前退出(最推荐的单行读取法)
对于任意大小的 CSV 文件,如果目标是读取第 target_idx 行(以 0 为起始索引),最自然、最健壮的做法是使用内置的 enumerate() 函数对 reader 进行遍历,并在找到目标行后立即执行 break。
很多开发者容易忽略 break 语句,这会导致一个严重的性能隐患:如果一个 CSV 文件有 1000 万行,而你需要的仅仅是第 5 行,若不写 break,Python 会继续老老实实地解析完剩余的 9999995 行才结束循环,耗费大量无谓的 CPU 时间。
import csv

def get_csv_row_by_index(filepath, target_index):
    """
    通过 enumerate 逐行读取指定索引的数据行(0-based)
    """
    with open(filepath, mode='r', encoding='utf-8', newline='') as f:
        reader = csv.reader(f)
        for current_index, row in enumerate(reader):
            if current_index == target_index:
                return row
            if current_index > target_index:
                break
    return None

# 构造测试 CSV 文件
test_file = 'employees.csv'
with open(test_file, mode='w', encoding='utf-8', newline='') as f:
    writer = csv.writer(f)
    writer.writerow(['ID', 'Name', 'Department', 'Salary'])
    writer.writerow(['1001', 'Alice', 'Engineering', '8500'])
    writer.writerow(['1002', 'Bob', 'Marketing', '6200'])
    writer.writerow(['1003', 'Charlie', 'Design', '7100'])
    writer.writerow(['1004', 'David', 'Product', '9300'])

# 读取目标行:例如读取索引为 2 的行(即物理第 3 行:Bob 的数据)
target_row = get_csv_row_by_index(test_file, target_index=2)
print("获取到的指定行数据:", target_row)
在上面的例子中,物理第 0 行是表头 ['ID', 'Name', ...]。如果你希望读取“第 1 条真实员工数据”,其实对应的是物理索引 1。在编写通用函数时,应当先用 next(reader) 提取或跳过表头,再以数据行为基准从 0 开始计数,避免出现“差一错误(Off-by-one Error)”。
三、方法二:使用 itertools.islice() 截取指定行与连续区间(最优雅高效)
Python 标准库中的 itertools.islice() 是处理迭代器切片的利器。它的语法与列表切片非常类似:islice(iterable, start, stop[, step])。与普通切片不同的是,它不会一次性把整个序列装进内存,而是以 C 语言底层实现的高速迭代机制,静默跳过前 start 行,仅产生 [start, stop) 区间内的数据,到达 stop 后自动触发终止。
这一方法既可以用来精确读取单行(通过 next() 配合安全默认值),也非常适合提取连续的多行数据(例如提取分页数据或某段区间的批量记录)。
import csv
import itertools

filepath = 'employees.csv'

# 场景 A:使用 islice 读取单行(例如第 3 行,索引 2)
with open(filepath, mode='r', encoding='utf-8', newline='') as f:
    reader = csv.reader(f)
    # islice(reader, 2, 3) 仅产出索引为 2 的单行
    target_row = next(itertools.islice(reader, 2, 3), None)
    print("islice 读取单行:", target_row)

# 场景 B:使用 islice 提取连续区间行(例如读取索引 1 到 3 的数据,不包含 3)
with open(filepath, mode='r', encoding='utf-8', newline='') as f:
    reader = csv.reader(f)
    range_rows = list(itertools.islice(reader, 1, 3))
    print("islice 连续区间行切片:")
    for r in range_rows:
        print("  -", r)
islice 连续区间行切片:
- ['1001', 'Alice', 'Engineering', '8500']
- ['1002', 'Bob', 'Marketing', '6200']
itertools.islice() 的显著优势在于代码整洁、没有显式的循环逻辑变量,且底层在到达指定位置后不再产生多余的 Python 字节码开销。
四、方法三:小文件直接使用 list(reader) 内存索引(适用场景与边界)
在文件体积明确可控(例如几十 KB 到数兆字节以内的配置表、字典映射表)的前提下,将整个 csv.reader 直接转换为 Python 列表是最直观的开发方式。转换后,你可以像操作普通二维数组一样进行任意正向索引、负向反向索引或全切片。
import csv

filepath = 'employees.csv'

with open(filepath, mode='r', encoding='utf-8', newline='') as f:
    reader = csv.reader(f)
    all_rows = list(reader)  # 将所有行完全读入内存

# 支持正向与反向随机访问
first_row = all_rows[0]   # 表头
second_row = all_rows[1]  # 第一条记录
last_row = all_rows[-1]   # 最后一条记录

print("第 0 行 (表头):", first_row)
print("第 1 行 (数据):", second_row)
print("最后一行:", last_row)
第 1 行 (数据): ['1001', 'Alice', 'Engineering', '8500']
最后一行: ['1004', 'David', 'Product', '9300']
适用边界与禁止事项:当 CSV 文件增长到几十 MB 甚至数 GB 时,绝对禁止调用 list(reader)。Python 对象的内存放大效应(每个字符串对象都有额外的 PyObject 头部与内存开销)通常会使内存消耗达到物理文件体积的 3~5 倍以上,极易引发系统的内存溢出(Out of Memory)导致进程被操作系统强杀。
五、方法四:使用 csv.DictReader 读取带表头的指定行
在许多实际业务场景中,我们不希望通过物理列下标(如 row[1])去取值,因为一旦 CSV 的列顺序发生变更,代码就会产生难以察觉的静默 Bug。此时,推荐使用 csv.DictReader。
csv.DictReader 会自动把文件的首行作为字段名(fieldnames),然后将后续的每一行数据封装为以列名为键的字典。结合前述的 enumerate() 或 itertools.islice(),可以极为清晰地读取指定行。
import csv
import itertools

filepath = 'employees.csv'

with open(filepath, mode='r', encoding='utf-8', newline='') as f:
    # DictReader 会自动消耗首行作为键名
    dict_reader = csv.DictReader(f)

    # 获取数据行的第 2 条(即 David,索引 3)
    target_employee = next(itertools.islice(dict_reader, 3, 4), None)

    if target_employee:
        print("员工姓名:", target_employee['Name'])
        print("所属部门:", target_employee['Department'])
        print("完整字典:", dict(target_employee))
所属部门: Product
完整字典: {'ID': '1004', 'Name': 'David', 'Department': 'Product', 'Salary': '9300'}
特别注意:使用 DictReader 时,数据行的索引是从 0 开始的第 1 条实际数据,它已经自动为你排除了表头行的干扰,这种语义对业务逻辑更加友好。
六、高效读取多个非连续指定行
有时候业务需求并非读取单一行或一段连续行,而是需要抽取特定的离散多行(例如第 3 行、第 18 行、第 105 行)。
很多人的做法是多次打开文件,或者在循环里用 target_list 进行遍历查询。高效的做法是:将目标行号存入哈希集合 set(实现 O(1) 的查询复杂度),并在当前索引达到 max(target_set) 时立即 break 退出。
import csv

def read_discrete_rows(filepath, target_indices):
    """
    高效读取多个非连续索引的行,到达最大目标索引后提前终止
    """
    targets = set(target_indices)
    max_target = max(targets)
    results = {}

    with open(filepath, mode='r', encoding='utf-8', newline='') as f:
        reader = csv.reader(f)
        for idx, row in enumerate(reader):
            if idx in targets:
                results[idx] = row
            if idx >= max_target:
                # 已经找齐或超过所有目标行,立刻停止流式读取
                break
    return results

# 测试读取索引 1 和 3 的行
filepath = 'employees.csv'
selected_data = read_discrete_rows(filepath, target_indices=[1, 3])
for idx, content in selected_data.items():
    print(f"索引 {idx}: {content}")
索引 3: ['1003', 'Charlie', 'Design', '7100']
七、关键注意事项与避坑指南
虽然用 Python 读取 CSV 的代码通常只有寥寥数行,但在生产环境中,字符编码、平台换行差异与迭代器生命周期极易引发隐蔽的数据损毁或逻辑错误。
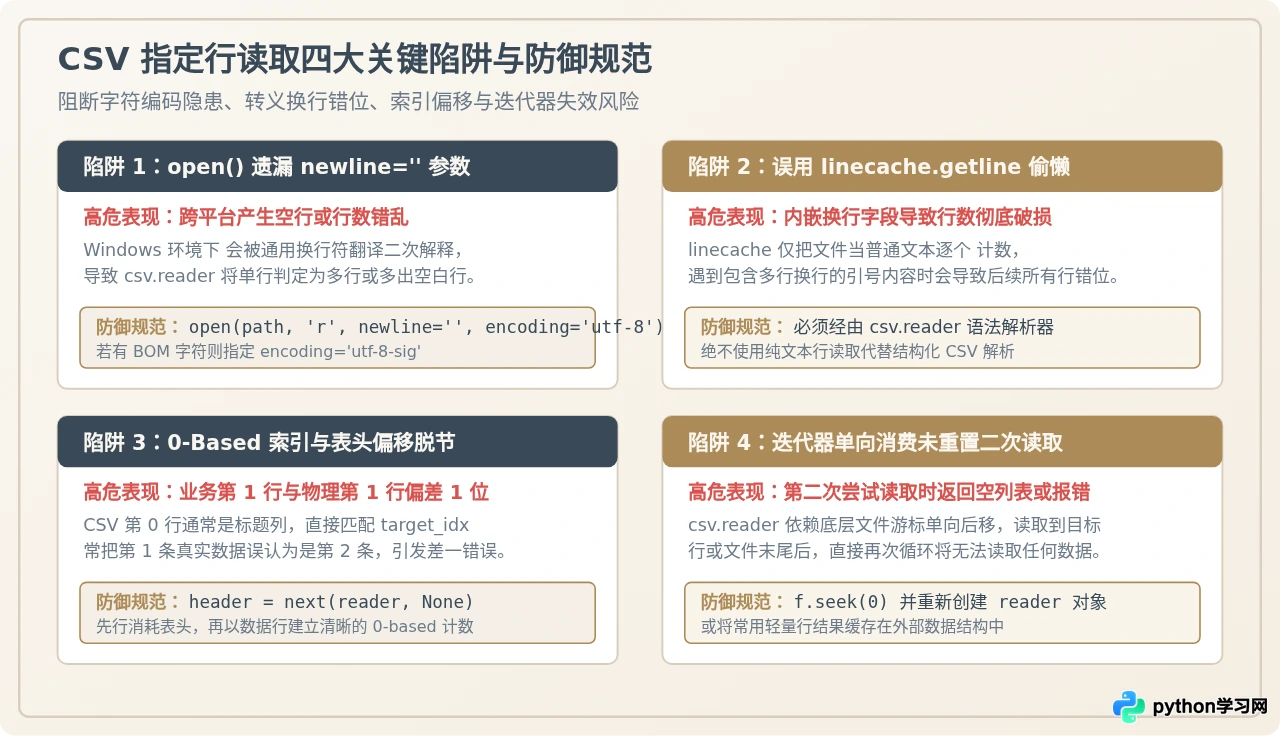
1. 打开文件必须显式传入 newline=''
Python 官方文档中特别强调:在以文本模式打开供 csv 模块使用的文件时,必须指定 newline=''。这是因为不同操作系统对换行符的定义不同(Windows 为
,POSIX 为
)。如果未指定该参数,Python 的通用换行符支持会在读取时将
翻译为
,导致 csv.reader 的内部状态机在遇到包含嵌入换行符的引号字段时发生误判,甚至在 Windows 下读取时产生多余的空行。
2. 切勿使用 linecache 偷懒读取 CSV 行
Python 标准库提供了 linecache.getline(filename, lineno),很多文章推荐用它来“一行代码读取指定行”。但在 CSV 场景下使用 linecache 是极其危险的!linecache 只是纯粹基于物理换行符
统计行数,它完全不具备 RFC 4180 CSV 语法解析能力。一旦某个字段包含多行文本(例如 "第1行
第2行"),linecache 会错误地把它算成两行,导致后续所有读取的行号完全发生偏移错位。任何涉及 CSV 格式的数据提取,必须经由 csv.reader 状态机。
3. 注意 UTF-8 BOM 字符的处理
从 Microsoft Excel 中导出的 CSV 文件通常带有 (即 UTF-8 BOM 标记)。如果直接使用 encoding='utf-8' 打开,表头的第一个字段名会变成 'ID' 而非 'ID',这会导致 DictReader 无法通过正常键名访问第一列。防御方法很简单:只要文件可能来自 Windows 或 Excel,统一使用 encoding='utf-8-sig' 打开,Python 会自动剔除开头的 BOM 标记。
4. 迭代器的单向不可逆性
csv.reader 是一个单向消费的迭代器。一旦你遍历到了第 100 行,文件指针和迭代器游标就已经停留在第 100 行所在的位置。如果此时你再试图寻找第 50 行,继续循环将一无所获。如果确实需要对同一个打开的文件进行多次重新定位,必须通过 f.seek(0) 重置文件物理游标,并重新构建 csv.reader(f) 实例。
八、方法特性汇总表
| 实现方案 | 内存复杂度 | 时间复杂度 | 最适合场景 | 主要限制 / 潜在缺陷 |
|---|---|---|---|---|
| enumerate() + break | O(1) | O(target) | 单行精确检索、超大文件提取 | 需要编写简短的循环判断语句 |
| itertools.islice() | O(k) | O(stop) | 连续行区间切片、分页加载 | 对离散不规则行提取不够灵活 |
| list(reader) 内存全载 | O(N) | O(1) | 几十 MB 以内的小文件随机多次访问 | 大文件极易导致 OOM 崩溃,严禁用于大数据 |
| csv.DictReader | O(1) | O(target) | 需要按列名提取字段的高可读性业务 | 需多耗费微量字典封装开销 |
| set 集合查表 + break | O(M) | O(max_target) | 读取多个非连续的散列行号 | 需要预先计算出最大目标行号 |
本文所列代码均基于 Python 3.8+ 标准库编写并经过完整验证,无需安装任何第三方依赖。在工程实现中,请始终根据数据规模与业务场景优先选择流式处理方案,守护服务的内存安全。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















