


Python代码中包含中文字符需要加# coding=utf-8吗
深入解答Python代码中包含中文字符时是否需要添加# coding=utf-8声明。全面解析Python 2与Python 3的编码机制差异、PEP规范背景、常见SyntaxError报错排查步骤以及现代Python工程的最佳实践。
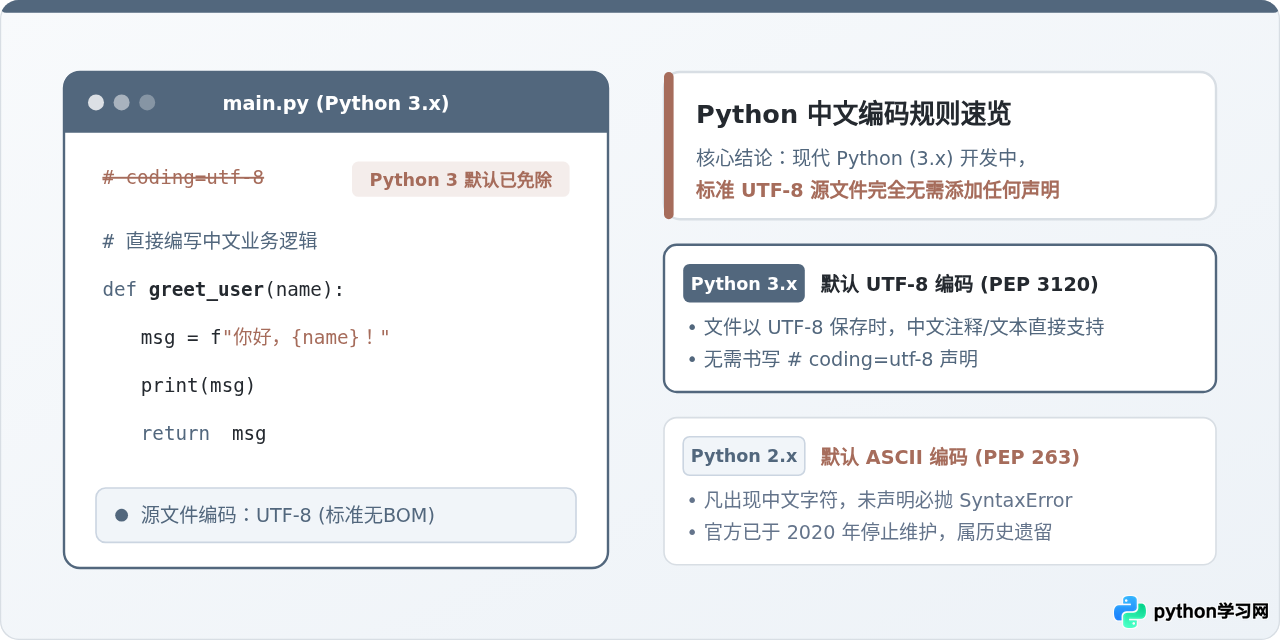
# coding=utf-8。Python 3 已正式将 UTF-8 确立为源文件的默认编码方式。过去常见必须添加该声明的现象,属于 Python 2 时代的遗留规范,或用于极少数源码被保存为 GBK/ANSI 等非 UTF-8 编码时的特殊场景。
一、为什么大家总觉得“必须加”?历史根源剖析
很多开发者在刚学习 Python 时,常在教科书、网络教程或老项目的源码第一行看到类似 # -*- coding: utf-8 -*- 或 # coding=utf-8 的声明。这容易让人产生一种误解,以为只要在 Python 代码里写了中文,这行代码就是必不可少的语法要求。其实,这种认知的产生完全源于 Python 语言的历史演进。
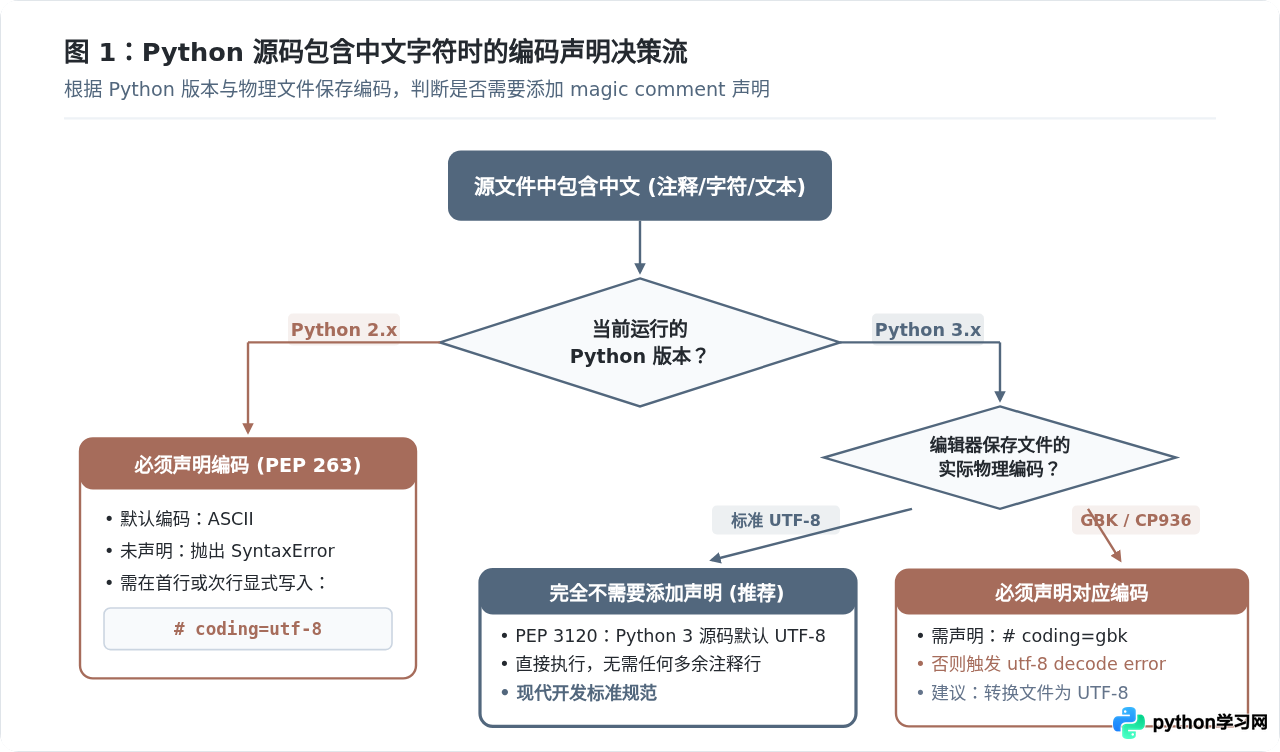
在 Python 2 时代(该版本已于 2020 年正式停止维护),解释器默认将源码文件视为纯 ASCII 编码(见 PEP 263 规范)。ASCII 字符集仅包含 128 个基础字符,不包含任何汉字。当你在 Python 2 源码中键入汉字注释或文本时,文件中就会出现大于 127 的字节序列。Python 2 解释器在编译分析源码时一旦遇到这些字节,就会立即中断执行并抛出语法错误:
# Python 2 环境下的经典错误示例
SyntaxError: Non-ASCII character 'ä' in file test.py on line 3, but no encoding declared; see http://python.org/dev/peps/pep-0263/ for details
为了解决这一问题,PEP 263 引入了“编码声明魔术注释(Magic Comment)”,强制开发者必须在文件的第一行或第二行显式声明 # coding=utf-8,告知解释器采用 UTF-8 规则解码源码字节流。因为 Python 2 流行了十余年,这行模板化注释被深深固化在很多老程序员的肌肉记忆与旧教程中,并被代代相传至今。
二、现在的运行机制:Python 3 的默认编码革新
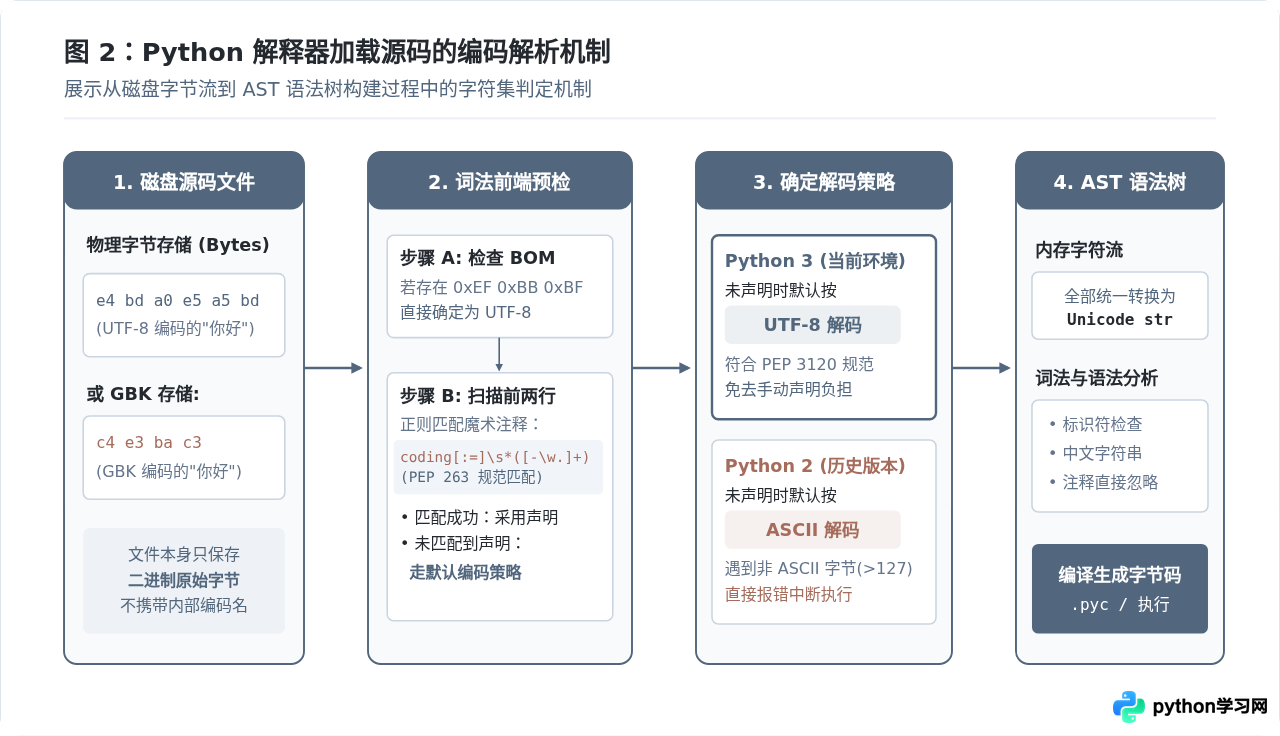
从 Python 3.0 开始,Python 官方推出了 PEP 3120 规范,彻底改变了源码的默认编码机制:Python 3 将 UTF-8 直接确立为源代码文件的唯一标准默认编码。
这意味着,只要你的代码编辑器默认将文件保存为 UTF-8 格式(当前主流开发工具如 VS Code、PyCharm、Sublime Text 乃至现代化文本编辑器均默认采用此配置),Python 3 解释器在读取 .py 文件时,就会直接按照 UTF-8 格式进行无损解码。无论是中文单行注释、多行文档字符串(Docstring),还是实际的业务文案,都可以原生编写并直接运行。
不仅如此,Python 3 甚至在词法分析器中支持了 Unicode 标识符。例如在以下完全纯净的 Python 3 脚本中,没有任何编码声明,执行完全正常:
# 这是一个普通的 Python 3 脚本,无需任何 # coding=utf-8 声明

def 欢迎新用户(用户名: str) -> str:
    # 可以在代码中自由编写中文注释与业务提示
    欢迎语 = f"您好,{用户名}!欢迎登录系统。"
    return 欢迎语

if __name__ == "__main__":
    结果 = 欢迎新用户("张三")
    print(结果)
在 Python 3 中直接运行上述代码,解释器能够流畅地完成词法分析、AST 抽象语法树构建并生成字节码,不会抛出任何编码警告或异常。
三、什么时候仍然需要写 coding 声明?
既然 Python 3 默认就是 UTF-8,那是不是说 # coding=... 语法完全失效了?并非如此。PEP 263 的解析规则在 Python 3 中依然保留,只是默认值由原来的 ASCII 升级为了 UTF-8。在以下极少数特殊场景下,编码声明依然具有特定作用:
1. 源文件被保存为非 UTF-8 编码(例如 GBK 或 ANSI)
这是在 Windows 平台或维护陈年遗留系统时较常碰到的情况。例如,某些老旧编辑器(如 Windows 早期记事本或特定开发工具)在简体中文系统下默认以 GBK/CP936 编码保存文件。如果一个 .py 文件被以 GBK 编码保存,而其中恰好含有汉字,Python 3 按照默认的 UTF-8 规则去解码 GBK 的双字节序列时就会失败,并报出以下异常:
# Python 3 读取 GBK 编码文件时的经典报错示例
SyntaxError: (unicode error) 'utf-8' codec can't decode byte 0xd5 in position 0: invalid continuation byte
此时,如果必须保持该文件为 GBK 编码,就必须在文件首行声明 # coding=gbk。这样 Python 3 解释器就会根据 PEP 263 规则,放弃默认的 UTF-8,改用 GBK 解码器来解析源码。
在现代软件工程中,即便遇到了上述报错,也不推荐通过在代码里写 # coding=gbk 来迁就老文件。更健康的做法是将编辑器设置为 UTF-8,并将该文件重新另存为“UTF-8 without BOM”,使整个项目彻底消除非标准编码的隐患。
2. 需要兼顾 Python 2 的历史过渡项目
如果你的代码仓库属于极少数仍在维护的底层库,且明确要求同一套代码必须在 Python 2.7 与 Python 3.x 之间完全兼容运行,那么为了迁就 Python 2 的解释器,必须保留 # -*- coding: utf-8 -*-。但在绝大多数新建项目与现代化生产环境中,这一兼容需求早已不复存在。
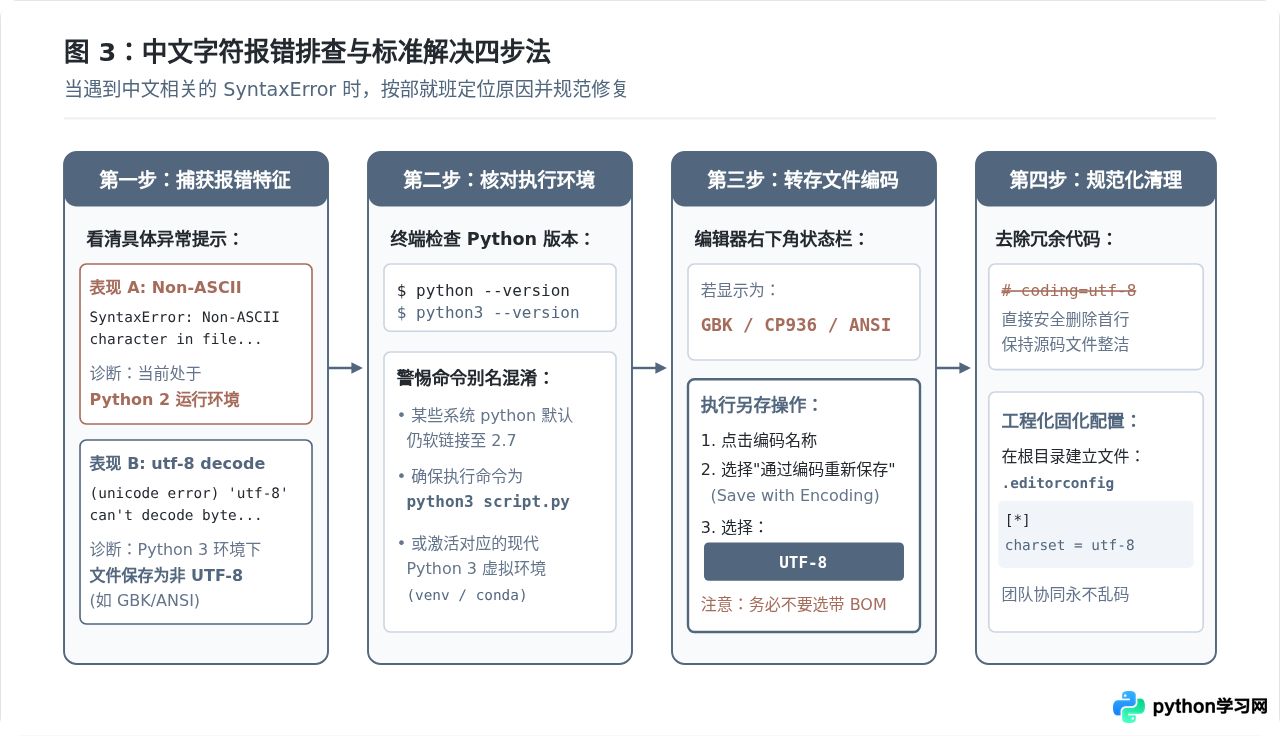
四、遇到中文编码报错时的标准排查步骤
如果你在运行包含中文字符的 Python 脚本时遇到了 SyntaxError,不要盲目地直接复制一行 # coding=utf-8,请按照以下四个标准步骤进行排查与修复:
-
第一步:识别具体的报错信息。
如果报错信息中包含Non-ASCII character ... but no encoding declared,说明当前调用的解释器实际上是 Python 2;如果报错信息是'utf-8' codec can't decode byte...,说明当前是在 Python 3 下运行,但物理文件的真实保存编码不是 UTF-8。 -
第二步:核对当前终端执行的 Python 版本。
在终端输入python --version或python3 --version。在部分 Linux/macOS 环境或未经配置的旧服务器中,系统全局的python命令可能依然软链接在 Python 2.7。请确保使用python3 main.py执行程序,或者在对应的现代虚拟环境(venv/conda)中运行。 -
第三步:检查并转换物理文件保存编码。
观察编辑器右下角状态栏显示的字符编码。在 VS Code 中点击右下角的编码名称(如显示为 GBK 或 Windows-1252),选择“通过编码重新保存(Save with Encoding)”,然后选择 UTF-8。注意:千万不要选择带 BOM(Byte Order Mark)的“UTF-8 with BOM”,否则部分旧工具在解析首行时可能产生不可预期的前导字符冲突。 -
第四步:清理冗余声明并规范工程配置。
当文件确认为标准的 UTF-8 格式且在 Python 3 下运行后,直接删除文件顶部的# coding=utf-8。在项目根目录下创建.editorconfig文件,统一全团队的编码标准:# .editorconfig 统一编码配置示例 [*] charset = utf-8 end_of_line = lf insert_final_newline = true
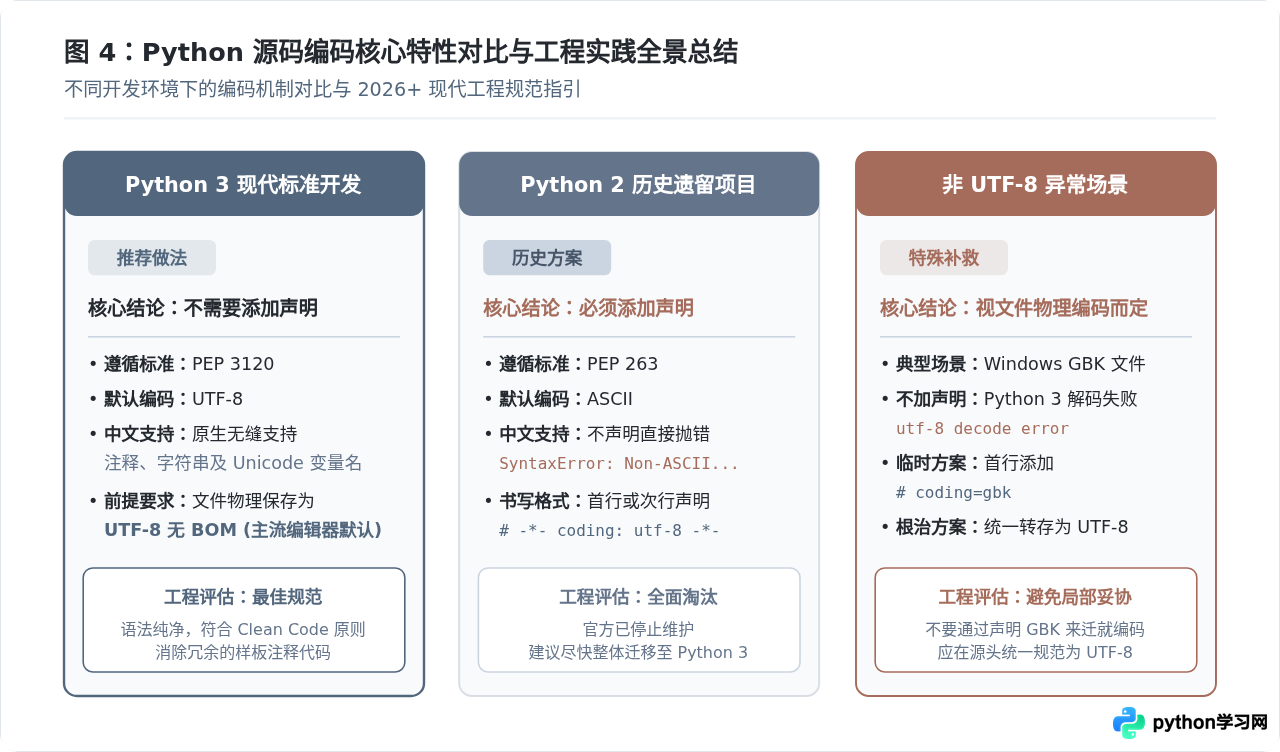
五、全景对比与工程实践总结
为了便于直观对照与技术决策,下表系统总结了不同开发场景下的编码机制、规则依据与推荐做法:
| 场景与维度 | Python 2.x (历史环境) | Python 3.x (现代标准) | 非 UTF-8 异常场景 (如 GBK) |
|---|---|---|---|
| 默认源码编码 | ASCII (仅 128 个基础字符) | UTF-8 (原生多语言支持) | 由操作系统或旧编辑器决定 |
| 规范出处 | PEP 263 | PEP 3120 | PEP 263 回退机制 |
| 含中文时是否需要加声明 | 必须添加 (否则 SyntaxError) | 完全不需要 (直接原生运行) | 若保留非 UTF-8 则需显式声明对应编码 |
| 推荐书写方式 | # -*- coding: utf-8 -*- |
无任何声明 (Clean Code) | 不建议声明 GBK,推荐直接转存为 UTF-8 |
| 当前生命周期状态 | 2020 年官方已终止维护 | 长期稳定标准方案 | 工程债务,应在源头统一消除 |
综上所述,在当下的 Python 开发中,只要你的工作流基于 Python 3,并且遵循将源码保存为 UTF-8(无 BOM)的标准习惯,就请放心大胆地在代码中书写中文注释与文本,完全不需要也不建议额外添加 # coding=utf-8。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















