


Python怎么将字符串每个字符转为列表元素
详细讲解在Python中将字符串每个字符转为独立列表元素的常用方法,包含内置list()函数、列表推导式及循环追加,并对比性能差异、避坑指南与最佳实践。
list(string)。例如 list("Python") 将立即返回 ['P', 'y', 't', 'h', 'o', 'n']。若在拆分的同时需要进行字符过滤、大小写格式统一或条件筛选,则可以使用列表推导式;如果需要复杂的断点追踪或状态判断,可采用基础的 for 循环追加。
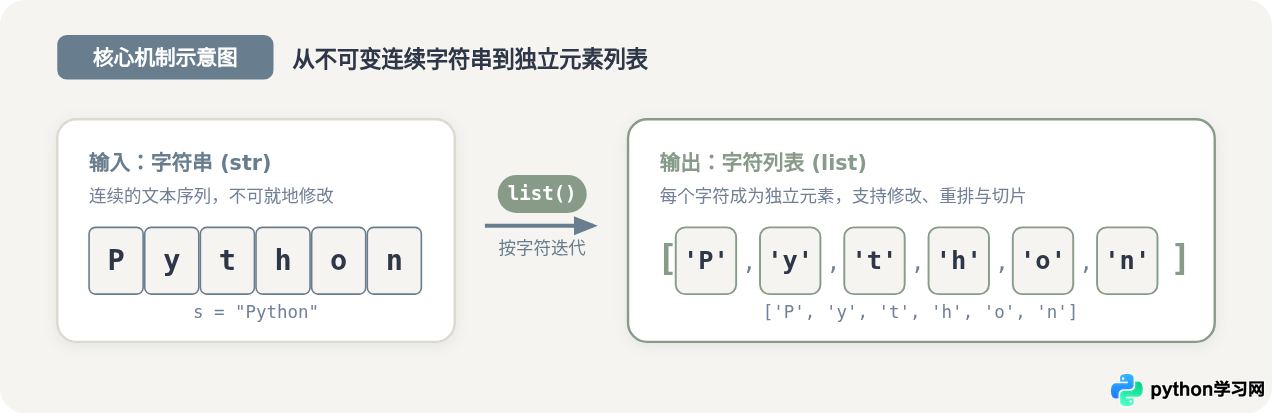
方法一:使用内置 list() 函数(最直接首选)
Python 中将整个字符串拆解为字符列表的标准做法是使用 list() 函数。Python 的字符串(str)本质上是一个不可变的字符序列,天然实现了序列与可迭代对象协议(Iterable Protocol)。因此,当把字符串传给 list() 时,Python 会逐个提取其中的字符,放入新创建的列表中。
代码示例
# 定义一个包含字母与标点的字符串
text = "Hello, World!"

# 直接使用内置 list() 函数转换
char_list = list(text)

# 打印结果与列表长度
print(char_list)
print("列表长度:", len(char_list))列表长度: 13
从示例输出可以看到,包括逗号和空格在内的每一个原生字符都被精准切分成了列表里的单字符元素。原字符串共有 13 个字符,转换后得到的列表长度同样为 13。
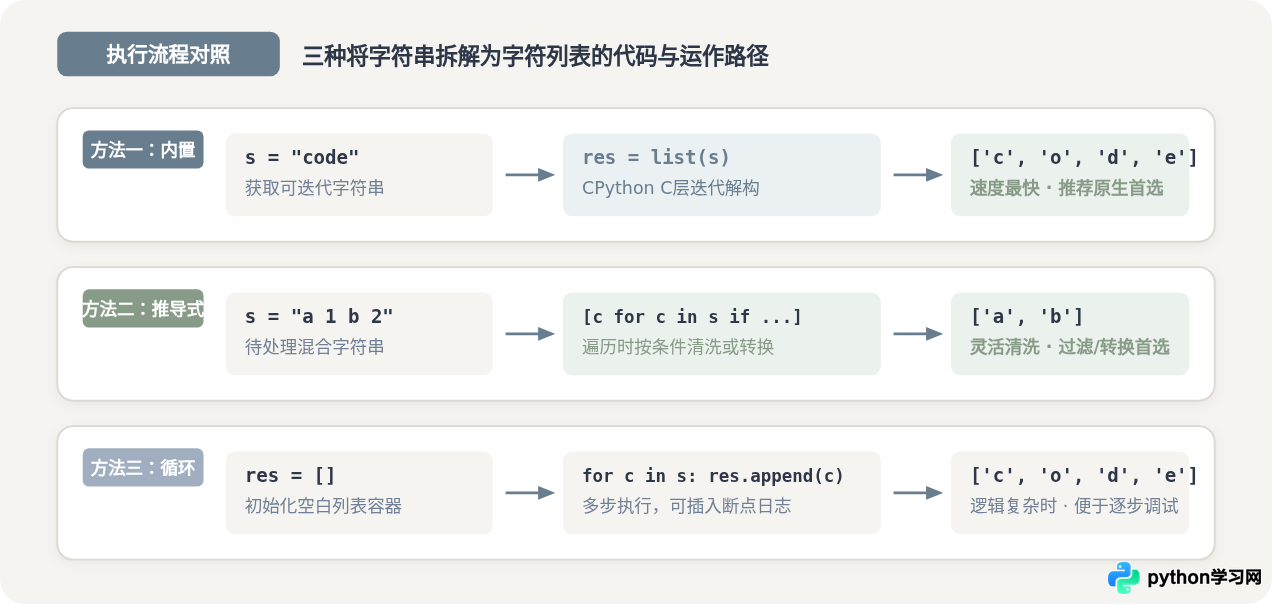
底层运作:为什么 list() 能无缝拆分字符串?
许多初学者会疑惑,为什么 list() 接收数字如 list(12345) 会报错 TypeError: 'int' object is not iterable,而接收字符串却可以完美拆分。
关键原因在于底层接口支持:Python 中的字符串内置了 __iter__() 方法。当 list(s) 被调用时,解释器在 C 语言层面调用底层的迭代协议,依次产出索引 0, 1, 2, ... 对应的单字符对象,并预估列表空间一次性分配,写入对象指针。这使得 list() 的执行速度远超任何用 Python 语法手动书写的循环。
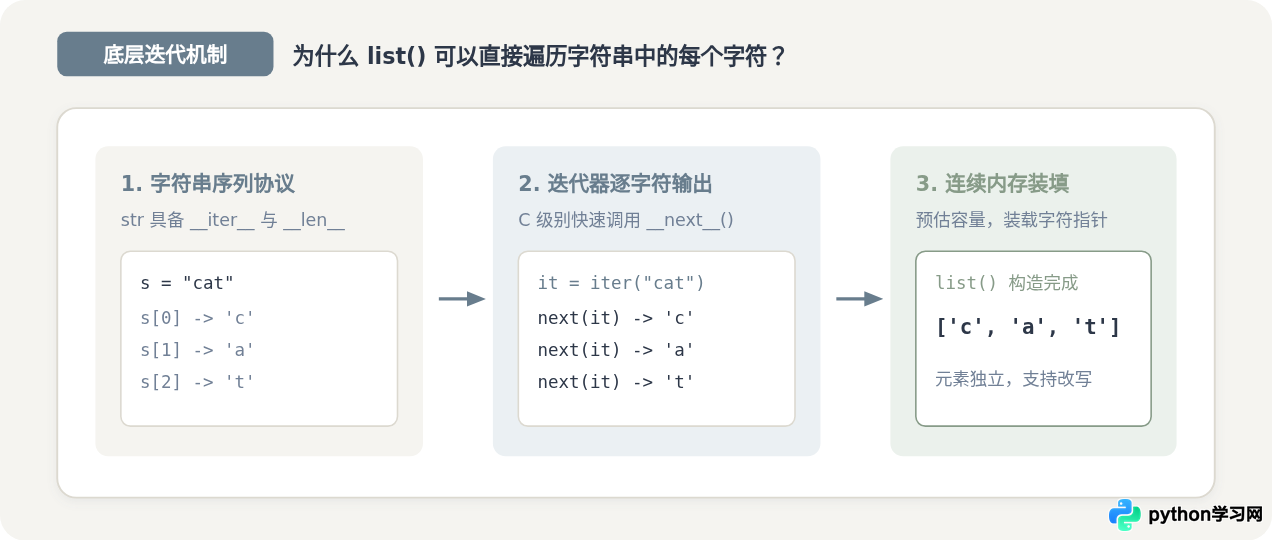
方法二:使用列表推导式(灵活变换与过滤)
如果不仅仅是将字符拆开,还希望在拆解的过程中对字符进行同步处理,列表推导式(List Comprehension)是最佳选择。
列表推导式的核心语法为 [char for char in text]。它的优势在于允许在单行内嵌入转换表达式与 if 条件分支,避免了“先拆出全量列表、再写循环清洗二次遍历”的冗余操作。
场景 1:仅提取字母并统一转为大写
raw_text = "Py 3.10!"

# 仅保留英文字符,并统一转换为大写
filtered_chars = [c.upper() for c in raw_text if c.isalpha()]

print(filtered_chars)场景 2:剔除不可见的空格与制表符
dirty_str = "A B	C
"

# 过滤所有空白字符
clean_chars = [c for c in dirty_str if not c.isspace()]

print(clean_chars)方法三:使用 for 循环与 append() 追加
对于刚入门的开发者或面对复杂多分支业务时,标准的 for 循环配合 append() 是最直观、容错率最高的写法。
source = "data"
result = []

for char in source:
    # 可以在此处插入复杂的验证、日志记录或条件跳转
    result.append(char)

print(result)
虽然代码行数比 list() 多,且由于在 Python 字节码层反复触发列表动态扩容和方法查找,其运行速度相对较慢,但在需要调试排查异常字符或处理状态机时,这种写法具有最高的灵活性。
关键差异分析与避坑指南
理解不同做法在一致条件下的关键差异及其对程序行为的影响,能帮助我们在实际开发中避免逻辑错误与性能陷阱。
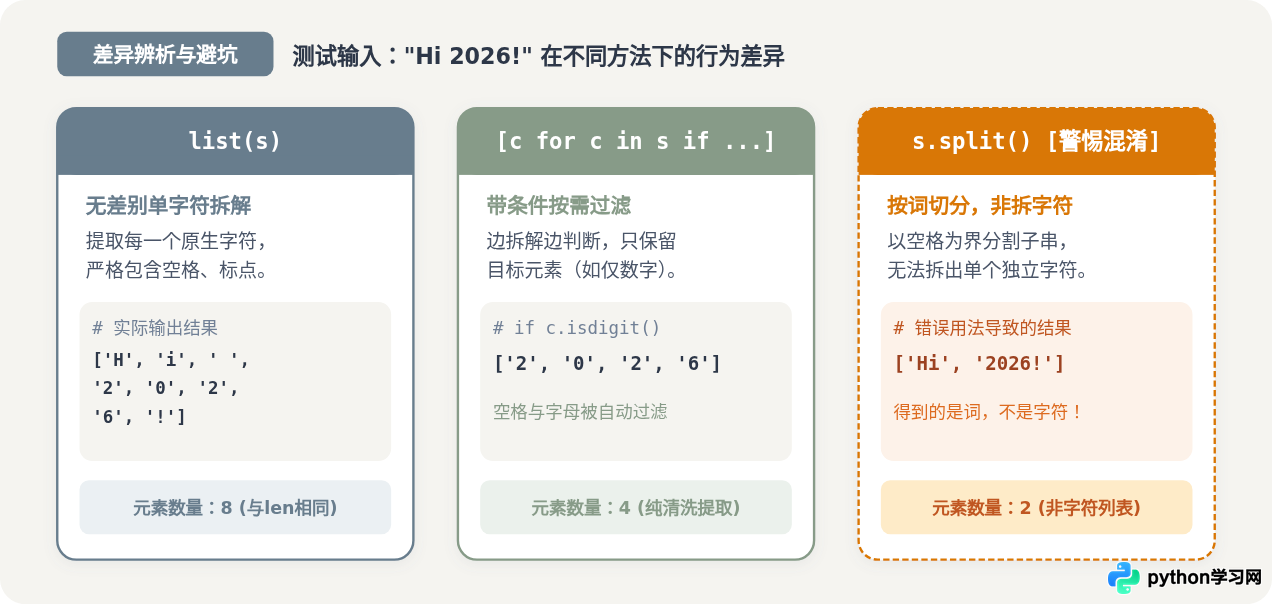
部分开发者在需要将字符串转为列表时习惯性地调用 s.split()。需要明确的是:split() 是根据指定分隔符(默认是任意连续空白字符)将字符串分割成“词(Word)”,它不会把连续单词内的字符拆开。
例如对 "cat" 执行 "cat".split(),得到的结果仍然是包含单个完整单词的 ['cat'],只有 list("cat") 才能得到 ['c', 'a', 't']。
list() 与列表推导式的特性对比
| 对比维度 | 内置函数 list(s) | 列表推导式 [c for c in s] | 常规 for 循环 + append() |
|---|---|---|---|
| 核心用途 | 1:1 无损纯字符拆解 | 字符拆解 + 条件筛选 / 转换 | 多步骤逻辑 / 异常捕获 / 状态机 |
| 执行性能 | 最高(原生 C 循环优化) | 次之(字节码推导式优化) | 较慢(频繁函数调用与扩容) |
| 代码简洁度 | 仅需一个函数调用,极简 | 单行表达式,语义清晰 | 需要 3~4 行代码 |
| 适用场景 | 纯粹拆解字符、反转字符串等 | 清洗数据、去除特定标点符号 | 复杂调试与多条件控制流 |
特殊边界情况与处理技巧
1. 空字符串的处理
当传入空字符串 "" 时,list("") 不会抛出任何异常,而是安全地返回一个空列表 []。列表推导式 [c for c in ""] 同样返回 []。在编写防御性代码时无需特意编写非空前置判定。
2. 特殊空白符与转义符
像换行符
、制表符 在 Python 内部均被视为单个合法的 Unicode 字符。因此 list("a
b") 会返回 ['a', '
', 'b'],长度为 3。如果期望去除转义符,需使用列表推导式并结合 c.strip() 进行判断。
3. 逆向操作:将字符列表重新拼接为字符串
完成对字符列表的修改(如替换某个字符、排序或剔除元素)后,通常需要将其还原为字符串。Python 中最地道的逆向拼接方法是使用空字符串的 join() 方法:
chars = ['P', 'y', 't', 'h', 'o', 'n']

# 使用 join 方法将列表元素缝合为完整字符串
restored_str = "".join(chars)

print(restored_str)场景决策与总结速查
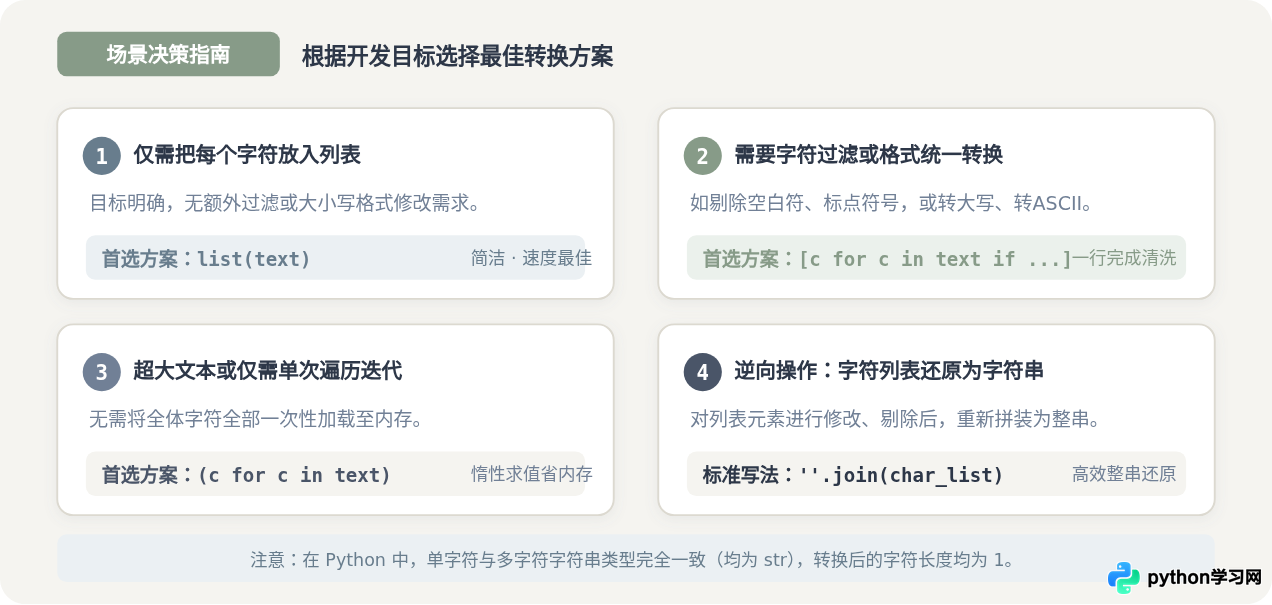
在实际开发中,根据任务需求选用最匹配的方法:
- 无条件全部拆分:毫不犹豫使用
list(s),这是最符合 Pythonic 哲学的写法。 - 清洗或转换字符:使用
[c for c in s if 条件],一步到位,代码紧凑。 - 超大文本或流式消费:使用生成器表达式
(c for c in s),无需占用整块列表内存,按需迭代。 - 多步异常处理或调试:使用传统的
for循环结构。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















