


照片直接转PDF和OCR转可编辑文档有什么区别
深入对比照片直接转PDF与OCR转可编辑文档的底层数据结构、处理流程、排版保真度与业务应用场景,帮助读者在合同归档、数据提取与知识管理中做出明智选择。
一、底层机制:数据存储与呈现方式的根本差异
在日常工作与学习中,很多用户使用手机拍照扫描后,经常混淆“生成PDF”与“文字识别”。直观上看,两者最终都呈现出白纸黑字的文档版面,但如果深入文件内部的数据流,会发现两者的存储模型截然不同。
1. 照片直接转PDF:给图片套上标准容器外壳
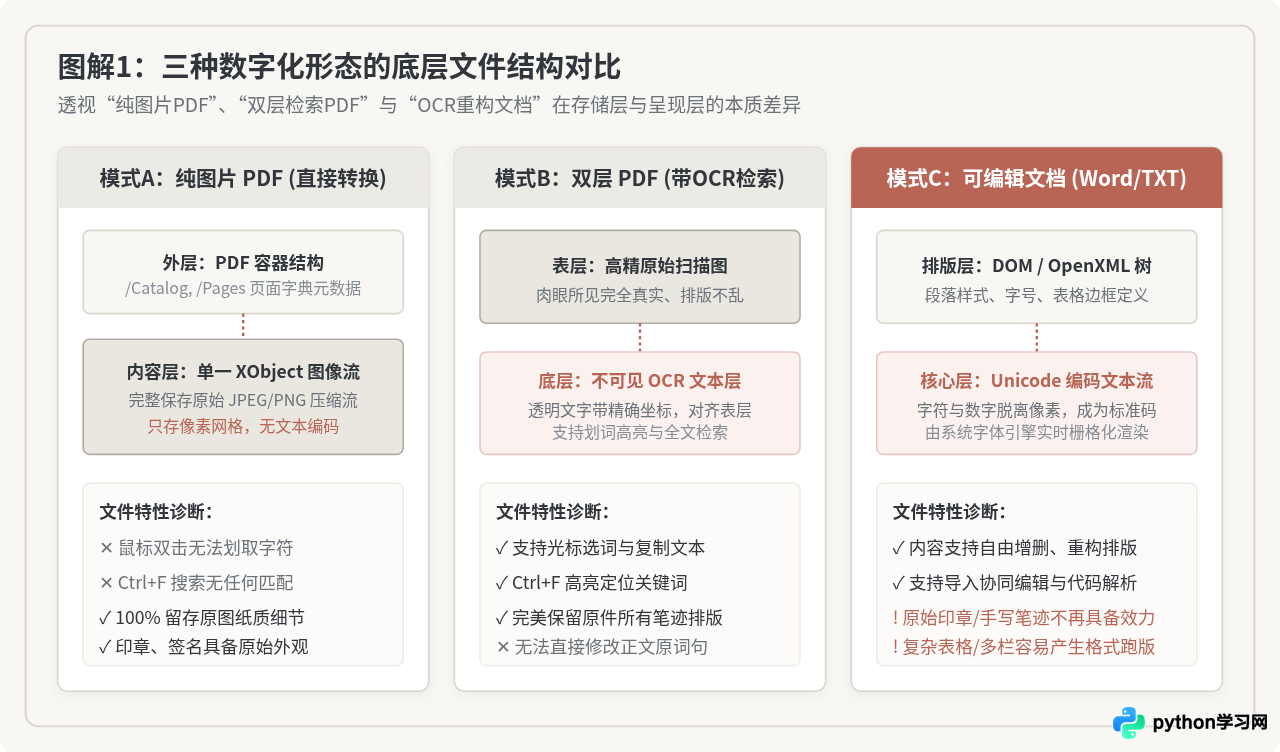
当把一张JPG或PNG照片直接保存为PDF时,转换程序执行的是格式层面的“封装(Packaging)”。在PDF底层规范中,软件创建了一个标准的页面描述字典(/Pages),并在页面坐标系内开辟一个矩形绘图区域,将输入的图片压缩流直接作为XObject(外部图像对象)嵌入文件流中。
在这个过程中,文件并没有读取任何字形含义。PDF阅读器渲染该文档时,所做的只是将图像数据解压并绘制为像素点阵。因此,即使用户在屏幕上能看清每一行字,计算机的文字选择光标也无法附着在任何字词上,按下快捷键 Ctrl+F 搜索也永远找不到任何内容。本质上,它仍然是一张照片,只是文件后缀改成了 .pdf。
2. OCR转可编辑文档:从视觉图形到字符编码的语义重构
OCR(Optical Character Recognition,光学字符识别)则完全不同。它不以保留原始像素为终点,而是将输入的图像切分成行、字与笔画,提取其外形拓扑特征,并送入模式识别模型进行推理匹配。当系统判断某个笔画组合匹配汉字“的区别”时,它输出的是该汉字在Unicode标准中的唯一字符编号(如 U+7684、U+533A、U+522B)。
当这些字符序列被写入Word(DOCX)或纯文本(TXT)时,文件记录的是字符流、段落样式标签、字体映射及表格DOM树。阅读器或文字处理软件读取的是字符代码,并调用本地操作系统的字体库实时矢量化渲染。正因如此,文字能够被自由删除、添加、替换,甚至改变字号和颜色。
3. 介于两者之间的特殊形态:双层可检索PDF(Sandwich PDF)
很多企事业单位在电子档案管理中,既需要保留原始纸质发票、公章签名的真实扫描外观,又要求能够在海量文档库中检索合同条款,这时便诞生了“双层PDF”。
双层PDF的巧妙之处在于它融合了两种模式:在可视的顶层,完整展示原始高清晰度扫描照片;而在不可见的底层,则利用OCR算法提取出文字,并将这些文字设置为100%透明,精准对齐在顶层对应字迹的坐标下方。这样,用户肉眼看到的是原汁原味的原始纸张细节,而鼠标划选、复制或搜索时,拾取的则是底层的隐形字符层。
二、处理流程:操作步骤与算法执行管线对比
两种技术方案在计算资源消耗、处理耗时以及操作容错度上存在天壤之别。了解各自的执行链路,有助于理解为什么OCR往往比直接转PDF耗时更长、对图片质量更敏感。
1. 照片直接转PDF的处理流:毫秒级的流封装
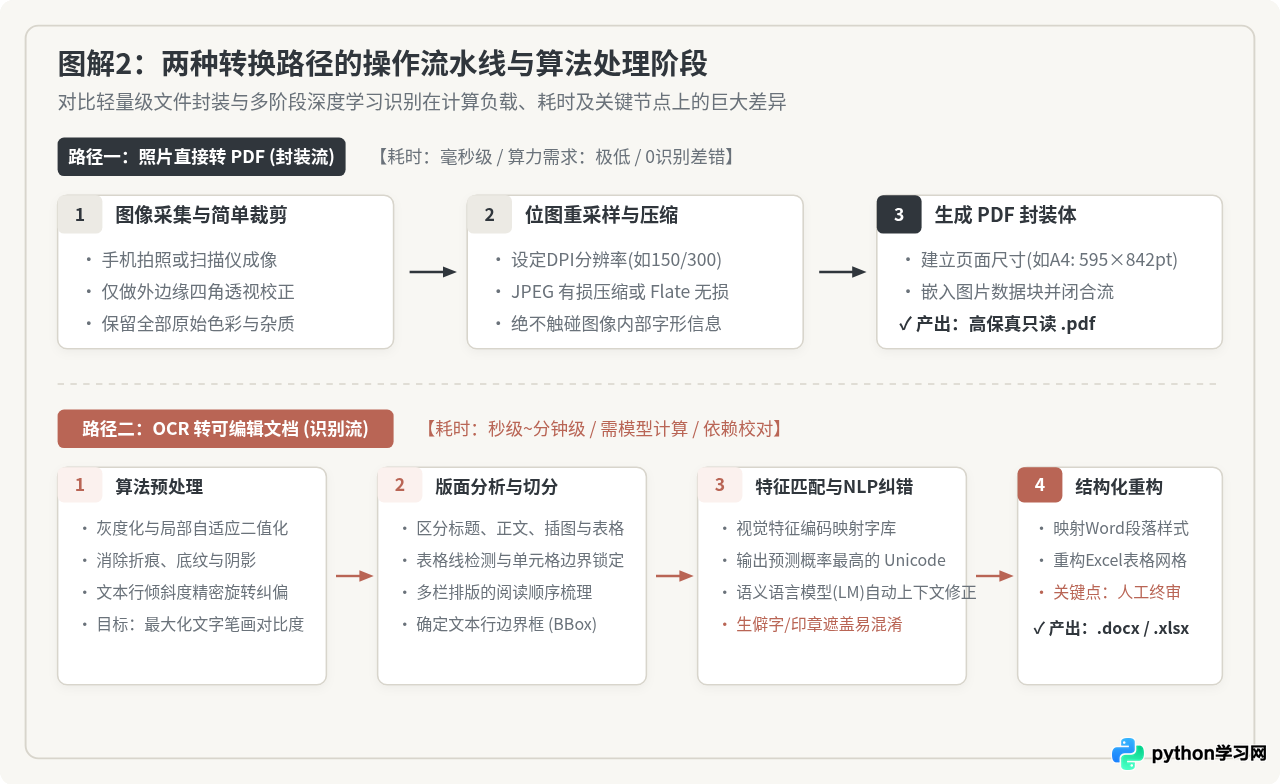
直接转PDF的流水线极为精简,几乎不消耗多余算力:
- 图像获取与几何裁剪:由用户手动或手机系统自动探测纸张边缘,进行简单的四点透视纠偏,将不规则拍照画面拉平为矩形。
- 色彩与压缩配置:根据目标文件大小,选择JPEG有损压缩比或Flate无损压缩,将像素重采样为指定DPI(如文档通常采用的150或300 DPI)。
- 写入PDF包装体:按照PDF 1.4~1.7规范生成文件头(Header)、对象目录(Cross-Reference Table)及页面流,直接将压缩好的图像流写入。整套过程在现代手机或电脑上均在百毫秒内完成,且完全不需要联网或加载大模型。
2. OCR转可编辑文档的处理流:复杂的多阶段智能流水线
将照片转换为真正的Word或Excel文档,必须历经严密的机器视觉与自然语言处理步骤:
- 图像增强与预处理:算法先对彩色照片进行灰度化与局部自适应二值化处理,消除纸张折痕、背后透光墨迹及拍摄阴影;随后利用霍夫变换或投影法检测文字行倾斜角并旋转水平。
- 版面分析(Layout Analysis):这是确保排版不混乱的关键一步。算法需要将页面分割为标题区、正文多栏、独立插图、印章区域以及复杂的表格网格,理清跨列分栏的阅读顺序。
- 字形识别与NLP纠偏:利用深度卷积神经网络或Vision Transformer模型对行内字符进行特征提取,输出概率最大的Unicode字符。随后配合语言模型(Language Model)通过上下文词频自动修正同音或形近错字(例如纠正“己”、“已”、“巳”的混淆)。
- 排版反向重构与人工校对:将识别出的文字重新编排进DOCX的样式系统,或者把框线识别为Excel单元格。由于手写体、复杂数学公式或生僻字极易出现识别错误,人工校验(Proofreading)是OCR流程中不可或缺的最终闭环。
三、核心维度横向评测:关键能力与适用特征
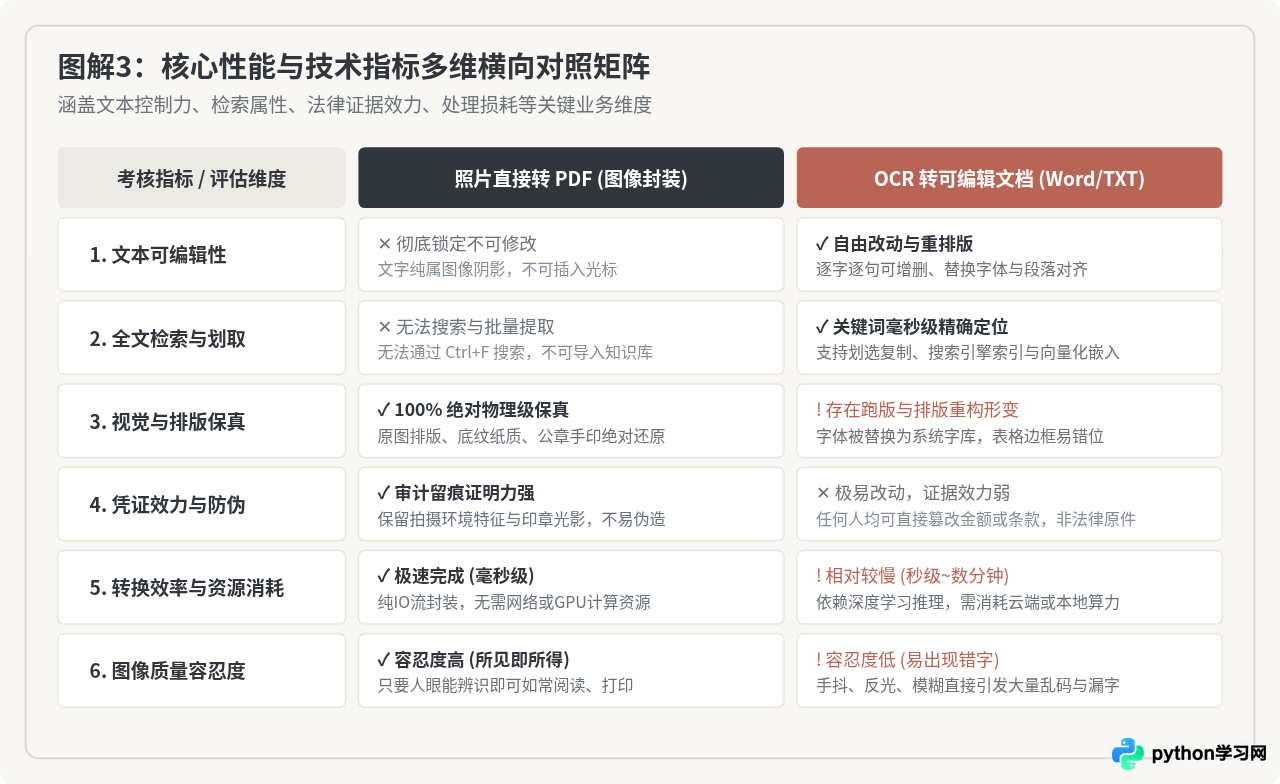
为了让读者在实际工作中能够一目了然地做出选择,我们将两者的关键指标归纳为以下六个维度:
| 对比维度 | 照片直接转 PDF | OCR 转可编辑文档 |
|---|---|---|
| 文字可编辑性 | ✕ 完全不可编辑(位图锁定,改动需涂抹修图) | ✓ 自由增删修改(与正常输入的文本无异) |
| 全文检索与复制 | ✕ 无法搜索与复制(无法划取词句,搜索引擎无法读取) | ✓ 支持全文秒级定位(支持Ctrl+F及接入AI向量知识库) |
| 原始排版保真度 | ✓ 100% 绝对物理保真(照片原貌保留,印章底纹丝毫不差) | ! 排版易错位跑版(字体被系统替代,分栏易串行) |
| 法律凭证效力 | ✓ 具备原始凭证证明力(保留真实拍摄细节与印章光影) | ✕ 易被篡改,证明力低(字符被重写,无法单独作原件证据) |
| 转换耗时与性能 | ✓ 极速完成(毫秒级)(本地轻量I/O操作,零算力压力) | ! 耗时较长(秒级~分钟级)(依赖算法推理,资源开销大) |
| 图片质量容忍度 | ✓ 容忍度高(只要人眼能够看清,即可作为文档归档) | ! 容忍度极低(模糊、倾斜、反光会导致大面积识别乱码) |
许多用户误以为“把纸质合同转成Word修改保存”比“直接存PDF”更好,但在法律与审计场景下这是极大的误区。Word文档本身是开放的可编辑文件,其时间戳与文字都可以随意篡改,无法在法庭或审计调查中作为有效原件依据。涉及双方签字盖章的纸质合同、税务发票、司法传票等,必须优先选择直接转PDF(或双层PDF)进行原件图像留存。
四、场景决策指南:何时直接转PDF,何时选择OCR?
面对具体的工作与生活任务,读者无需纠结于哪种技术“更先进”,而应根据最终的业务用途倒推最合适的处理路径。
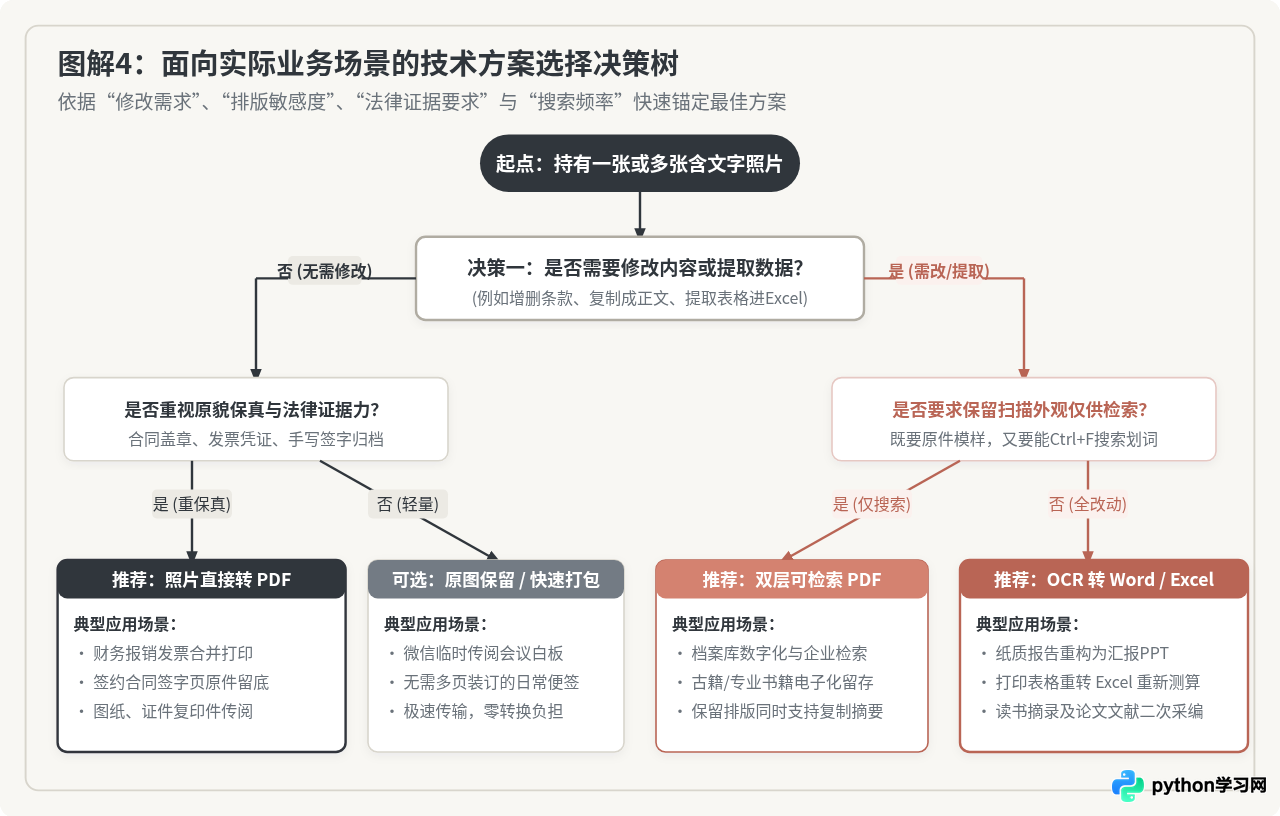
1. 适合选择“照片直接转PDF”的典型场景
- 财务报销发票与收据汇总:需要把分散拍摄的增值税发票、出租车票合并为一份多页PDF提交财务系统,此时财务只关心发票真实印章与代码是否清晰可辨。
- 签署合同与协议归档:客户或供应商签字盖章后的原件扫描件,仅需封存备份、发送对方留底或作为附件上传OA系统。
- 设计图纸、工程蓝图与手绘草图:包含大量非文本几何线条、矢量符号或艺术笔触的内容,任何OCR算法都无法有效识别,直接打包PDF是唯一可靠方案。
- 现场取证与证件复印件:身份证、营业执照、房产证的翻拍件,作为业务办理的资格审查材料。
2. 必须采用“OCR转可编辑文档”的典型场景
- 书籍摘抄与论文文献引用:阅读实体书或纸质期刊时,拍摄精彩段落并转换为纯文本,直接粘贴入论文、读书笔记或知识库。
- 纸质表格重算与数据录入:拿到打印的财务对账单、销售统计表,需要将表格还原为可进行公式计算的Excel(.xlsx)工作表。
- 老旧文档翻印与二次重构:原先的电子源文件已丢失,手头只有一份早期打印稿,需要在此基础上增删条款、修改公司名称并重新排版打印。
- 多语言文档即时翻译:拍摄外文说明书或合同,需提取文字送入机翻引擎生成译文对照。
3. 优先选择“双层可检索PDF”的最佳实践
如果所在机构正在推进数字化办公,例如建立企业级档案库、客户诉讼卷宗管理或大型招投标文档归集,强烈建议使用带有“双层PDF(Searchable PDF)”输出功能的专业扫描仪或软件。这样既满足了法律风控对原始真实凭证的严苛要求,又能让员工在成千上万页的文档中实现精准的全文关键词检索。
五、常见认知误区与排错建议
现象:不少用户在手机端使用某些“扫描大师”类软件导出PDF后,发现用电脑打开依然无法划选文字或按 Ctrl+F 搜索。
原因:这类软件在默认设置下通常仅执行“图像拼接与PDF封装”(即本文介绍的第一种模式)。要获得可搜索的PDF,必须在导出选项中明确勾选“生成可搜索PDF(Searchable PDF)”或“开启文本识别”开关。如果未勾选,导出的依然是纯图像PDF。
OCR识别效果具有极强的“输入决定输出(Garbage in, garbage out)”特征。在拍摄需要OCR处理的照片时,应注意以下要点:
- 避免斜拍与透视形变:尽量垂直正上方俯拍,使页面与镜头平面平行,减少字符梯形畸变。
- 避免单一侧向强光源:侧光容易使纸张折痕产生深色阴影,导致算法误将折痕识别为连笔或标点符号;尽量采用均匀散射光。
- 保证充足的有效像素:拍摄文本时,单字的高度在图像中建议不低于30个像素点,避免放大后字迹边缘模糊粘连。
六、总结
总结而言,照片直接转PDF解决的是“装订与保真”的问题,它以最高的速度、最低的算力消耗,把多张图片规范化为适合打印与长期归档的标准化文件,完好保留原件的法律证据效力;而OCR转可编辑文档解决的是“复用与加工”的问题,它通过计算机视觉技术打破位图像素的禁锢,将文字释放为可计算、可搜索、可重排的自由数据。
在日常工作流中,先确认你对该文件的最终诉求是“查阅留底”还是“二次修改”,便能在两者之间迅速做出精准而高效的选择。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















