


想从事Python开发?不同职业方向的技能树重点解析
针对想从事Python开发的求职者与转行人员,深度拆解Web后端、数据分析、机器学习工程与自动化运维测试四大主流方向的技能树重点、核心技术栈、决策逻辑与学习避坑指南。
从事Python开发并不是掌握语法后就能直接投递所有岗位,因为不同岗位对知识结构、工具生态以及工程能力的要求差异极大。本文直接梳理Python开发领域中四个最为成熟的主流职业方向——Web后端开发、数据分析与商业智能、人工智能与机器学习工程以及自动化运维与测试开发,系统拆解每个方向的核心技能树、工程痛点、技术选型以及差异化决策路径,帮助你在起步阶段聚焦关键能力,建立符合产业实际的技术壁垒。
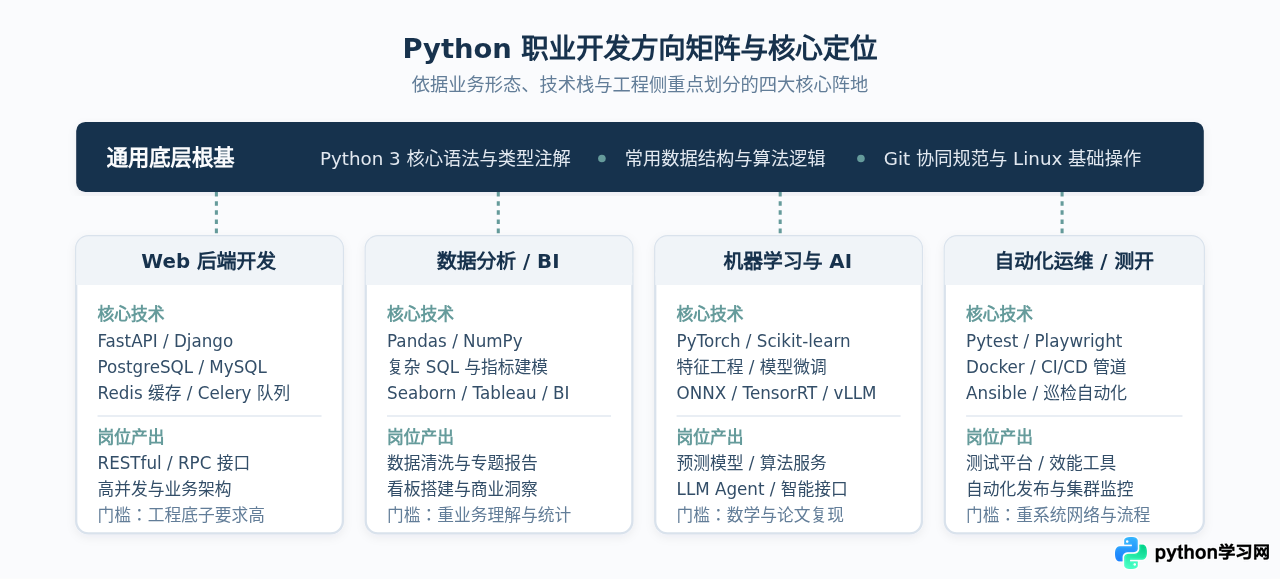
一、Python 开发者的通用根基:不可逾越的底层素养
无论你未来选择进入哪个细分方向,Python 本身的语言底座都是决定后续代码质量与排查深度的关键。部分初学者容易误以为“会用框架就是会 Python”,直接跳过语言特性去生搬硬套库函数,结果在遇到并发死锁、内存泄露或异步阻塞时束手无策。
进入任何具体方向之前,必须扎实掌握以下共性知识点:
- 对象模型与可变性机制:深刻理解 Python 中“一切皆对象”的概念,清楚深拷贝与浅拷贝的差异,明确列表、字典等可变对象作为函数默认参数时容易引发的状态污染。
- 迭代器、生成器与上下文管理器:掌握
yield关键字与生成器表达式,理解惰性求值在降低内存占用上的决定性作用;熟练使用with语句管理资源,并能通过__enter__与__exit__编写自定义上下文管理器。 - 函数式特性与闭包装饰器:透彻掌握一等公民函数、高阶函数、闭包以及带参数的装饰器。装饰器在权限校验、日志记录、耗时度量等工程场景中随处可见。
- 虚拟环境与依赖管理:弃用系统全局
pip install,熟练掌握venv、uv或Poetry隔离项目环境,并理解pyproject.toml与锁定文件的工作原理。 - 系统调用与版本控制:具备在 Linux 终端中进行文件排查、环境变量配置与进程管理的基础技能,掌握 Git 分支开发与合并流程。
二、Web 后端开发:重构与高可用架构为核心
Python 在 Web 领域的优势在于极高的开发迭代效率以及丰富的微服务支持。然而,企业级 Web 后端岗位考察的远不止写几个路由函数返回 JSON,而是围绕网络协议、数据持久化性能、异步非阻塞 IO 以及系统可观测性构建的完整工程体系。
1. 核心框架生态与选型逻辑
目前业界主要分为两大阵营:以 FastAPI 为代表的现代异步生态,以及以 Django 为代表的全功能成熟生态。
- FastAPI / Starlette:基于 Python 类型注解与
asyncio构建,原生集成 Pydantic 进行严格的数据验证与序列化,性能优越且自动化生成 OpenAPI 规范文档。在新兴中台服务、AI 算法 API 封装以及轻量微服务中占据绝对主流。 - Django / DRF (Django REST Framework):包含开箱即用的 Admin 后台、身份认证系统与强内聚的 ORM。适合业务模型复杂、需要快速交付完整后台与企业级业务逻辑的项目。
2. 数据层与分布式组件重点
后端开发的重头戏在数据流与状态存储。核心技术包括:
- 关系型数据库深度优化:熟悉 PostgreSQL 或 MySQL 的索引原理(B+ 树、联合索引最左匹配原则)、事务隔离级别以及死锁排查。掌握通过
EXPLAIN ANALYZE诊断慢查询。 - ORM 及其性能陷阱:熟练使用 SQLAlchemy 2.0 或 Django ORM,但重点在于识别并解决典型的
N+1查询问题,掌握预加载(select_related/joinedload)与批量更新操作。 - 缓存与限流:熟练使用 Redis 实现分布式锁、热点缓存击穿防护、令牌桶限流与会话管理。
- 异步任务队列:使用 Celery 或 RQ 处理耗时的邮件发送、PDF 生成、第三方系统同步等任务,了解 Broker(RabbitMQ/Redis)与 Worker 之间的消息投递与重试机制。
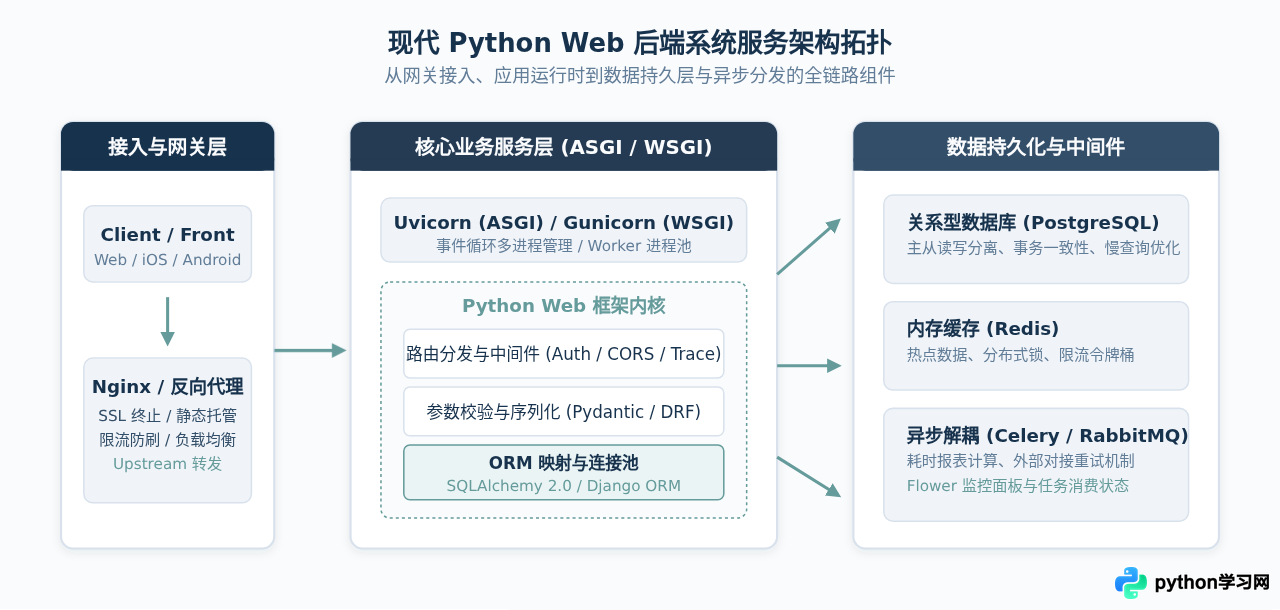
在使用 FastAPI 编写 async def 路由时,如果内部调用了未经线程池包装的阻塞库(如旧版 requests.get() 或同步数据库查询),会导致当前 Worker 线程的主事件循环被完全卡死,并发吞吐量剧降。处理阻塞代码必须使用 run_in_threadpool 或直接改用 httpx.AsyncClient 与异步数据库驱动(如 asyncpg)。
三、数据分析与商业智能:从清洗到决策支撑
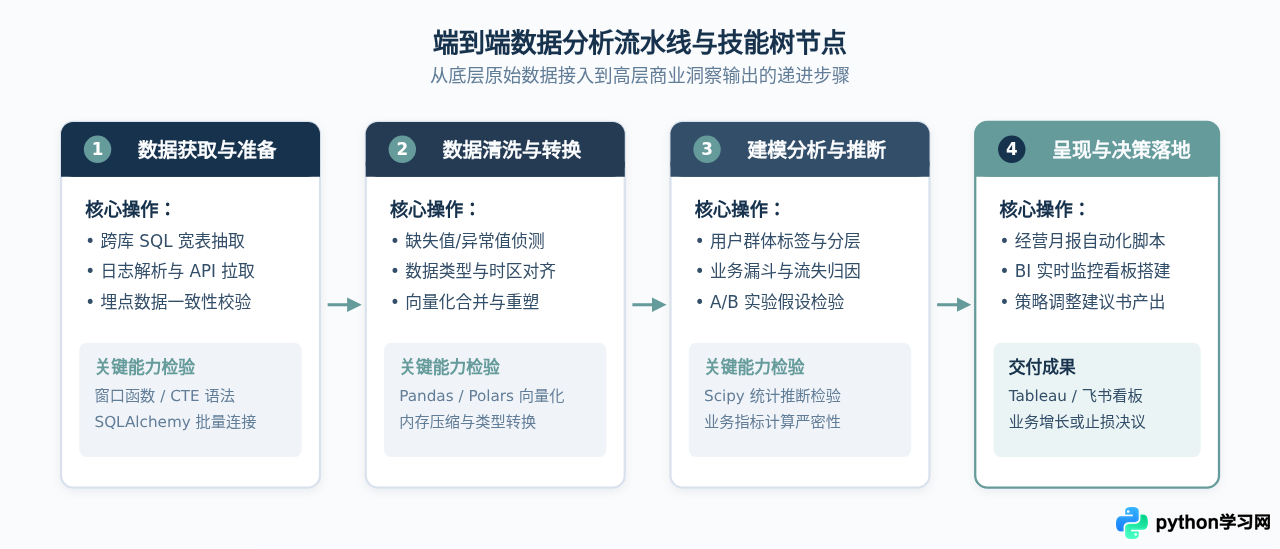
数据分析方向的本质不是编写代码架构,而是通过数据发掘业务事实、诊断异常并支撑经营决策。很多转行者花费数月背诵复杂的统计学公式,却写不出一句高效的 SQL 聚合查询,这在求职时极易碰壁。在绝大部分业务型企业中,SQL 与 Pandas 结合业务场景的综合运用占据了日常工作的 80%。
1. 核心技术组件链条
- 数据提取与 SQL 功底:不仅是简单的
SELECT * FROM,必须深入掌握窗口函数(ROW_NUMBER()、LEAD()/LAG()、RANK())、公用表表达式(CTE)、留存率计算模型与复杂多表 JOIN。 - Pandas / Polars 向量化处理:熟练运用
groupby、透视表pivot_table与多层索引(MultiIndex),掌握时间序列处理(重采样、滑窗统计)。能够利用向量化计算替代低效的for循环或iterrows()。 - 数据可视化与洞察呈现:使用 Seaborn 或 Plotly 绘制分布图、箱线图与热力图,重点在于根据数据类型选择正确的图表形式,避免过度修饰而破坏可读性。
- 指标体系搭建与归因分析:掌握漏斗分析模型、A/B 测试指标显著性检验、杜邦分析法与异常波动归因思路。
四、人工智能与机器学习:工程化落地的分水岭
机器学习与人工智能方向目前正经历深刻的分工重构。过去单纯在 Jupyter Notebook 中调包调参(如 model.fit())的“算法调包侠”已基本失去求职竞争力。当前工业界最紧缺的是懂数学原理、具备模型微调能力,同时精通工程化部署与推理加速的 MLOps 工程师。
1. 理论根基与经典算法
- 数学基础:线性代数(矩阵分解、奇异值、特征向量)、多变量微积分(梯度下降与偏导链式法则)、概率论与数理统计(最大似然估计、贝叶斯定理、假设检验)。
- 传统机器学习:熟练掌握 Scikit-learn 中的逻辑回归、SVM、随机森林、XGBoost 与 LightGBM。传统树模型在结构化表格数据预测、金融风控与营销反欺诈场景中仍是主力。
2. 深度学习与大模型工程(LLMOps)
- PyTorch 生态:熟练运用张量操作、自动求导机制、自定义
Dataset与DataLoader,以及多 GPU 分布式训练(DDP)。 - 大语言模型工程落地:掌握基于 Hugging Face Transformers 的模型加载,熟悉 LoRA / QLoRA 参数高效微调,熟练使用 LangChain 或 LlamaIndex 构建企业级检索增强生成(RAG)管道。
- 推理加速与服务化:掌握模型量化(AWQ、GPTQ)、ONNX 转换、vLLM 高并发推理引擎部署,能够通过 Triton Inference Server 或 FastAPI 输出高性能低延迟服务。
五、自动化运维与测试开发:研发效能的守护者
测试开发(SDET)与自动化运维(SRE/DevOps)是 Python 另一项底蕴深厚的就业阵地。这类岗位的核心价值不是简单执行黑盒点击,而是利用 Python 开发工具、平台与流水线,降低整个研发团队的交付成本与故障率。
1. 测试开发的核心技能
- 单元与接口测试:精通
pytest框架,深度使用fixture实现测试夹具管理、数据驱动测试(parametrize)以及 Mock 依赖隔离。 - 端到端自动化:熟练运用 Playwright 或 Selenium 编写稳定的 UI 自动化脚本,处理等待机制、反爬侦测与多标签页通信;使用 Appium 进行移动端自动化。
- 自研测试效能平台:掌握基于 Vue + Django/FastAPI 自研测试用例管理平台、造数工具与自动化压测系统(Locust)。
2. 自动化运维与 SRE 技能
- 基础设施即代码与配置管理:熟练编写 Ansible Playbook,利用 Python SDK 操作云平台(阿里云、腾讯云、AWS)资源。
- 容器与编排:编写 Dockerfile 镜像构建最佳实践,调用 Kubernetes Python Client 进行自动化扩缩容与集群巡检。
- 监控与告警闭环:解析 Prometheus 指标,结合 Python 脚本编写异常指标探测、日志清洗过滤与企业微信/飞书告警自动派单。
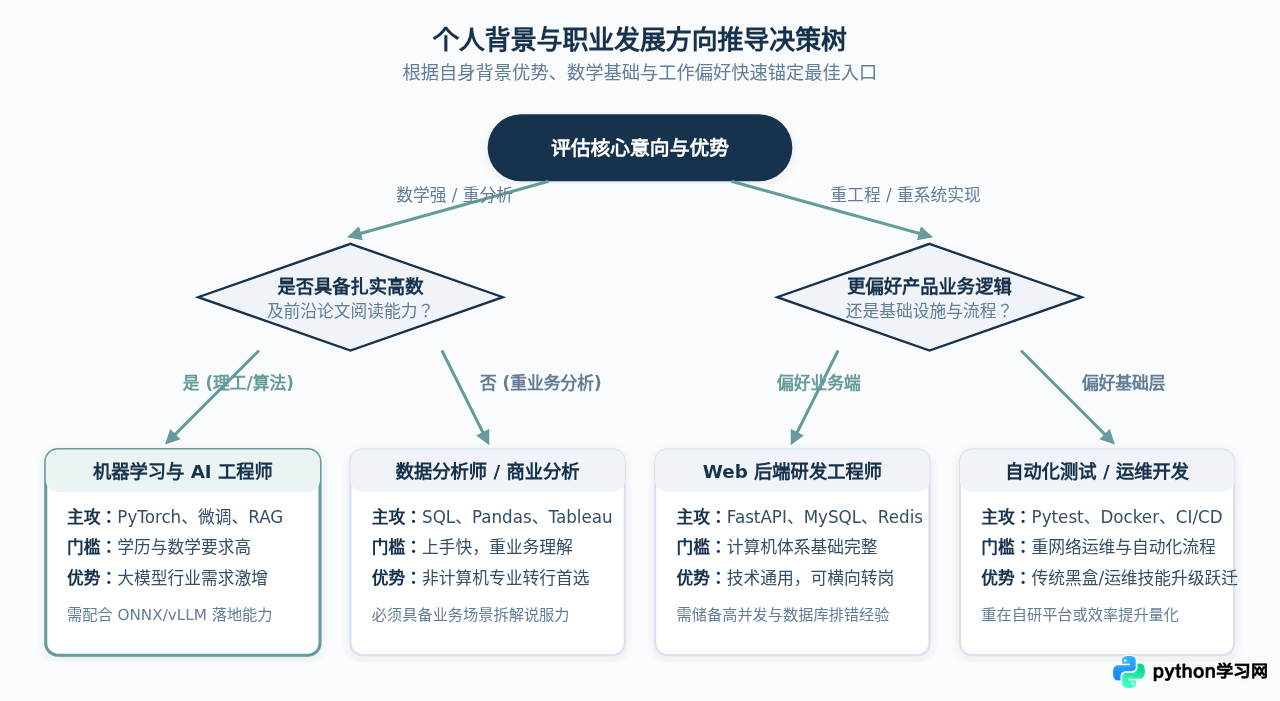
六、四大方向核心维度对比与选择依据
为了给面临方向抉择的读者提供清晰客观的参考,我们将四大方向在学习成本、数学门槛、业务理解以及核心产出形式等关键维度进行横向归纳:
| 职业方向 | 学习启动门槛 | 数学与统计要求 | 代码与架构深度 | 典型日常产出 |
|---|---|---|---|---|
| Web 后端开发 | 中等(需补齐网络/系统基础) | 低(重逻辑思维与数据结构) | 极高(高并发、事务、异步) | RESTful API、数据持久层、中台服务 |
| 数据分析 / BI | 较低(语法与工具链相对平缓) | 中等(熟练掌握描述与推断统计) | 中等(重数据清洗与分析脚本) | 分析看板、业务诊断报告、决策建议 |
| 机器学习 / AI | 极高(理论推导与工程落地兼备) | 极高(线性代数/概率论/微积分) | 高(模型推理加速与服务化) | 预测算法服务、微调模型、智能 Agent |
| 自动化测开 / 运维 | 中等(重在工程环境与测试理论) | 低(侧重系统稳定性与流程设计) | 中高(测试平台开发、运维脚本) | 自动化测试用例、CI/CD 管道、运维平台 |
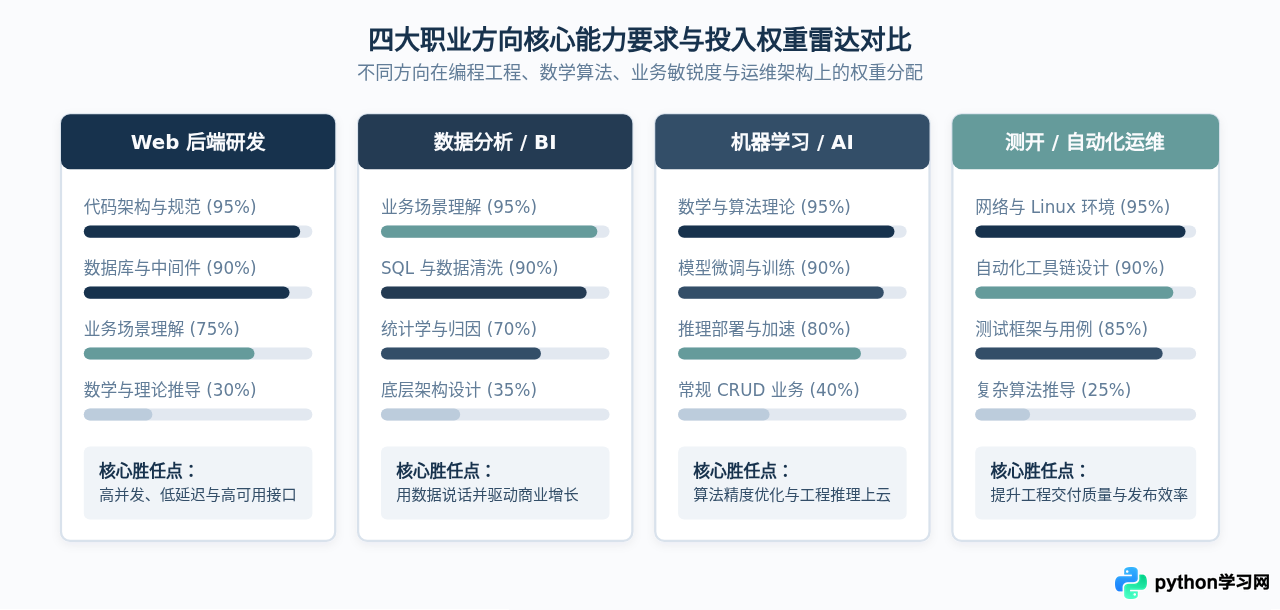
七、进阶实操中的核心误区与避坑建议
在向目标方向冲刺的实际过程中,学习者往往会踩入几个极具普遍性的陷阱。提前识别这些误区能够极大节省时间:
- 长期停留在“教程地狱”(Tutorial Hell):跟着视频一行一行抄写代码会让人产生已经掌握的错觉。一旦离开教程独立建仓,就不知道如何配置
logging、如何设计数据表外键、如何组织项目的配置隔离。验证自身是否掌握的标准只有一个:能否从零创建空文件夹并独立完成一个具备基本健全性的完整功能模块。 - 忽视计算机底层网络与系统:把 Python 当作纯粹的高级语法糖,忽略 TCP 三次握手、HTTP 状态码语义、Linux 权限控制(如
chmod/chown)以及进程间通信基础。任何生产级别的排错,最终都会回到操作系统与网络层面。 - 盲目堆砌第三方库而不深究实现原理:遇到需求就装一个第三方库,却不知道库内部是如何处理连接池、是否有内存泄露隐患、是否为线程安全。在生产环境中,引入依赖应当极其审慎,精通少量核心库的底层逻辑远好于浅尝辄止地把玩几十个周边包。
- 项目作品千篇一律缺乏生产信服力:简历中的实战项目切忌充斥着泛滥的“图书管理系统”、“电商后台模板”或“波士顿房价预测”。有说服力的作品应该体现实战细节:例如包含了数据库查询优化对比、包含了详细的
pytest单元测试覆盖率报告、部署在 Docker 容器中且通过 CI/CD 自动发布并附带监控面板截图。
八、结语:找到属于你的单点突破口
Python 是一把多用途工具,但职业发展的价值取决于你将这把工具用在什么深度的问题上。对于初学者或转行人员而言,最忌讳的是“什么方向都学一点,但没有一个方向能达到企业生产标准”。更明智的策略是:守住 Python 核心底座与代码规范,选准一个与自身既有背景或兴趣高度契合的单点方向进行深度攻坚,待形成完整的项目产出与知识闭环后,再逐步横向扩展工程边界。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















