


怎么优化Dify智能体的知识库检索准确率

针对Dify智能体在知识库检索中常见的漏召回、跑偏及幻觉问题,系统讲解文档预处理分段、向量与全文混合检索、Rerank重排序打分及Query前置重写的端到端调优方法。
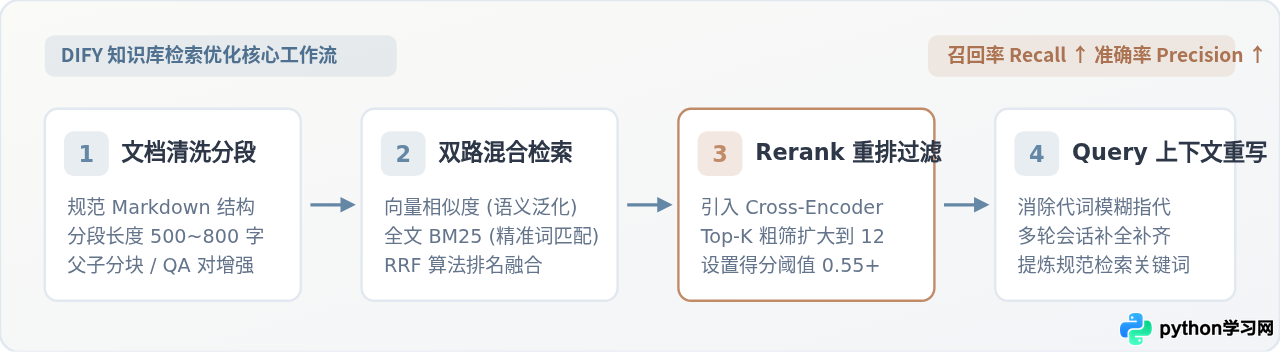
一、源头优化:文档清洗与分段粒度控制
在检索增强生成(RAG)系统中,数据切分的质量直接决定了检索精度的上限。如果切分出来的文本块本身语意支离破碎,后续无论使用多么强大的 Embedding 模型或 Rerank 模型,都无法恢复被切断的事实关系。
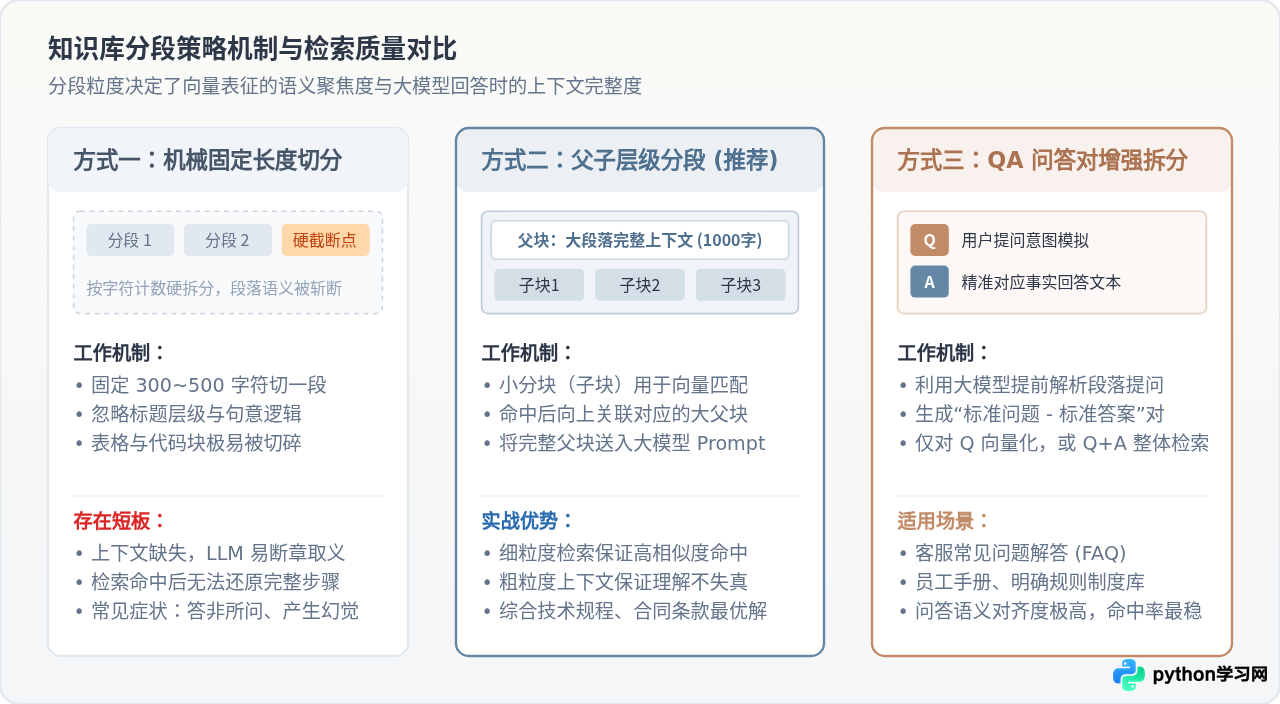
1. 告别机械定长切分:设置合理的 Chunk Size 与 Overlap
Dify 提供了“自动分段与清洗”与“自定义分段”两种模式。在默认的自动模式下,系统常按固定的 500 字符进行机械切分。这种切分容易在句子中间甚至专有名词内部发生硬截断,导致语义丢失。
- 分段最大长度(Chunk Size):建议调整为 500 ~ 800 字符。若字符过少(如 100~200 字),向量表征虽然聚焦,但送入大模型时缺乏上下文支撑;若字符过长(如超过 1200 字),语义被稀释,检索相似度打分容易偏低。
- 分段重叠长度(Overlap):建议保持在分段长度的 10% ~ 15%(通常为 50 ~ 100 字符)。重叠区域能有效保障跨切分点前后的专有名词、转折连词和主宾语关系不被物理截断。
- 标识符切分优先:充分利用 Markdown 格式,以二级标题(
##)或段落换行符(
2. 引入进阶切分:父子层级分段与 QA 问答拆分
针对复杂业务文档(如技术手册、制度文件、产品规格书),推荐采用结构化程度更高的分段模式:
父子层级分段(Parent-Child Retrieval):这是兼顾“检索精度”与“生成完整度”的最佳架构。系统在底层将文本拆分为细粒度的“子块”(例如 200 字符)用于计算向量与检索命中,而在命中文档后,向上提取其归属的“父块”(例如 1000 字符的大段落)注入大语言模型的 Prompt 中。这样既能保证高精度的局部匹配,又不会丢失宏观背景。
QA 问答对拆分:对于售后支持、员工手册等高频咨询类内容,在 Dify 知识库导入时选择“Q&A 分段模式”。系统会利用大模型将原始文档提炼为一条条“标准问题 - 标准解答”的数据对。由于用户在聊天时的提问句式通常是疑问句,将 Query 与向量化的问题(Q)进行匹配,其相似度远高于与陈述式长文的匹配度。
二、检索模式升级:从单一向量到多路混合检索
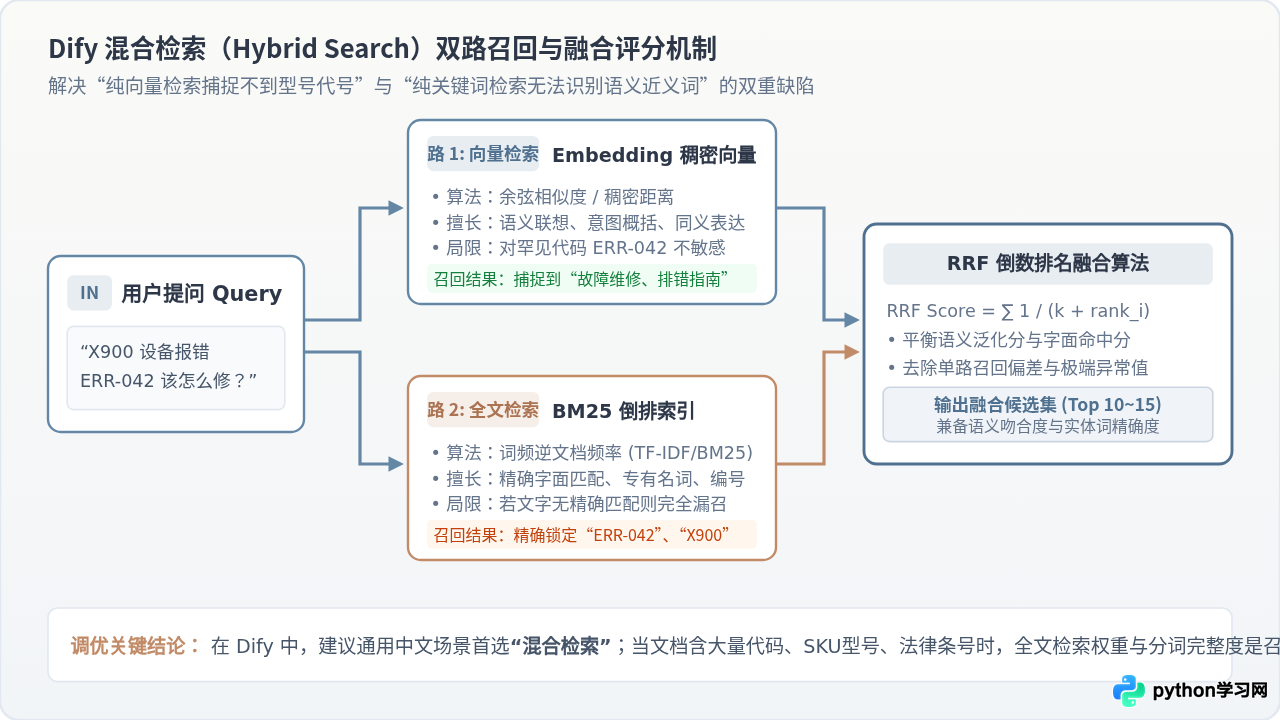
很多用户在搭建 Dify 应用时习惯直接选用“向量检索(Vector Search)”。然而,向量检索基于语义嵌入空间中的余弦距离,其优势在于理解自然语言的泛化含义(如理解“如何退货”与“怎样申请退款”属于同一意图),但其最致命的盲区在于对专有名词、生僻型号、报错代码、SKU 编号几乎没有精确字面判别力。
1. 向量检索与全文检索的互补逻辑
当用户提问:“设备出现 ERR-042 错误怎么排查?”单一向量模型很可能会召回包含“设备出现严重系统故障排查”的段落,而把真正写有“ERR-042”的操作手册排在后面,因为高维嵌入空间中罕见字符的语义向量权重极其发散。
为了解决该问题,必须在 Dify 中启用混合检索(Hybrid Search)。混合检索结合了:
- 稠密向量检索(Vector Search):捕捉意图泛化、同义词匹配与长句语义关联;
- 稀疏全文检索(Full-Text / BM25):基于倒排索引计算词频逆文档频率,精准锁定专有词汇、英数型号与精确字符。
2. 融合打分策略:RRF 与权重调配
在 Dify 的混合检索配置中,支持两种多路召回融合机制:
- 倒数排名融合(Reciprocal Rank Fusion, RRF):无需人工设置权重,系统根据各路检索的排序位置自动计算加权倒数和(公式为
Score = ∑ 1 / (60 + rank))。这种方式鲁棒性极强,不易受单一打分分值量纲差异的干扰,推荐作为默认选项。 - 自定义权重(Weighted Score):支持为向量检索与全文检索分别指定权重(如向量 0.7 + 全文 0.3)。如果文档中包含大量表格、商品货号或专业术语,可适当调高全文检索权重至 0.4 ~ 0.5。
三、引入重排序(Rerank)模型压制噪音
在 RAG 管道中,召回率(Recall)与准确率(Precision)往往存在权衡:为了不漏掉正确信息,我们通常希望初筛召回更多的分段;但召回的片段越多,掺杂的低相关度噪音就越多,容易误导大模型输出幻觉。
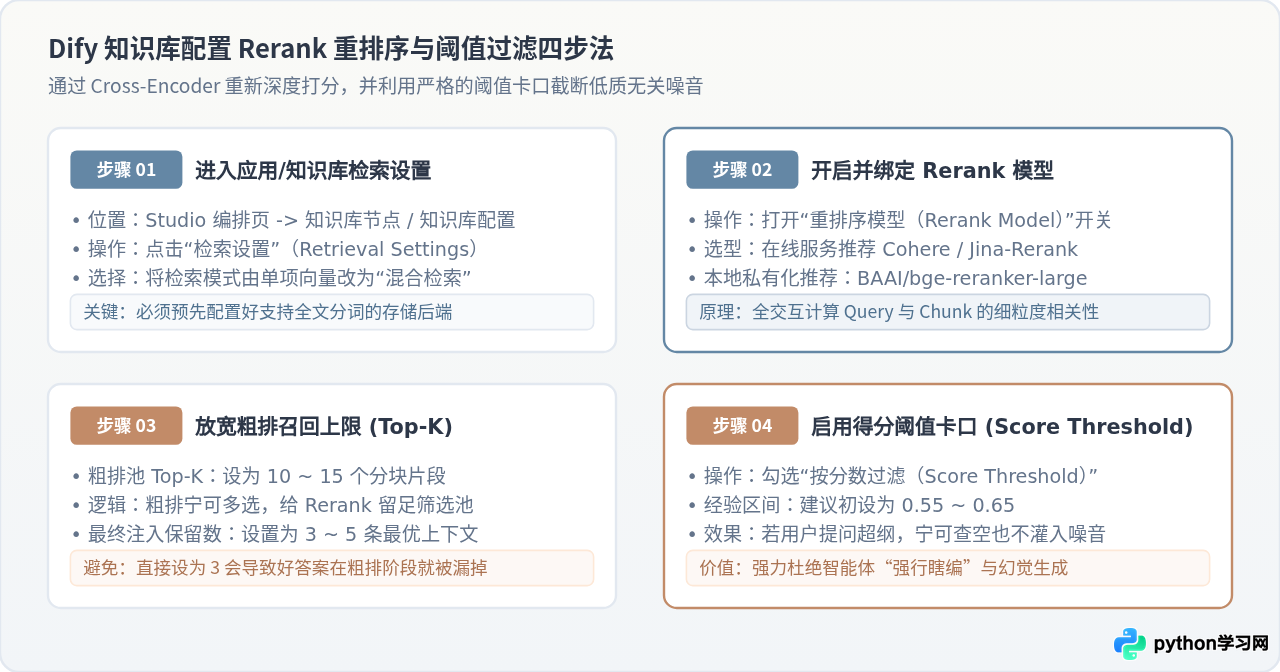
重排序(Rerank)模型是解决这一矛盾的决定性组件。Embedding 模型属于“双塔架构(Bi-Encoder)”,在检索前文档与问题是独立编码的,无法捕捉词与词之间的交互关系;而 Rerank 模型属于“交叉编码架构(Cross-Encoder)”,它将用户 Query 与候选 Chunk 拼接在一起同时输入,让注意力机制在全交互层面上逐字计算匹配度,打分精度显著高于普通向量相似度。
实战配置四步操作路径
- 进入检索设置:在 Dify 应用编排界面或知识库概览中,找到目标知识库的“检索设置(Retrieval Settings)”。
- 开启 Rerank 模型:将“重排序模型”开关置为开启状态。云端环境可选
Cohere Rerank v3或Jina Reranker v2;私有化本地部署推荐通过 Xinference 或 Ollama 接入BAAI/bge-reranker-large或bge-reranker-v2-m3。 - 扩大粗排 Top-K 候选池:在开启 Rerank 后,将初筛召回数量(Top-K)由常规的 3~5 条放大至 10 ~ 15 条。粗排的职责是“保证召回不遗漏”,留出足够的筛选空间。
- 设定保留数量与得分阈值(Score Threshold):
将最终注入大模型上下文的保留数量设为 3 ~ 5 条;同时务必勾选“得分阈值(Score Threshold)”,将分值卡口设在
0.55 ~ 0.65之间。低于该阈值的候选分段将被硬性剔除。
| 参数项 | 未优化默认值 | 推荐优化配置 | 配置价值与效果 |
|---|---|---|---|
| 检索模式 | 向量检索 (Vector) | 混合检索 (Hybrid) | 兼顾语义泛化与特定代码/型号精确匹配 |
| 重排序模型 | 未开启 | 启用 bge-reranker-large | 利用 Cross-Encoder 深度打分,彻底重排候选质量 |
| 初筛召回量 (Top-K) | 3 | 10 ~ 15 | 扩大粗筛覆盖范围,大幅减少有效信息漏召概率 |
| 最终保留片段数 | 3 | 3 ~ 5 | 控制上下文窗口有效荷载,避免长上下文衰减 |
| 得分阈值过滤 | 关闭 | 开启 (0.55 ~ 0.60) | 阻断超纲提问时的低分噪音,从根源压制模型幻觉 |
四、智能体前置处理:在工作流中加入 Query 重写
在智能体(Agent)的多轮人机交互中,很多检索失败并非发生在知识库内部,而是发生在用户的提问输入端。
1. 多轮会话中的“代词指代”与“语境脱节”
考虑以下真实会话场景:
如果在第二轮中直接把“那它对文件大小有什么限制?”送到知识库进行向量检索,检索系统无法得知“它”指的是“Dify 知识库导入文件”,召回的结果很可能是其他模块或通篇不相干的内容。
2. 在 Dify 工作流中配置“问题重写”节点
在 Dify Studio 中采用Chatflow / 工作流编排模式,在知识库检索节点之前插入一个轻量 LLM 节点(如 GPT-4o-mini 或 Claude-3.5-Haiku),专门执行 Query 改写任务。
示例节点系统提示词(Prompt):
经过该节点处理后,输入的“那它对文件大小有什么限制?”会被即时重写为:“Dify 知识库单个导入文件的大小上限与规格限制”。此时再传入知识库检索节点,召回准确率将产生质的提升。
五、检索效果自检与常见问题排查
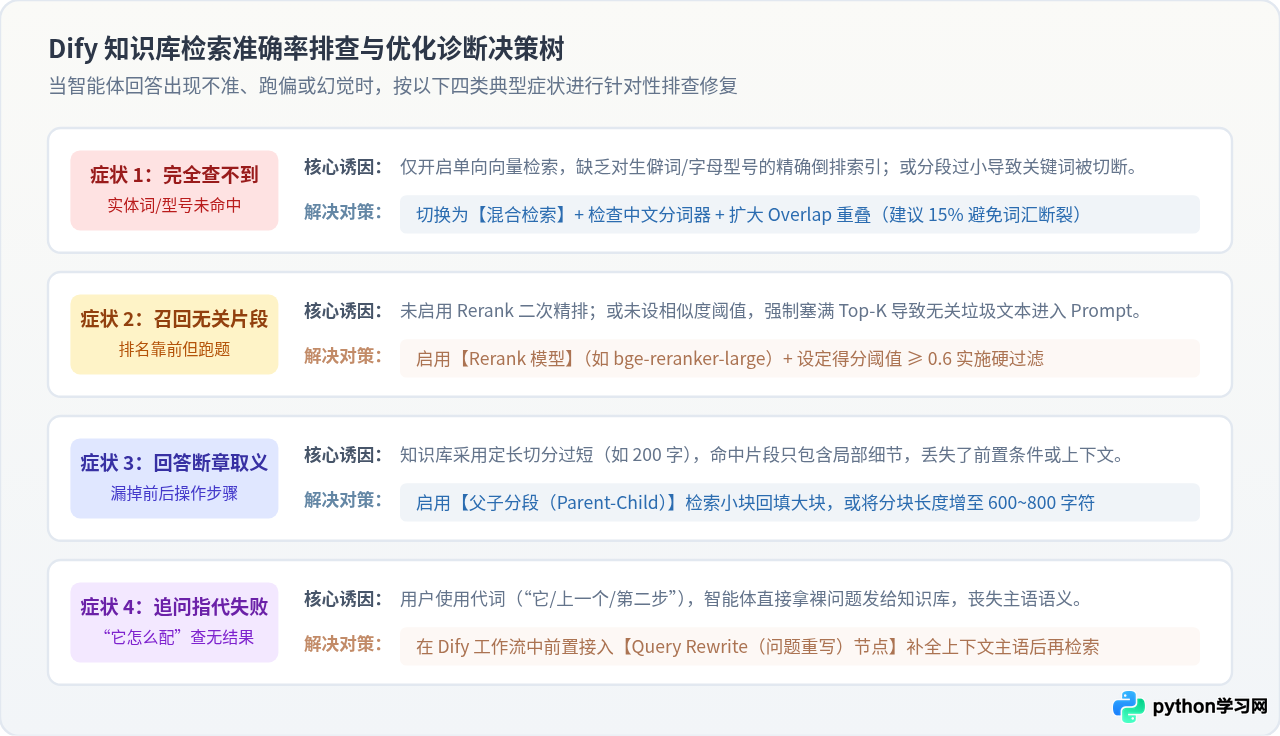
为了快速定位日常运行中出现的检索不准确现象,可以参考以下诊断决策树进行针对性排查:
落地验证方法:善用 Dify 内置的“召回测试(Hit Testing)”
修改完分段策略与检索参数后,切勿直接上线给用户测试,应充分利用 Dify 知识库内置的“召回测试(Hit Testing)”功能:
- 准备基准测试集:整理 20 ~ 30 条业务典型提问(包含近义词提问、具体型号查询、长句追问及部分超纲问题)。
- 输入测试比对:在召回测试界面输入问题,系统会直接展示出命中分段的列表、相似度评分以及被 Rerank 重新计算后的排序位次。
- 量化验证达标线: 检查预期答案是否出现在 Top-3 结果中(检验 Top-3 召回率);同时观察超纲问题的最高得分是否低于设定的得分阈值(检验低质噪音拦截率)。
通过持续迭代文档清洗质量、固化混合检索加 Rerank 参数基线,并在前置链路消除用户输入的模糊歧义,即可让 Dify 智能体的知识库回答稳定性与准确率达到工业级落地标准。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















