


Python数据库模型与表结构不一致怎么解决
深入解析Python开发中ORM数据库模型与实际数据库表结构脱节的核心原因、定位排查路径与标准解决步骤。涵盖SQLAlchemy与Django迁移同步、元数据修复及生产安全注意事项。
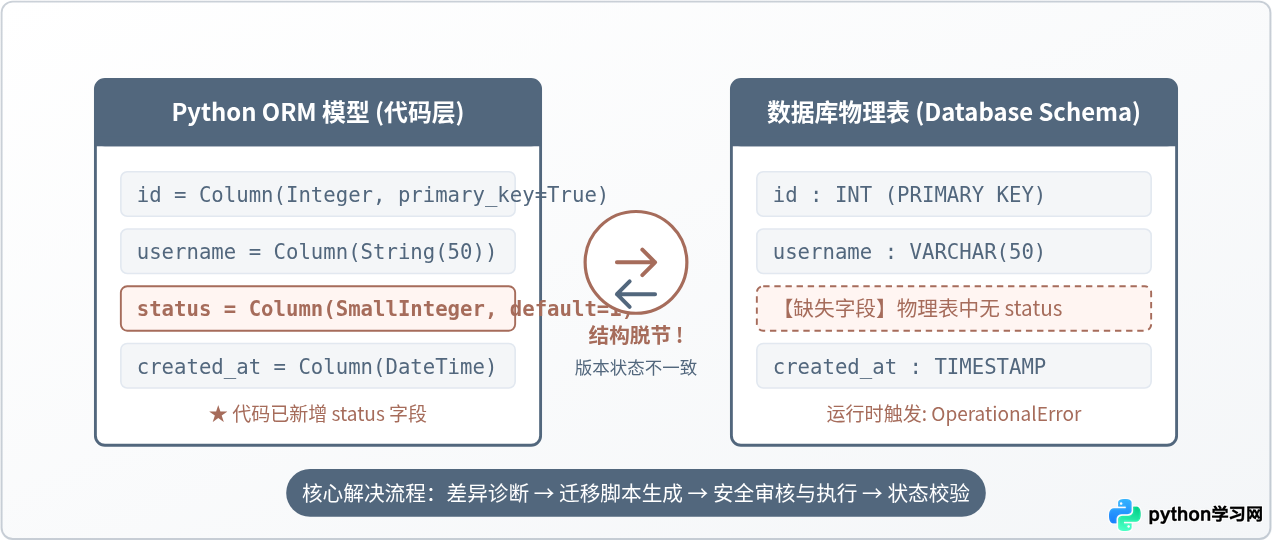
OperationalError: no such column、ProgrammingError: column does not exist 或外键约束失败时,核心诱因是代码中的 ORM 模型定义与实际数据库中的物理表结构产生了分歧。解决这一问题的标准路径非常明确:确立代码与数据库两者间的单一真实基准,借助自动化迁移工具(如 SQLAlchemy 的 Alembic 或 Django 的 Migrations)比对差异并生成版本化变更脚本执行;对于历史记录错位的情况,通过版本对齐标记(Stamp / Fake)消除元数据分歧,最后在 CI/CD 中建立静态检查拦截后续隐患。
一、认识不一致的表现与底层脱节机制
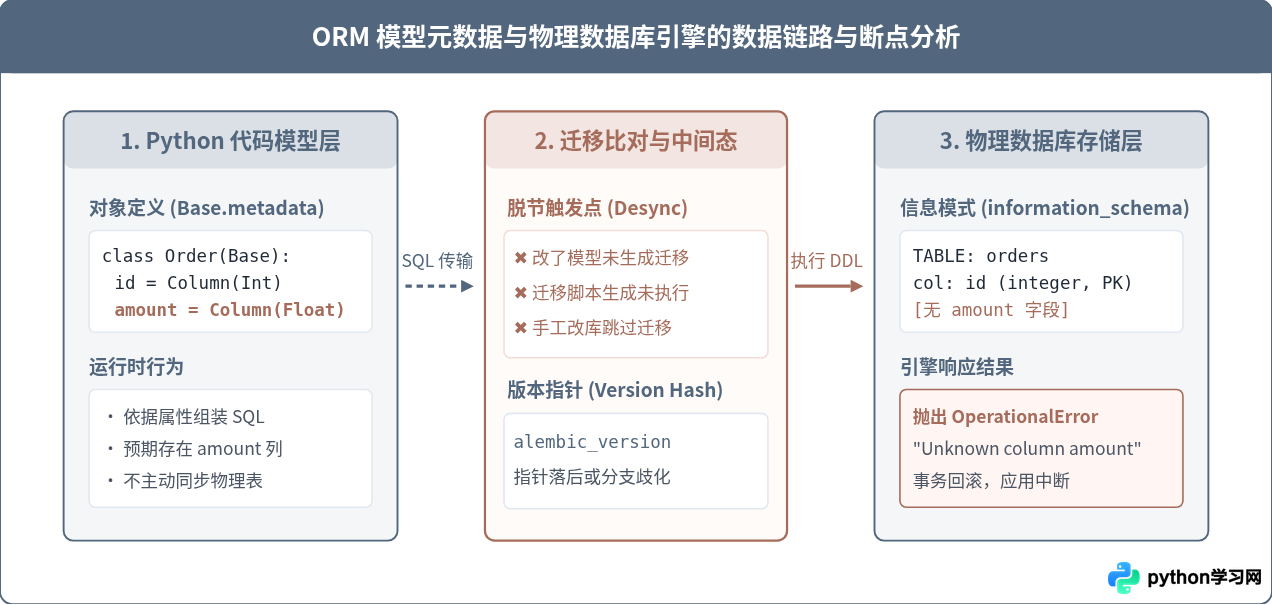
在以 SQLAlchemy、Django ORM、Tortoise-ORM 为代表的 Python 应用中,开发者习惯通过面向对象的类属性来管理关系型数据库表。但在实际工程迭代中,代码与物理库往往运行在两个不同生命周期中。当你在类中添加了一个字段并推向环境时,数据库并不会主动感知到代码的语法改变,导致两者在元数据上脱节。
这种不一致通常表现为以下几类具体异常:
- 缺失字段报错:执行查询时 ORM 默认根据模型属性生成
SELECT col1, col2, new_col FROM table,数据库引擎直接返回no such column或Unknown column; - 写入约束冲突:代码模型中将字段标记为必填,或者数据库中物理列设置了
NOT NULL但代码新建对象未赋值,引发IntegrityError; - 类型与长度静默截断:模型定义与列类型不符,例如代码中设为
String(255)而数据库依然是VARCHAR(32),当长文本写入时抛出数据过长错误或静默截断; - 迁移版本错位:数据库元数据表(如
alembic_version或django_migrations)记录的版本号与当前代码所指向的迁移版本链断裂。
二、定位与决策:确立解决基准方向
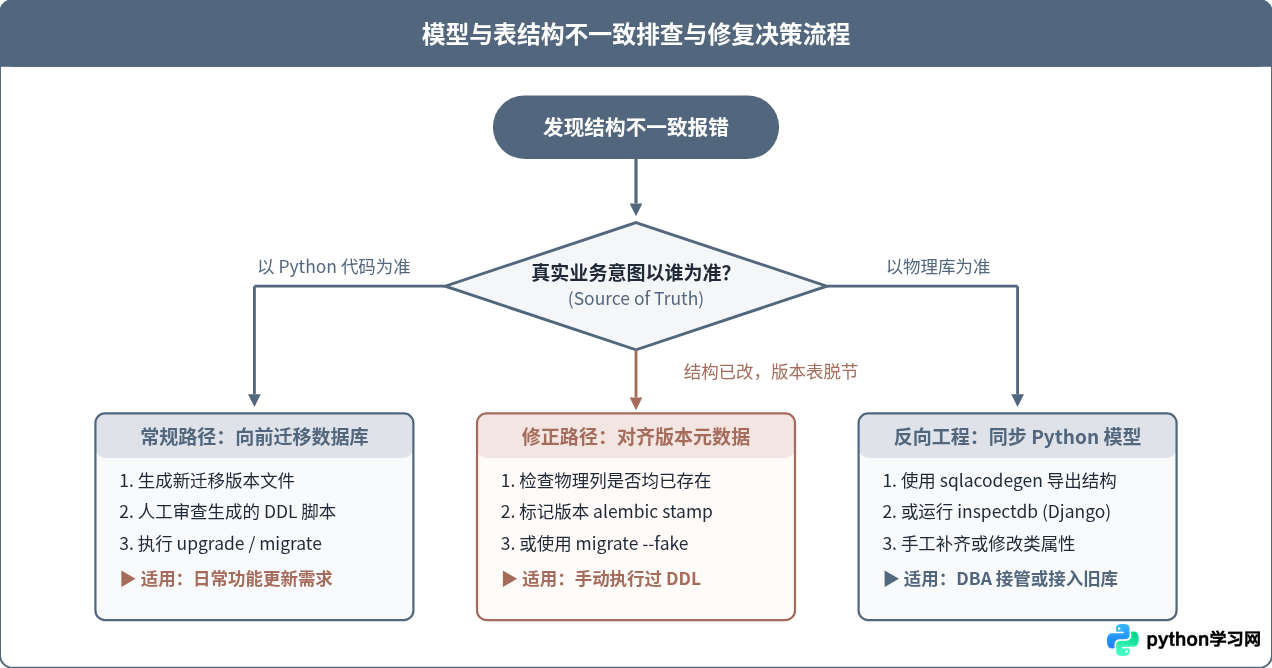
在动手修改任何代码或执行数据库变更前,必须首先厘清一个核心问题:当前是以“代码模型”为基准同步数据库,还是以“物理数据库”为基准倒推更新模型?盲目运行自动化命令可能导致线上真实数据列被直接删除。
三、主流场景的具体解决步骤
1. SQLAlchemy + Alembic 环境下的标准同步
在 SQLAlchemy 项目中,不要试图调用 Base.metadata.create_all(engine) 来同步已有表的新字段,因为 create_all 仅创建数据库中完全不存在的表,对已存在表内部字段的增删改完全静默忽略。标准同步方案必须依托 Alembic 迁移。
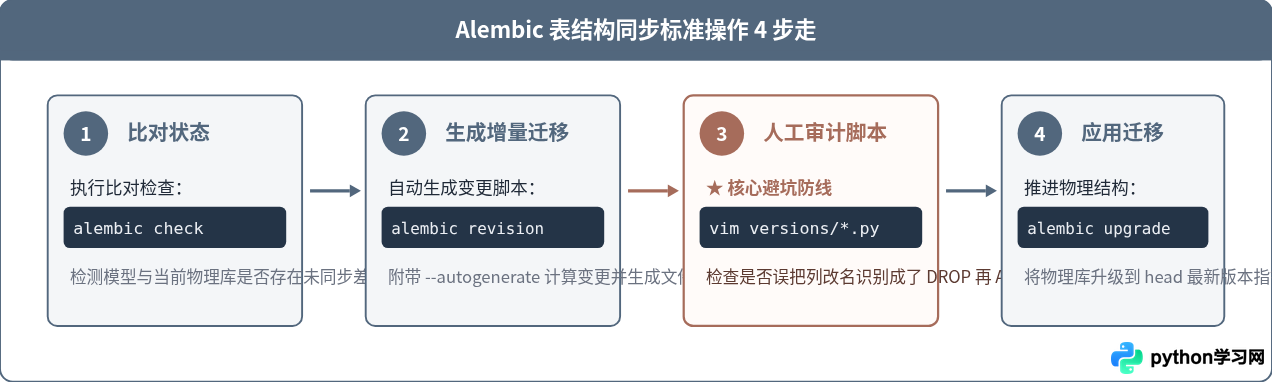
第一步:验证差异与生成变更脚本
在项目根目录(存在 alembic.ini 的路径)下执行自动检测:
# 1. 检查是否存在未同步的模型修改(如果存在会返回非零退出状态码)
alembic check

# 2. 对比 target_metadata 与当前数据库,生成变更迁移文件
alembic revision --autogenerate -m "add_status_column_to_users"--autogenerate 并非万能。它通过元数据反射对比,无法安全识别重命名字段。如果你在模型里将 user_name 改名为 username,Alembic 生成的脚本会是:先 drop_column('user_name') 再 add_column('username'),这将直接导致原有用户数据全部被抹去!遇到重命名字段,必须手动将脚本编辑为 op.alter_column('table_name', 'old_name', new_column_name='new_name')。
第二步:审核并执行迁移
打开生成的迁移文件,确认 upgrade() 和 downgrade() 函数中的操作符合预期,随后执行:
# 执行应用变更到最新版本
alembic upgrade head

# 验证当前数据库所处版本哈希
alembic current
2. Django ORM 环境下的同步流程
Django 内置了严密的迁移体系。如果在开发中修改了 models.py,直接按标准两步走:
# 1. 检测模型改动并创建迁移文件
python manage.py makemigrations

# 2. 将改动应用到目标数据库
python manage.py migrate

# 3. 检查所有应用迁移状态(全部带 [X] 即表示已同步)
python manage.py showmigrations
常见卡点与处理:当向已存在数据的表中新增一个非空列(models.CharField(max_length=50) 且未指定 null=True)时,Django 终端会提示提供一次性默认值(Provide a one-off default now)。必须输入一个合理的默认值或预先设置 default='...',否则迁移在向物理表写入非空约束时会因为已有旧记录无值而执行失败。
3. 物理表结构其实已被修改,但迁移历史记录丢失(元数据紊乱)
生产运维中常见一种事故:DBA 或开发人员因紧急故障直接在 MySQL/PostgreSQL 终端执行了 ALTER TABLE users ADD COLUMN status INT;,但没有通过迁移文件记录。此时如果再去跑迁移,工具会尝试再次 ADD COLUMN,报错 Duplicate column name 'status'。
此时的解决思路是:补写对应的迁移文件,但不让工具真正去执行 DDL,仅把迁移版本号记入元数据表。
-
Alembic 场景:生成好对应版本的迁移文件后,使用
stamp命令将版本号强行打入alembic_version表中:# 将数据库标记为已达到指定的 revision 版本,跳过实际 SQL 执行 alembic stamp 2a3b4c5d6e7f # 或者直接标记为最新 alembic stamp head -
Django 场景:使用
--fake参数伪造迁移执行:# 仅在 django_migrations 表中插入记录,不真正执行底层的 SQL python manage.py migrate --fake myapp 0005_add_status_column
4. 以现有数据库为准:反向工程生成或更新 Python 模型
如果接手的是已有复杂数据库,或者数据库结构被外部系统频繁改动,应该以物理库为准来修复 Python 模型代码:
| 技术栈 | 使用工具 / 命令 | 操作效果与建议 |
|---|---|---|
| SQLAlchemy | sqlacodegen mysql+pymysql://user:pwd@host/dbname |
直接反射全库表结构,输出完整的 Column、类型及主外键模型代码,将其复制替换工程中的模型类。 |
| Django ORM | python manage.py inspectdb > models_inspect.py |
内省数据库并输出标准 Django Model。审查字段类型后,将对应字段合入主工程。 |
| Tortoise-ORM | aerich inspect-db |
反射生成对应的 Tortoise ORM Model 类代码。 |
四、生产环境长效防御与闭环规范
解决单次不一致只是修复了现状,更重要的是防止团队协作或持续部署时反复出现脱节事故。
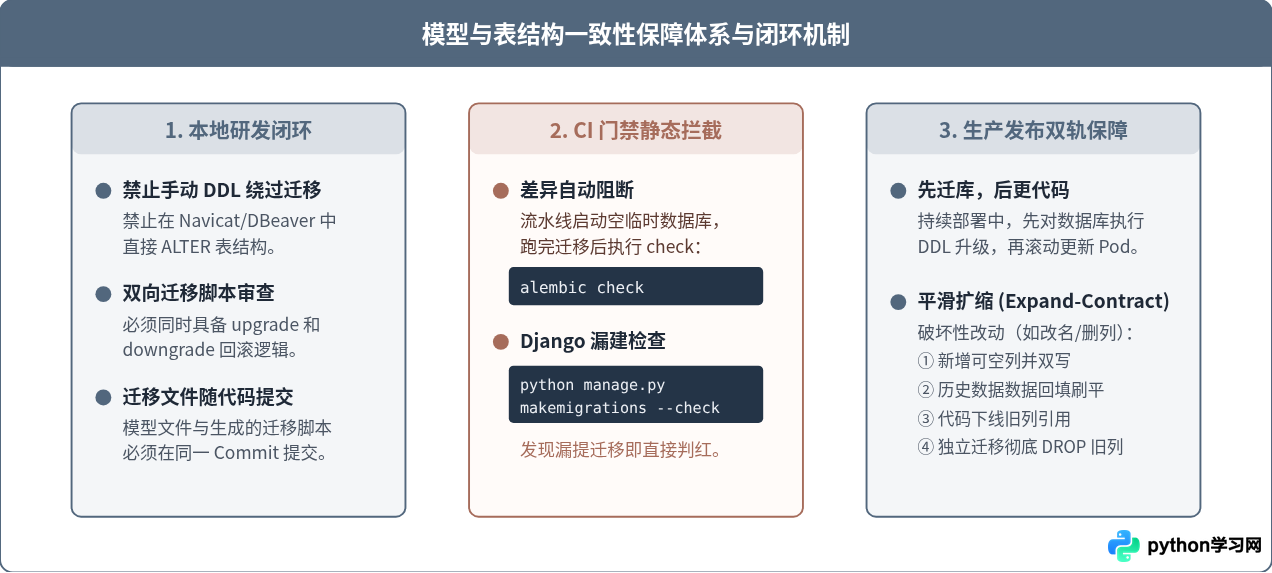
在敏捷发布流程中,最稳妥的上线顺序是“两阶段发布(Expand and Contract)”。绝不能在一个版本里既删掉旧列又引入新列,因为在容器或多实例滚动发布过程中,旧版本的 Python 进程依然在处理流量,一旦物理表旧列被立即删除,正在运行的旧进程会全面崩溃。新增列允许为空,待全部 Pod 升级为新版本代码并运行平稳后,再在后续版本中执行物理删除。
create_all 撞大运。遵循“辨明基准 → 生成受控脚本 → 人工审计列重命名 → 执行迁移与 stamp 对齐 → CI 静态拦截”这一标准化闭环,即可彻底排除字段不存在与约束冲突等隐患。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















