


Dify和LangChain有什么区别?应用平台与代码框架对比
深入对比 Dify 与 LangChain 的核心差异:从应用平台与代码框架的定位分野、RAG 落地流程、开发调试体验到实际团队选型建议。
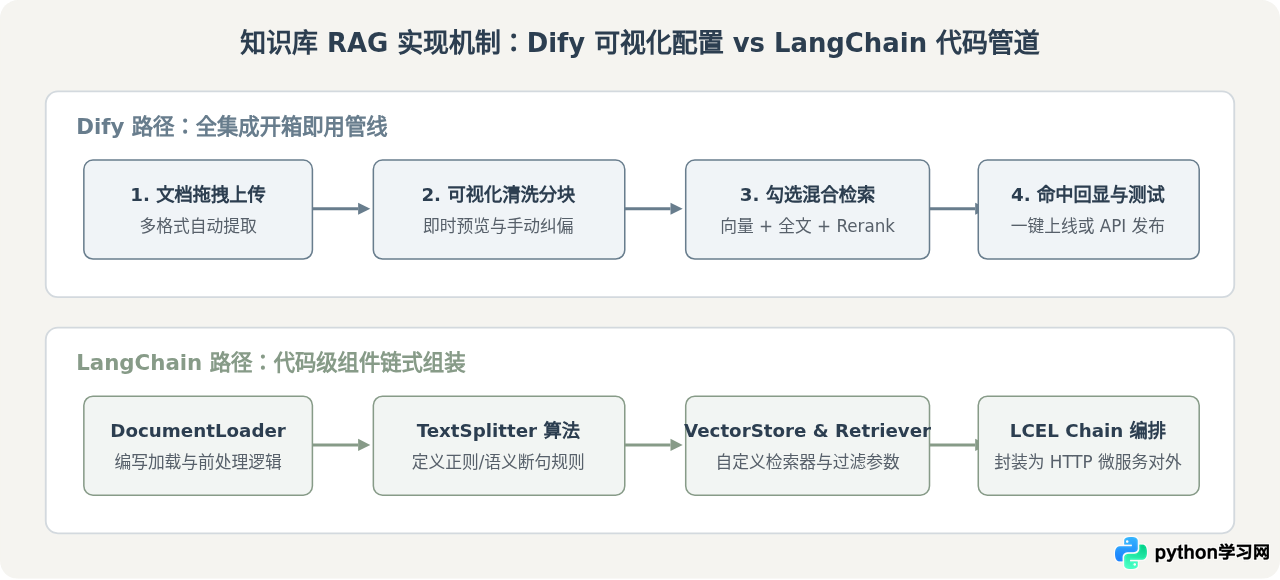
Dify 与 LangChain 最本质的区别,在于产品定位的层级完全不同:Dify 是一个开箱即用、带图形界面的 LLM(大型语言模型)应用开发与运维平台,而 LangChain 是一个面向程序员的代码级软件开发框架(SDK/库)。如果你需要快速搭建企业知识库、配置工作流并通过 Web 界面交付给团队使用,Dify 能提供全栈现成的解决方案;如果你要在现有的 Python 或 TypeScript 代码工程中深度定制复杂管道、编写底层控制算法,LangChain 则赋予了开发者极高的代码自由度。两者并非非此即彼的替代关系,而是处在 AI 落地技术栈的不同层级。
一、核心定位与技术形态对比
理解两者的差异,首先要看它们的交付形态与工作方式。很多初学者容易将二者混淆,是因为它们都能用来制作基于大模型的问答机器人(RAG)或智能体(Agent)。但仔细拆解两者的技术构成,会发现它们的侧重点截然不同。
Dify 的技术形态:Dify 是一个完整的应用程序系统(采用 Python 编写后端后端核心与引擎、Next.js 编写前端交互)。它自带用户权限管理系统、数据库、向量检索引擎连接器、可视化的 Prompt 编排画布,以及内置的模型 API 调度网关。部署好 Dify 后,用户甚至无需编写一行代码,就能在浏览器中完成数据上传、分块调优、提示词设计,并一键生成可直接嵌入官网的聊天组件或对外标准的 RESTful API。
LangChain 的技术形态:LangChain 则是一套供工程师在代码编辑器中调用的开源工具包。它通过抽象出一套核心概念(如 PromptTemplate、OutputParser、Retriever、Tool 以及基于管道符操作的 LCEL 表达式语言),帮助开发者用代码拼装模型调用链。LangChain 本身不提供可视化的后台界面,也不负责用户的鉴权或前端聊天窗渲染,所有的用户交互与服务部署都需要开发者自行通过 FastAPI、Flask 或 Next.js 等框架编写胶水代码完成。
二、关键场景对比:构建企业知识库问答(RAG)
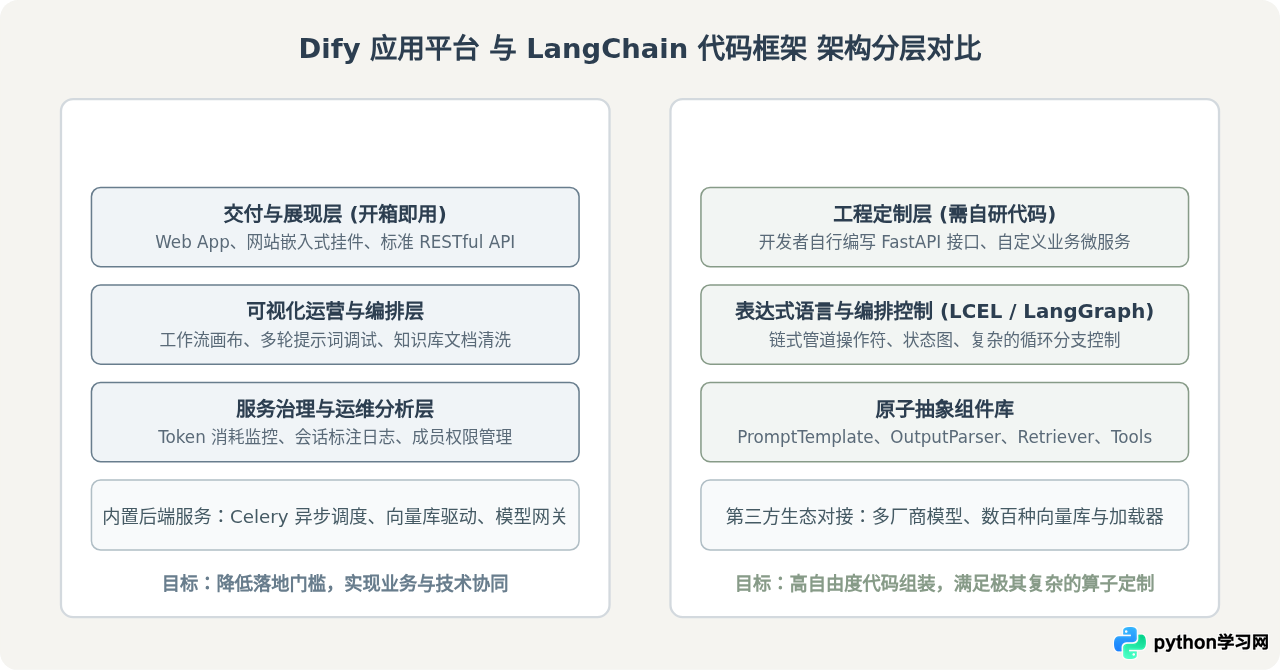
检索增强生成(RAG)是检验大模型应用框架成色最普遍的场景。通过对比在 Dify 与 LangChain 中实现 RAG 的全流程,可以清晰看出两者在工程复杂度与灵活性上的取舍。
1. 在 Dify 中搭建 RAG 的过程
在 Dify 中创建知识库问答,核心体验是流水线式的可视化操作:
- 数据导入与解析:直接将 PDF、Word 或 Markdown 文件拖拽进界面,系统后台自动调用预置的解析器提取文本。
- 分段与清洗策略选择:提供“自动分段”与“自定义分段”两种模式。在界面上可直观调整分块大小(Chunk Size)与重叠字数(Overlap),并能实时预览前五条切片效果,甚至直接在线修改切分不理想的文本块。
- 多路召回与重排配置:在设置中可直接勾选混合检索(向量检索 + 倒排关键词全文检索),并配置 Rerank(重排)模型,无需自行编写混合排序算法。
- 发布与调试:在主页面点击“测试检索”,输入问题即可看到召回的原文卡片和相似度分数。确认无误后,绑定到 Chatbot 即可直接使用。
2. 在 LangChain 中编写 RAG 的过程
而在 LangChain 中,开发者需要使用 Python 代码一步步组织数据管线。以下是一段典型的 LangChain (LCEL) 检索问答代码示例:
import os
from langchain_community.document_loaders import PyPDFLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_community.vectorstores import Chroma
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough

# 1. 加载文档并切分
loader = PyPDFLoader("company_manual.pdf")
docs = loader.load()
text_splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
splits = text_splitter.split_documents(docs)

# 2. 向量化存入向量库
vectorstore = Chroma.from_documents(documents=splits, embedding=OpenAIEmbeddings())
retriever = vectorstore.as_retriever(search_kwargs={"k": 3})

# 3. 构造提示词模板与格式化函数
def format_docs(docs):
    return "\n\n".join(doc.page_content for doc in docs)

prompt = ChatPromptTemplate.from_template(
    "根据以下参考信息回答问题:\n{context}\n\n问题:{question}"
)

# 4. 使用 LCEL 表达式连接管道
rag_chain = (
    {"context": retriever | format_docs, "question": RunnablePassthrough()}
    | prompt
    | ChatOpenAI(model="gpt-4o", temperature=0)
    | StrOutputParser()
)

# 5. 执行调用
answer = rag_chain.invoke("年假的申请审批流程是什么?")
print(answer)
从代码可以看出,LangChain 要求开发者对每个环节都有明确的控制权。例如你可以自由替换自定义的分词器、编写独创的多级检索逻辑(如 Parent Document Retriever 或 Self-Query Retriever)。但代价是:你需要自己维护环境依赖、向量数据库连接池,以及未来上线所需的 API 路由与前端展示界面。
三、开发工作流与协作模式对比
除了功能实现手段的差异,团队协作维度的考量往往是技术选型的决定性因素。
Dify 的多角色协同优势:在实际业务场景中,最了解提示词调优和业务知识边界的往往是产品经理、业务运营或领域专家,而非后端研发。Dify 的可视化画布(Workflow Canvas)允许非技术人员直接调整节点顺序、修改 System Prompt、补充知识库条目。开发团队只需负责最初的部署或编写自定义工具插件,极大解放了研发生产力。
LangChain 的工程师中心模式:LangChain 的所有调整都发生在代码提交和代码审查(PR)环节。每当业务人员提出“提示词要增加一条约束”或者“需要更换一个重排模型”,都必须由开发人员修改代码、运行单测并重新发版上线。如果团队完全由资深全栈工程师组成,这种方式能够享受到 Git 版本控制、严格类型检查(TypeScript)和本地自动测试的便利;但对于非技术角色密集的团队,沟通链条会明显拉长。
四、关键维度全面对照
为了更直观地展示技术特性的分布,下表在开发语言、运维要求、可扩展性等核心维度对二者进行了对照:
| 对比维度 | Dify (应用平台) | LangChain (代码框架) |
|---|---|---|
| 核心形态 | 完整 Web 应用程序系统与中间件 | Python / TypeScript 代码库 (SDK) |
| 用户界面 | 原生自带全功能管理后台与对话交互 UI | 无,需开发者自建或搭配第三方前端组件 |
| 门槛与受众 | 极低,产品经理、运营人员及开发者均可上手 | 中高,要求熟练掌握编程语言与异步架构 |
| RAG 知识库 | 内置开箱即用的解析、切分、混合检索与重排 | 需在代码中调用相应组件逐项组装调用链 |
| 应用调试 | 页面内单步追踪执行、查看各节点详细输入输出 | 代码日志打点、单元测试或接入 LangSmith |
| 定制上限 | 支持自定义 Python 代码节点和 Tool 插件扩展 | 极高,理论上支持任何代码级别的自定义控制 |
| 系统运维成本 | 需维护 Docker/Kubernetes 运行底座及数据库 | 视宿主工程而定,框架本身无常驻服务进程 |
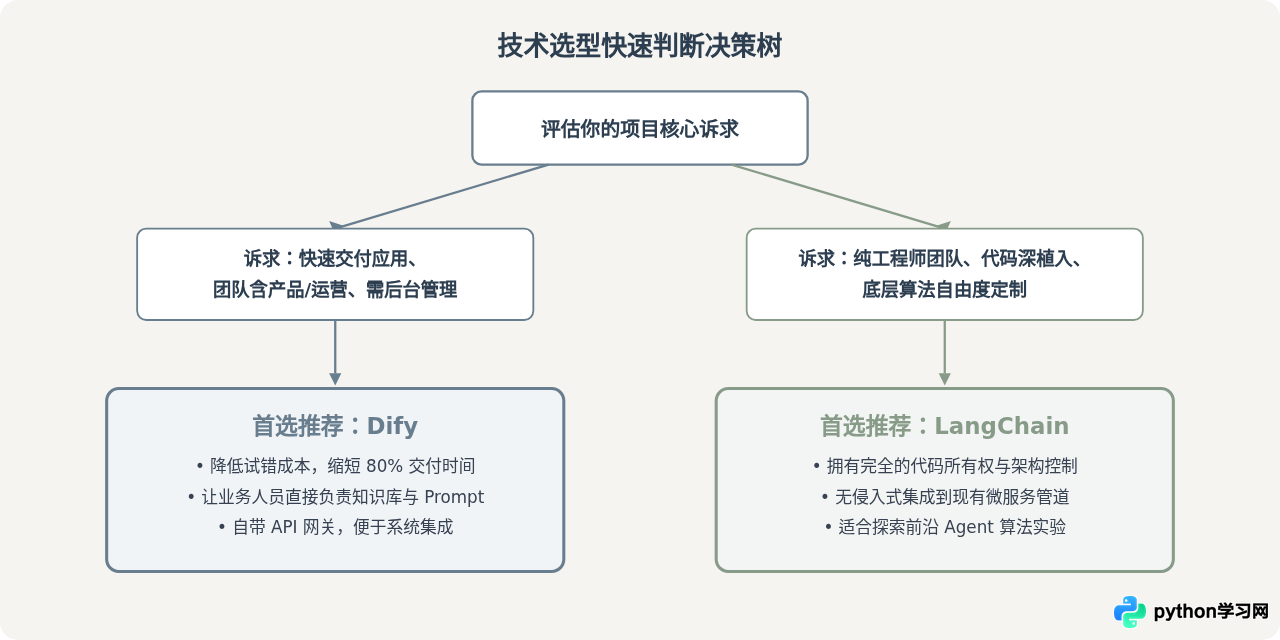
五、选型决策指南:如何根据实际需求选择?
在面对具体业务需求时,选型的核心依据在于团队技能配比与定制深度的边界:
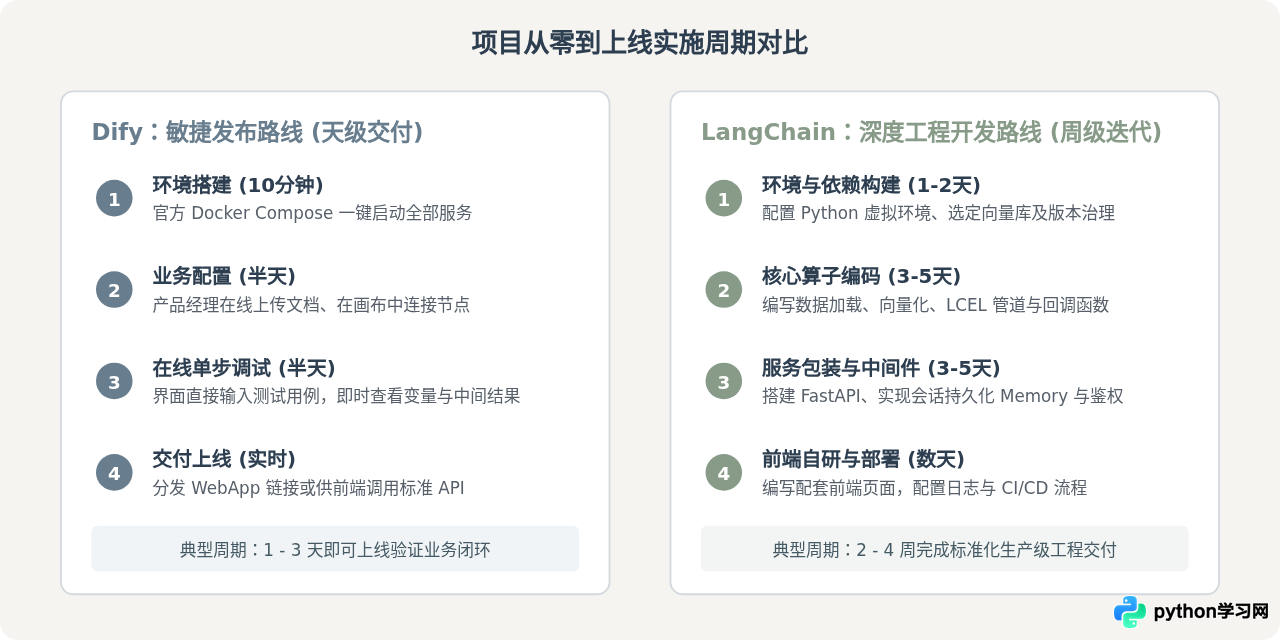
- 快速上线企业知识库与内部问答系统:如果你只有 1-2 名工程师,需要在最短时间内交付能跑通的内部知识库或客户答疑助手,Dify 是生产效率最高的选择。
- 团队需要业务人员深度参与提示词工程:业务规则频繁变动,且变动大多集中在“提示词微调”和“知识库维护”层面,采用 Dify 可以直接省去研发充当传话筒的成本。
- 希望获得开箱即用的多租户与数据看板:Dify 默认具备按应用统计 Token 消耗量、用户点赞/踩反馈记录的能力,满足大多数中小团队的管理诉求。
- 将 LLM 深度嵌入现有的大型软件代码库:你的核心项目是一套成熟的 Python/Node.js 微服务架构,AI 只是系统中的一个内部计算环节,并不需要独立的 Web 平台。
- 有高度特化的底层数据结构与算法需求:例如需要实现学术前沿的多阶段自省推理(Self-Refine)、专有的向量数据库驱动适配或极其非标准的数据清洗规则。
- 需要极致的控制粒度与无依赖分发:作为基础库打包进桌面端程序(如 Electron 客户端)或轻量 CLI 工具中运行,不需要后台数据库和常驻 Web 服务。
六、两者的结合与常见认知误区
1. 常见认知误区澄清
- 误区一:Dify 是 LangChain 的前端界面或套壳。事实并非如此。早期 Dify 的底层逻辑曾参考过社区模式,但经过多个大版本的演进,现在的 Dify 已经拥有完全自主研发的 RAG 检索引擎、Agent 运行时(Agent Runtime)和独立的调度框架,两者的代码架构没有强制从属依赖。
- 误区二:使用了 Dify 就无法进行二次开发。Dify 是完全开源的项目(基于 Apache 2.0 衍生协议),不仅支持私有化部署,还支持开发者通过编写自定义代码节点(Code Node)或开发 Tool 插件来接入专有业务系统;同时它生成的每个应用都提供标准的 REST API,可以被任何其他外部系统调用。
- 误区三:LangChain 的应用写完后可直接给最终用户使用。在实际生产中,仅仅运行
chain.invoke()只是完成了算子逻辑。要给真实客户使用,开发者仍需手动补充用户鉴权、会话历史存储(Redis/PostgreSQL)、输入防注入审查、限流熔断以及前端交互界面。
2. 两者的混合协同方案
在成熟的复杂企业架构中,Dify 与 LangChain 经常并存使用:
例如,算法研发团队可以使用 LangChain 或 LangGraph 在后台编写极具深度、包含数十个复杂步骤的专有计算服务,并将其封装为一个内部 HTTP API;随后,业务团队在 Dify 的画布中将这个 API 注册为一个自定义工具(Tool)节点。通过这种方式,底层复杂的算法能力得到了代码级定制,而上层的提示词组装、最终界面展示和多租户运营则由 Dify 统一接管,实现了灵活性与交付效率的最大化平衡。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















