


Python集合交集、并集与差集运算方法详解
深入详解Python集合(set)的交集、并集与差集运算方法,结合文氏图拓扑原理、内置方法与运算符差异对比、实战数据比对流水线及注意事项,提供系统实用的操作指南。
set)是一种基于哈希表实现的无序、元素唯一的容器结构。针对多源数据的匹配、过滤与合并,集合提供了数学意义上的交集(Intersection)、并集(Union)与差集(Difference)运算。本文将直接从底层原理、两种调用范式(运算符与内置方法)、实战应用流水线以及工程陷阱四个维度展开系统解析,帮助你在实际开发中准确、高效地应用集合运算。
一、集合运算的核心原理与文氏图解析
集合运算建立在经典集合论基础之上。与列表(list)遍历比对所需的 O(N × M) 时间复杂度不同,Python 集合内部利用哈希表(Hash Table)管理元素,其元素查找操作的平均时间复杂度为 O(1)。这意味着进行集合间的交集、并集或差集计算时,算法仅需对其中一个集合进行单次线性扫描即可完成匹配,大幅提升了大规模数据集的处理效率。
为了准确区分常见运算的边界,我们可以借助文氏图(Venn Diagram)直观观察两个集合 A 与 B 在不同运算规则下的元素归属:
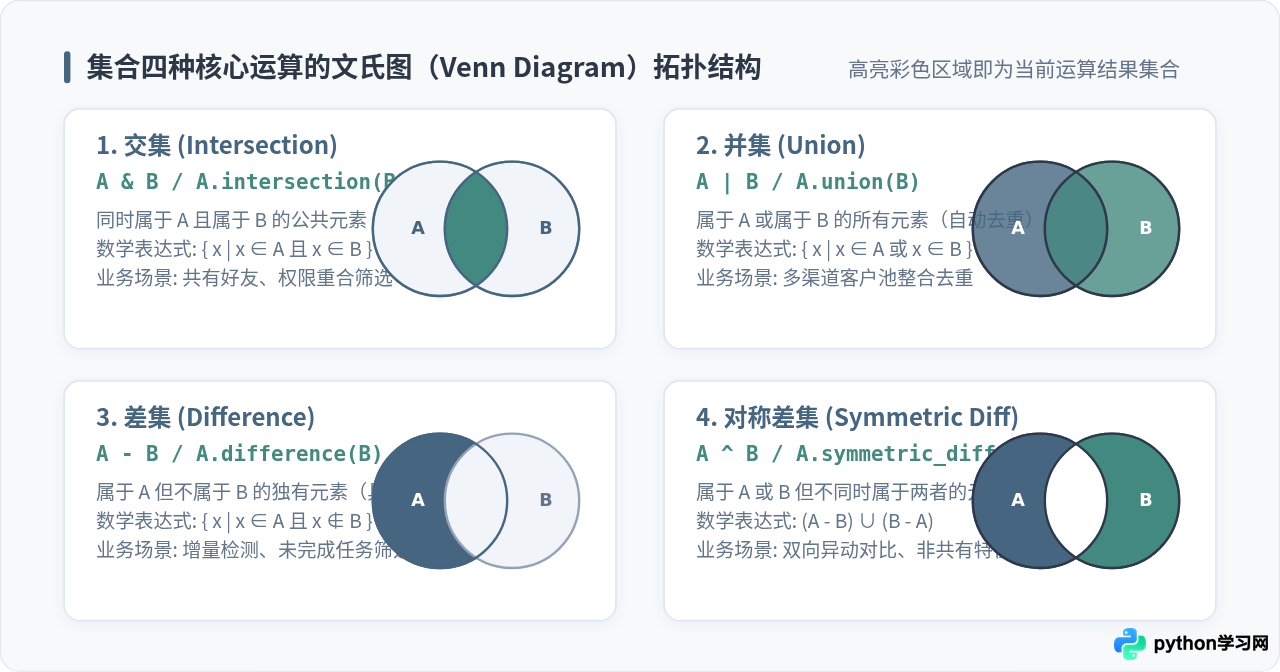
从数学定义与集合包含关系来看:
- 交集(Intersection):提取两个集合共同拥有的元素。只有同时属于
A且属于B的元素才会被保留。 - 并集(Union):汇合两个集合的所有元素,并依据哈希唯一性自动剔除重复项。属于
A或属于B的元素均被收录。 - 差集(Difference):具有明确的方向性。
A - B表示保留所有属于A但在B中不存在的元素;反之B - A则保留B独有的元素。 - 对称差集(Symmetric Difference):由属于
A或属于B、但不同时属于二者的元素组成,等价于(A - B) ∪ (B - A)。
二、交集运算(Intersection):提取共同元素
交集运算用于筛选多个数据源中的重叠部分。在 Python 中,可以通过按位与运算符 &、实例方法 intersection() 以及就地更新方法 intersection_update() 来实现。
1. 运算符 & 与 intersection() 方法
当两端操作数均为集合类型时,使用 & 符号语法简练;而 intersection() 更加灵活,允许传入任意可迭代对象(如列表、元组、生成器等),并支持同时计算多个对象的交集。
# 环境: Python 3.8+
# 场景: 部门员工具备的技能标签比对
dev_skills = {"Python", "Linux", "Docker", "Git"}
ops_skills = {"Linux", "Kubernetes", "Docker", "Ansible"}

# 方式一:使用运算符 &(操作数必须均为 set)
common_skills_op = dev_skills & ops_skills
print("运算符交集结果:", common_skills_op)

# 方式二:使用 intersection() 方法(参数可为 list 或其他 iterable)
backend_requirements = ["Linux", "Docker", "Go"]
matched_skills = dev_skills.intersection(backend_requirements)
print("方法交集结果:", matched_skills)

# 方式三:链式求解多个集合的共同交集
qa_skills = {"Linux", "Git", "Python"}
core_skills = dev_skills.intersection(ops_skills, qa_skills)
print("三方共有技能:", core_skills)2. 就地修改:intersection_update() 与 &=
如果希望直接修改现有集合,而无需重新开辟内存创建新对象,可以使用 intersection_update() 或增强赋值运算符 &=。这在处理高频或内存密集型任务时具有显著优势。
active_users = {"user_101", "user_102", "user_103", "user_104"}
paid_users = {"user_102", "user_104", "user_105"}

# 将 active_users 直接修改为其与 paid_users 的交集
active_users.intersection_update(paid_users)
print("就地更新后的 active_users:", active_users)三、并集运算(Union):合并元素并自动去重
并集运算用于汇聚分散的数据流。在汇聚的同时,集合会自动对重复项进行剪枝,确保每个唯一值仅保留一份。
1. 运算符 | 与 union() 方法
使用竖线 | 可以直观表达两个集合的合并;union() 则支持将一个主集合与多个不同类型的容器进行合并计算。
# 场景: 汇总来自两个服务节点的告警 ID
cluster_a_alerts = {"ALT-001", "ALT-002", "ALT-003"}
cluster_b_alerts = {"ALT-003", "ALT-004", "ALT-005"}

# 方式一:运算符 |
all_alerts_op = cluster_a_alerts | cluster_b_alerts
print("运算符并集结果:", all_alerts_op)

# 方式二:union() 方法接受元组或列表
legacy_alerts = ("ALT-005", "ALT-006")
aggregated_alerts = cluster_a_alerts.union(cluster_b_alerts, legacy_alerts)
print("多来源汇总并集结果:", aggregated_alerts)2. 就地扩充:update() 与 |=
s.update(iterable) 是 Python 集合中最常用的扩充方法,相当于列表的 extend(),但具备集合的去重属性。
whitelist = {"192.168.1.1", "192.168.1.2"}
new_ips = ["192.168.1.2", "192.168.1.3", "192.168.1.4"]

whitelist.update(new_ips)
print("扩充后的白名单集合:", whitelist)四、差集运算(Difference):找出独有元素
差集的核心价值在于变化比对和单向排除。它能够迅速解答“集合 A 中有哪些元素是集合 B 中没有的”。
1. 差集的单向性:A - B 与 B - A
与交集和并集的对称性不同,减法运算符 - 具有严格的左操作数依赖性。A - B 与 B - A 代表完全不同的物理含义。
expected_tasks = {"task_1", "task_2", "task_3", "task_4"}
completed_tasks = {"task_2", "task_4", "task_5"}

# 未完成的任务: 计划中有,但实际未完成
uncompleted = expected_tasks - completed_tasks
print("未完成任务 (expected - completed):", uncompleted)

# 计划外的冗余任务: 实际完成但未在计划中列出
extra_tasks = completed_tasks - expected_tasks
print("计划外任务 (completed - expected):", extra_tasks)

# 采用 difference() 方法
print("通过方法计算未完成任务:", expected_tasks.difference(completed_tasks))2. 对称差集补充:^ 与 symmetric_difference()
当我们需要同时找出“A 独有”与“B 独有”的所有元素,并剔除二者共有部分时,应采用对称差集。
config_local = {"host", "port", "timeout", "debug"}
config_remote = {"host", "port", "token", "retries"}

# 找出存在差异的配置键名
diff_keys = config_local ^ config_remote
print("双向非共有配置项:", diff_keys)五、运算符与内置方法的关键差异与选择流程
在实际编写代码时,开发者经常在符号运算符(如 &, |, -)与对象内置方法(如 intersection(), union(), difference())之间犹豫。这两套机制在语法灵活性和类型约束上存在明确差异:
- 操作数类型限制:运算符要求两边必须全部是
set(或frozenset)类型。如果右侧传入列表或元组,Python 会直接抛出TypeError: unsupported operand type(s)。而内置方法可以接受任何可迭代对象。 - 多参数支持:内置方法支持传入多个可迭代对象作为参数(例如
s.union(list1, tuple2, set3)),而运算符若要组合多个对象,必须写成链式形式且所有对象均需提前转为集合。 - 就地修改能力:若需节省内存开销,必须使用带有
_update后缀的方法或复合赋值运算符(&=,|=,-=)。
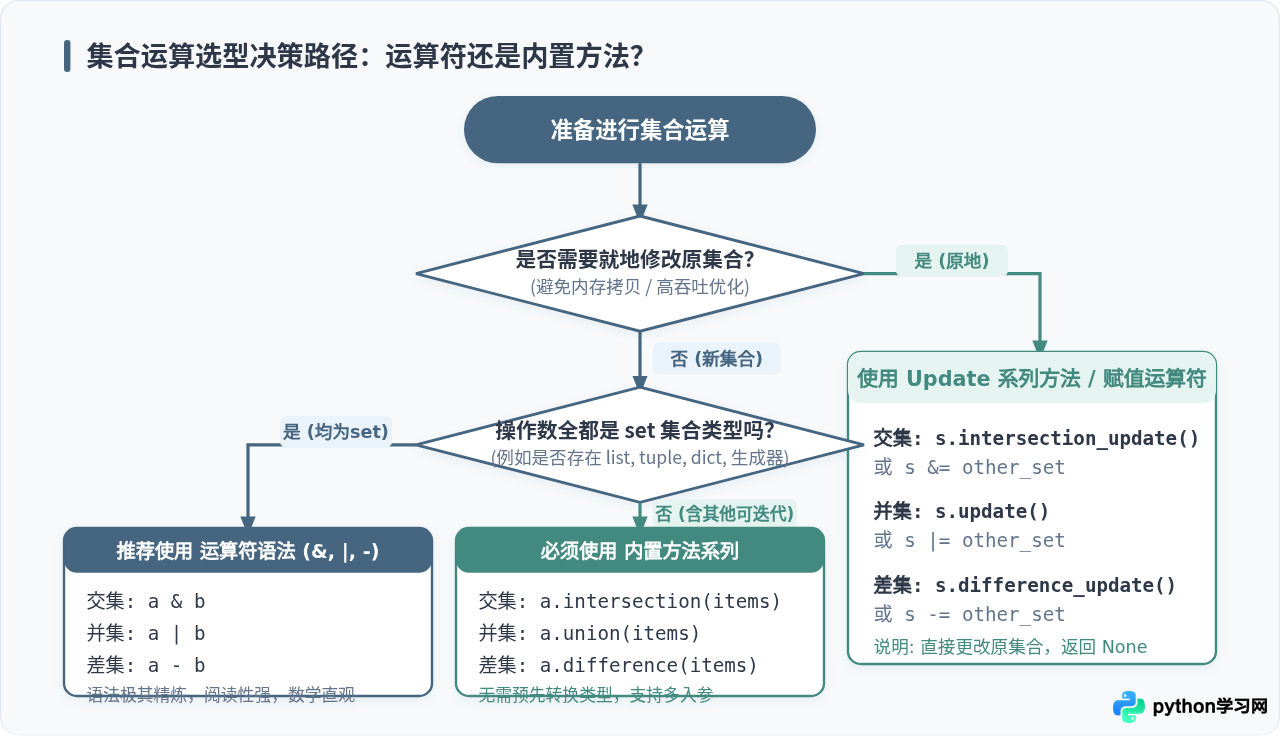
set,且需要简洁的数学可读性时,优先使用 &、|、-;当需要比对来自数据库游标、文件迭代器或列表的数据时,直接调用 s.intersection(iterable),无需额外执行 set(...) 显式转换,节省一次内存申请。
六、实战操作流程:基于集合运算的数据比对与过滤
为了加深理解,我们以一个典型的工业级业务场景为例:远程服务端数据与本地数据库缓存的数据增量同步。系统需要快速识别出哪些是远程新增加的记录、哪些是远程已经删除的过期记录,以及哪些是存量重叠记录。
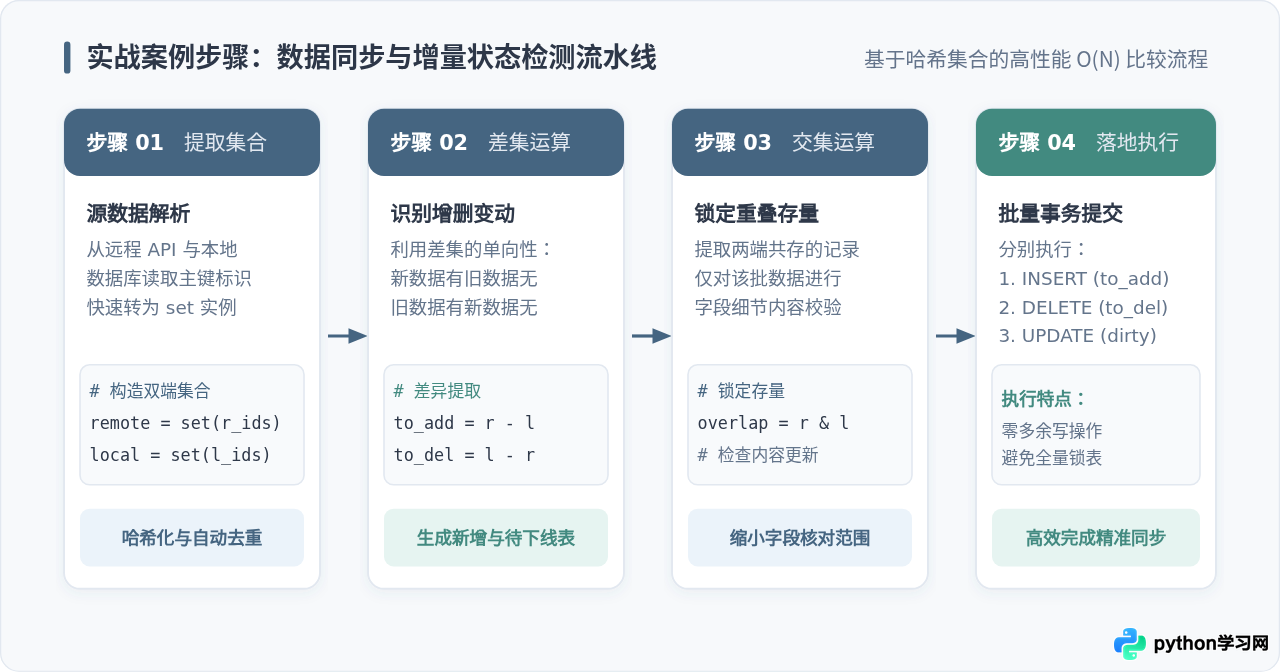
完整数据同步与比对实现代码
# 完整数据增量比对同步脚本
# 执行环境: Python 3.8+

def synchronize_catalog(local_records: list, remote_records: list):
    """
    通过集合交集与差集运算实现高效率增量数据分类
    """
    # 步骤 1: 提取主键唯一标识并构建集合
    local_id_set = {item["id"] for item in local_records}
    remote_id_set = {item["id"] for item in remote_records}

    print(f"本地现有数据量: {len(local_id_set)} 条 | 远程最新数据量: {len(remote_id_set)} 条")

    # 步骤 2: 差集运算 - 提取待插入新增项 (远程有但本地无)
    insert_ids = remote_id_set - local_id_set

    # 步骤 3: 差集运算 - 提取待下线删除项 (本地有但远程已废弃)
    delete_ids = local_id_set - remote_id_set

    # 步骤 4: 交集运算 - 锁定共同存量项以备更新检查
    retained_ids = remote_id_set & local_id_set

    # 步骤 5: 结果格式化输出
    return {
        "to_insert": sorted(list(insert_ids)),
        "to_delete": sorted(list(delete_ids)),
        "to_check_update": sorted(list(retained_ids))
    }

# 准备测试数据
local_cache = [
    {"id": 1001, "name": "商品A", "price": 49.0},
    {"id": 1002, "name": "商品B", "price": 88.0},
    {"id": 1003, "name": "商品C", "price": 120.0},
]

remote_api = [
    {"id": 1002, "name": "商品B", "price": 95.0},  # 存量项,价格变更
    {"id": 1003, "name": "商品C", "price": 120.0}, # 存量项,无变更
    {"id": 1004, "name": "商品D", "price": 230.0}, # 新增项
]

sync_plan = synchronize_catalog(local_cache, remote_api)
print("同步执行计划:", sync_plan)七、常见陷阱与性能优化注意事项
在编写集合运算逻辑时,以下几个细节极易导致逻辑错误或运行时崩溃,需要特别防范:
在 Python 中,一对空花括号
{} 默认定义的是空字典(dict),而非空集合。若要声明一个空集合,必须显式调用内置函数 set()。如果误写为 empty_set = {},后续调用 empty_set.intersection(...) 时会触发 AttributeError。
1. 集合元素的哈希限制(Unhashable Types)
集合底层严重依赖哈希查找,因此集合中的所有元素必须是可哈希的(Hashable),即可调用 hash() 函数且生命周期内哈希值不变。
- 合法元素:整数、浮点数、字符串、元组(其子元素亦必须可哈希)、冻结集合
frozenset。 - 非法元素:列表
list、字典dict、常规集合set。将列表放入集合会抛出TypeError: unhashable type: 'list'。
2. 遍历中的就地修改冲突(RuntimeError)
与字典类似,不能在直接遍历集合的过程中执行 remove()、add() 或原地运算方法。集合哈希桶在扩容或元素删除时会导致迭代器状态失真,Python 解释器会主动抛出 RuntimeError: Set changed size during iteration。如需过滤,应采用差集运算或者列表推导式生成副本。
八、运算方法速查与总结
熟练掌握集合的交集、并集与差集,不仅能显著精简代码行数,更能在数据量膨胀时借助哈希优势保持高效。下表直观总结了各个运算的符号表达、方法映射与核心特征:
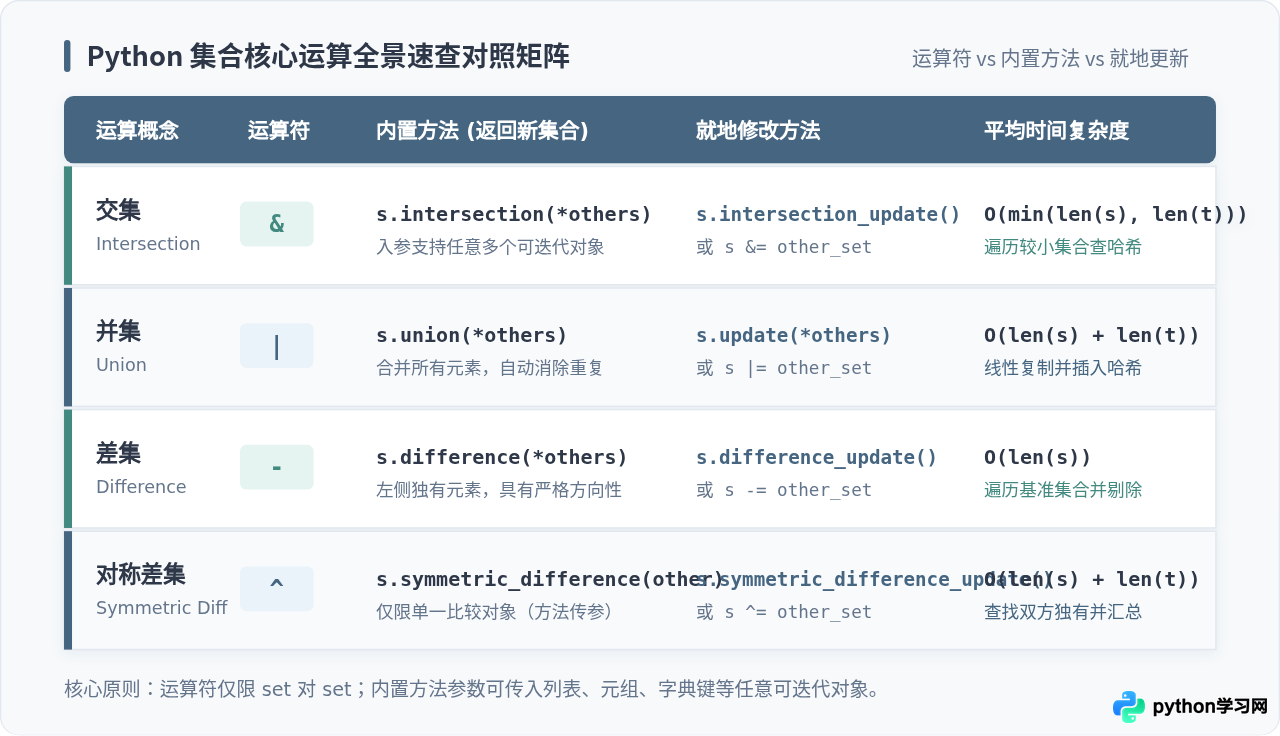
在实际工程开发中,推荐形成如下默认习惯:比对明确的集合对象优先使用 &, |, -;处理外部列表或管道输入优先使用 .intersection(), .union(), .difference();在追求极致性能与节约内存的循环体内部,坚决使用 .update() 等就地修改方法。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















