


Python切片省略参数怎么写?[:],[::]与[::2]的效果对比
深入解析Python切片中省略参数的底层规则与编写方式,详细对比[:]、[::]与[::2]在取值范围、步长机制、内存分配及实际应用场景中的核心区别与避坑要点。
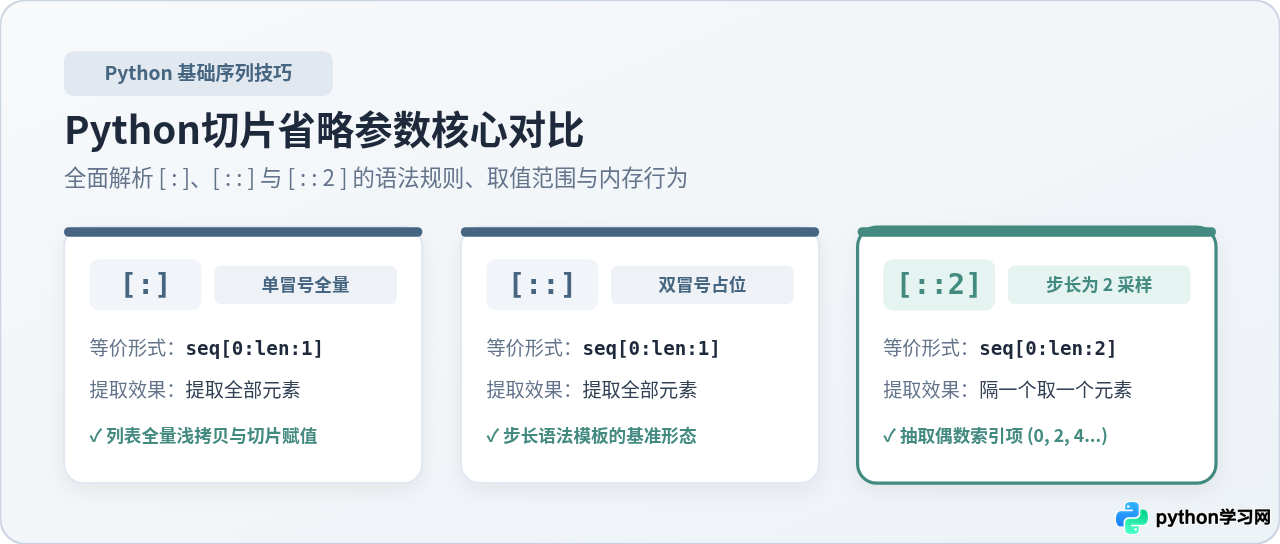
sequence[start:stop:step]。当省略参数时,Python 会自动采用默认值:在正向步长下,start 缺省为 0,stop 缺省为序列长度 len(seq),step 缺省为 1。因此,[:] 与 [::] 均提取原序列的全部元素并生成浅拷贝副本,二者取值完全一致;而 [::2] 明确指定了步长为 2,其效果是“跨步采样”,只提取索引为 0、2、4、6 等偶数位置的元素。
一、切片基本结构与缺省参数解析规则
Python 中的切片语法允许我们高效地截取列表(list)、字符串(str)和元组(tuple)等有序序列的连续或跳跃子集。一个完整的切片表达式包含由冒号隔开的三个可选参数:
sequence[start:stop:step]这三个参数各自承担明确的角色:
start(起始索引):切片截取的起点,包含该位置的元素。若省略,当step > 0或未指定step时,默认为0;当step < 0时,默认为序列的最后一个元素(即索引-1)。stop(终止索引):切片截取的终点,不包含该位置的元素(典型的左闭右开区间[start, stop))。若省略,当step > 0时默认为len(sequence);当step < 0时默认为序列开头之前(涵盖索引 0)。step(步长):索引遍历的步进值。若省略第二个冒号及步长,默认步长为1。步长不仅决定采样频率,其正负符号更决定了切片的方向(正数为从左向右正序截取,负数为从右向左反序截取)。
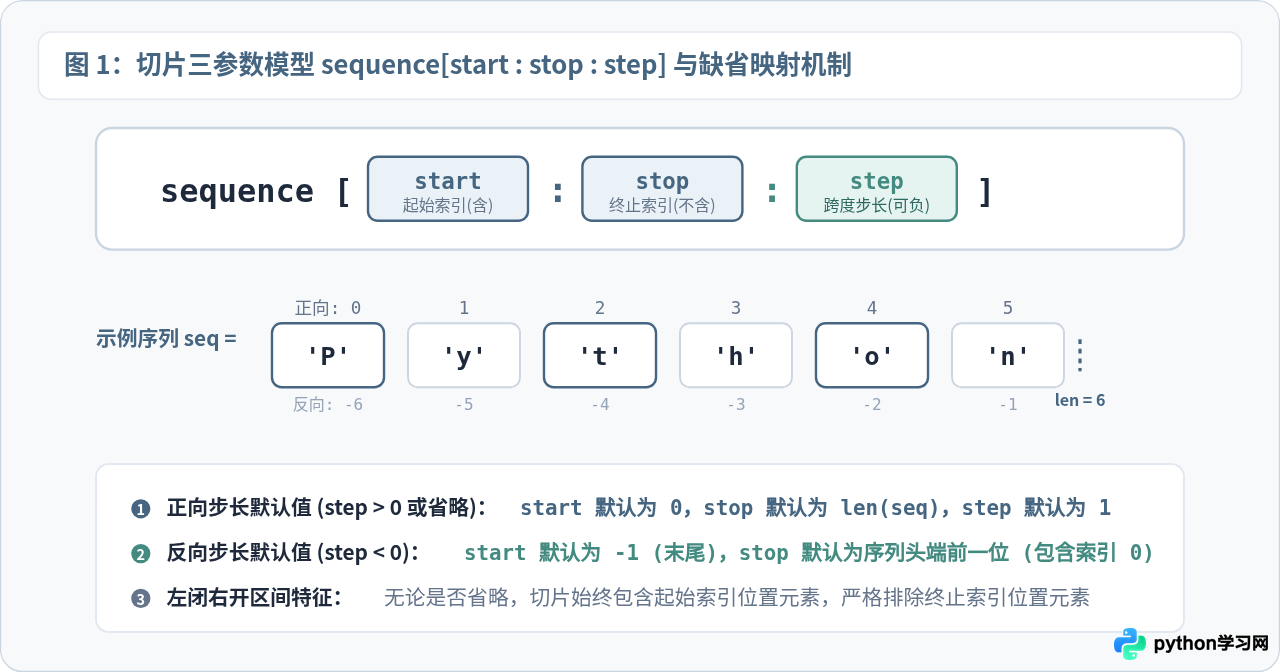
理解了默认值映射之后,我们就能清楚知道:冒号在这里充当占位符与分隔符。根据冒号的数量和参数填写的相对位置,Python 解释器可以精确判定开发者想要省略哪些参数。
二、切片操作执行与指针计算步骤
很多初学者对省略参数感到疑惑,本质上是没有建立 Python 解释器内部如何处理切片的执行模型。当我们在代码中书写 data[::2] 或 data[:] 时,Python 底层的实际处理流程分为四个关键步骤:
- 语法解析与冒号定位:解释器首先根据方括号内的冒号数量划分参数槽位。单个冒号划分为
start和stop两个槽位;双冒号则明确指出第三个参数是step。 - 填补缺省边界(Default Filling):检查各个槽位是否为空。若为空,根据当前步长的符号填充对应的边界默认值。
- 指针计算与循环提取:指针从
start开始,在满足终止边界条件前,依次按step的幅度增加指针索引,收集对应元素。 - 封装并返回同类型新序列:将所有收集到的元素装配入一个新的容器对象中,返回给调用者。
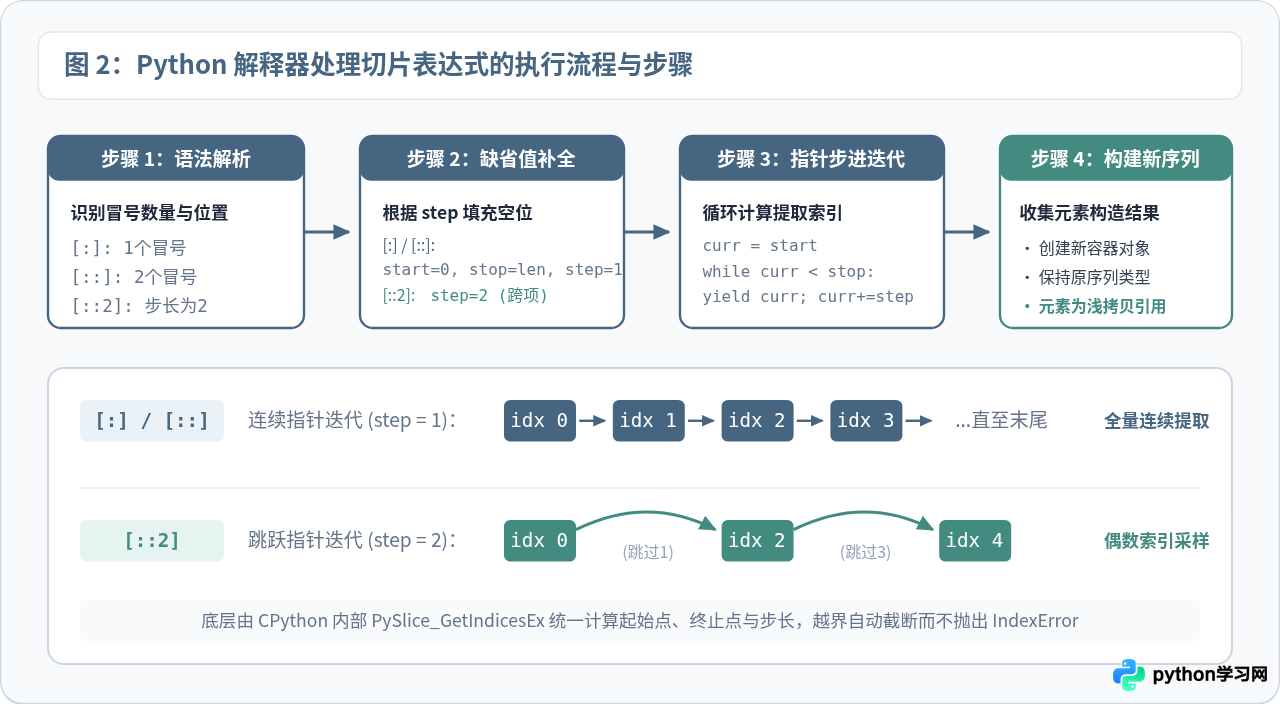
由于 Python 切片具有容错保护机制,即使指定的索引超出实际范围(例如序列长度为 5 却切到了 100),解释器也会将其自动截断到合法边界,而绝不会抛出 IndexError 异常。
三、[:],[::] 与 [::2] 的效果深度对比
下面我们通过具体的代码实验,逐一分析这三种最常见的省略写法的实际运行效果与行为差异。
1. [:] —— 单冒号全量浅拷贝与切片赋值
[:] 只包含一个冒号,它省略了 start 和 stop,同时也没有书写第二个冒号,因此 step 隐式采用默认值 1。
# 示例 1: [:] 的基础取值与浅拷贝验证
fruits = ["apple", "banana", "cherry", "date"]
copy_fruits = fruits[:]

print("提取结果:", copy_fruits)
print("内容是否相等:", copy_fruits == fruits)
print("是否为同一内存对象:", copy_fruits is fruits)

示例输出:
提取结果: ['apple', 'banana', 'cherry', 'date']
内容是否相等: True
是否为同一内存对象: False
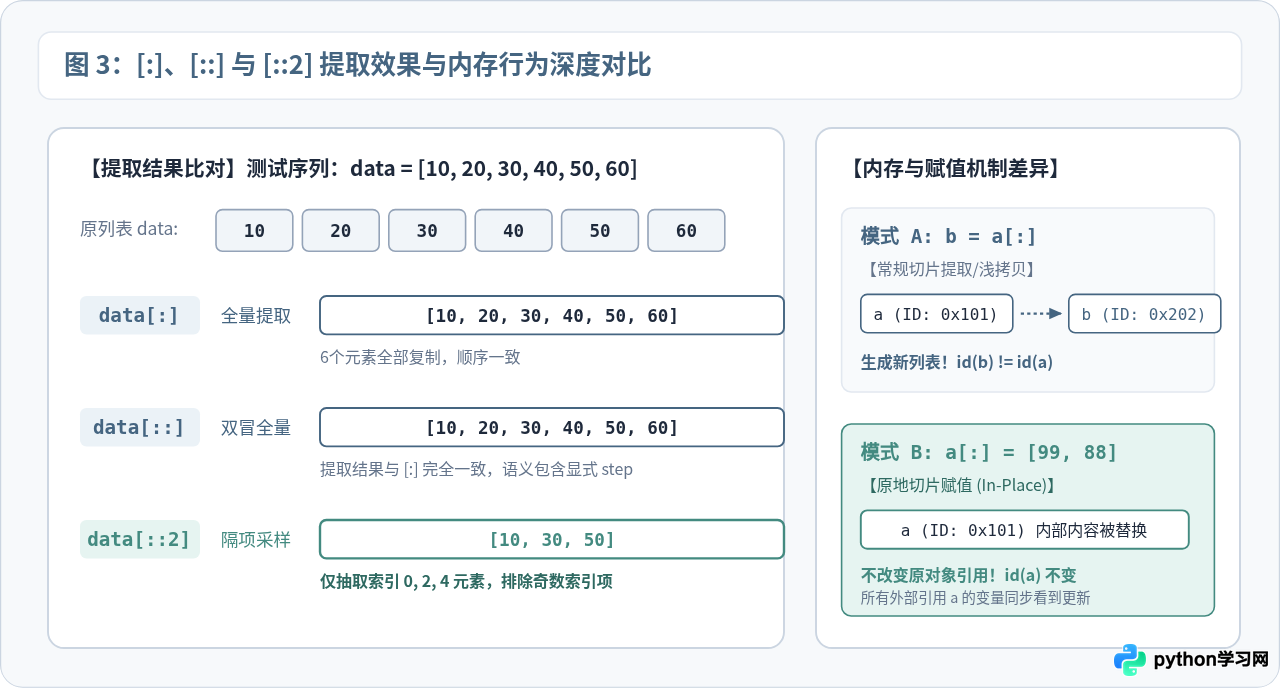
fruits[:] 的提取结果是包含所有元素的新列表。虽然元素内容一致,但 copy_fruits 拥有独立的内存地址。在不需要引入 copy 模块时,[:] 是对一维列表进行浅拷贝最 Pythonic、效率最高的手法。
[:] 不仅能读,还能作为左值赋值。例如 fruits[:] = ["orange", "grape"],这会原地清空并重写原列表的内部内容,而 fruits 对象本身的内存 ID 不发生任何改变。这对于需要向调用方保持引用不变的场景极其重要。
2. [::] —— 双冒号全量占位
[::] 包含两个冒号,它显式保留了步长参数的位置,但由于三个槽位全部未填值,start 缺省为 0,stop 缺省为列表长度,step 缺省为 1。
# 示例 2: [::] 的运行效果
numbers = [10, 20, 30, 40, 50]
result = numbers[::]

print("提取结果:", result)
print("是否与 [:] 结果完全相同:", result == numbers[:])

示例输出:
提取结果: [10, 20, 30, 40, 50]
是否与 [:] 结果完全相同: True
从取值结果来看,numbers[::] 与 numbers[:] 没有任何区别。既然效果一致,为什么 Python 允许写两个冒号?因为 [::] 是完整的 [start:stop:step] 结构,它的主要价值在于为传递可变步长提供语法格式模板,例如通过格式化参数动态填入步长 seq[::step_var]。
3. [::2] —— 跨步跳跃提取(偶数索引项)
[::2] 省略了 start 和 stop,而在第二个冒号之后明确指定 step=2。这意味着它从索引 0 开始,每隔 2 个单位提取一个元素。
# 示例 3: [::2] 隔项取值
digits = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]
sampled = digits[::2]

print("提取结果:", sampled)

示例输出:
提取结果: [0, 2, 4, 6, 8]
由于起点是 0,加上步长为 2,每次命中的索引序列为 0, 2, 4, 6, 8,因此它提取出的是所有偶数索引位置的元素。
只要把起点
start 显式指定为 1,保留终止位置省略并维持步长为 2,写成 digits[1::2],即可命中索引 1, 3, 5, 7, 9。通过 [::2] 和 [1::2],我们可以一行代码完成交错数据的奇偶分离。
四、核心差异归纳与选择指南
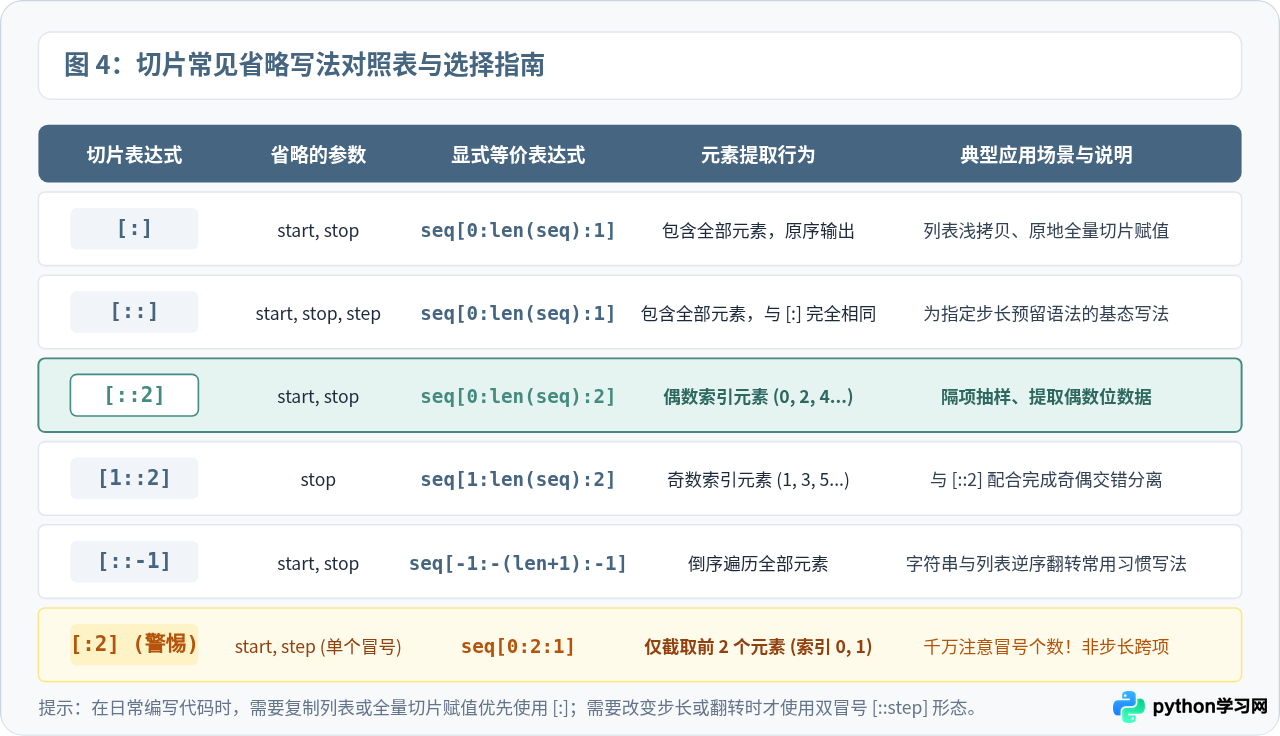
为了让读者在实际编码时快速查阅和准确选择,下表将常见的切片省略写法及容易混淆的变体进行了全面归纳:
| 表达式 | 等价显式写法 | 提取元素范围 | 典型用途 |
|---|---|---|---|
seq[:] |
seq[0:len(seq):1] |
所有元素 | 列表全量浅拷贝;原地切片更新 seq[:] = ... |
seq[::] |
seq[0:len(seq):1] |
所有元素 | 双冒号步长占位,提取结果与 [:] 等价 |
seq[::2] |
seq[0:len(seq):2] |
偶数索引项 (0, 2, 4...) | 隔行抽样、数据降采样、偶数位提取 |
seq[1::2] |
seq[1:len(seq):2] |
奇数索引项 (1, 3, 5...) | 与 [::2] 搭配分离奇偶项 |
seq[::-1] |
seq[-1:-(len+1):-1] |
倒序全部元素 | 列表、字符串快速反转 |
seq[:2] |
seq[0:2:1] |
前 2 个元素 (索引 0, 1) | 截取前 N 项,注意不是隔项提取 |
五、开发中极易混淆的误区与注意事项
[:2] 与 [::2](致命冒号陷阱)很多初学者想实现“隔一个取一个”,不小心漏掉了一个冒号写成了
data[:2]。
data[:2]:只有 1 个冒号,2处在stop位置,表示截取从索引 0 到索引 2(不含 2),最终只返回前两个元素。data[::2]:有 2 个冒号,2处在step位置,表示步长为 2 遍历整个序列。
使用
new_list = old_list[:] 虽然创建了新的列表容器,但属于浅拷贝(shallow copy)。如果列表内部包含字典、子列表等可变对象,新旧列表内部的子对象仍然指向同一块内存空间:
# 示例 4: 嵌套可变对象的浅拷贝限制
nested = [[1, 2], [3, 4]]
cloned = nested[:]

# 修改子列表中的元素
cloned[0].append(99)

print("原列表 nested:", nested)
print("新列表 cloned:", cloned)

示例输出:
原列表 nested: [[1, 2, 99], [3, 4]]
新列表 cloned: [[1, 2, 99], [3, 4]]
从输出可以看到,原列表 nested 内部的第一项也同步发生了变化。如果需要完全隔绝多层嵌套数据的修改,应使用标准库中的 copy.deepcopy(),而不能单靠切片 [:]。
在编写业务逻辑时,切片省略语法的核心原则是“按需省略,语义明确”。全量复制或切片赋值时直接用
[:] 最为清晰简洁;仅在需要调整步进(如隔项抽样 [::2]、逆序翻转 [::-1])或动态传参时,才使用双冒号形态。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















