


Python分块读取大型二进制数据流以避免内存溢出
详细讲解在Python中如何以固定分块方式读取超大型二进制数据流,深入剖析内存溢出机理、缓冲区大小权衡、生成器与iter哨兵机制,并提供哈希计算与流式下载等实用实战模式。
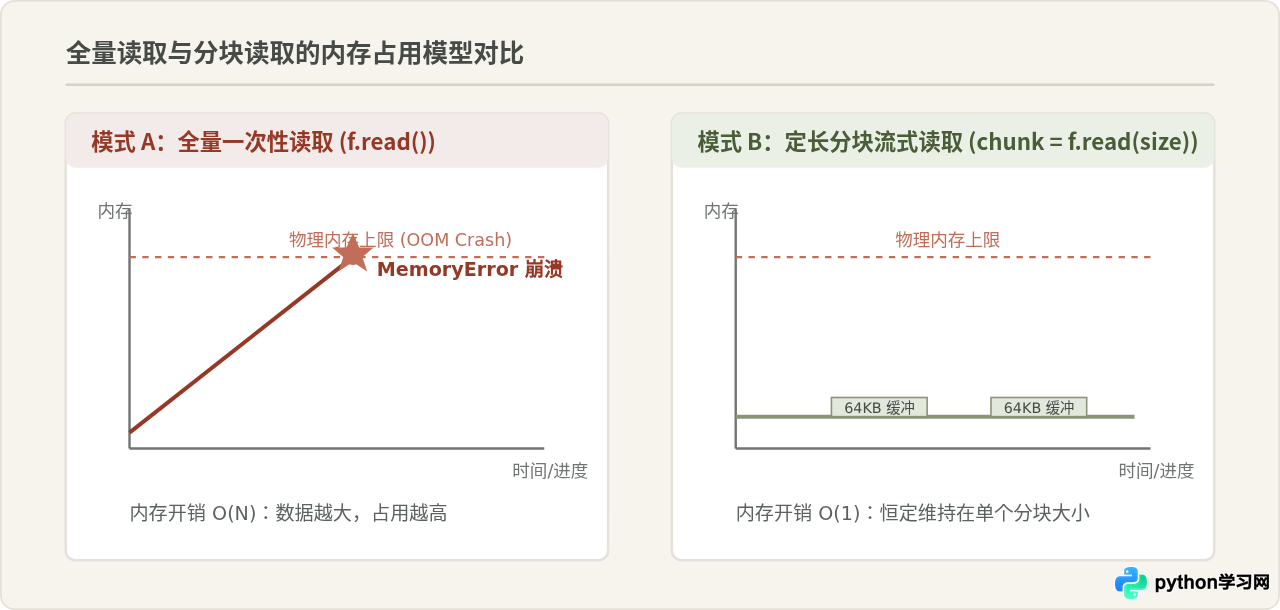
在 Python 中处理几百兆到数十吉字节(GB)的二进制文件或网络流时,最核心的原则是将全量载入转为增量消费:通过以二进制模式('rb')打开输入流,设定固定容量的字节缓冲区(通常为 64KB 至 1MB),每次仅读取并处理一个切片,并在数据消费完成后立即交由解释器回收或覆写。这种分块读取策略将峰值内存开销从随着文件体积无限增长的 $O(N)$ 彻底降为常数级别的 $O(1)$,从根本上杜绝 MemoryError 内存溢出异常。
一、为何全量读取会导致内存迅速溢出
很多初学者或快速脚本在读取文件时习惯直接调用 f.read()。如果目标只是几兆字节的配置或元数据,这种写法非常方便。但在面对大型音视频、虚拟磁盘镜像、系统日志包或机器学习权重等二进制数据流时,这种方式存在极其严重的隐患。
当调用不带参数的 f.read() 时,Python 运行时会向操作系统请求一次性分配能够容纳整个文件体积的连续内存,并将其封装为单个 bytes 对象。若待处理文件体积为 16GB,而运行环境的物理可用内存仅有 8GB,解释器在申请内存阶段便会抛出不可逆的 MemoryError,甚至直接触发操作系统的 OOM Killer 强行杀掉进程。
二、标准实现:使用 while 循环与固定缓冲区
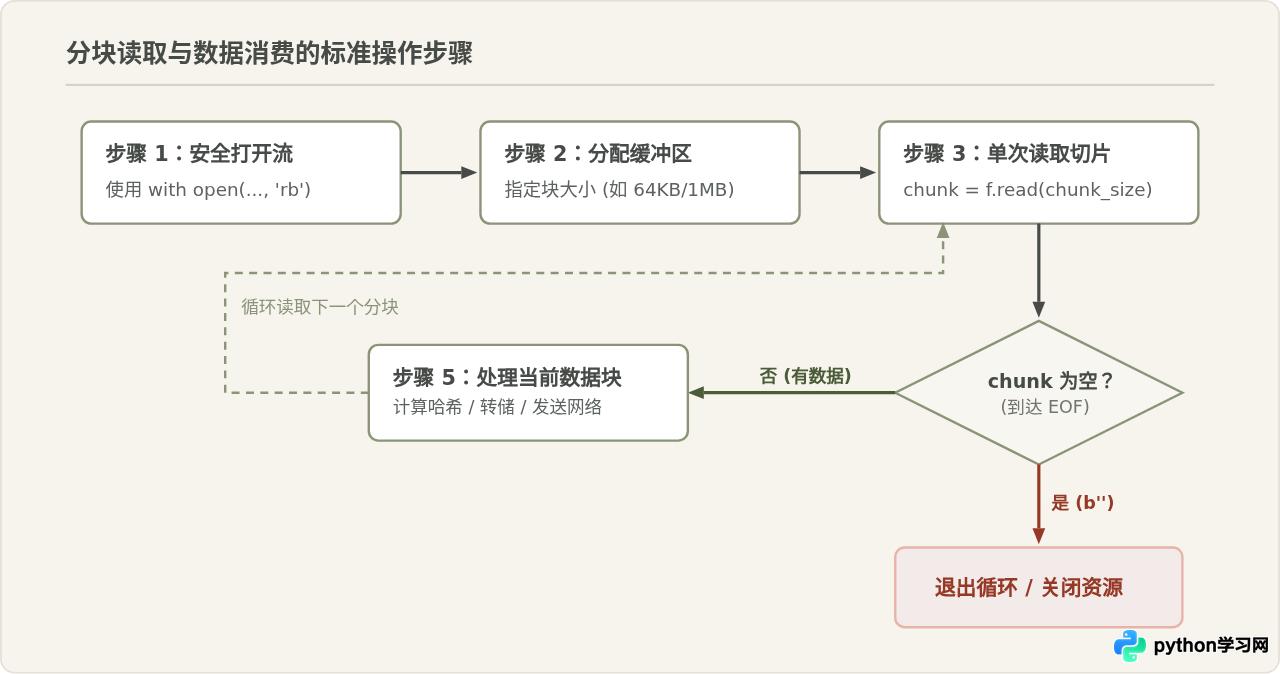
在 Python 中分块读取二进制文件的基本做法非常明确:显式指定只读二进制模式 'rb',在循环体中调用 f.read(chunk_size),并通过判断返回值是否为空字节串 b'' 来识别文件结束符(EOF)。
def process_binary_file(file_path, chunk_size=65536):
    """
    分块读取大型二进制文件并逐块处理
    :param file_path: 文件绝对路径
    :param chunk_size: 单次读取的字节数,默认 64KB (65536 字节)
    """
    with open(file_path, 'rb') as f:
        while True:
            chunk = f.read(chunk_size)
            if not chunk:
                # 当读取到末尾时,f.read() 返回空字节串 b''
                break
            # 在此处执行具体的数据处理,例如哈希计算或网络转发
            handle_data(chunk)

def handle_data(data_block):
    # 示例处理函数:打印当前块长度
    pass
上述代码体现了几个关键要点:
- 上下文管理器
with:确保即使在处理分块期间发生网络超时、格式解析异常或中断,底层的系统文件句柄也能被安全关闭。 - 显式字节模式
'rb':绝不可遗漏'b'。如果以纯文本'r'打开二进制流,Python 会强制执行平台默认的字符解码(如 UTF-8),遇到非文本字节将立即触发UnicodeDecodeError,甚至因换行符转换导致数据损坏。 - 退出条件
if not chunk:在二进制模式下,文件末尾的信号是长度为 0 的空字节串b''。必须使用布尔值取反或len(chunk) == 0判定退出。
三、进阶习惯:利用 iter 哨兵模式构建生成器
虽然 while True 模式功能完备,但在复杂项目中,若将文件读取、条件退出和业务逻辑混在一起,会使函数职责不够清晰。Python 提供了内置函数 iter() 的双参数重载形式:
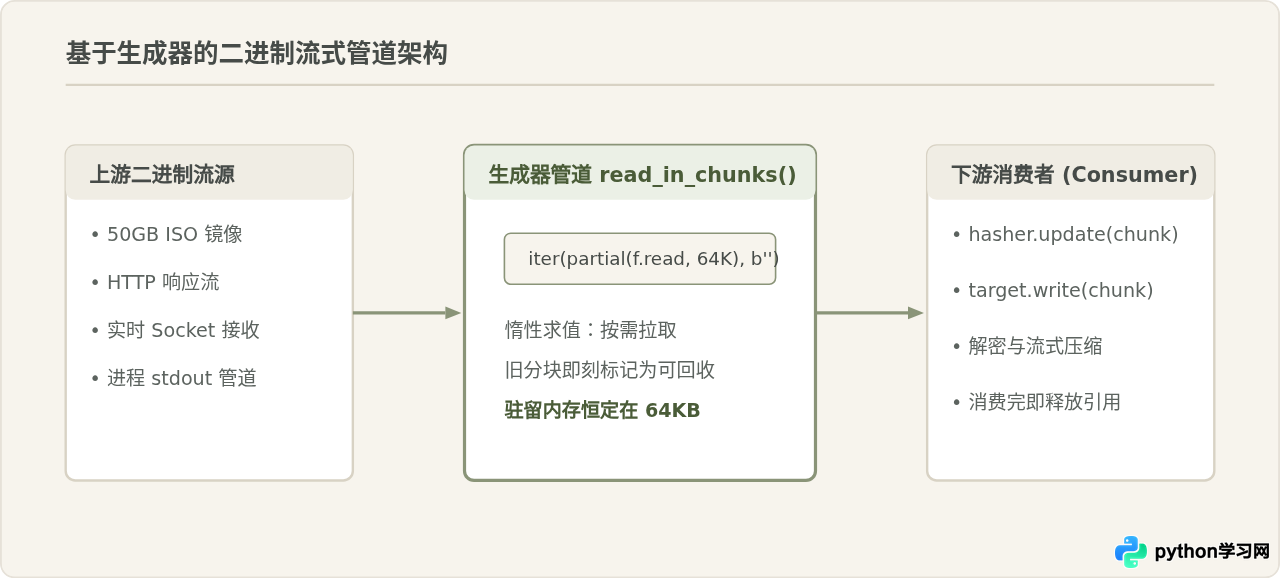
iter(callable, sentinel):传入一个无参数的可调用对象(Callable)以及一个哨兵值(Sentinel)。解释器每次迭代都会调用该对象,一旦返回值等于哨兵值,迭代器立即自动终止并抛出 StopIteration。
结合 functools.partial 或 lambda,可以写出极简且符合 Pythonic 风格的生成器:
from functools import partial

def read_in_chunks(file_object, chunk_size=65536):
    """
    将二进制文件对象转为可迭代的字节块生成器
    """
    # 每次调用 reader() 等价于 file_object.read(chunk_size)
    # 当返回值等于 b'' 时,迭代自动结束
    reader = partial(file_object.read, chunk_size)
    return iter(reader, b'')

# 使用方式清晰易读:
with open("large_disk_image.iso", "rb") as f:
    for chunk in read_in_chunks(f, chunk_size=1024 * 1024):
        # 逐块进行处理,循环语义直观自然
        consumer_process(chunk)
这种封装的最大优势在于解耦:上游函数仅负责以恒定内存产生切片,下游只需使用标准的 for chunk in ... 语法糖。无论是做过滤、计算、压缩还是持久化,业务代码都无需再写任何 while 或状态判断。
四、常见误区与深度辨析
误区 1:在二进制文件中直接使用 for line in f 逐行迭代
for line in f 是官方推荐的流式读取方式,因为它借助底层缓冲区自动以换行符 \n(ASCII 码 0x0A)为界返回每一行。然而,在二进制数据流中,0x0A 只是一个普通的数据字节(例如像素值、音频采样值或内存地址偏置)。如果一个 4GB 的编译归档或加密二进制文件中恰好连续数个 GB 都没有出现 0x0A,解释器为了搜寻行终止符就会不停往内存中累加读取,最终同样退化为全量读取,触发 MemoryError。
误区 2:缓冲区(Chunk Size)设置得越大,I/O 速度就越快
既然分块能省内存,那分块大小到底选多少合适?有些开发者认为“分块越小内存越省,所以选 100 字节”,另一些开发者则认为“分块越大吞吐量越高,所以直接选 500MB”。这两种极端都不可取:
| 缓冲区大小 | 系统调用次数 | CPU 缓存亲和性 | 综合适用场景 |
|---|---|---|---|
| 过小 (< 4KB) | 极多(频繁触发用户态/内核态切换) | 差,开销主要被系统调用吞噬 | 网络低速串口调试 |
| 常规推荐 (64KB ~ 1MB) | 极少(与现代操作系统页缓存完美对齐) | 极佳(契合 CPU L2/L3 高速缓存) | 绝大多数常规文件与网络流(黄金区间) |
| 过大 (> 256MB) | 少 | 差,容易造成瞬时内存毛刺与换页 | 特定的大型顺序吞吐磁盘阵列 |
五、两大典型工程场景实战
1. 计算超大文件的 SHA-256 哈希值
安全与校验场景中经常需要对数百 GB 的安装包进行校验。Python 的 hashlib 库支持增量更新:创建哈希对象后,多次调用 hasher.update(chunk),最终调用 hasher.hexdigest() 即可输出指纹。
import hashlib
from functools import partial

def calculate_sha256(file_path, chunk_size=1024 * 1024):
    """
    流式计算超大文件哈希,内存恒定在 1MB
    """
    hasher = hashlib.sha256()
    with open(file_path, 'rb') as f:
        # 每次读取 1MB
        for chunk in iter(partial(f.read, chunk_size), b''):
            hasher.update(chunk)
    return hasher.hexdigest()

# 示例调用
# print("SHA256:", calculate_sha256("/data/archive.tar.gz"))
2. 网络二进制流的边下边存(不依赖外部库)
从远端服务下载大文件时,若直接使用第三方库的 response.content 同样会使全量数据涌入内存。利用 Python 标准库的 urllib.request,结合分块读取,可以轻松实现“边下边刷入磁盘”,无论目标文件多大,内存开销始终可控。
import urllib.request

def download_large_stream(url, output_path, chunk_size=65536):
    """
    使用标准库将远程二进制流分块写入磁盘
    """
    req = urllib.request.Request(
        url,
        headers={'User-Agent': 'Mozilla/5.0 (StreamDownloader)'}
    )
    with urllib.request.urlopen(req) as response, open(output_path, 'wb') as out_file:
        while True:
            chunk = response.read(chunk_size)
            if not chunk:
                break
            out_file.write(chunk)
六、总结与开发检查清单
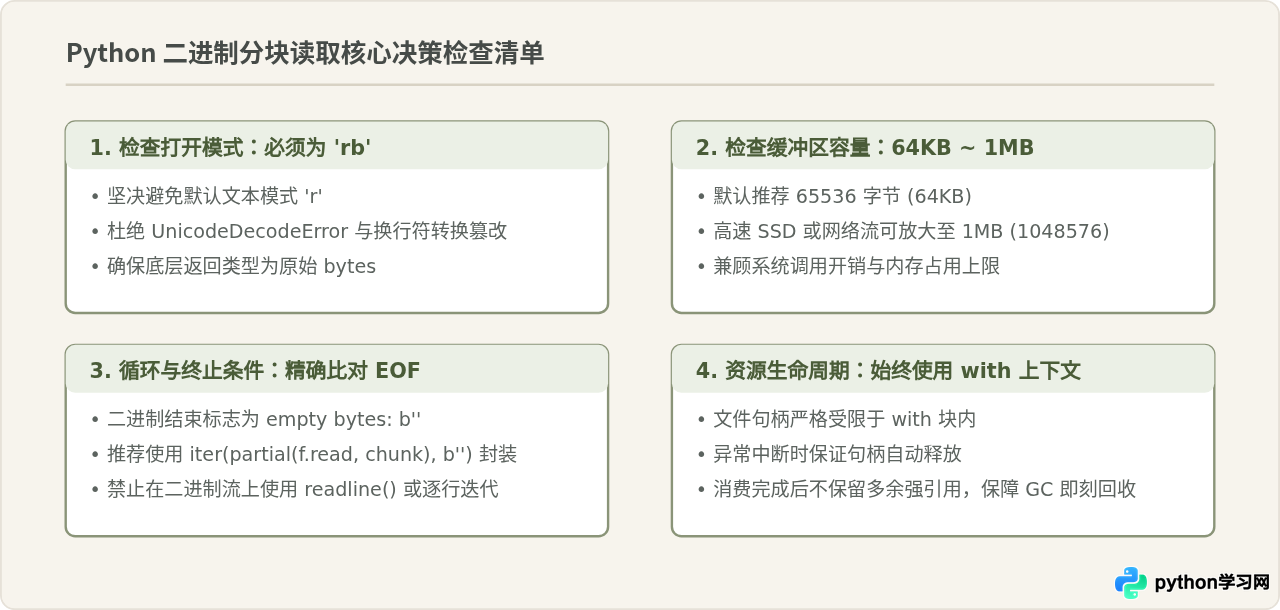
处理大型二进制数据流并不是复杂的黑魔法,而是对底层 I/O 与内存生命周期的敬畏。只要坚持按块消费,便能在资源受限的容器或低配服务器中轻松处理数百倍于内存容量的大数据。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















