


Python压缩图片大小并保持清晰度的技巧
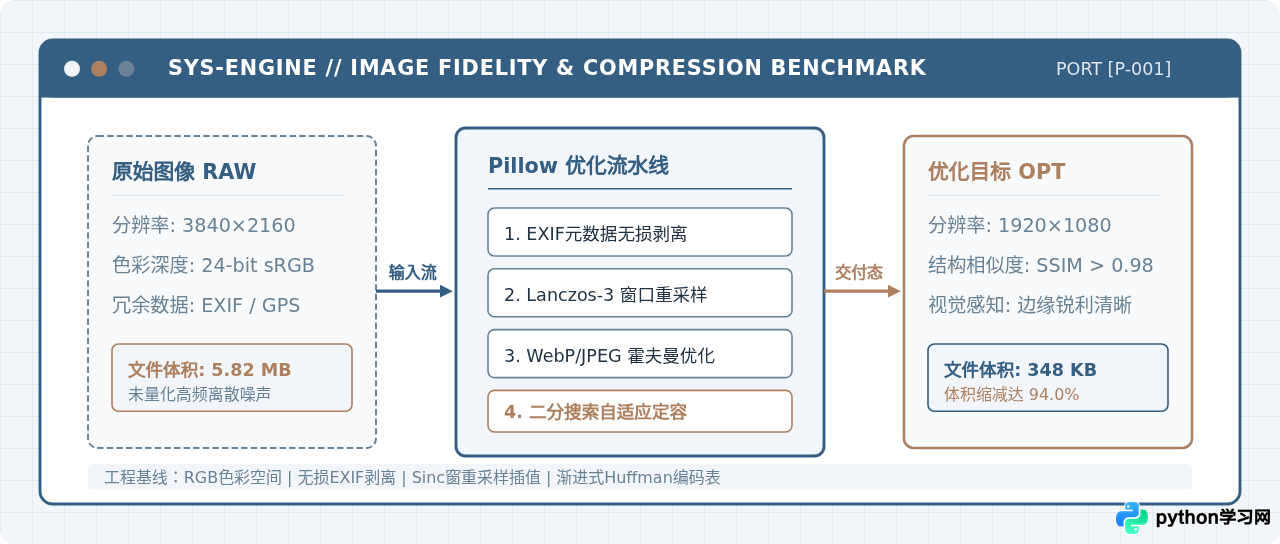
本文详解使用Python压缩图片体积并兼顾高清晰度的实用技巧,包括无损元数据剥离、高保真Lanczos重采样、现代格式WebP转换以及基于二分法的目标体积自适应逼近方案。
一、图片体积构成与无损优化的切入点
很多开发者在面对一张数兆大小的原始照片时,往往直接将保存质量参数调至 30 或 40,结果图片出现了大面积的马赛克与色块边缘模糊。要实现“压缩体积同时保持清晰”,首先需要解构图片在磁盘上的字节组成。
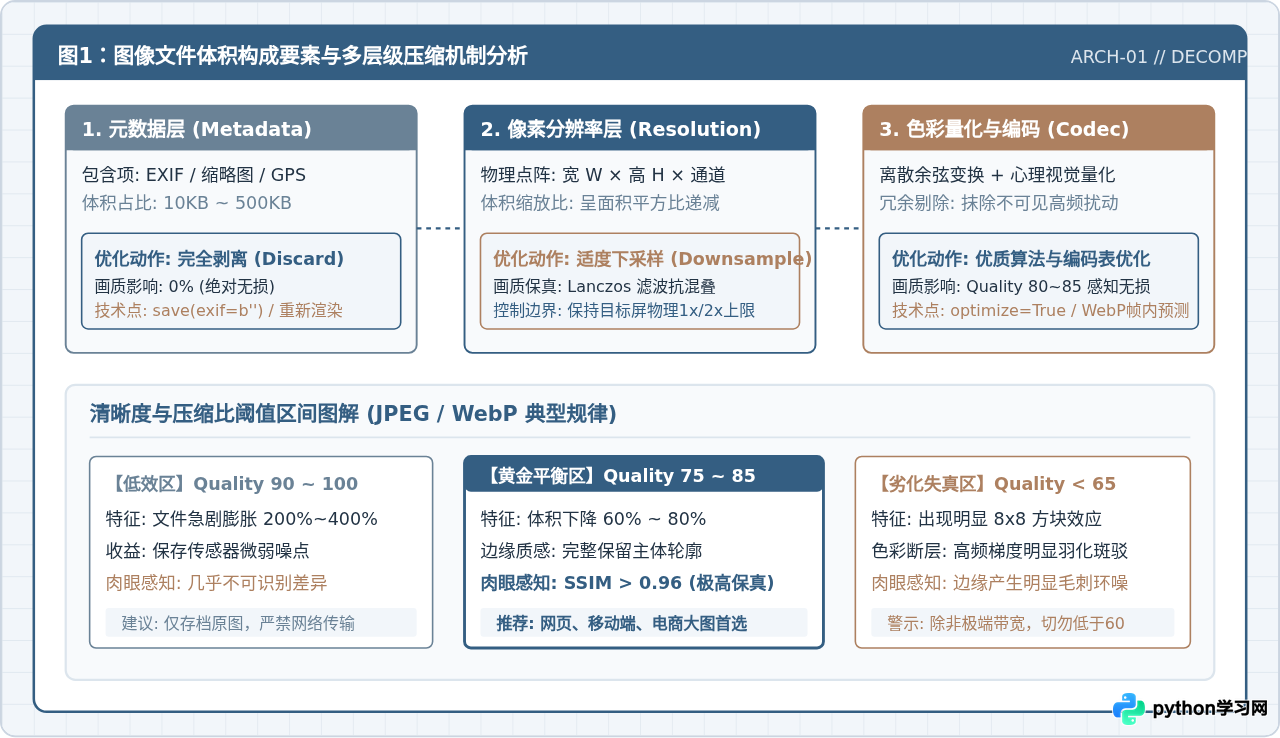
一个标准的图像文件通常包含三个关键层级:
- 元数据层(Metadata):包括相机型号、曝光参数、GPS 地理位置、嵌入式缩略图及 ICC 色彩配置文件。一张未经处理的单反照片或智能手机原图,仅 EXIF 和缩略图就可能占据 50KB 到 500KB 的体积。对于 Web 端展示,这些信息完全是冗余的,剥离它们能带来 100% 绝对无损的体积缩减。
- 物理点阵与分辨率层(Resolution):图像的物理像素总数(宽 × 高)。文件体积与像素总数呈正相关。如果在一块逻辑显示区域只有 800px 的网页中加载 4000px 的原图,额外的像素不仅无法呈现,还会造成浏览器缩放模糊和带宽浪费。
- 色彩量化与频域编码层(Quantization & Codec):JPEG、WebP 等格式通过离散余弦变换(DCT)或帧内预测将图像从空域转至频域,并对人眼不敏感的高频色彩细节进行粗粒度量化,最后进行熵编码(哈夫曼或算术编码)。保持清晰度的核心,就是在量化阶段避开过度抹除高频轮廓。
二、基础优化:无损剥离与编码表重建
在不改变任何图像像素的前提下,Pillow 提供了两个立竿见影的参数:清除 EXIF 元数据以及重构哈夫曼编码树(Huffman Table)。
在 JPEG 标准中,默认采用通用的量化与编码表以节省编码计算时间;而当开启 optimize=True 时,Pillow 会在写入文件前对整幅图像的频域系数进行全量扫描,针对该图像的色彩分布生成一套最优的哈夫曼树。这项操作耗时仅增加数十毫秒,但通常能在画质完全一致的情况下额外节省 5% 至 15% 的文件大小。
from PIL import Image, ImageOps
import os

def lossless_clean(input_path: str, output_path: str) -> None:
    """
    无损优化图片:纠正方向、剥离EXIF并重建最优哈夫曼编码表
    """
    with Image.open(input_path) as img:
        # 1. 在剥离元数据前,基于 EXIF 纠偏方向,防止手机竖拍照片倒转
        img = ImageOps.exif_transpose(img)

        # 2. 转换色彩模式为标准 sRGB(针对RGBA与CMYK做兼容保护)
        if img.mode in ("RGBA", "P"):
            img = img.convert("RGB")
        elif img.mode == "CMYK":
            img = img.convert("RGB")

        # 3. 剥离 EXIF 保存,开启 optimize 与 progressive
        img.save(
            output_path,
            format="JPEG",
            quality=85,          # 85 为肉眼感知无损的黄金阈值
            optimize=True,       # 全量生成最优哈夫曼编码表
            progressive=True     # 启用渐进式扫描,提升大图网页加载体验
        )

# 示例调用
# lossless_clean("camera_raw.jpg", "optimized.jpg")三、尺寸重采样:高保真降采样算法与微锐化
当图片物理尺寸远超展示需求时,缩减分辨率是减少体积最直接的手段。但选择不同的重采样滤镜(Resampling Filter),输出图片的清晰度差异天差地别。
Pillow 提供了多种重采样算法:
Image.Resampling.NEAREST(最近邻):速度最快,但在缩小照片时会直接丢弃像素,产生严重的锯齿和莫尔条纹。Image.Resampling.BILINEAR(双线性插值):仅参考周围 2×2 区域,下采样后整体边缘容易发灰、失焦。Image.Resampling.BICUBIC(双三次插值):参考周围 4×4 区域,计算平滑曲线,表现良好。Image.Resampling.LANCZOS(兰索斯滤波):基于 Sinc 窗函数的高阶插值(参考 8×8 邻域),在下采样时能极其出色地抑制混叠噪点,最大限度保留纤细线条和高频纹理,是保真缩放的首选滤镜。
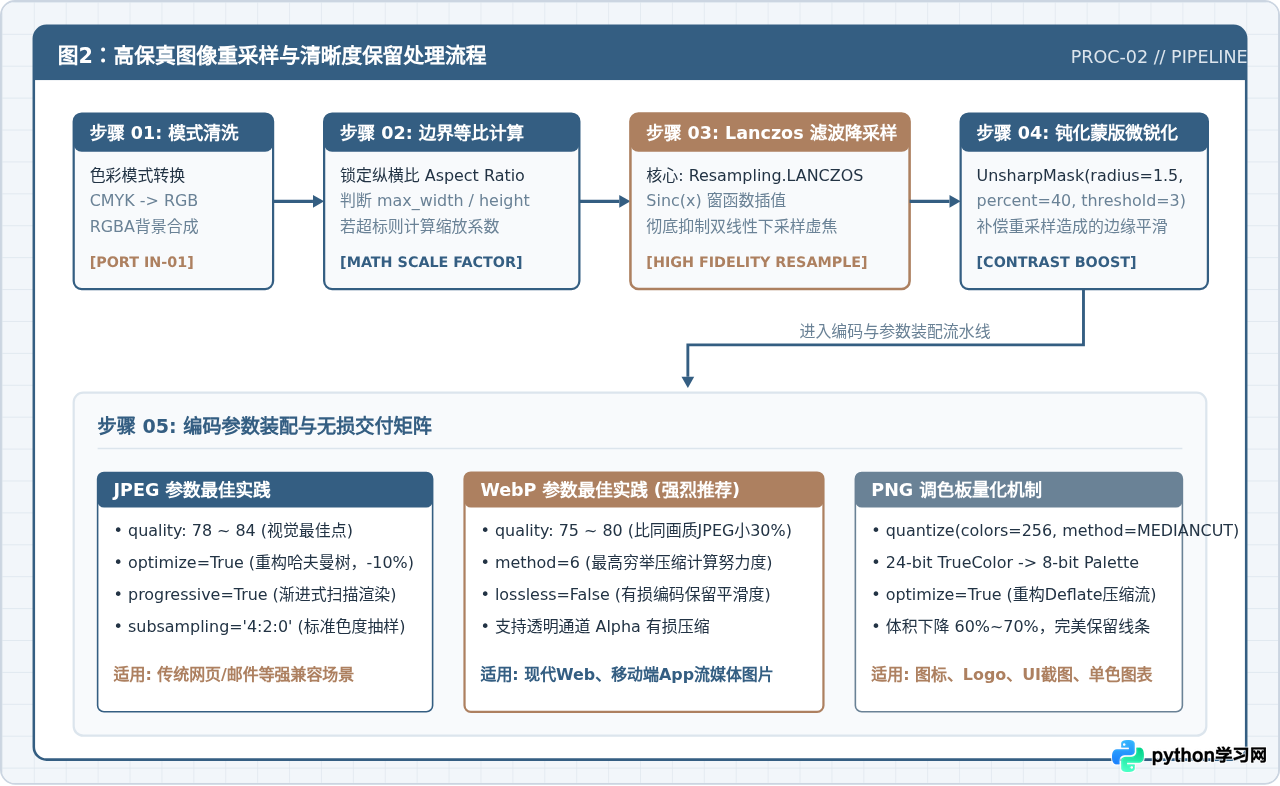
此外,数学上的重采样插值不可避免地会在边缘产生微小的能量扩散(即感知上的轻微“发虚”)。为了弥补这一现象,专业图像处理往往在降采样后附加一层极轻微的钝化蒙版锐化(Unsharp Mask)。它通过增强边缘两侧的高频明暗反差,让缩小后的图片在视网膜屏上展现出“晶莹剔透”的刀锋质感。
from PIL import Image, ImageFilter

def high_fidelity_resize(img: Image.Image, max_width: int, max_height: int) -> Image.Image:
    """
    高保真等比缩放并施加适度边缘锐化补偿
    """
    orig_w, orig_h = img.size

    # 无需缩放则直接返回
    if orig_w <= max_width and orig_h <= max_height:
        return img.copy()

    # 计算严格等比例缩放系数
    scale = min(max_width / orig_w, max_height / orig_h)
    new_w = int(orig_w * scale)
    new_h = int(orig_h * scale)

    # 采用 Lanczos 窗口滤波进行高保真下采样
    resized_img = img.resize((new_w, new_h), Image.Resampling.LANCZOS)

    # 注入轻度锐化补偿:半径1.5像素,强度40%,阈值3阶灰度(防止噪点被放大)
    sharpened_img = resized_img.filter(
        ImageFilter.UnsharpMask(radius=1.5, percent=40, threshold=3)
    )

    return sharpened_img
四、现代格式演进:迁移至高效的 WebP 编码
如果业务场景允许(现代浏览器与移动端客户端对 WebP 的支持率已超过 97%),将格式从传统的 JPEG 或 PNG 转换为 WebP 是最强大的体积压缩利器。
WebP 采用了 VP8 视频编码体系中的帧内宏块预测技术。对于逼真的摄影照片,WebP 有损模式在维持与 JPEG 相同主观质量(SSIM 指标一致)的条件下,体积可以减少 25% 至 35%;对于带有文字和扁平色块的图表,WebP 无损模式比经过最优压缩的 PNG 还能小 26%。
from PIL import Image

def convert_to_webp(img: Image.Image, output_path: str, quality: int = 80) -> None:
    """
    将图像以极高努力程度转码为现代 WebP 格式
    """
    # WebP 完美原生支持 RGBA 透明度及 RGB 模式
    if img.mode not in ("RGB", "RGBA"):
        img = img.convert("RGBA" if "transparency" in img.info else "RGB")

    img.save(
        output_path,
        format="WEBP",
        quality=quality,    # 推荐区间: 75 ~ 82
        method=6            # 压缩努力度等级: 0(最快)到6(最高压缩比),设为6可榨干体积
)quantize() 方法将 1600 万色智能聚类为 256 色的调色板索引图(PNG-8),体积通常能瞬间骤降 60% 至 70%,且矢量图形的边缘完全不会产生毛刺。
五、精准控制:基于二分法的目标体积自适应压缩
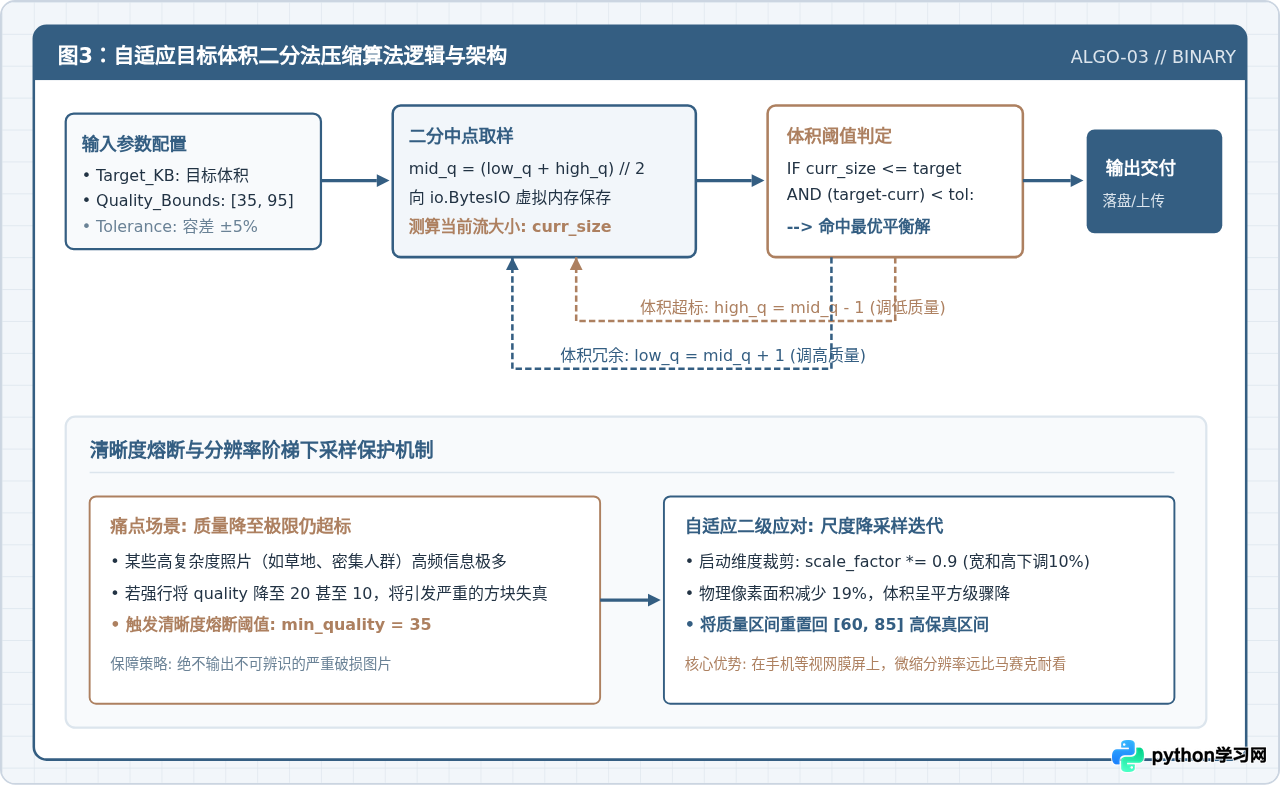
在实际生产业务中,我们经常遇到硬性指标限制:例如“附件大小严禁超过 300KB”、“上传头像必须控制在 150KB 以内”。如果单纯把 quality 写死为 60,对于结构简单的平淡风景图,体积可能会溢出;而对于细节极少的内容,又会造成过度压缩。
为了在满足体积上限的同时输出清晰度最高的版本,最佳算法是基于二分搜索(Binary Search)在内存流中迭代探测最佳 quality。同时,为了防止复杂大图在质量降至下限后依然超标,算法内置了“清晰度熔断机制”:当质量降至 35 时若仍超标,不再继续降低画质,而是自动启动第二维度的等比尺寸缩放。
import io
from PIL import Image, ImageOps

def compress_to_target_kb(
    input_path: str,
    output_path: str,
    target_kb: int,
    min_quality: int = 35,
    max_quality: int = 95,
    tolerance_ratio: float = 0.05
) -> int:
    """
    通过二分法逼近目标文件体积,保障画质优先,必要时启动分辨率下采样保护
    返回最终输出文件的字节大小
    """
    target_bytes = target_kb * 1024
    min_bytes_bound = int(target_bytes * (1 - tolerance_ratio))

    with Image.open(input_path) as src_img:
        img = ImageOps.exif_transpose(src_img)
        if img.mode != "RGB":
            img = img.convert("RGB")

        current_img = img.copy()
        best_buffer = None
        best_size = 0

        # 外层循环:当极端复杂图在最低质量下依然超标时,按比例阶梯下采样
        scale_factor = 1.0
        while True:
            low_q = min_quality
            high_q = max_quality
            iteration_best_buf = None

            # 内层循环:二分搜索质量参数
            while low_q <= high_q:
                mid_q = (low_q + high_q) // 2

                buf = io.BytesIO()
                current_img.save(
                    buf,
                    format="JPEG",
                    quality=mid_q,
                    optimize=True,
                    progressive=True
                )
                curr_size = buf.tell()

                # 如果在容差允许的高精度区间内,直接接受
                if min_bytes_bound <= curr_size <= target_bytes:
                    best_buffer = buf
                    best_size = curr_size
                    break

                if curr_size > target_bytes:
                    high_q = mid_q - 1
                else:
                    # 记录小于目标的最大候选流
                    iteration_best_buf = buf
                    best_size = curr_size
                    low_q = mid_q + 1

            if best_buffer is not None:
                break

            # 若在当前尺寸下找到了合规候选
            if iteration_best_buf is not None and best_size <= target_bytes:
                best_buffer = iteration_best_buf
                break

            # 清晰度熔断保护:降至最小画质仍超标,缩小分辨率 10% 后重新探测
            scale_factor *= 0.9
            orig_w, orig_h = img.size
            new_w = max(int(orig_w * scale_factor), 320)
            new_h = max(int(orig_h * scale_factor), 240)

            # 若尺寸已缩至极限仍无法满足,跳出循环接受现状
            if new_w <= 320 or new_h <= 240:
                best_buffer = buf
                best_size = curr_size
                break

            current_img = img.resize((new_w, new_h), Image.Resampling.LANCZOS)

        # 落盘写入文件
        best_buffer.seek(0)
        with open(output_path, "wb") as f_out:
            f_out.write(best_buffer.read())

return best_size六、生产环境技术选型与避坑指南
在批量处理海量图片的工程流水线中,为了保障代码的健壮性并规避崩溃与色彩偏差,需要特别留意以下细节:
- CMYK 色彩空间崩溃:部分来自印刷系统的图片为 CMYK 模式。如果直接以 JPEG 格式保存为网络流,可能会发生颜色严重偏色或直接报
cannot write mode CMYK as JPEG异常。正确的做法是先执行img.convert('RGB')。 - 透明通道底色变黑:PNG 的 RGBA 格式如果强行保存为不支持 Alpha 的 JPEG,透明部分默认会变为纯黑。若必须转成 JPEG,应先创建一个纯白色的背景图层进行 Alpha 混合:
# 规范处理 RGBA 转 RGB 避免黑底 if img.mode == 'RGBA': background = Image.new('RGB', img.size, (255, 255, 255)) background.paste(img, mask=img.split()[3]) # 提取 Alpha 通道作为蒙版 img = background - 手机竖拍角度翻转:现代智能手机拍摄的照片,往往在传感器层面保持横向物理存储,仅在 EXIF 中打上
Orientation旋转标记。若直接剥离 EXIF,图片将呈现 90° 或 180° 的倒立翻转。务必在最开始调用ImageOps.exif_transpose(img)。 - 高并发性能优化:图片解码与重采样是标准的 CPU 密集型任务。在 Python 中,由于 GIL(全局解释器锁)的存在,批量处理时不建议使用多线程(
threading),而应采用multiprocessing.Pool或concurrent.futures.ProcessPoolExecutor充分利用服务器多核算力。
七、方案效果对比与总结
为了直观评估各种策略的收益,下表展示了一张典型的 2400×1600 单反摄影原图在不同压缩流程下的指标表现:
| 处理阶段与策略 | 典型体积 | 相对压缩率 | SSIM 结构相似度 | 主观视觉质量评估 |
|---|---|---|---|---|
| 原始原图(含完整EXIF) | 4.85 MB | 基准 (0%) | 1.000 | 原始未压缩状态 |
| 纯无损优化(剥离EXIF + 优化哈夫曼) | 3.92 MB | -19.2% | 1.000 | 100% 绝对无损,细节分毫不差 |
| 等比降采样至 1920×1280 (Lanczos) | 1.85 MB | -61.9% | 0.992 | 适应常规屏,线条平滑无混叠 |
| 高质量 JPEG (Quality 82 + 渐进式) | 420 KB | -91.3% | 0.975 | 边缘锐利,无明显色块感知 |
| 现代 WebP 转码 (Quality 80, Method 6) | 285 KB | -94.1% | 0.978 | 色彩过渡极其平滑,体积最小 |
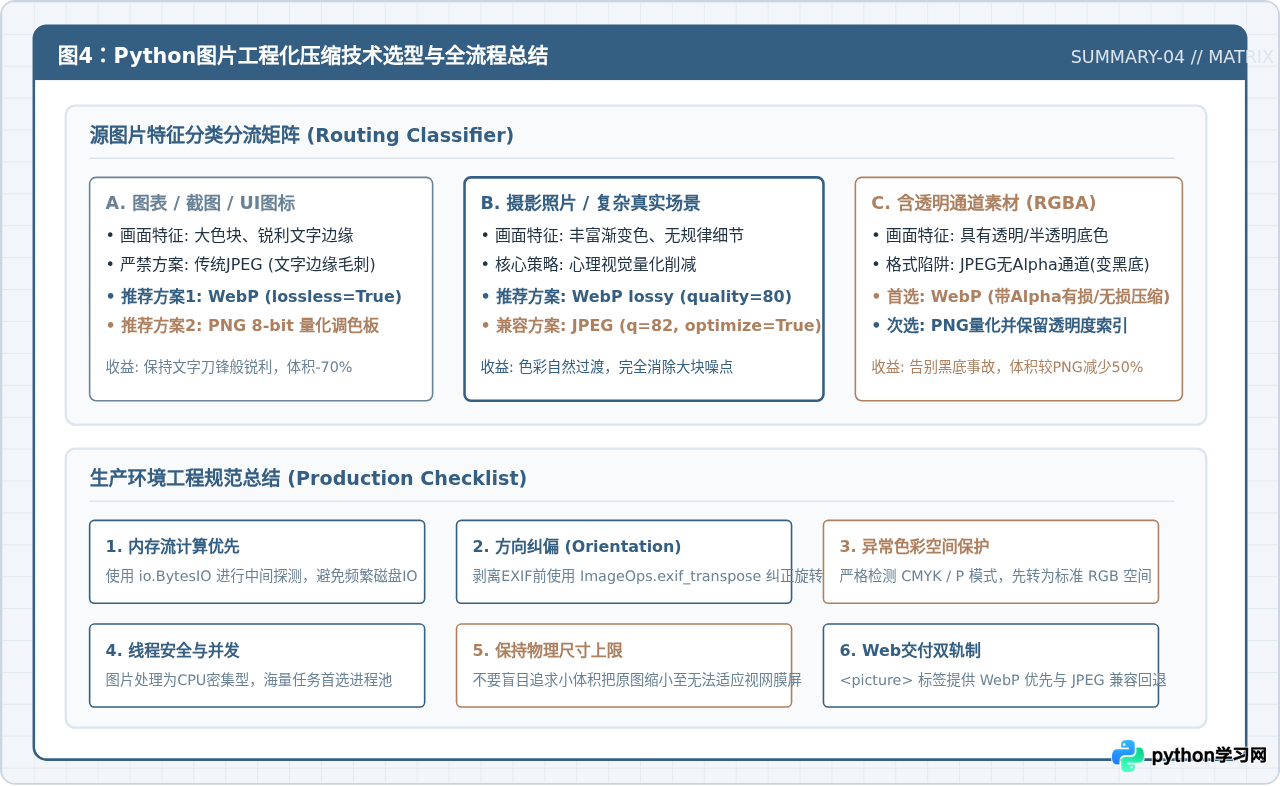
综上所述,在 Python 环境下实现“高压缩比”与“高清晰度”的兼顾,关键在于建立起多维协同的优化流水线:以 ImageOps.exif_transpose 与 convert('RGB') 作为鲁棒性前置,以 Resampling.LANCZOS 与钝化锐化作为尺度调控,以 optimize=True 与现代 WebP 格式作为数据压缩底座,再配合二分搜索机制精准守住业务体积线。这套标准流程能够在最大化释放网络带宽与存储空间的同时,为终端用户交付极其清晰细腻的视觉体验。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















