


Python元组是什么:不可变特性与列表的核心区别
深入解析Python元组的定义、不可变机制以及与列表在内存结构、性能、语义与哈希性上的核心差异,帮助开发者准确理解并合理选型。
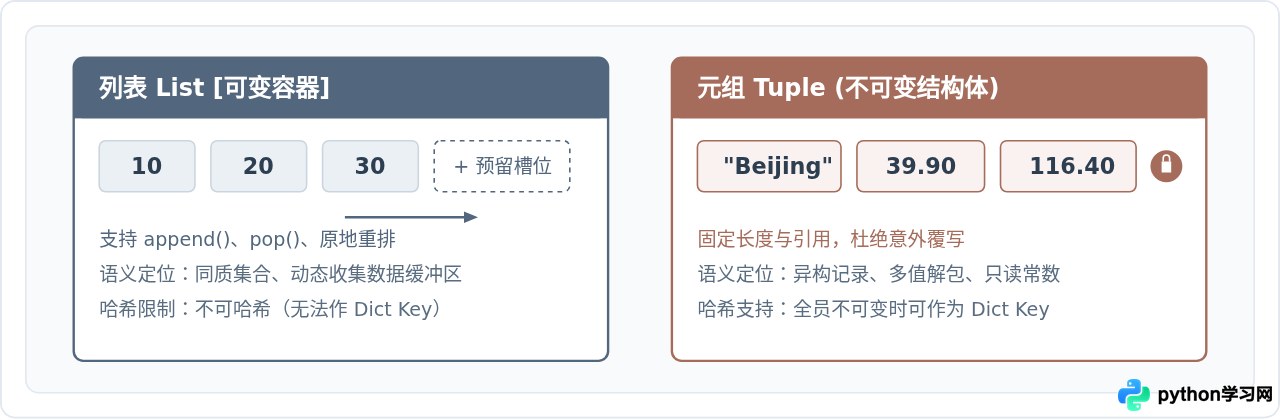
在 Python 中,元组(tuple)是一种由逗号分隔、长度固定且不可就地修改的有序序列。它与列表(list)在外表上极为相似,都能按索引存储多个元素,但两者的底层定位完全不同:列表是专为动态变更而设计的可变容器,而元组则通过不可变特性保障数据完整性、降低内存开销,并天然支持字典键与集合运算。本文将直面两者的设计差异与关键运行机制。
一、元组的本质:形式、创建机制与语法陷阱
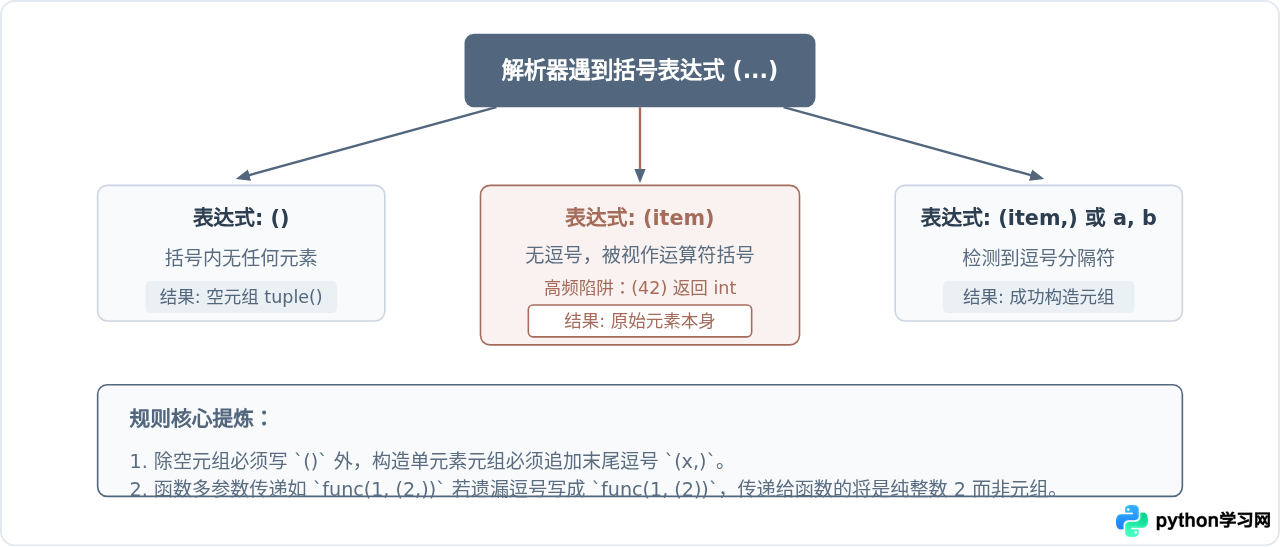
在书写 Python 代码时,许多初学者习惯将“小括号”当作元组的绝对标志。然而在 Python 语法解析器中,真正定义元组的符号是逗号(,),而不是小括号。小括号的主要功能是消除表达式优先级歧义,或者在定义空元组时充当语法占位符。
# 示例 1:创建元组的常见方式
empty_tup = ()              # 空元组:必须使用成对圆括号
coords = 10, 20             # 省略括号:逗号自动触发元组打包 (Tuple Packing)
standard_tup = (1, 2, 3)    # 常用写法:带括号提高代码可读性

print(type(coords)) # 输出示例:<class 'tuple'>这种“逗号优先”的机制带来了一个极其高频的代码隐患:单元素元组的定义。如果你在圆括号中只写一个数字或字符串而不加逗号,Python 会将其判定为数学运算中的分组括号,表达式的值依旧是原始对象本身。
# 示例 2:单元素括号判定区别
val_a = (42)     # 无逗号:被当作普通算术括号
val_b = (42,)    # 带有逗号:构造单元素元组

print(type(val_a))  # 输出示例:<class 'int'>
print(type(val_b))  # 输出示例:<class 'tuple'>
同样地,元组支持灵活的解包(Unpacking)操作。函数返回多个结果时的本质就是返回了一个打包元组,调用方可以一次性将其分发给多个变量。
二、不可变特性的底层真相:究竟什么“不能改”?
元组最常被提及的特征是“不可变”(Immutable)。直观表现是:你不能像列表那样调用 append()、extend()、remove(),也不能通过下标直接更改元素。
# 示例 3:试图原地修改元组元素会抛出异常
fruits = ("apple", "banana", "cherry")

# 尝试赋值修改第一个元素
try:
    fruits[0] = "orange"
except TypeError as err:
    print("捕获异常:", err)
    # 示例输出:捕获异常: 'tuple' object does not support item assignment
这个机制在日常使用中非常直白,但许多开发者在面对“包含可变对象的元组”时,往往会产生困惑。例如下面这段代码:
# 示例 4:包含列表的元组
data = (100, [1, 2])

# 尝试修改列表内部的元素
data[1].append(3)
print(data)  # 输出示例:(100, [1, 2, 3])
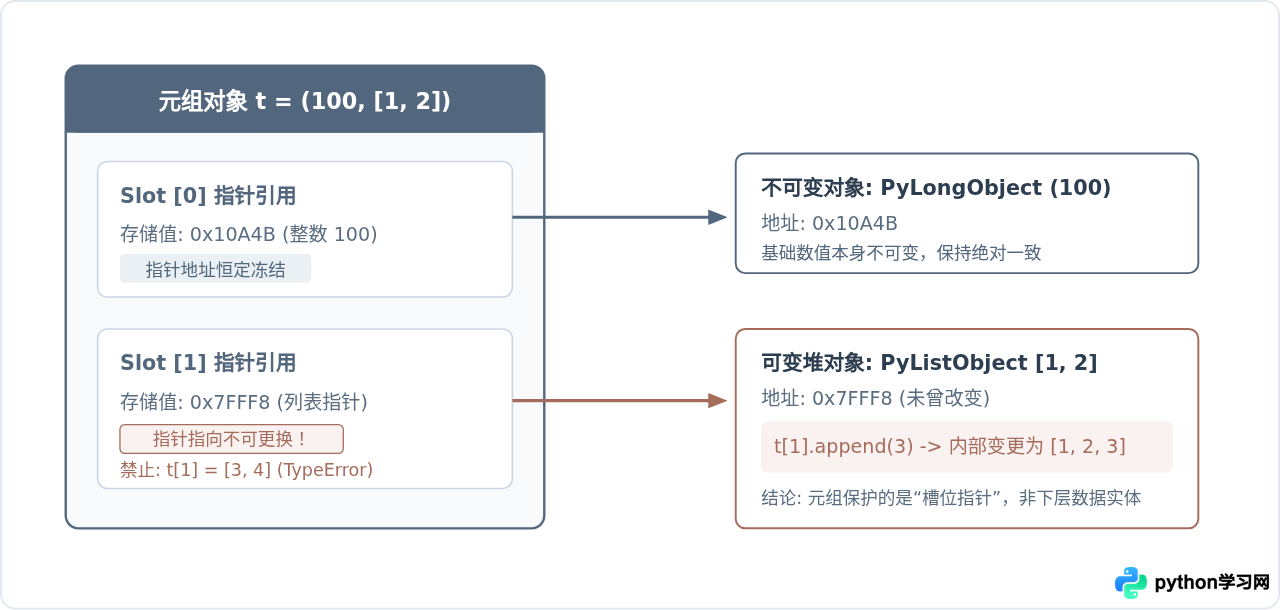
为什么 data 是元组,其内容却被修改了?这涉及到 Python 底层的对象存储模型:
- 元组的物理本质:元组结构体在内存中保存的是一组连续的内存对象指针(引用)。
- 不可变的边界:元组的“不可变”仅指这些槽位所存储的指针地址不能被替换或重新指向新的对象。
- 间接可变性:如果槽位指向的是一个可变对象(如
list、dict),该对象自身在堆内存中的内容依然可以变更,但指针本身的数值(内存地址)从未改变。
执行 t = (1, [2]); t[1] += [3] 会引发神奇的“既报错又生效”现象:TypeError 抛出(因为 += 试图将相加后的结果写回元组槽位 t[1]),但列表原地的 extend 已经执行完成,导致 t[1] 变成了 [2, 3]。因此,请严格避免在元组内放置可变容器。
三、元组与列表的核心区别
表面上看,元组和列表都支持按下标访问、切片读取、for 循环迭代以及 len() 计数。很多初学者容易将它们视作“带不带只读保护的同一种数组”。但事实上,Python 在 C 语言底层对两者的实现构架存在根本性分野。
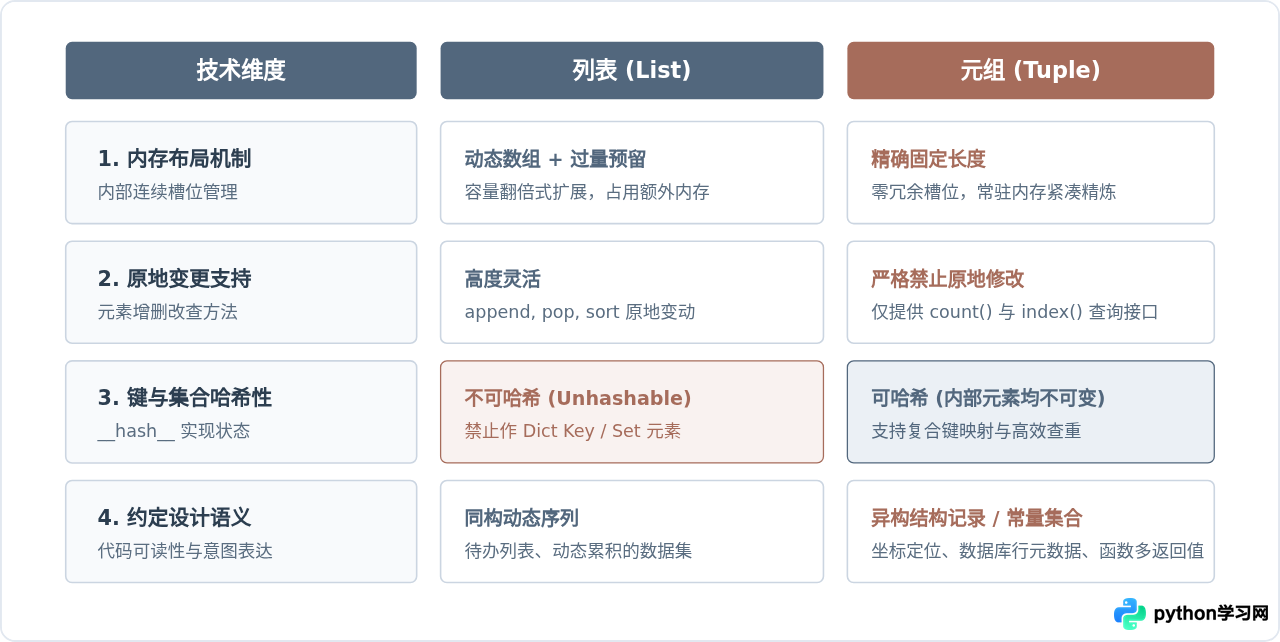
1. 内存分配与内部结构差异
列表是动态数组(Dynamic Array)。为了保证 append() 操作在多数情况下达到分摊 $O(1)$ 的时间复杂度,列表采用了过分配(Over-allocation)机制。这意味着一个容量为 4 的列表在追加第 5 个元素时,Python 往往会一次性在内存中开辟 8 或更多个连续槽位,未使用的槽位作为冗余预留。
相反,元组是定长只读数组。它在实例化时便精确得知元素的总个数,因此只会按需分配刚好容纳这些指针的内存空间,绝不留存任何闲置冗余槽位。
# 示例 5:验证列表与元组的内存开销
import sys

empty_list = []
empty_tuple = ()

list_data = [1, 2, 3, 4]
tuple_data = (1, 2, 3, 4)

print("空列表内存字节:", sys.getsizeof(empty_list))    # 示例输出: 56
print("空元组内存字节:", sys.getsizeof(empty_tuple))   # 示例输出: 40
print("4元素列表字节:", sys.getsizeof(list_data))     # 示例输出: 88
print("4元素元组字节:", sys.getsizeof(tuple_data))    # 示例输出: 72
此外,CPython 内部对元组有全局的空元组单例优化和小元组缓冲池(freelist)优化。创建和销毁极小规模元组(如 1~20 长度)的速度通常高于列表,且减少了系统调用 malloc 的开销。
2. 可哈希性(Hashability)与字典键
这是元组在工程中最具实用价值的区别之一。在 Python 中,字典(dict)的键和集合(set)的元素都依赖哈希表进行 $O(1)$ 寻址。
- 列表不可哈希:列表的内容随时可能被修改,若作为键,其哈希值改变会导致在字典桶中无法再次寻回,因此 Python 显式禁用了列表的
__hash__方法,调用hash([1, 2])会直接抛出TypeError: unhashable type: 'list'。 - 元组可哈希(在元素全可哈希的前提下):只要元组内部的每一个元素也是不可变且可哈希的(例如由纯数字、字符串、其他纯元组组成),该元组就具备确定性的哈希值,可以安全地作为字典的键。
# 示例 6:元组作为字典键的应用场景
# 典型场景:网格二维坐标、多字段复合索引
point_map = {
    (0, 0): "原点",
    (10, 20): "目标点 A",
    (30, 45): "目标点 B"
}

print(point_map[(10, 20)])  # 正常寻址输出: 目标点 A

# 若元组内部嵌套了列表,则不可哈希
invalid_tup = (1, [2, 3])
try:
    hash(invalid_tup)
except TypeError as e:
    print("错误提示:", e)  # 示例输出: 错误提示: unhashable type: 'list'
3. 设计语义与表达意图
除了技术指标外,两者的语法哲学差异显著:
- 列表代表“同质集合”(Homogeneous Collection):列表中通常存放同类型的一群事物(例如一列用户 ID、一组传感器读数)。元素的顺序通常代表业务队列或排序关系,增删元素不会破坏列表本身的含义。
- 元组代表“异质记录”(Heterogeneous Record):元组更像 C 语言中的轻量级
struct。位置(索引)本身往往携带了属性语义。例如("Alice", 28, "Engineer")中,索引 0 代表姓名,索引 1 代表年龄,索引 2 代表职业。删除或追加一个位置会直接破坏这条记录的数据结构。
四、选型判断:何时使用元组,何时选用列表?
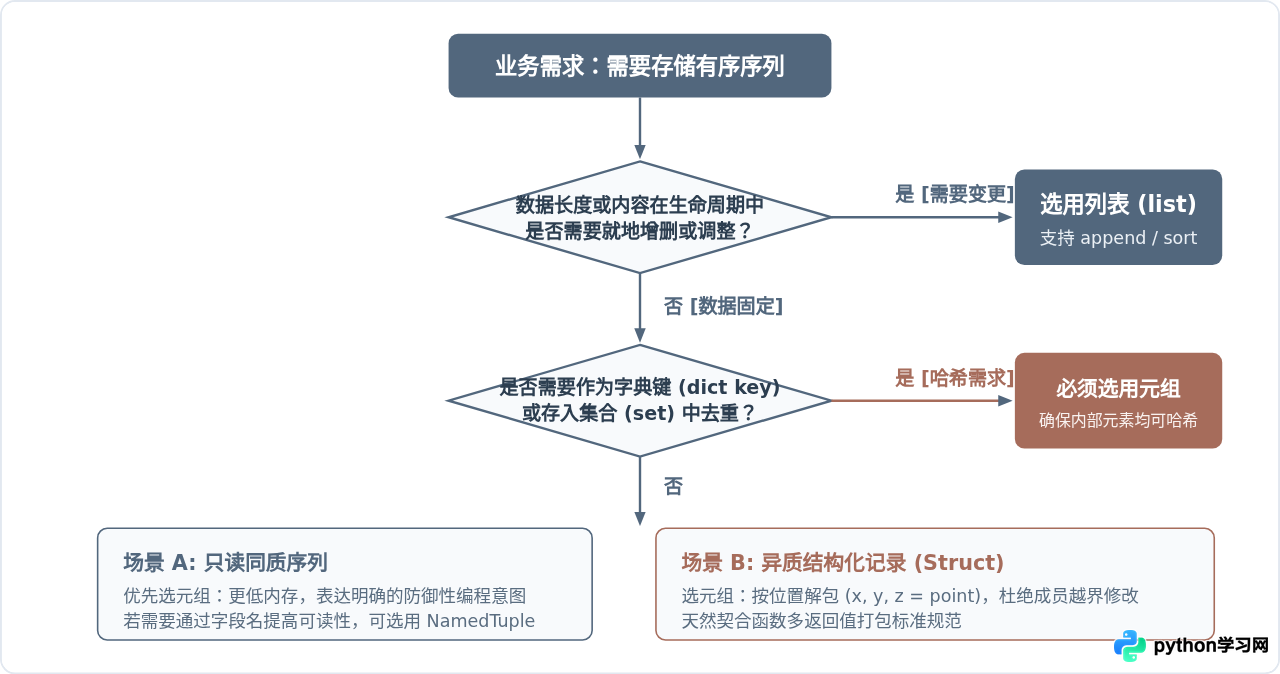
编写实际代码时,很多开发者因为列表接口丰富,往往下意识地将所有序列都声明为列表。但只要按照以下三个关键决策点进行梳理,就能迅速确定最恰当的容器类型。
| 场景需求 | 推荐类型 | 技术依据与收益 |
|---|---|---|
| 数据在运行期频繁增删、过滤、重新排序 | 列表 (list) |
列表具备高效的平摊扩容接口与内置原地排序(Timsort),无需反复生成新对象。 |
| 表示结构固定的单条记录(如坐标、RGB 色值、用户信息三元组) | 元组 (tuple) |
每个索引位置承载特定语义,不可变性避免团队成员在下游处理函数中意外改写局部属性。 |
| 需要作为字典的复合键或存入集合 | 元组 (tuple) |
列表无法通过哈希校验;不可变元组支持确定性哈希计算,适用于表格坐标或多字段映射。 |
| 大量只读常量字典或函数返回值多项传递 | 元组 (tuple) |
内存开销更小,利用 CPython 内部缓存池加速创建与回收,并且向外部调用者明确表达“只读”契约。 |
如果元组字段较多、通过数字索引访问容易混淆(例如 user[3] 难以直观看出含义),可以进一步使用标准库中的 collections.namedtuple 或 typing.NamedTuple。它们既拥有元组轻量、不可变、可哈希的特性,又允许通过属性名(如 user.email)访问成员,兼顾性能与可读性。
五、常见问题与典型误区速查
1. 执行 t = t + (4,) 为什么没有报错?
元组不能修改,但重新绑定变量不等于修改原有对象。执行 t = t + (4,) 时,Python 在底层计算 t + (4,) 并申请开辟了一块全新的内存空间存储合并后的新元组,最后让变量名 t 指向新地址。原有元组如果不再被引用,将被垃圾回收器清理。这与列表调用 l.append(4) 在原内存地址就地扩容有着本质区别。
2. 既然元组不可变,为什么支持切片?
对元组执行切片操作(例如 t[1:3])并不会修改原元组,而是从原元组中复制对应的引用指针,生成一个全新的切片子元组。原元组及其元素毫发无损。
3. 列表转换为元组、元组转换为列表的代价如何?
使用 tuple(my_list) 或 list(my_tuple) 进行类型转换时,时间复杂度均为 $O(n)$。Python 会线性遍历原始序列,并将各元素的引用逐个复制到新创建的目标容器中。因此,在性能敏感的高频循环内部,应尽量避免频繁进行无谓的相互转换,建议在数据产生源头即确定最契合的容器类型。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















