


Python中map函数与列表推导式哪个更好用

map(int, str_list))或需要利用迭代器进行惰性求值以节约内存的场景,map 函数会更简洁高效。
一、核心机制差异:即时求值 vs 惰性迭代
要判断两者哪个更好用,首先需要理解它们在底层运行机制上的根本差异。列表推导式与 map 并不是简单的语法糖替代关系,它们在对象的生命周期与内存驻留方式上截然不同。
列表推导式采用的是即时求值(Eager Evaluation)。在代码执行到推导式的那一刻,Python 解释器会立即执行循环与计算,在堆内存中申请空间并构建出一个完整的 list 对象。无论输入数据规模有多大,推导式都会在当行代码结束时将所有结果加载完毕。
而 map 函数在 Python 3 中采用的是惰性求值(Lazy Evaluation)。执行 map(func, iterable) 时,解释器仅仅返回一个轻量的 map 迭代器对象,此时并没有发生实质性的元素计算,也没有在内存中分配结果列表。只有当程序后续通过 for 循环、next() 函数或显式包装 list() 去消费它时,元素才会被按需单步计算出来。
# 列表推导式:立即生成完整列表
squared_list = [x * x for x in range(5)]
print(type(squared_list))  # <class 'list'>
print(squared_list)        # [0, 1, 4, 9, 16]

# map 函数:返回迭代器对象,不立即计算
squared_map = map(lambda x: x * x, range(5))
print(type(squared_map))   # <class 'map'>
print(squared_map)         # <map object at 0x...>
print(list(squared_map))   # [0, 1, 4, 9, 16]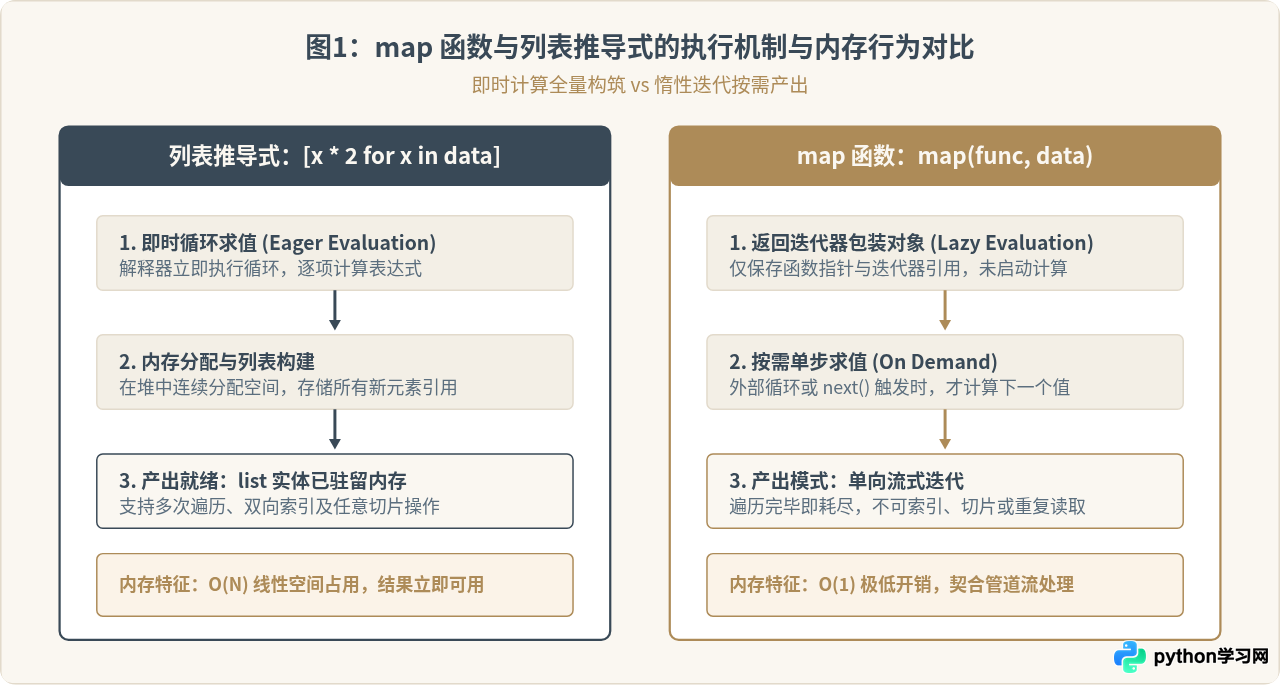
二、可读性与表达力对比
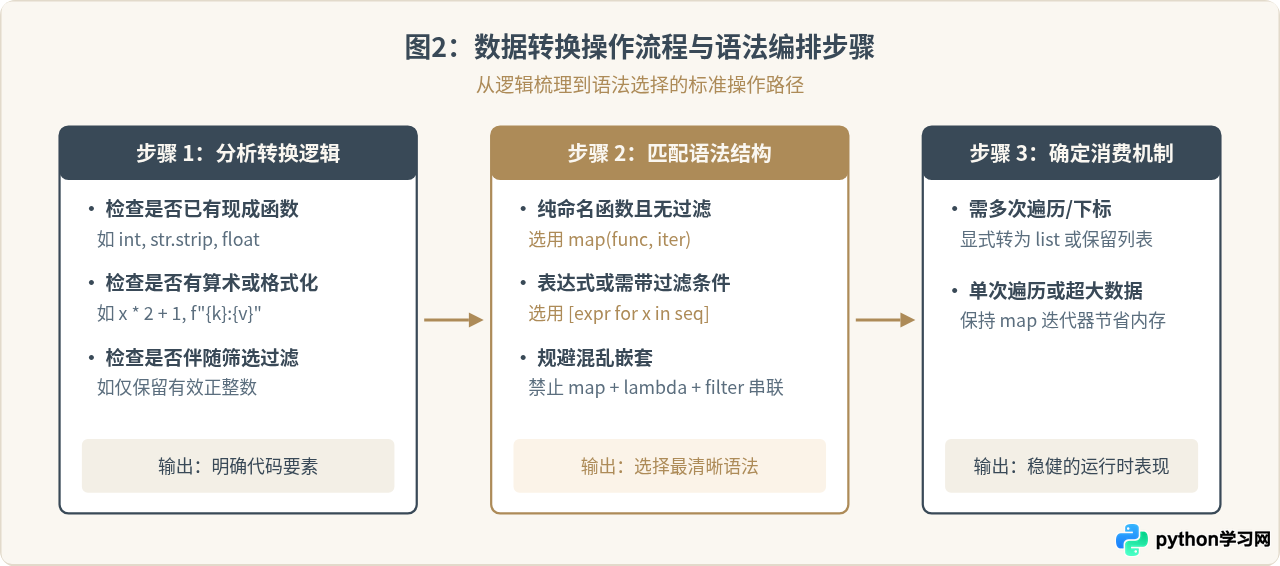
代码的可读性往往决定了团队协作的效率与长期维护的成本。在这方面,两者的表现取决于操作是否需要额外的匿名函数。
1. 简单表达式:推导式更加自然直观
当需要对数据进行算术运算、属性提取或自定义格式转换时,列表推导式的语法结构非常贴近自然英语逻辑(“对我想要的元素做变换,来自原始数据”)。而 map 必须借助 lambda 表达式才能完成类似工作,引入了额外的语法杂音。
prices = [10.5, 20.0, 35.8, 42.1]

# 列表推导式:简洁清晰,语义连贯
discounted_1 = [round(p * 0.9, 2) for p in prices]

# map + lambda:多层嵌套与参数声明
discounted_2 = list(map(lambda p: round(p * 0.9, 2), prices))
在上述对比中,推导式省去了 list(...) 和 lambda p: 的冗余声明,阅读体验明显更为流畅。
2. 复用已有命名函数:map 更加干练
如果转换逻辑已经有成熟的内置函数或自定义函数,map 的表现就会逆转。它可以直接接收函数名作为参数,不需要声明临时变量名。
raw_ids = [" 101 ", "204\n", " 309", "405 "]

# map 直接传入命名函数:干净利落
clean_ids_map = list(map(str.strip, raw_ids))

# 列表推导式:必须显式起一个临时变量名 x
clean_ids_comp = [x.strip() for x in raw_ids]在此类典型的数据清洗场景中,map(int, numbers) 或 map(str.lower, words) 省略了中间变量的命名负担,既简洁又符合函数式编程范式。
三、功能扩展性:条件过滤与多序列处理
1. 条件过滤(Filtering)
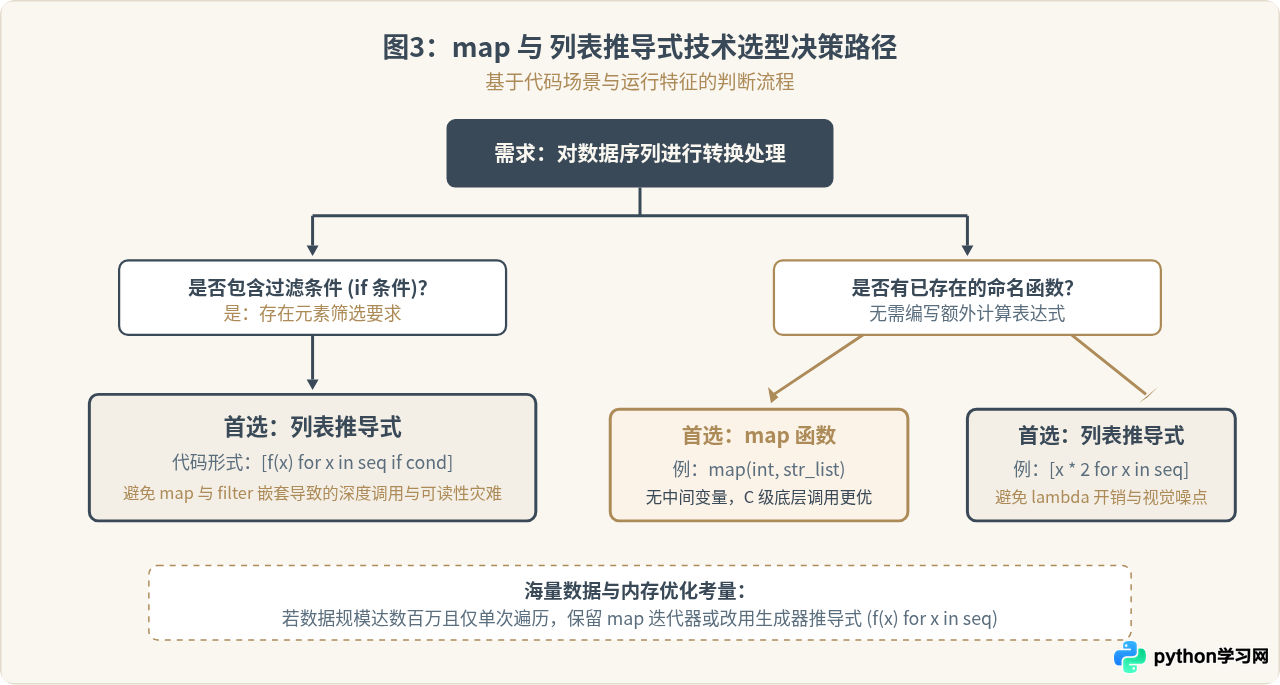
现实业务中的数据转换往往伴随着数据清洗和过滤要求(例如只处理正数、去除空字符串)。列表推导式原生支持 if 子句,语法极为自然:
raw_data = [-5, 12, 0, -8, 23, 40]

# 列表推导式:转换与过滤一气呵成
positive_doubled = [x * 2 for x in raw_data if x > 0]
# 结果: [24, 46, 80]相比之下,map 函数本身完全不具备过滤功能。如果非要用函数式编程处理带过滤的逻辑,就必须与 filter 函数组合嵌套:
# map 与 filter 嵌套:阅读困难且极不符合 Python 惯用法
positive_doubled_map = list(map(lambda x: x * 2, filter(lambda x: x > 0, raw_data)))
这种嵌套方式代码层级过深,阅读时思维需要在内层的 filter 和外层的 map 之间来回跳跃。在 Python 官方代码规范(PEP 8)与社区共识中,普遍强烈反对这种写法,此时列表推导式具有压倒性优势。
2. 多序列并行处理
当需要同时处理两个或多个列表的对应元素时,map 提供了一个非常便捷的特性:它可以接收多个迭代器参数,自动在最短的序列结束时停止:
bases = [10, 20, 30]
powers = [1, 2, 3]

# map 可以直接接收多个序列
powered_map = list(map(pow, bases, powers))
# 结果: [10, 400, 27000]

# 列表推导式需要结合 zip() 函数
powered_comp = [pow(b, p) for b, p in zip(bases, powers)]在此场景下,两种方式各有千秋:map 语法更为紧凑,而 zip 搭配推导式则更具显式变量绑定的直观性。
四、执行效率与内存开销分析
关于性能,许多开发者存在“内置函数一定比推导式快”或者“推导式一定比 map 快”的片面认知。真实的性能表现取决于底层是否有 Python 虚拟机的函数调用开销:
- 使用内置 C 函数时,
map略占优势:例如map(int, str_list),C 底层无需经过 Python 虚拟机逐项解包和变量查找,执行速度通常比[int(x) for x in str_list]快 10% 到 20% 左右。 - 使用
lambda表达式时,列表推导式更快:map(lambda x: x * 2, data)在每次迭代时都会额外产生一次 Python 层的函数调用栈压栈与出栈开销;而列表推导式在字节码层面直接由优化过的内部循环处理(LIST_APPEND指令),不仅省去了函数调用开销,执行速度通常显著快于map + lambda。
MemoryError。此时应优先保留 map 迭代器,或使用生成器表达式 (expr for x in seq)。
五、综合总结与选型依据
为了让选择更清晰,我们可以从语法习惯、工程实践、资源消耗等维度将两者汇总对比:
| 考量维度 | map 函数 | 列表推导式 | 选型建议 |
|---|---|---|---|
| 调用现成函数 | 语法极简:map(func, data) |
稍显冗余:[func(x) for x in data] |
优先使用 map |
| 数学/字符表达式 | 需引入 lambda,语法啰嗦 | 语法紧凑自然,直观清晰 | 优先使用 列表推导式 |
| 条件筛选 (Filter) | 不支持,需嵌套 filter() |
原生支持 if 子句 |
强烈推荐 列表推导式 |
| 内存占用机制 | O(1) 惰性迭代器,按需产出 | O(N) 立即全量构建 list | 超大数据单次流式处理选 map |
| Python 社区惯例 | 偏向函数式编程风格 | Pythonic 首选语法,广泛采用 | 通用业务逻辑推荐 列表推导式 |
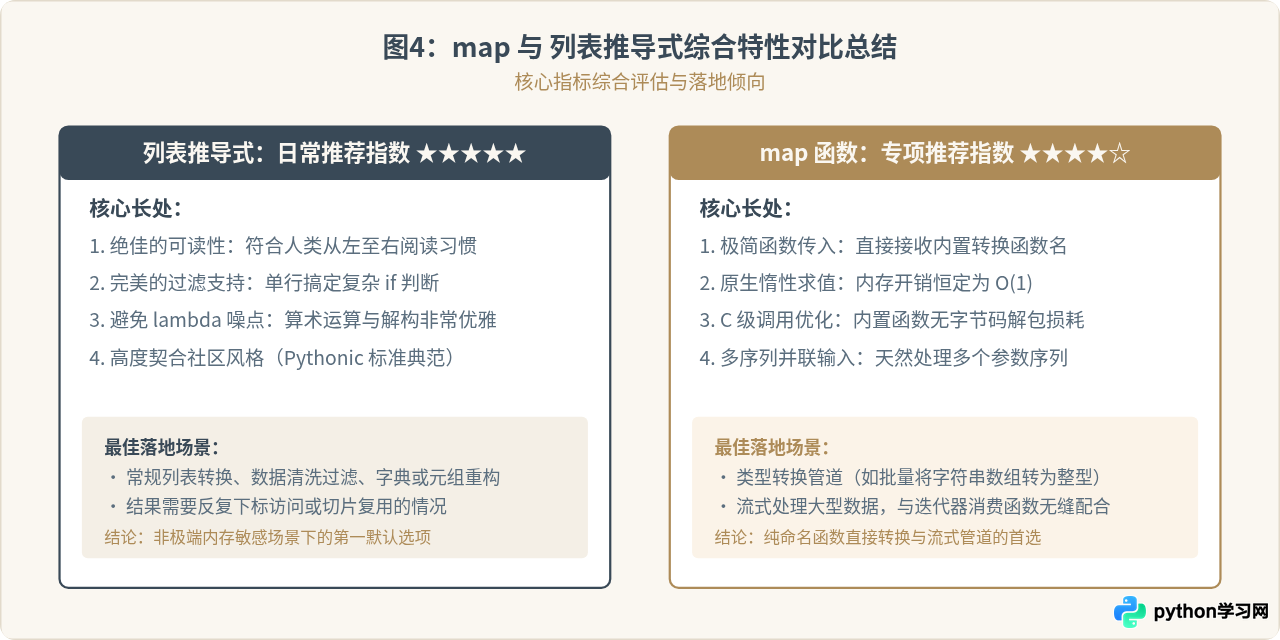
综上所述,列表推导式在整体工程体验与灵活度上更胜一筹,是绝大多数 Python 开发者的第一选择;而在已存在成熟函数且无需条件过滤,或是需要充分发挥迭代器惰性优势的场景下,map 函数则显得更加专业与凝练。理解这两者的边界,结合实际代码语境选用,才能写出既具执行效率又优雅易读的高质量 Python 程序。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















